Wo sollte das Rollout-Budget am sinnvollsten ausgegeben werden? Nicht in Transformer, sondern in den nächsten Schritt der Risikovorhersage.
Nach dem Post-Training großer Modelle durch Reinforcement Learning, in der Robotersteuerung und im Meta-RL tritt ein immer praxisrelevanteres Problem auf:
Die individuelle Bewertung jeder Aufgabe ist zu kostspielig, und die Vorhersage von Risiken anhand historischer Daten kann mit der Aktualisierung des Modells nicht Schritt halten.
Wie lassen sich mit einem begrenzten Rollout-Budget die Prompts finden, die das Training wirklich wert sind?
Ein Forschungsteam der Nationalen Universität für Verteidigungstechnologie und der Tsinghua-Universität hat darauf basierend ICRPM (In-Context Risk Predictive Model) vorgeschlagen, das anhand aktueller Aufgaben- und Risikoprotokolle das Risiko des nächsten Schritts direkt vorhersagt.
Diese Methode erfordert keine zusätzliche Generierung von Rollouts oder zusätzliche Umgebunginteraktionen für die Risikovorhersage. Bei weitgehendem Erhalt des ursprünglichen Trainingsaufwands verbessert sie die Effekte der Aufgabenrisikovorhersage und -auswahl in Szenarien wie RLVR großer Modelle, Meta-RL und robuster Steuerung.
Forschungshintergrund: Warum werden Aufgaben falsch ausgewählt, obwohl die Vorhersage genau ist?
Die herkömmliche Aufgabenstichprobe erfordert zunächst die Messung des Schwierigkeitsgrads oder des Risikos der Kandidatenaufgaben. Im RLVR großer Modelle bedeutet dies, mehrere Antworten für den Prompt zu generieren und dann die Erfolgsrate der Problemlösung anhand überprüfbarer Belohnungen zu schätzen; im Meta-RL und bei der robusten Steuerung bedeutet dies oft kostspielige Umgebunginteraktionen.
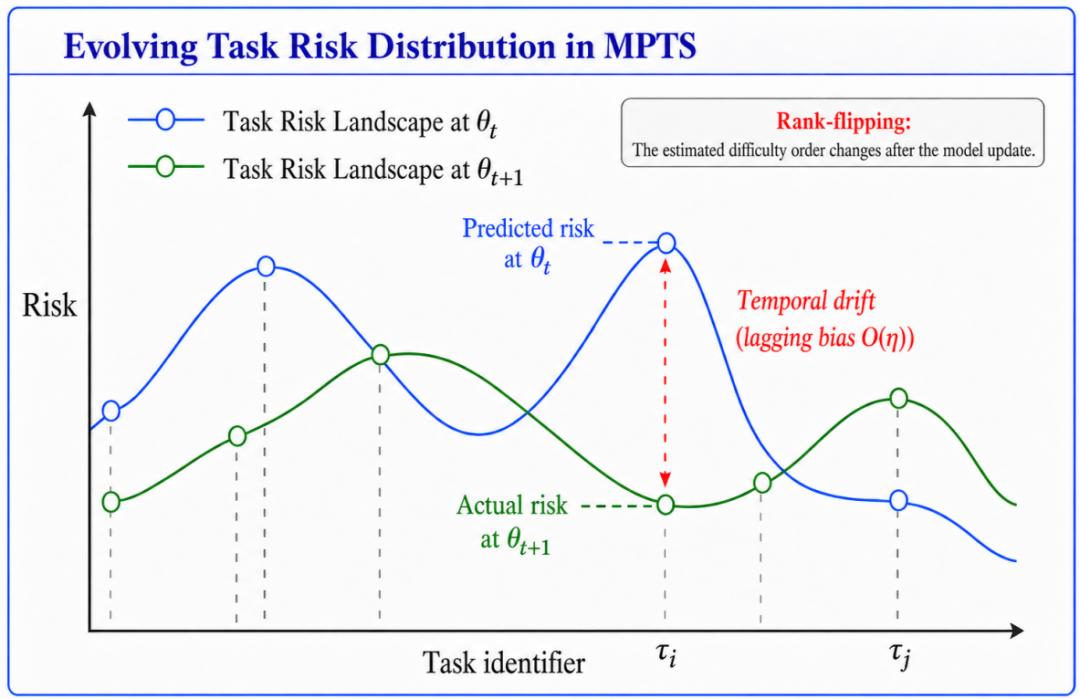
Model Predictive Task Sampling (MPTS) reduziert diese Art von Bewertungen durch ein Risikovorhersagemodell (RPM): Es führt nur echte Messungen an einer kleinen Anzahl von Aufgaben durch, sagt dann das Risiko einer größeren Kandidatenmenge voraus und führt die Stichprobe entsprechend durch. Aber das Aufgabenrisiko ist kein statisches Label. Nach der Aktualisierung der Strategie kann eine ursprünglich schwierige Aufgabe einfach werden, und die Rangfolge zwischen den Aufgaben kann sich sogar umkehren. Ein RPM, das gut darin ist, das „aktuelle Risiko“ vorherzusagen, kann nicht unbedingt genau beurteilen, „welche Aufgabe in der nächsten Runde ausgewählt werden soll“.
△
Technische Lösung: RPM von der Betrachtung des aktuellen Zustands zur Vorhersage des nächsten Schritts umstellen
Vorhersage zukünftiger Risiken anhand des Kontexts
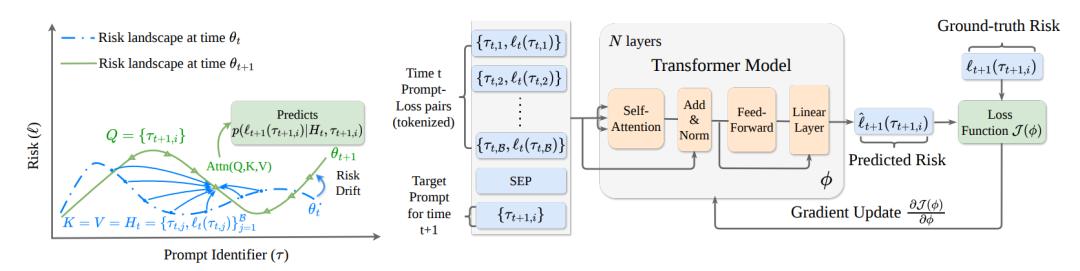
ICRPM behält das grundlegende Aufgabenstichprobengerüst von MPTS bei und ersetzt vor allem die darin verwendete Methode zur Risikovorhersage. Herkömmliche RPM passen hauptsächlich das Risiko unter der aktuellen Strategie an; ICRPM hingegen betrachtet die Beobachtungen des letzten Schritts von „Aufgabe – Risiko“ als Kontext und kombiniert sie mit den zu bewertenden Aufgaben, um das Risiko nach der nächsten Aktualisierung der Strategie vorherzusagen.
Auf diese Weise sind historische Aufzeichnungen nicht nur gewöhnliche Trainingsbeispiele, sondern werden auch zu Hinweisen, die den Zustand der Strategie widerspiegeln. Das Modell muss nicht nur die Schwierigkeitsunterschiede verschiedener Aufgaben lernen, sondern auch, wie sich die Schwierigkeit mit dem Fortschritt des Trainings ändert.
△
Die Fehleranalyse der Arbeit erklärt die Notwendigkeit dieses Designs. Wenn herkömmliches RPM das aktuelle Risiko vorhersagt und es dann für den nächsten Schritt verwendet, tritt ein zeitlicher Verzögerungsfehler erster Ordnung auf, der mit der Lernrate zusammenhängt. Wenn der Kontextvorhersager lokale Risikoänderungen erfassen kann, kann ICRPM den entsprechenden Glättungsrest auf eine Größenordnung zweiter Ordnung steuern. Dies bedeutet jedoch nicht, dass der Vorhersagefehler automatisch auf Null sinkt: Der kontextbezogene Näherungsfehler des Modells selbst besteht weiterhin.
Auffüllen der spärlichen Überwachung durch ein Zeitabfallfenster
Die Anzahl der Aufgaben, die in jeder Runde wirklich bewertet werden, ist begrenzt. Wenn man sich nur auf die neueste Charge stützt, ist die Datenmenge leicht unzureichend; aber wenn alte Daten über einen langen Zeitraum angesammelt werden, mischen sich veraltete Strategiezustände ein.
ICRPM verwendet ein gleitendes Fenster mit zeitlichem Abfall, das den Kontext und die Vorhersageziele wiederverwendet, die aus den letzten 3 historischen Chargen gebildet wurden, und setzt den Zeitabfallkoeffizienten auf 0,9. Neuere Aufzeichnungen haben einen größeren Einfluss auf die aktuelle Vorhersage, ältere Aufzeichnungen können immer noch Überwachungssignale liefern, aber ihr Gewicht nimmt allmählich ab, sodass ein Gleichgewicht zwischen der Ergänzung der Überwachung und der Vermeidung von Störungen durch veraltete Daten erreicht wird.
Erfassung von aufgabenübergreifenden Beziehungen durch Transformer
In der Implementierung kodiert ICRPM die Aufgaben und die entsprechenden Risiken in Eingabedarstellungen, modelliert die Beziehungen zwischen historischen Aufgaben durch Transformer, liest dann die Informationen, die mit den Kandidatenaufgaben zusammenhängen, durch Cross-Attention aus und gibt schließlich die Risikovorhersage für den nächsten Schritt aus.
Es ist erwähnenswert, dass das Experiment die Parameteranzahl von ICRPM und herkömmlichem RPM abgeglichen hat: Im Meta-RL beträgt sie etwa 0,65 Millionen Parameter und im RLVR etwa 42,8 Millionen Parameter. Daher kann der Leistungsunterschied nicht einfach dadurch erklärt werden, dass das Vorhersagemodell größer geworden ist. Das Trainingsziel stammt weiterhin aus dem vorhandenen Optimierungsprozess, es sind keine zusätzlichen Umgebunginteraktionen oder Rollouts für das Risikomodell erforderlich.
Ablationsvalidierung: Der Schlüssel liegt nicht nur in der Berücksichtigung von mehr historischen Daten
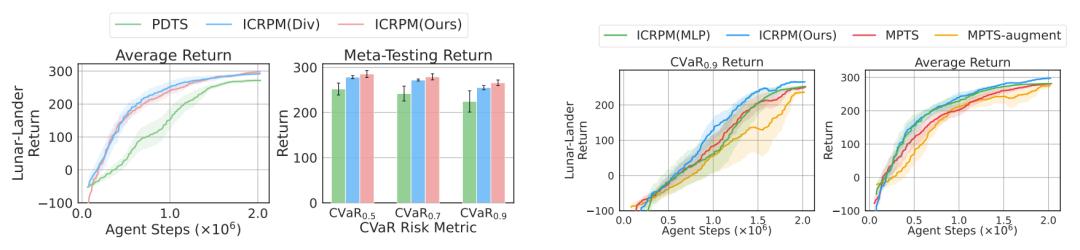
Die Studie verglich verschiedene Modellstrukturen, Aufgabenauswahlregeln und Einstellungen des historischen Fensters auf LunarLander. Wenn der Transformer durch ein MLP mit abgeglichener Parameteranzahl ersetzt wird, ist ICRPM immer noch besser als herkömmliches MPTS; wenn MPTS das gleiche historische Fenster und den gleichen Zeitabfall hinzugefügt wird, aber der nächste Schritt nicht vorhergesagt wird, kann es ICRPM immer noch nicht einholen.
△
Dies zeigt, dass der wirklich entscheidende Faktor die vorausschauende Vorhersage unter Kontextbedingungen ist, und nicht nur die Verwendung von Transformer oder die Erhöhung der historischen Daten. Experimente zur Fenstersensitivität zeigen auch, dass die Historie nicht umso besser ist, je länger sie ist: Die Arbeit verwendet ein 3-Schritte-Fenster und einen Abfallkoeffizienten von 0,9, um ein Gleichgewicht zwischen der Ergänzung der Überwachung und der Vermeidung von Störungen durch alte Daten zu erreichen.
Experimentelle Ergebnisse: Von der Robotersteuerung bis zum RLVR großer Modelle
Die Arbeit deckt vier Szenarien ab: Few-Shot-Sinus-Regression, Meta-RL, Domain Randomization (DR) und LLM-RLVR. Der Schwerpunkt der Bewertung liegt nicht nur auf der durchschnittlichen Leistung, sondern auch auf der Konsistenz der Rangfolge der Aufgabenrisiken und der Leistung bei schwierigen Aufgaben.
Few-Shot-Regression: Kann die Verbesserung der Risikorangfolge zu Vorteilen führen?
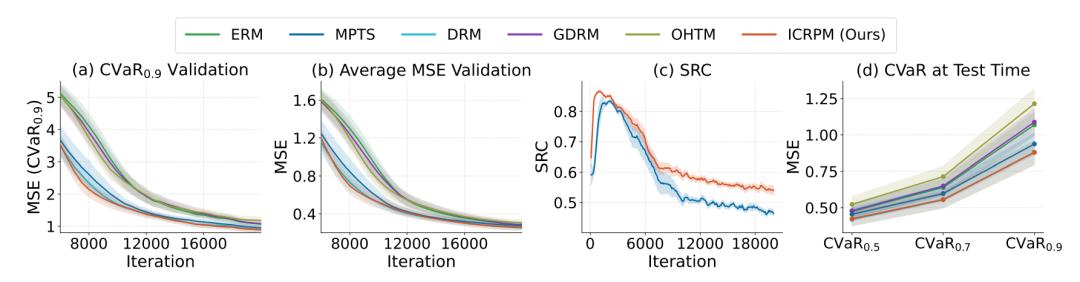
Im Few-shot Sinusoid Regression Experiment senkte ICRPM nicht nur den durchschnittlichen mittleren quadratischen Fehler (MSE) und den Tail-Risikofehler, sondern der Spearman-Rangkorrelationskoeffizient (SRC) zwischen vorhergesagtem und tatsächlichem Risiko war auch durchweg besser als bei MPTS. In der Meta-Test-Phase erzielte ICRPM bei den drei Bewertungsniveaus CVaR₀.₅, CVaR₀.₇ und CVaR₀.₉ den niedrigsten MSE unter allen Vergleichsmethoden und behielt gleichzeitig eine höhere Risikorangkorrelation bei, was zeigt, dass die Verbesserung der Rangfolge der Aufgabenschwierigkeit an die nachgeschaltete Leistung weitergegeben werden kann.
△
Kontinuierliche Steuerung: Verbesserung der Leistung bei schwierigen Aufgaben
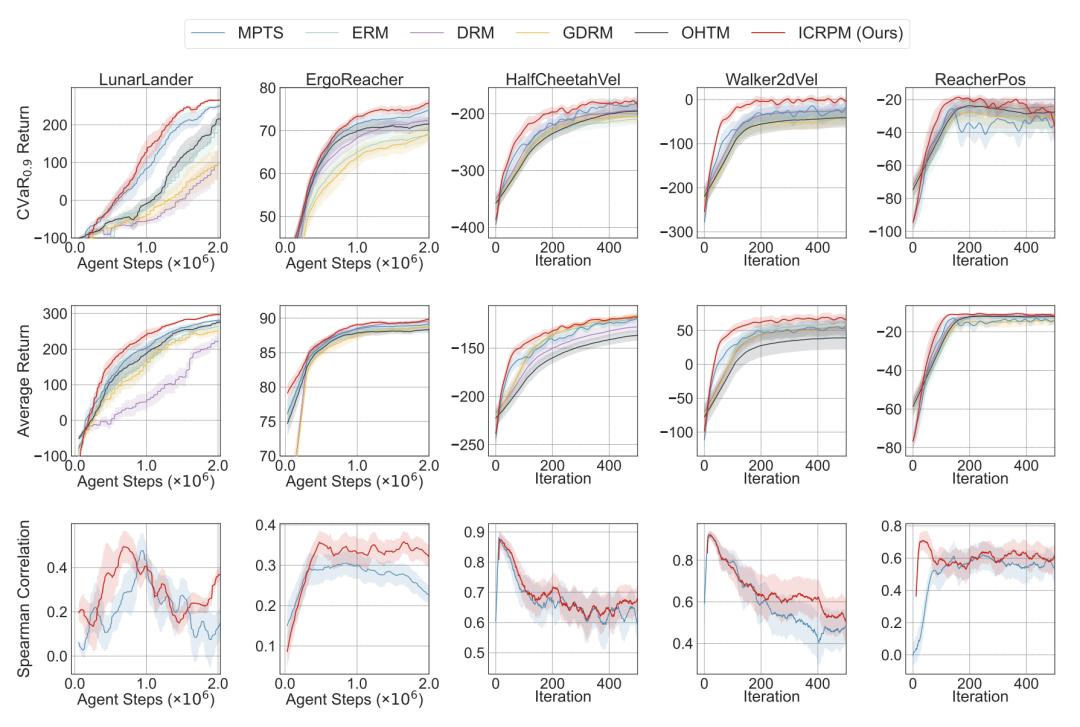
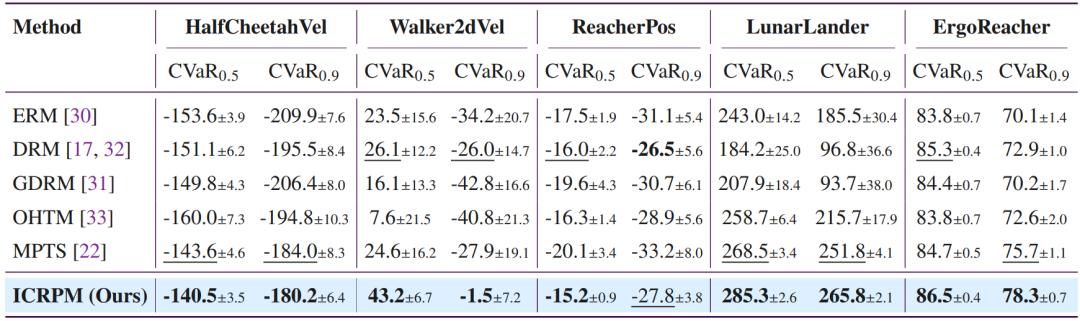
In den fünf Umgebungen, die Meta-RL und DR betreffen, zeigte ICRPM insgesamt eine stärkere Robustheit gegenüber Tail-Risiken. Auf Walker2dVel betrug die CVaR₀.₉-Belohnung von MPTS -27,9, ICRPM verbesserte sie auf -1,5; auf LunarLander berichtet die Arbeit, dass die CVaR₀.₉ von ICRPM bei Konvergenz um mehr als 40 % höher ist als bei ERM.
△
△
Im Einzelnen wurde die CVaR₀.₉ von Walker2dVel von -27,9 ± 19,1 bei MPTS auf -1,5 ± 7,2 bei ICRPM verbessert; HalfCheetahVel wurde von -184,0 auf -180,2 verbessert und ErgoReacher von 75,7 auf 78,3. Aber nicht alle einzelnen Indikatoren liegen vorne: ICRPM auf ReacherPos beträgt -27,8, etwas niedriger als -26,5 bei DRM. Daher sollte die Schlussfolgerung als Verbesserung des Gesamttrends verstanden werden, nicht als absoluter Vorteil für alle Aufgaben.
RLVR großer Modelle: Verbesserung der Countdown-Genauigkeit
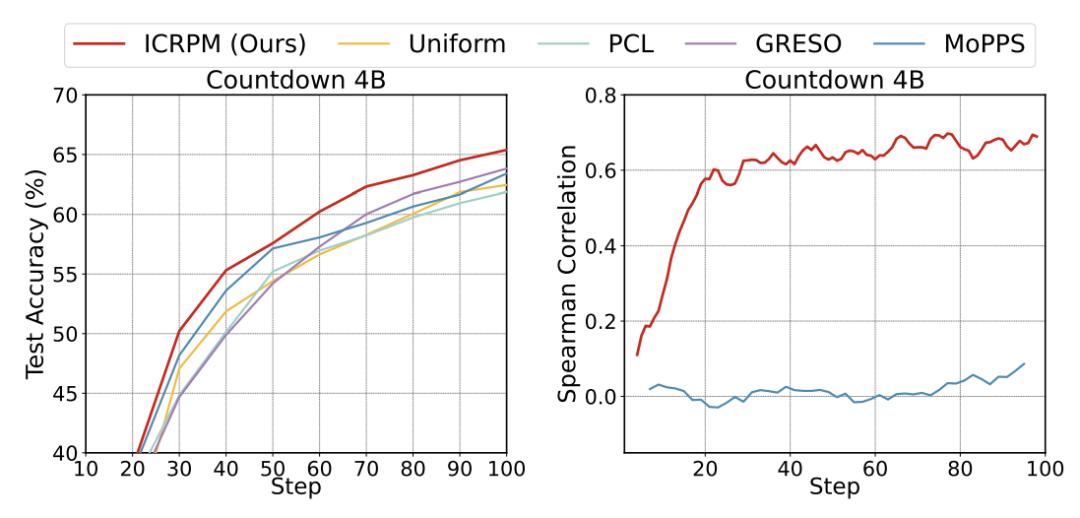
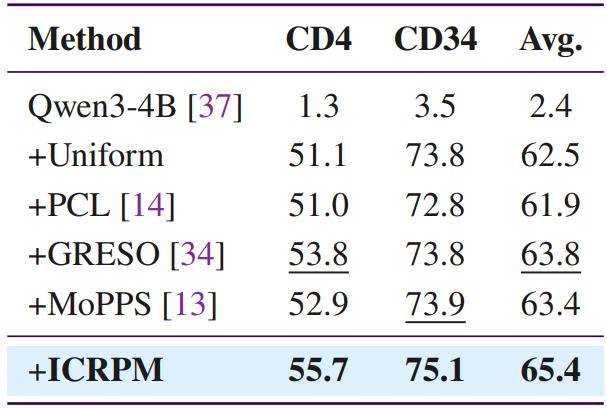
Im Countdown-Experiment auf Basis von Qwen3-4B-Base enthält der Trainingssatz etwa 20.000 Countdown-34-Proben, und für jeden Prompt werden 8 Antworten generiert. Die Rangkorrelation von ICRPM für die Prompt-Schwierigkeit ist deutlich besser als bei den Vergleichsmethoden und führt zu einer besseren endgültigen Genauigkeit.
△
△
Auf dem schwierigeren CD4-Testsatz erreichte pass@1 von ICRPM 55,7 %, 1,9 Prozentpunkte höher als 53,8 % bei GRESO und 2,8 Prozentpunkte höher als 52,9 % bei MoPPS; auf CD34 erreichte es 75,1 %, der Durchschnitt der beiden betrug 65,4 %. Im Vergleich zur durchschnittlichen Genauigkeit von 62,5 % bei Uniform, 63,8 % bei GRESO und 63,4 % bei MoPPS liegt ICRPM um 2,9, 1,6 bzw. 2,0 Prozentpunkte höher.
Berechnungsaufwand: Keine zusätzlichen Rollouts erforderlich, die Betriebskosten sind nahezu gleich wie bei der ursprünglichen Methode
Was die Berechnungskosten betrifft, so betrug die Laufzeit von ICRPM, Uniform, PCL und MoPPS in einem RLVR-Experiment, das im Anhang der Arbeit berichtet wird, jeweils etwa 11,1 Stunden, und die von GRESO etwa 17,8 Stunden. Auf Walker2dVel beträgt die relative Laufzeit von ICRPM 1,08 mal die von ERM, nahe an 1,07 mal von MPTS.
<