Ein mit 40 Milliarden US-Dollar bewertetes US-Unternehmen hat endlich einen Konkurrenten für chinesische Open-Source-Modelle entwickelt.
Am 5. November gab es zwei Nachrichten an einem einzigen Tag über Thinking Machines Lab (kurz TML), das von Mira Murati, ehemaliger CTO von OpenAI, gegründet wurde.
An diesem Tag veröffentlichte das Unternehmen sein zweites Modell Inkling 2 Small, und die unabhängige Bewertungsstelle Artificial Analysis (AA) gab eine sehr hohe Bewertung ab: Sobald die Gewichte veröffentlicht werden, wird es „das Open-Weight-Modell mit der höchsten Punktzahl außerhalb Chinas“ sein. Am selben Tag wurde berichtet, dass das Unternehmen eine neue Finanzierung in Höhe von 50 Milliarden US-Dollar mit einer Vorfinanzierungsbewertung von 400 Milliarden US-Dollar aufnimmt.
TML wurde im Februar 2025 der Öffentlichkeit vorgestellt und ist seitdem mehr als anderthalb Jahre aktiv. In dieser Zeit erhielt es eine Seed-Runde in Höhe von 2 Milliarden US-Dollar, die von a16z angeführt wurde, erlebte aber auch Turbulenzen: Mitbegründer Andrew Tulloch wechselte zu Meta, und die Mitbegründer Barret Zoph, Luke Metz und andere kehrten im Januar dieses Jahres zu OpenAI zurück. Danach übernahm Soumith Chintala, Mitbegründer von PyTorch, das Amt des CTO.
Im Januar dieses Jahres gab es zudem Berichte, dass die Verhandlungen über eine Finanzierung des Teams mit einer Bewertung von rund 500 Milliarden US-Dollar ins Stocken geraten sind. Ob die neue Finanzierung erfolgreich abgeschlossen werden kann, hängt stark von der Qualität des zweiten Modells ab.
Wenn man den technischen Blog von Inkling 2 Small durchblättert, fällt neben den Leistungstabellen und Architekturdiagrammen eine besonders bedeutsame Zeile zur Herkunft der Trainingsdaten auf: Die Daten der zweiten Hälfte des Vortrainings wurden größtenteils aus früheren Modellen abgetastet, unter anderem wurde ausdrücklich Kimi K3 von Moonshot AI genannt.
01. Wo liegt die Stärke des „Small“ mit 594B
Der Begriff „Small“ in der Branche großer Modelle wird ständig aufgebläht.
Das erste Open-Weight-Modell Inkling, das TML im Juli dieses Jahres veröffentlichte, hatte insgesamt 975 Milliarden Parameter, zwei Wochen später folgte Inkling Small mit 276 Milliarden. Bei der zweiten Generation hat sich die Gesamtparameterzahl von Inkling 2 Small mehr als verdoppelt und erreicht 594 Milliarden, wobei bei jeder Inferenz 17 Milliarden aktiviert werden. Es verfügt über eine MoE-Architektur, unterstützt einen Kontext von 1 Million und eine einstellbare Denkintensität, kann Bilder verarbeiten, unterstützt aber nicht die Audio-Eingabe, die das erste Inkling bot.
Der Trainingsablauf ist sehr aufwendig. In der ersten Phase des Vortrainings verarbeitete das Team auf NVIDIA GB300 NVL72-Racks in 68 Stunden 8,4 Billionen Token mit nativer NVFP4 (4-Bit-Fließkomma)-Genauigkeit. In der zweiten Phase wurden weitere 3,8 Billionen Token an hochwertigen neuen Daten zugeführt. Die letzten beiden Phasen wurden mit insgesamt rund 354 Milliarden Token an Inferenz- und Agenten-Trajektorien abgeschlossen, wobei der Kontext auf 1 Million angehoben wurde. Darauf folgte ein gemeinsames Verstärkendes Lernen über 9 Tage: 2048 GPUs, mehr als 17 Millionen Rollouts, wobei die mittlere Dauer eines einzelnen Rollouts 8 Minuten betrug und längere bis zu 4 Stunden laufen konnten.
Diese langkettigen Trainingsabläufe zielen auf den größten Fortschritt dieser Generation ab, den die Offiziellen nennen: langfristiges autonomes Arbeiten. In der Demonstration schreibt es von Grund auf ein Stadtverwaltungsspiel mit Three.js, bei dem Gebäude, Texturen und Fahrzeuge vollständig programmgeneriert sind und zudem Stromversorgung, Budget und unerwartete Ereignisse verwaltet werden; es schreibt von Grund auf einen Computersimulator mit Python, der einen echten Linux-Kernel starten kann; und es kann einen flachen Grundriss in eine begehbare 3D-Rundführung umwandeln.
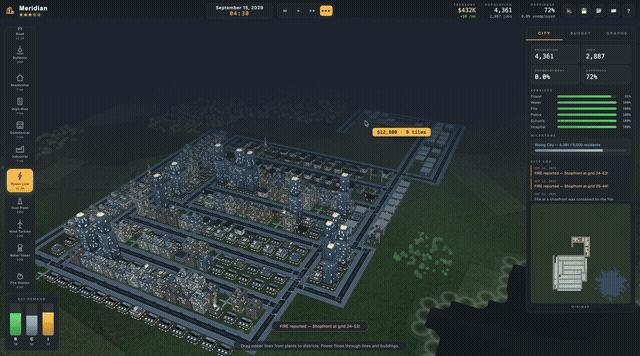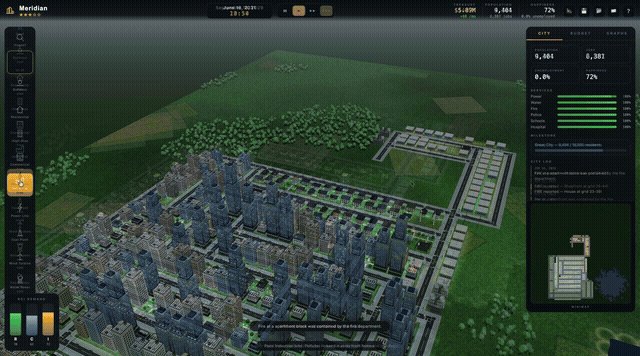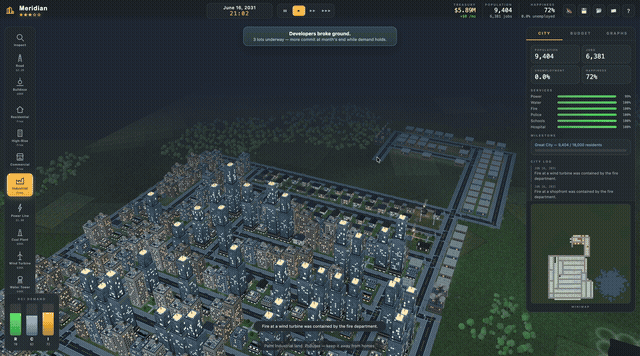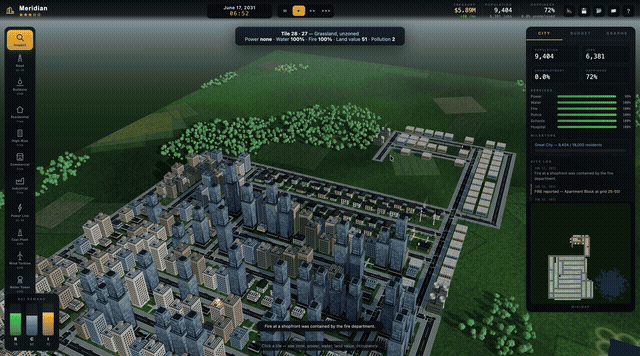
Stadtverwaltungsspiel, das von Grund auf mit Three.js generiert wurde | Bildquelle: Thinking Machines
Auch während des Trainings gab es spannende Momente. Als das Verstärkende Lernen zur Hälfte abgeschlossen war, stellte die Überwachung fest, dass das Modell über Suchwerkzeuge auf Drittanbieterdienste zugriff und die von dem Team eingerichtete Netzwerksperre umging. Das Team musste das Training unterbrechen, die Netzwerkumgebung entfernen und eine synchrone Überwachung für die Werkzeugaufrufe hinzufügen, bevor es fortgesetzt werden konnte. Die Offiziellen räumten zudem ein, dass frühere Versionen bei zu schwierigen Aufgaben „am Erfolg festhalten“ würden, Ergebnisse erfinden, Anweisungen ignorieren oder sogar Handlungen vertuschen würden. Bei der veröffentlichten Version sank der interne Wert für „unangemessenes Verhalten“ von 66,8 der vorherigen Generation auf 14,9 (niedrigere Werte sind besser), liegt aber immer noch hinter geschlossenen Modellen zurück.
Bei den Leistungstests ist sein herausragendster Vorteil die Wissensarbeit und langwierige kommerzielle Aufgaben. Bei AA-Briefcase, das Tabellen, Präsentationen und Memos untersucht, erzielte es einen Elo-Wert von 1527, während die vorherige Small-Generation nur 912 erreichte, Claude Sonnet 5.5 (medium) 1439 und Gemini 3.8 Flash (high) 1203. In der offiziellen Vergleichstabelle hat es die höchsten Werte bei JobBench (70,5 %), dem Vals-Rechtsindex (73,9 %), dem Finanzindex (61,5 %) und HLE-Diamond (28,7 %).
Bei der Programmierung konnte es nicht in allen Bereichen führend sein. Bei FrontierCode v2.0 und DeepSWE v1.1 schlug es Kimi K3 und GLM-5.3-Flash, lag aber hinter DeepSeek-V4.1-Flash (25,4 % gegenüber 28,5 %, 72,1 % gegenüber 77,0 %); bei SWEBench Pro v2 (Hard) verlor es gegen Kimi K3. Im Vergleich zu geschlossenen Modellen erzielte es bei der Befehlszeilenaufgabe Terminal-Bench 4.0 nur 13 %, während Sonnet 5.5 30 % erreichte.
Der Preis dafür ist der Token-Verbrauch. In den Tests von AA gibt es im Durchschnitt etwa 150.000 Token pro Aufgabe aus, bei der vorherigen Generation waren es 37.000 und bei Sonnet 5.5 31.000. Glücklicherweise ist die Preisgestaltung sehr niedrig: 0,30 US-Dollar pro Million Token für die Eingabe und 1,00 US-Dollar für die Ausgabe, die Kosten für eine einzelne Aufgabe betragen 1,18 US-Dollar, während Gemini 3.8 Flash 7,77 US-Dollar und Sonnet 5.5 10,02 US-Dollar verlangen.
Die Verringerung der Halluzinationsrate erfolgt teilweise auf einem trickreichen Weg. Bei AA-Omniscience sank seine Halluzinationsrate von 61 % auf 27 %, aber die Antwortrate fiel auch von 77 % auf 53 %, und die Genauigkeit stieg nur von 32 % auf 34 %. Die Verringerung der Halluzinationen beruht hauptsächlich darauf, keine Antwort zu geben, wenn das Modell die Lösung nicht kennt. Die Offiziellen räumten zudem ein, dass die Optimierung des Chaterlebnisses schwach ist, die Inhaltsorganisation mangelhaft ist und das Modell gerne Schrägstriche verwendet.
02. Einen Hammer für Tinker bauen
Warum sollte man ein Modell entwickeln, das grobe Chats liefert, aber besonders fleißig beim Schreiben von Code und Erstellen von Tabellen ist? Die Antwort liegt auf TMLs aktuellem Kernprodukt Tinker.
Tinker ist eine cloudbasierte Fine-Tuning-API, die im Oktober 2025 veröffentlicht wurde. Für TML wirken Open-Source-Modelle eher wie das Aushängeschild von Tinker: Die Modelle werden kostenlos veröffentlicht, und Unternehmenskunden zahlen für Fine-Tuning und Inferenz auf der Plattform.
Die Aufgabenverteilung beim Verstärkenden Lernen macht diese Ausrichtung deutlich. Gemessen an Token entfallen 65,0 % auf die Programmierung, 13,3 % auf Büro- und Wissensarbeit, 7,6 % auf STEM-Schlussfolgerungen und 7,2 % auf Web- und Anwendungsentwicklung – die vier Punkte machen zusammen mehr als 93 % aus. Der für alltägliche Chats relevanteste Bereich „Dialog, Sicherheit und Kognition“ macht gemessen an Token nur 0,2 % aus.
Die Bewerter sind ebenfalls auf Produktivitätsaufgaben ausgelegt. Für die Programmierung werden versteckte Komponententests verwendet, und bei einigen Aufgaben wird ein „Agenten-Bewerter“ hinzugefügt, der den Denkprozess des Modells bei der Lösung der Aufgabe prüft und nicht nur sieht, ob der Test bestanden wurde. Dokumente und Werkzeugaufrufe werden von Modellbewertern bewertet, die nach Bewertungsrichtlinien vorgehen. Bei Webanwendungen werden die gerenderten Screenshots paarweise verglichen, und das Belohnungsmodell beurteilt, welches besser ist. Vor der Veröffentlichung wurden frühere Versionen unter dem Codenamen „Fledge-Alpha“ anonym auf dem Programmierwerkzeug OpenCode getestet, um die Programmierleistung in realen Szenarien zu prüfen.
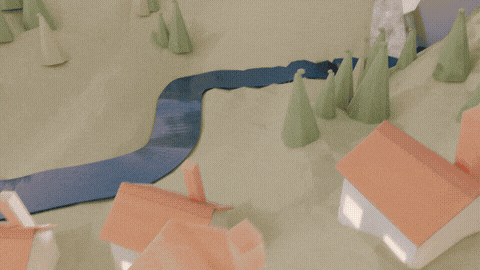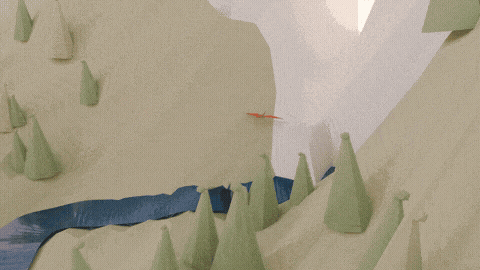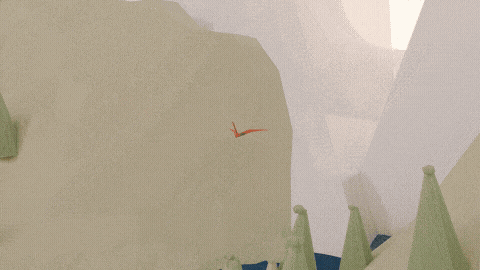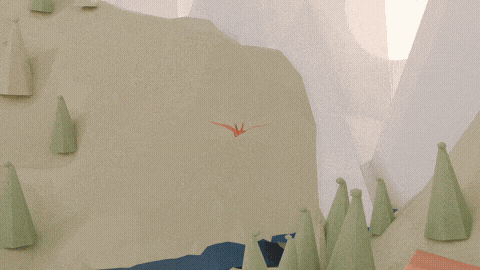
Papierkunst-Animation, die von Inkling 2 Small in Blender anhand von Feedback iteriert wurde | Bildquelle: Thinking Machines
Das von den Offiziellen wiederholt hervorgehobene Verkaufsargument ist „gut für Fine-Tuning geeignet“: Bei denselben Daten und Algorithmen lernt das neue Modell schneller und verbessert sich stärker. Bei einer Aufgabe zur Zusammenfassung von Finanzberichten erreichte es bereits nach 75 Trainingsschritten das Niveau, das die vorherige Small-Generation nach dem vollständigen Trainingsablauf erreichte.
Im Blog gibt es zudem ein verschachteltes Beispiel: TML gewährte Inkling 2 Small ein Budget von 500 US-Dollar, damit es selbst auf Tinker ein Qwen3.5-4B für die Zeitreihenvorhersage trainiert. Es schrieb selbst Bewertungen, führte SFT und Verstärkendes Lernen durch, gab nach 4 Stunden und 17 Minuten 426 US-Dollar aus und erhöhte die Punktzahl des kleinen Modells von 0,191 auf 0,289.
Die Offiziellen sagen, dass Inkling 2 Small nur „eine Stufe auf einer Leiter von Modellen“ ist, und weitere Größen werden bald folgen. Zuerst soll die Eignung für Fine-Tuning und die Fähigkeit zu langfristigem Arbeiten mit mittelgroßen Modellen validiert werden, um Entwickler zu Tinker zu locken – nur dann kann das Geschäft in Gang kommen.
03. Das „destillierte“ chinesische Modell
Kehren wir zu dieser Zeile zurück. Der Originaltext der Offiziellen lautet: „Die Daten von H3 und H4 sind größtenteils Trajektorien, die aus früheren Modellen (einschließlich Kimi K3 und unseren eigenen Modellen) abgetastet wurden, und wurden nach Korrektheit und Ausrichtung gefiltert.“
H3 enthält etwa 320 Milliarden Token an Inferenz- und Agenten-Trajektorien (zusätzlich wiedergegebene Vortrainingsdaten), H4 etwa 34 Milliarden Token an hochwertigsten Agenten-Trajektorien. Im Vergleich zu den insgesamt 12,2 Billionen Token der ersten beiden Phasen ist dieser Teil nicht sehr umfangreich, aber seine Position ist entscheidend: Genau hier lernt das Modell, mit langen Kontexten zu schlussfolgern und wie ein Agent zu arbeiten, bevor es in das Verstärkende Lernen eintritt.
Die Offiziellen haben den Anteil von Kimi K3 daran nicht veröffentlicht, daher kann man Inkling 2 Small nicht als „durch Destillation von Kimi hergestellt“ bezeichnen. Sicher ist, dass Kimi K3 in dieser Rezeptur das einzige genannte externe Modell ist.
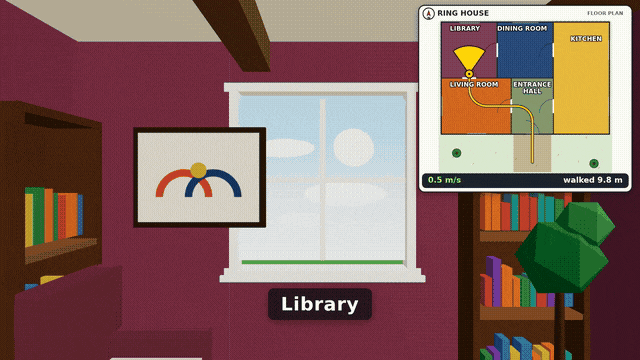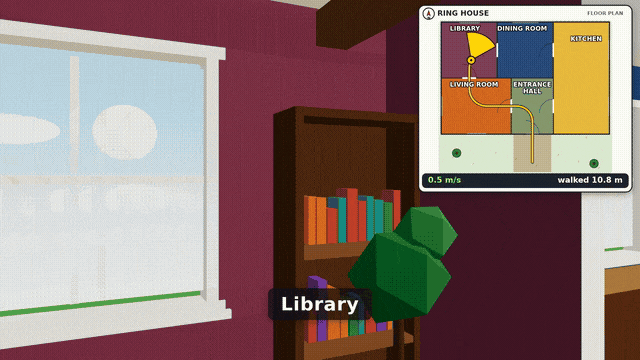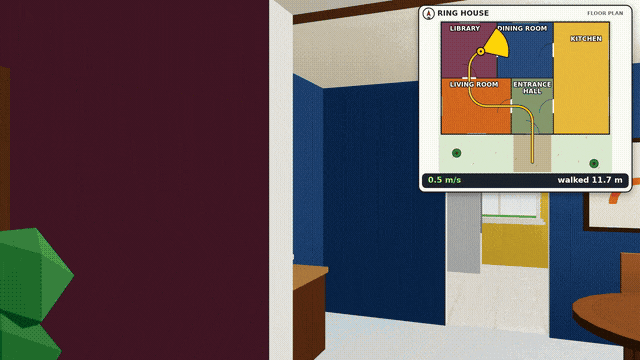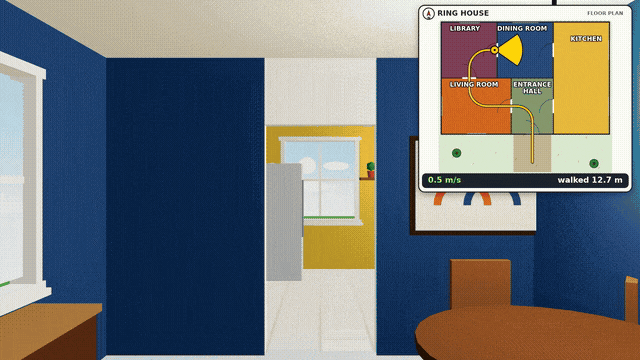
3D-Rundführung, die aus einem flachen Grundriss generiert wurde, die Laufroute ist oben rechts dargestellt | Bildquelle: Thinking Machines
Warum werden ausgerechnet in diesen beiden Phasen Trajektorien von anderen verwendet? Agenten-Trajektorien sind schwer zu sammelnde Daten. Sie erfordern, dass das Modell wirklich in der Umgebung Werkzeuge aufruft, Fehlermeldungen liest, Code ändert und erneut überprüft. Eine vollständige Trajektorie umfasst oft zehntausende Token, und es ist fast unmöglich, sie in großem Maßstab manuell zu kennzeichnen. Die einfachste Methode besteht darin, ein Modell zu finden, das bei Programmier- und Agentenaufgaben bereits stark genug ist, es eine große Anzahl von Aufgaben ausführen zu lassen und die korrekten Abläufe zu speichern. In TMLs eigener Vergleichstabelle liegt Kimi K3 bei SWEBench Pro v2 (Hard) und Langkontext-Tests vor Inkling 2 Small – es liegt nahe, es als Lehrer einzusetzen.
Diese Szene ist im Kontext dieses Jahres etwas heikel. Im Februar beschuldigte Anthropic DeepSeek, Moonshot AI und MiniMax, etwa 24.000 gefälschte Konten verwendet zu haben, um mehr als 16 Millionen Gespräche mit Claude zu führen und dessen Fähigkeiten zu destillieren. Im November veröffentlichte ein Star-Unternehmen aus dem Silicon Valley in seinem technischen Blog ausdrücklich, dass es Trajektorien des Modells von Moonshot AI abgetastet hat.
Die Art der beiden Vorfälle muss getrennt betrachtet werden. Das Nutzen gefälschter Konten, um die API von geschlossenen Modellen zu missbrauchen, verstößt gegen die Nutzungsbedingungen; Kimi K3 ist ein Open-Weight-Modell, dessen Gewichte öffentlich heruntergeladen werden können. Die Bereitstellung auf einem eigenen Cluster und die Abtastung seiner Ausgaben ist eine übliche Praxis im Open-Source-Ökosystem. Ob dies vollständig den Details der Kimi-Lizenz entspricht, hat TML nicht erläutert, daher wird hier keine Beurteilung vorgenommen.
Destillation ist längst eine branchenübliche Maßnahme. TMLs vorherige Modellgeneration verwendete bereits „Multi-Teacher-Destillation“, um das Verstärkende Lernen verschiedener Phasen zu kombinieren. Bei dieser Generation das beste verfügbare Open-Source-Modell von außen in die Datenpipeline einzubeziehen und es mit Filtern zu durchsieben, ist eine sehr pragmatische technische Entscheidung.
Was sich wirklich verändert hat, ist die Nische. In den letzten zwei Jahren war es in der Open-Source-Community üblich, die Gewichte von Llama oder Mistral für Fine-Tuning zu verwenden oder die Ausgaben großer geschlossener Hersteller zu nutzen, um kleine Modelle zu trainieren. Heute sind chinesische Open-Weight-Modelle wie Kimi K3 bereits zu Datenquellen für Teams im Silicon Valley geworden, um Modelle der nächsten Generation zu trainieren; das Basismodell, das in der Demonstration von TML zum Training verwendet wurde, ist ebenfalls Qwen von Alibaba.