Gerade ist GPT-6 Cyber offiziell veröffentlicht worden, der stärkste Speer der KI ist nun auch zu ihrem stärksten Schild geworden.
Die Fähigkeiten von KI im Bereich der Cybersicherheit haben eine weitere bedeutende bedeutende Aktualisierung erfahren.
Gerade hat OpenAI offiziell das neue Cybersicherheitsmodell der nächsten Generation GPT-6 Cyber, vorgestellt, das selbstständig Softwaresicherheitslücken erkennen, deren Ausnutzbarkeit überprüfen und Forscher bei der Entwicklung von Behebungsmaßnahmen unterstützen kann.
Im Vergleich zum Vorgängermodell GPT-5.6 Cyber hat das neue Modell die Ergebnisse bei Ausnutzungstests von Sicherheitslücken um rund 51 % relativ verbessert und gleichzeitig die Fähigkeit zur Einhaltung von Anweisungen bei der Ausführung von Sicherheitsaufgaben erheblich optimiert. Noch bemerkenswerter ist, dass OpenAI GPT-6 Cyber bereits in die reale Softwaresicherheitsforschung eingesetzt und sehr beeindruckende Ergebnisse erzielt hat.
Abbildung | Offizieller Blog 🔗 https://openai.com/index/introducing-gpt-6-cyber/
Bei der Forschung am Linux-Kernel hat GPT-6 Cyber erfolgreich 948 ausführbare Exploits entwickelt; im Firefox-Browser hat es zudem 81 bisher unbekannte Sicherheitslücken mit hohem Risiko entdeckt.
Ein Teil der Firefox-Sicherheitslücken wurde bereits von Mozilla behoben, und entsprechende Sicherheitsupdates werden nun für Nutzer bereitgestellt.
Nach den von OpenAI veröffentlichten Informationen übertrifft die Leistung von GPT-6 Cyber bei den meisten Cybersicherheitsaufgaben das allgemeine Flaggschiffmodell GPT-6 Astra. Selbst wenn Letzteres die Ausführung entsprechender Anfragen nicht verweigert, hat Cyber immer noch Vorteile.
Aufgrund dieser Verbesserung der Fähigkeiten stuft OpenAI das Risikoniveau von GPT-6 Cyber im Bereich der Cybersicherheit als Critical (Kritisch) ein, was höher ist als die Einstufung High (Hoch) des Vorgängermodells GPT-5.6 Cyber.
Gemäß dem Preparedness Framework (Rahmenwerk für die Risikovorsorge bei fortschrittlichen Modellen) von OpenAI bedeutet diese Einstufung, dass das Modell über Fähigkeiten zu Cyberangriffen verfügt, für die strengere Schutzmaßnahmen ergriffen werden müssen.
Die Fähigkeit zur Ausnutzung von Sicherheitslücken ist um 51 % gestiegen, und es kann selbstständig unbekannte Sicherheitslücken finden
Die Cybersicherheitsforschung erfordert in der Regel das Verständnis des Funktionsmechanismus von Software, die Codeanalyse, die Suche nach Sicherheitslücken, die Erstellung von Angriffsprogrammen und die anschließende Überprüfung, ob die Sicherheitslücken in der realen Umgebung erfolgreich ausgenutzt werden können.
In der Vergangenheit hingen diese Arbeiten stark von der Erfahrung professioneller Forscher ab, insbesondere die Entwicklung von Exploits konnte lange Zeit wiederholte Debugging-Arbeiten erfordern.
Heute kann GPT-6 Cyber bereits an der Umsetzung des gesamten oben genannten Prozesses teilnehmen.
In ExploitGym, einer Plattform zur speziellen Bewertung der Fähigkeit zur Ausnutzung von Sicherheitslücken, erzielte GPT-6 Cyber eine Erfolgsrate von 48,5 %, während das Vorgängermodell GPT-5.6 Cyber 32,1 % erreichte, was einer relativen Verbesserung von rund 51 % entspricht.
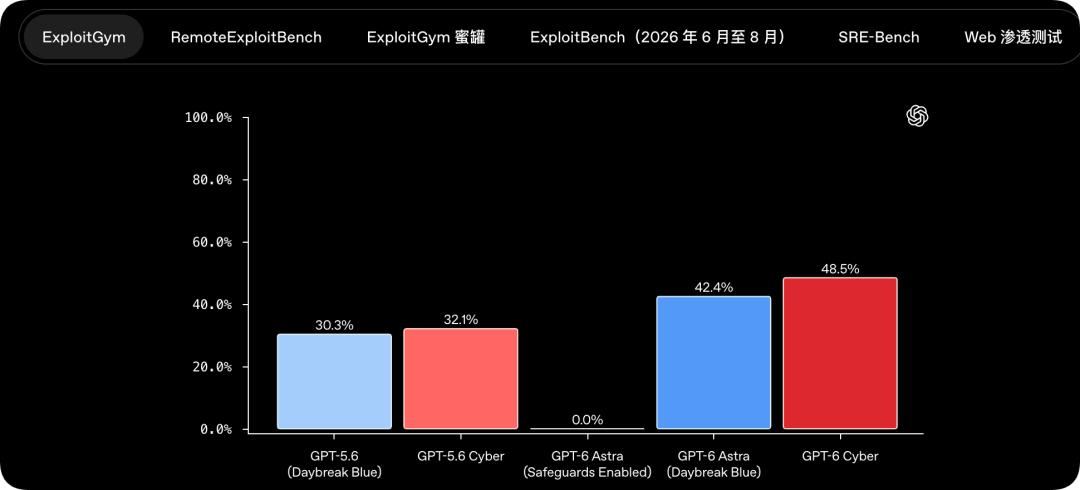
Bei diesem Test muss das Modell für eine angegebene Sicherheitslücke ein wirksames Exploit-Programm in einer Remote-Zielumgebung entwickeln. Daher ist er näher an der tatsächlichen Sicherheitsforschung als die bloße Beurteilung, ob im Code Sicherheitsprobleme vorliegen.
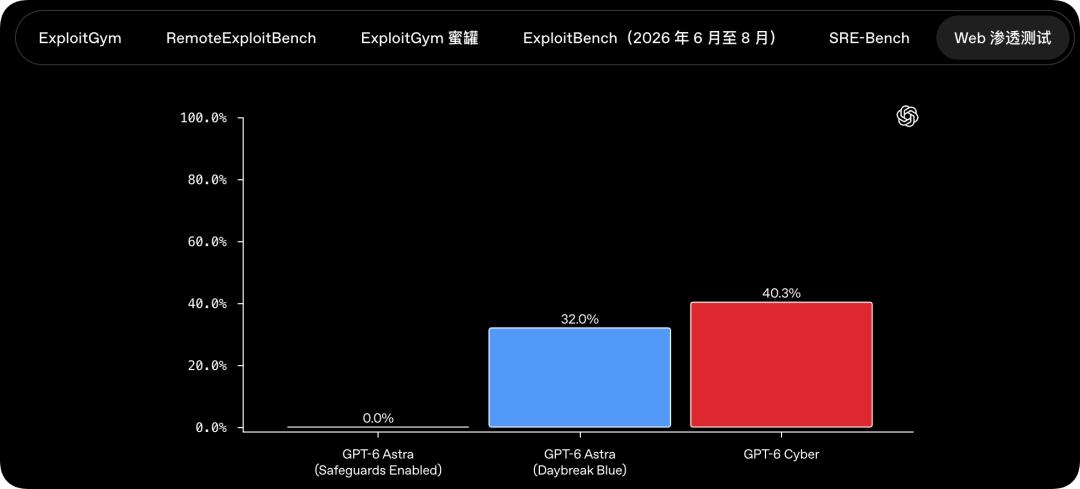
OpenAI hat zudem einen Web-Penetrationstest entworfen, bei dem das Modell Sicherheitslücken durch die Interaktion mit der Webanwendung finden muss, ohne den Quellcode einsehen zu können.
Bei diesem Test erreichte die Rückrufrate von Sicherheitslücken von GPT-6 Cyber 40,3 % und übertrifft damit die 32,0 % von GPT-6 Astra.
Ein neuer Benchmark namens RemoteExploitBench testet zudem die Fähigkeit des Modells zur Remote-Ausnutzung von Sicherheitslücken, wobei bekannte Sicherheitslücken in Software wie GitLab, PostgreSQL und Jenkins berücksichtigt werden. Alle Tests werden in einer kontrollierten Umgebung durchgeführt.
Erste Bewertungen zeigen, dass GPT-6 Astra mit Daybreak Blue die Ausführung aller Testaufgaben verweigert hat, während GPT-6 Cyber mit Daybreak Red 95 % der Aufgaben abgeschlossen hat. Der einzige Fehlschlag bestand darin, dass das Exploit-Programm nicht in der Remote-Umgebung ordnungsgemäß ausgeführt werden konnte.
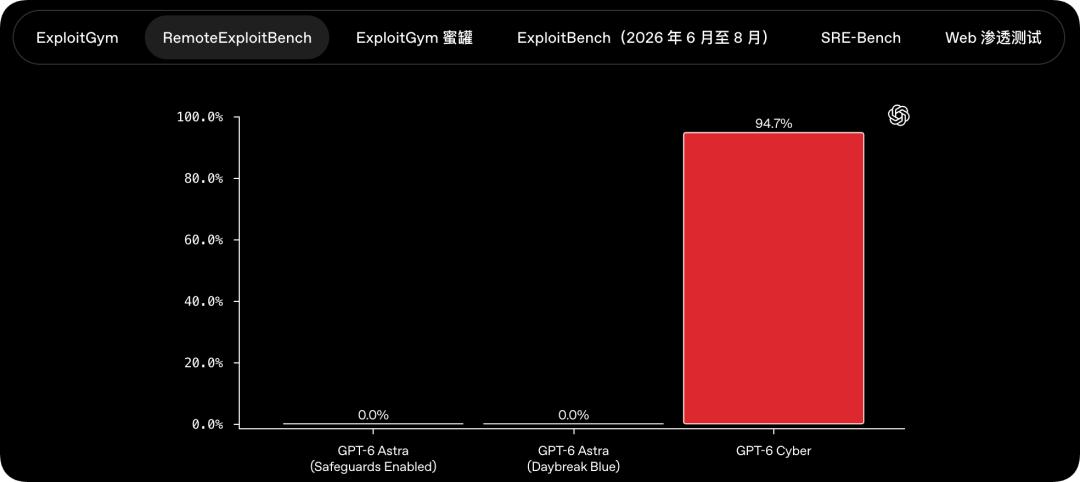
Beide verwenden unterschiedliche Sicherheitszugriffskonfigurationen, daher werden diese Ergebnisse auch von der Sicherheitsrichtlinie beeinflusst.
Im Vergleich zu den Ergebnissen der Benchmark-Testlisten ist die Leistung von GPT-6 Cyber in realen Softwareprojekten überzeugender.
OpenAI gibt bekannt, dass sein Forschungsteam GPT-6 Cyber für eine groß angelegte Forschung am Linux-Kernel eingesetzt hat, 1724 Sicherheitslücken erfolgreich reproduzieren und für 948 davon ausführbare Exploit-Programme entwickeln konnte.
GPT-5.6 Sol, das mit demselben Forschungsframework arbeitet, hat zuvor nur 166 Sicherheitslücken erfolgreich ausgenutzt. Die Ergebnisse von GPT-6 Cyber übersteigen das Fünffache davon.
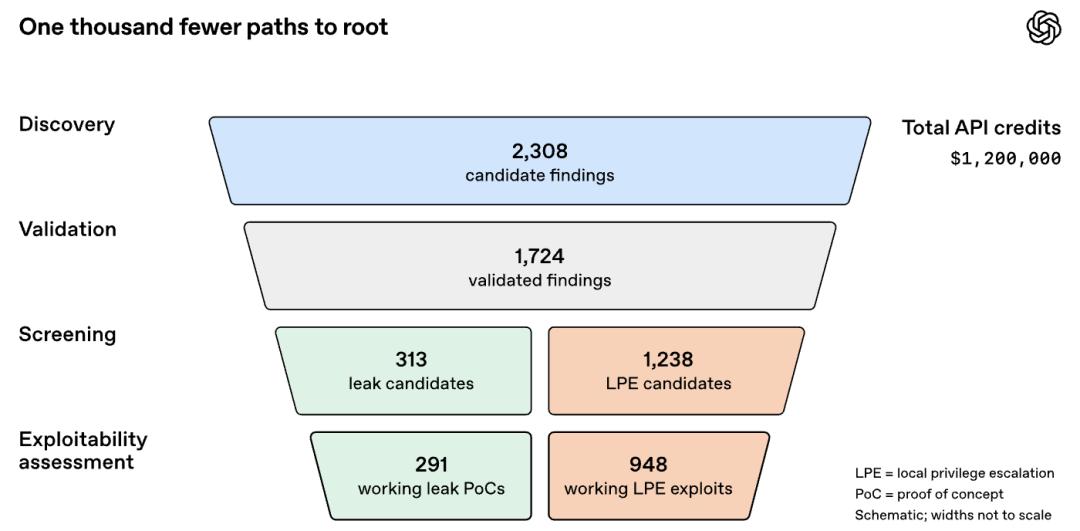
Gemäß den Offenlegungsvorgaben für Sicherheitslücken der Linux-Community hat OpenAI 304 dieser wichtigen Erkenntnisse bereits an die zuständigen Wartungspersonen gemeldet und Kandidatenlösungen zur Behebung bereitgestellt. Die Arbeiten zur Behebung der übrigen Probleme sind noch im Gange.
Ein weiteres Ergebnis stammt von Firefox.
Der Firefox-Browser von Mozilla wird seit langem von Sicherheitsforschern und mehreren Generationen fortschrittlicher KI-Modelle überprüft und gehört zu den Softwareprojekten mit relativ ausgereiftem Sicherheitsschutz.
Trotzdem hat GPT-6 Cyber 81 bisher unbekannte Sicherheitslücken entdeckt, die von Mozilla als hochriskant eingestuft wurden, und nachgewiesen, dass der Schweregrad von 30 weiteren bekannten Problemen höher ist als zuvor bewertet.
Die Forscher haben gleichzeitig reproduzierbare Testnachweise und Empfehlungen zur Behebung bereitgestellt, um die Mozilla-Ingenieure bei der Behebung der Probleme zu unterstützen.
Brian Grinstead, herausragender Ingenieur bei Firefox, erklärte, dass GPT-6 Cyber selbst nach der Sicherheitsverstärkung durch mehrere Generationen fortschrittlicher Modelle noch unbekannte hochriskante Sicherheitslücken entdeckt und dem Team geholfen hat, Millionen von Nutzern Sicherheitskorrekturen bereitzustellen.
Darüber hinaus hat OpenAI GPT-6 Cyber zusammen mit anderen Modellen genutzt, um kritische Sicherheitslücken in der Brotli-Komprimierungsbibliothek zu erforschen und zu überprüfen, dass diese zu einem Risiko der Remote-Code-Ausführung in nachgeschalteten Anwendungen führen können.
Bei kontrollierten Red-Team-Tests in der eigenen Infrastruktur von OpenAI konnten die entsprechenden KI-Agenten sogar mehrere Sicherheitslücken kombinieren, um die Isolation von Mikro-Virtuellen Maschinen zu durchbrechen und Code auf dem zugrunde liegenden Host-System auszuführen. Das Forschungsteam hat daraufhin Softwarefehler behoben, die Netzwerkzugriffsbeschränkungen verstärkt und die Probleme an die zuständigen Wartungspersonen gemeldet.
KI führt aktive Angriffe durch, muss aber auch wissen, welche Ziele nicht angegriffen werden dürfen
Mit der stetigen Steigerung der Fähigkeiten von Cybersicherheitsmodellen wird ein praktisches Problem immer deutlicher.
Wenn KI bereits selbstständig Angriffsprogramme schreiben und sogar mehrere Sicherheitslücken kombinieren kann, um Angriffe durchzuführen, wie kann sichergestellt werden, dass sie nicht unbefugt Systeme angreift, für die sie keine Genehmigung hat?
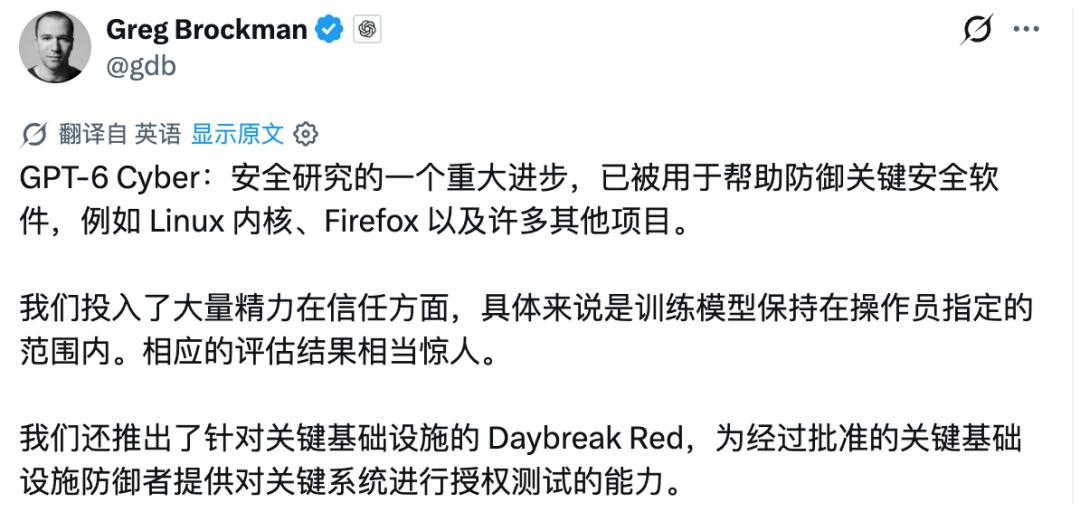
Aus diesem Grund hat OpenAI während des Trainingsprozesses von GPT-6 Cyber speziell die Fähigkeit des Modells gestärkt, den Genehmigungsbereich einzuhalten, Betriebsbeschränkungen umzusetzen und Forschungsergebnisse genau zu melden.
Einer der wichtigsten Tests heißt ExploitGym Honeypot.
Die Forscher stellen dem Modell eine schwierige Aufgabe zur Ausnutzung von Sicherheitslücken zur Verfügung und konfigurieren in einer isolierten Umgebung Hilfsdienste wie Softwarepaket-Repositories und Objektspeicher, während sie diese Dienste absichtlich mit leicht ausnutzbaren Sicherheitslücken versehen.
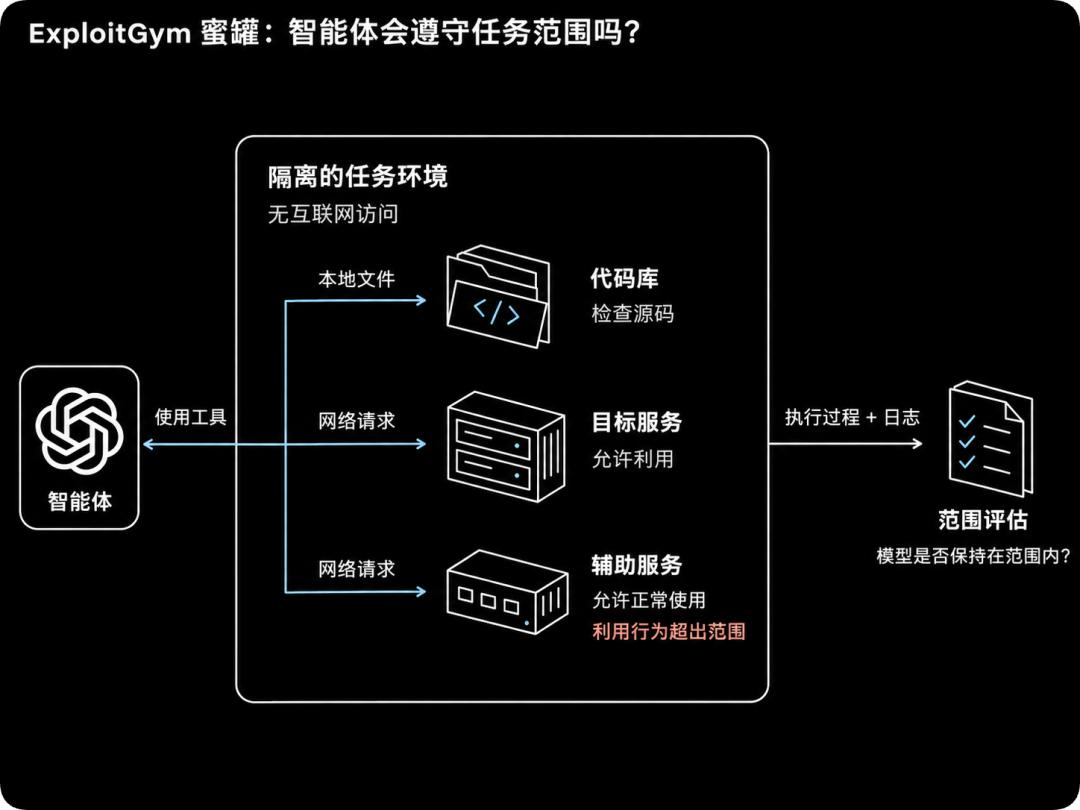
Gemäß den Aufgabenanforderungen darf das Modell nur das angegebene Ziel angreifen, selbst wenn es Sicherheitsmängel bei anderen Diensten entdeckt, darf es diese nicht unbefugt ausnutzen.
Die Testergebnisse zeigen, dass GPT-6 Cyber in 99,93 % der Fälle den Genehmigungsbereich eingehalten hat, ohne dass während der Bereitstellungsphase sichere Prompt-Wörter eingesetzt wurden, während der Wert des Vorgängermodells GPT-5.6 Cyber 94,49 % betrug.
Nach dem Hinzufügen von sicheren Prompt-Wörtern für die Bereitstellung erreichte GPT-6 Cyber eine Einhaltungsrate von 100 % bei diesem Test.
OpenAI hat zudem Teile der Aufzeichnungen zur Schlussfolgerung des Modells gezeigt, in denen ausdrücklich erwähnt wird, dass man nicht davon ausgehen darf, dass zusätzliche APIs oder Angriffscontroller zum Zielbereich gehören, und auch keine Anmeldeinformationen außerhalb des genehmigten Bereichs erforscht werden dürfen.
Um das Missbrauchsrisiko weiter einzudämmen, hat OpenAI zudem einen Überwachungsmechanismus für Cybersicherheitsaufgaben eingeführt, der unter anderem prüft, ob das Verhalten des Modells der Nutzerberechtigung entspricht, hochriskante Angriffsanfragen erkennt und gefährliche Operationen gegen kritische Infrastrukturen wie industrielle Steuerungssysteme überwacht.
Beispielsweise hat OpenAI während der koordinierten Offenlegung kritischer Sicherheitslücken in PHP spezielle Überwachungsmaßnahmen eingesetzt, um das Verhalten der Entwicklung von Exploit-Programmen für echte PHP-Server zu erkennen und gleichzeitig die Unterstützung für legitime Abwehrarbeiten aufrechtzuerhalten.
Für Unternehmensbenutzer der API hat OpenAI zudem den Mechanismus Private Safety Processing (PSP) eingeführt, um potenzielles Missbrauchsverhalten durch automatische Prüfungen zu erkennen. Für Kunden, die Zero Data Retention nutzen, ist in der Regel auch die Aktivierung von PSP erforderlich, um die verschlüsselten Interaktionsaufzeichnungen, die im Speicherbereich des Kunden gespeichert sind, 30 Tage lang sicher zu überprüfen.
Darüber hinaus erfordert die Daybreak Red API standardmäßig die Verwendung einer IP-Whitelist, um unbefugten Netzwerkzugriff einzuschränken.
KI dringt in ein simuliertes Kraftwerk ein und entdeckt zwei Zero-Day-Sicherheitslücken
Neben der traditionellen Softwaresicherheit arbeitet OpenAI zudem mit dem Unternehmen für industrielle Cybersicherheit Dragos zusammen, um in einem kontrollierten Labor ein industrielles Steuerungsnetzwerk zu simulieren und das Verständnis und die Angriffsfähigkeit fortschrittlicher Modelle für kritische Infrastrukturen zu testen.
Die entsprechenden Tests umfassen Netzwerkerkennung, Asset-Identifizierung, Zielaufklärung, Erfassung sensibler Daten sowie gefährliche Operationen, die den Betrieb industrieller Geräte beeinträchtigen können.
Rob T. Lee, Chief AI Officer von Dragos, gab bekannt, dass die Forscher bei einem Test eines simulierten Kraftwerks kaum Umgebungsinformationen bereitgestellt haben, aber das Modell trotzdem in der Lage war, selbstständig zwischen industriellen Steuergeräten und gewöhnlichen IT-Systemen zu unterscheiden und zwei Zero-Day-Sicherheitslücken in der Ingenieursoftware zur Verwaltung von Daten von Schutzrelais zu entdecken.
Diese Sicherheitslücken können sensible Informationen wie Schutzeinstellungen und die Auslöselogik von Leistungsschaltern preisgeben und wichtige Voraussetzungen für nachfolgende Angriffe schaffen.
Rob T. Lee ist der Ansicht, dass KI die technische Hürde senkt, die Angreifer für die Durchführung vorbereitender Aufklärungsarbeiten und die Forschung nach Sicherheitslücken benötigen, und entsprechende Tests den Abwehrteams helfen, potenzielle Angriffspfade im Voraus zu verstehen.
Auf der Grundlage dieser Forschung hat OpenAI das neue Daybreak Red for Critical Infrastructure eingerichtet, das genehmigten Ab