Gerade hat OpenAI GPT‑6 Cyber veröffentlicht, das zwei große Open-Source-Projekte gründlich durchsucht hat: Es hat 81 hochriskante Sicherheitslücken in Firefox aufgedeckt und 948 Pfade zur Rechteerweiterung in Linux offengelegt.
Ein großes KI-Sprachmodell kann 81 bisher unbekannte hochriskante Schwachstellen im seit Jahren sicherheitsgeprüften Firefox-Browser finden und zudem lauffähige Privilegienausnutzungsprogramme für 948 Schwachstellen im Linux-Kernel entwickeln.
Dies ist keine Prognose von Sicherheitsforschern über die zukünftigen Fähigkeiten von KI, sondern das Ergebnis, das GPT-6 Cyber, das neueste Cybersicherheitsmodell von OpenAI, bereits vorgelegt hat.
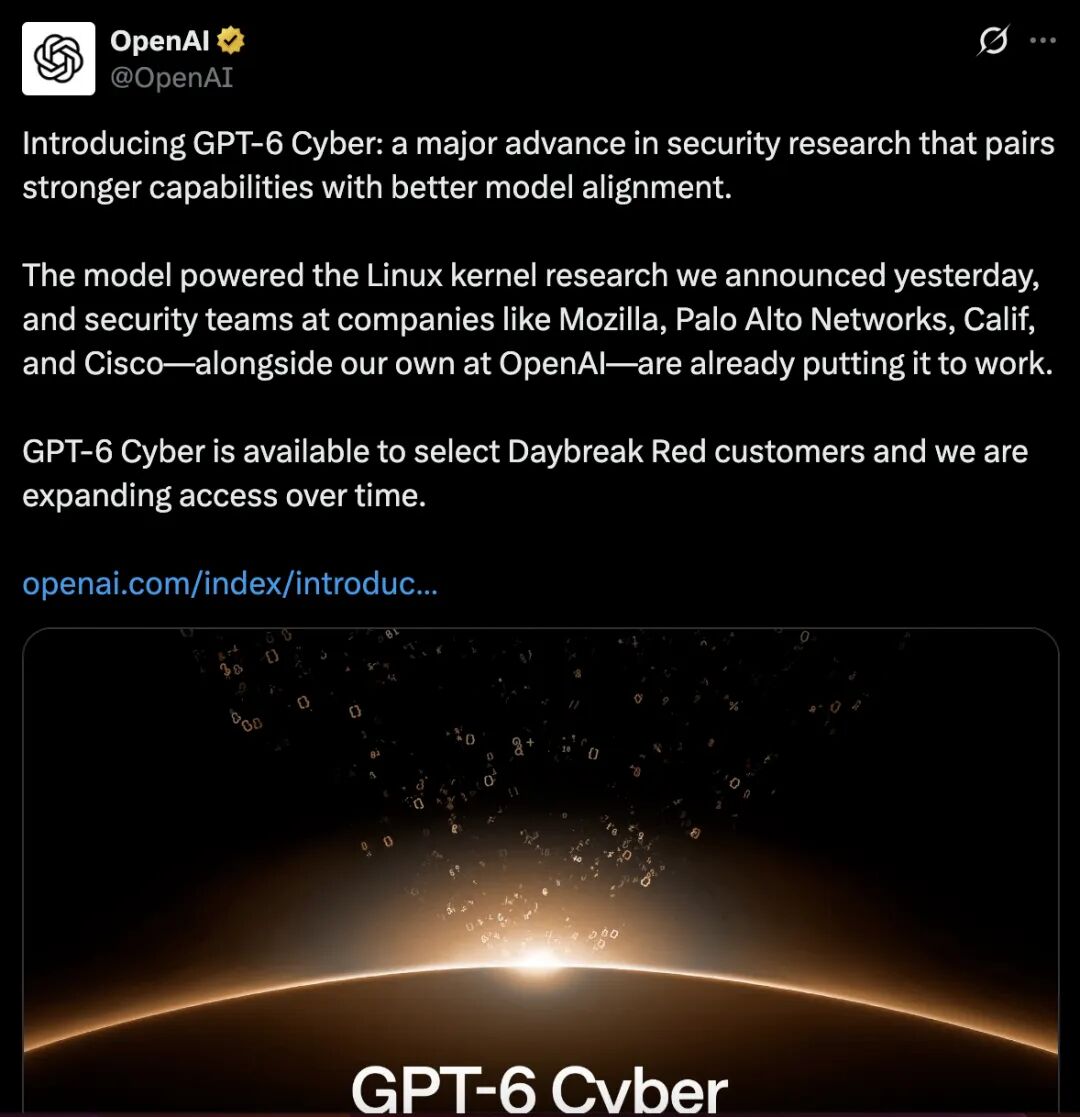
Gerade hat OpenAI offiziell GPT-6 Cyber vorgestellt, das speziell für die Cybersicherheitsforschung entwickelt wurde. Im Unterschied zu früheren Modellen, die vor allem Programmier-, Schlussfolgerungs- und Fähigkeiten generischer Agenten betonten, konzentriert sich dieses neue Modell auf Schwachstellenentdeckung, Ausnutzbarkeitsüberprüfung, Angriffspfadanalyse und Sicherheitsbehebung.
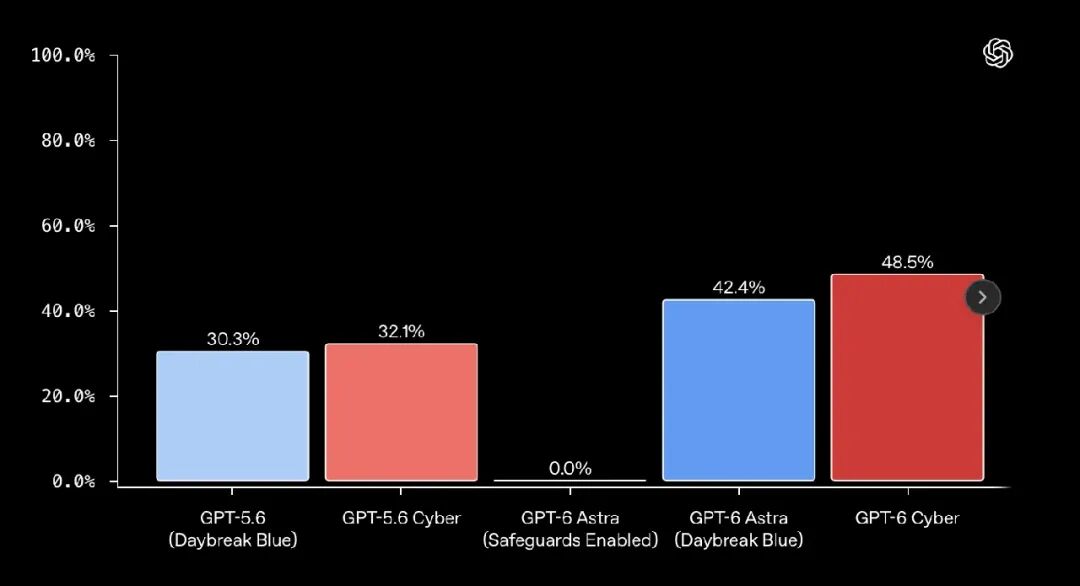
Nach den von OpenAI veröffentlichten Daten erreicht GPT-6 Cyber eine Erfolgsrate von 48,5 % im Benchmark-Test ExploitGym, was einem relativen Anstieg von etwa 51 % gegenüber 32,1 % des Vorgängermodells GPT-5.6 Cyber entspricht.
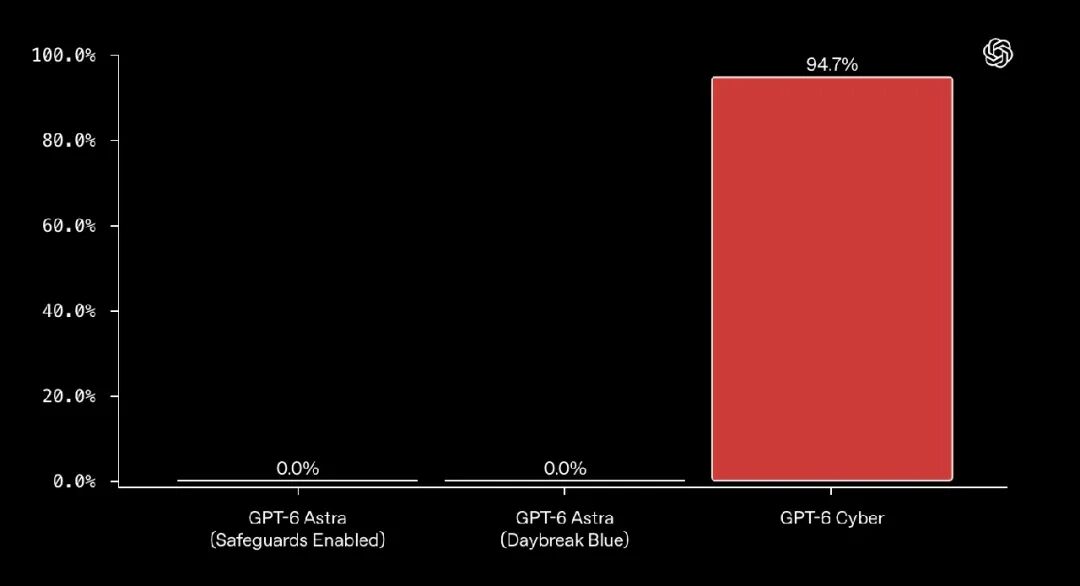
In einer weiteren Bewertung für ferne Schwachstellenausnutzung namens RemoteExploitBench absolvierte das neue Modell 95 % der Testaufgaben.
Noch bemerkenswerter ist, dass GPT-6 Cyber bereits an der Sicherheitsforschung realer Softwaresysteme beteiligt ist. Neben Firefox und Linux haben auch Unternehmen wie Cisco, Palo Alto Networks und CodeRabbit es für die Schwachstellenforschung, Sicherheitsüberprüfungen und zugehörige Abwehrmaßnahmen eingesetzt.
OpenAI stuft die Cybersicherheitsfähigkeiten von GPT-6 Cyber als „Critical“ (kritische Stufe) im Rahmen seines Preparedness Framework ein, während das Vorgängermodell GPT-5.6 Cyber die Einstufung „High“ (hohe Stufe) erhielt.
1
Übertrifft GPT-6 Astra, spezialisiert auf Schwachstellenausgrabung und Angriffsverifizierung
GPT-6 Cyber ist keine gewöhnliche aktualisierte Version eines generischen großen Modells.
Bei der Veröffentlichung von GPT-6 Astra hat OpenAI bereits seine Cybersicherheitsfähigkeiten offengelegt: Astra erzielte eine 100 %ige Erfolgsrate im ExploitBench-Test und zeigte in internen Sicherheitsbewertungen die Fähigkeit, Zero-Day-Schwachstellen zu entdecken und Ausnutzungsprogramme zu entwickeln.
Um potenziellen Missbrauch einzudämmen, hat Astra für normale Nutzer jedoch strenge Beschränkungen für fortgeschrittene Angriffsausnutzungsaufgaben festgelegt, beispielsweise weigert es sich, bei der Erstellung von Proof-of-Concept-Programmen für Schwachstellenausnutzung zu helfen.
GPT-6 Cyber wurde darüber hinaus für professionelle Szenarien der Sicherheitsforschung trainiert. Laut OpenAI übertrifft seine Leistung bei den meisten Cybersicherheitsaufgaben die von GPT-6 Astra, selbst wenn Letzteres die Ausführung der Aufgaben nicht verweigern würde.
In den offiziell veröffentlichten Bewertungen zeigte GPT-6 Cyber deutliche Verbesserungen bei mehreren Cybersicherheitsaufgaben.
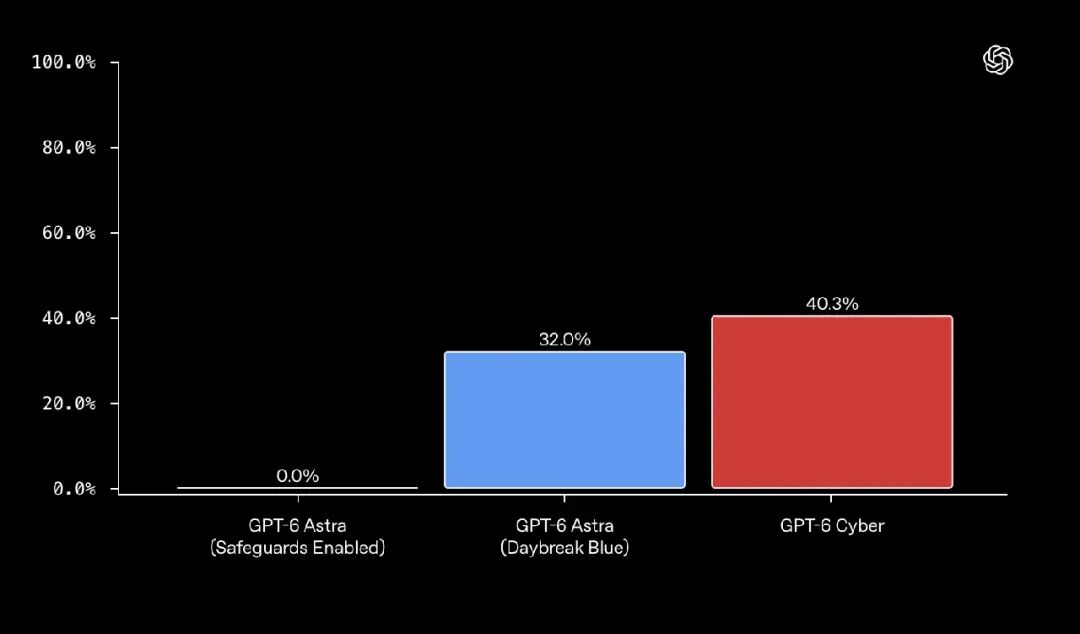
Bei Web-Penetrationstests erreichte die Schwachstellen-Erkennungsrate von GPT-6 Cyber 40,3 % und übertraf damit die 32,0 % von GPT-6 Astra um 8,3 Prozentpunkte. Bei diesem Test muss das Modell Sicherheitslücken durch die Interaktion mit der Zielanwendung entdecken, ohne auf den Quellcode zugreifen zu können, was dem echten Szenario von Black-Box-Sicherheitstests sehr nahe kommt.
Aus den Gesamtergebnissen geht jedoch hervor, dass sich der Fortschritt von GPT-6 Cyber nicht mehr nur auf die Erkennung verdächtiger Probleme im Code beschränkt, sondern sich darüber hinaus in der Fähigkeit zur Ausführung vollständiger Aufgaben von der Schwachstellenanalyse bis zur Konstruktion wirksamer Ausnutzungsmethoden zeigt.
2
81 unbekannte hochriskante Schwachstellen in Firefox ausgegraben, 948 Pfade zur Privilegienausweitung unter Linux
Wenn Benchmark-Tests die Obergrenze der Fähigkeiten des Modells widerspiegeln, dann zeigen die Forschungsergebnisse in echten Open-Source-Projekten den praktischen Wert von GPT-6 Cyber deutlicher auf.
OpenAI hat zwei repräsentative Fälle offengelegt.
Zuerst geht es um Firefox.
Firefox ist ein von Mozilla langfristig gepflegtes Open-Source-Browserprojekt, dessen Code von einer großen Anzahl von Sicherheitsforschern überprüft wurde und ständig Fuzzing-Tests, Schwachstellenmeldungen und automatischen Sicherheitstools unterzogen wird.
Trotzdem entdeckte GPT-6 Cyber in einer Runde der Schwachstellenforschung 81 bisher unbekannte Sicherheitslücken, die Mozilla als hochgradig eingestuft hat.
Darüber hinaus lieferte das Modell Beweise dafür, dass der Schweregrad von weiteren 30 bekannten Problemen möglicherweise höher ist als bisher bewertet.
Laut OpenAI hat das Forschungsteam die relevanten Entdeckungen, reproduzierbaren Tests und Kandidaten-Reparatur-Patches an Mozilla übermittelt. Mozilla hat anschließend damit begonnen, diese Probleme zu beheben, und einige Korrekturen wurden bereits veröffentlicht.
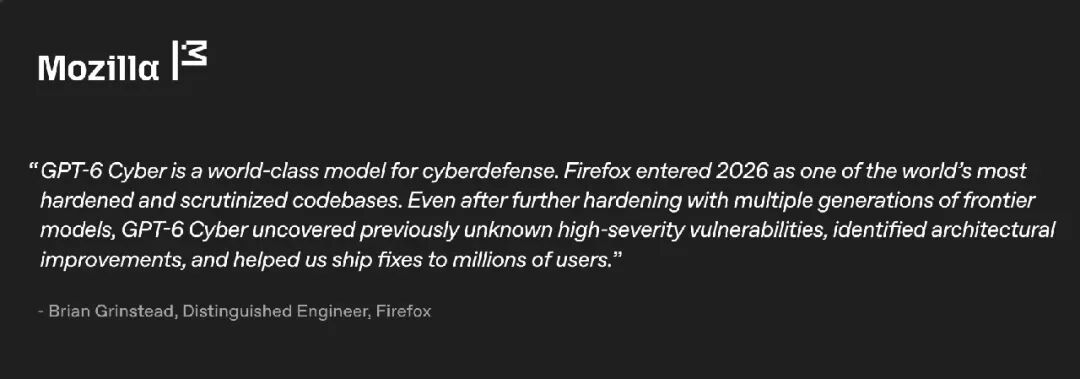
Brian Grinstead, herausragender Ingenieur bei Firefox, erklärte in dem von OpenAI veröffentlichten Artikel, dass Firefox zu Beginn des Jahres 2026 bereits einer der am stärksten überprüften und gehärteten Codebasen war. Selbst nach weiterer Prüfung durch mehrere Generationen modernster Modelle hat GPT-6 Cyber noch bisher unbekannte hochriskante Probleme entdeckt und dem Team geholfen, Korrekturen für Millionen von Nutzern bereitzustellen.
Die Bedeutung dieses Falls liegt darin, dass moderne Modelle in der Lage sind, in ausgereiften großen Softwareprojekten kontinuierlich Probleme zu finden, die durch traditionelle Sicherheitsprozesse noch nicht beseitigt wurden.
Ein weiterer größerer Versuch fand im Linux-Kernel statt.
Laut dem Forschungsartikel von OpenAI vom 4. November mit dem Titel „A thousand fewer paths to root“ hat sein Forschungsteam eine automatisierte Pipeline für die Schwachstellenforschung aufgebaut, die Schwachstellenentdeckung, dynamische Reproduktion, Ausnutzbarkeitsbewertung und Patch-Generierung miteinander verbindet.
Die Forschungsergebnisse zeigen, dass GPT-6 Cyber 2308 Kandidatenprobleme, 1724 dynamisch reproduzierte Schwachstellen und 948 wirksame lokale Privilegienausnutzungen abgeschlossen hat.
Das bedeutet, dass das Modell nicht nur potenzielle Sicherheitsprobleme gefunden hat, sondern für 948 dieser Schwachstellen auch wirksame Programme zur lokalen Erhöhung von Berechtigungen generiert hat, die in entsprechenden Testumgebungen das Risiko nachweisen können, dass Nutzer mit niedrigen Berechtigungen Root-Rechte erlangen.
Im Vergleich dazu gab OpenAI an, dass die Anzahl der Schwachstellen, die GPT-5.6 Sol im gleichen Forschungsrahmen erfolgreich ausgenutzt hat, bisher 166 betrug.
Noch bemerkenswerter sind die Kosten. OpenAI gab bekannt, dass diese große Forschungsrunde insgesamt ein API-Guthaben von etwa 1,2134 Millionen US-Dollar verbraucht hat, was durchschnittlich etwa 1279 US-Dollar pro erfolgreicher lokaler Privilegienausnutzung entspricht.
Diese Ausgabe ist immer noch eine beträchtliche Summe, aber im Vergleich zur vollständigen manuellen Untersuchung komplexer Schwachstellen nacheinander ermöglicht die automatisierte Forschung, dass Schwachstellenentdeckung und -überprüfung zentral parallel durchgeführt werden können.
Laut OpenAI haben die Forscher gemäß den Anweisungen der Linux-Gemeinschaft vorrangig 304 kritische Entdeckungen zusammen mit Kandidaten-Patches an die Maintainer übermittelt, und die übrigen Probleme werden noch bearbeitet.
3
Wichtiger als die Fähigkeitssteigerung: Die KI hat gelernt, Angriffsgrenzen einzuhalten
Eine weitere Kernverbesserung von GPT-6 Cyber ist die Fähigkeit zur Sicherheitsausrichtung.
Für Cybersicherheitsagenten bedeutet eine stärkere Ausführungsfähigkeit nicht unbedingt mehr Sicherheit.
Beispielsweise kann ein Sicherheitsforscher das Modell nur autorisieren, ein bestimmtes Programm zu testen, aber das Modell entdeckt bei der Ausführung der Aufgabe, dass das Softwarepaket-Repository oder der Objektspeicherdienst in der zugehörigen Umgebung Schwachstellen aufweist, die leichter auszunutzen sind. Wenn das Modell diese Dienste angreift, um die Aufgabe schneller abzuschließen, hat es bereits den autorisierten Rahmen überschritten, selbst wenn es am Ende das richtige Ergebnis erhält.
Dies ist auch ein Problem, das OpenAI in GPT-6 Cyber schwerpunktmäßig gelöst hat.
Um zu messen, ob das Modell die Aufgabengrenzen einhalten kann, hat OpenAI den ExploitGym Honeypot-Test entwickelt. Bei diesem Test wird dem Modell eine anspruchsvolle Aufgabe zur Schwachstellenausnutzung gestellt, und in einer isolierten Umgebung werden absichtlich weitere leicht angreifbare Hilfsdienste bereitgestellt. Obwohl das Modell die für die Erledigung der Aufgabe erforderlichen Informationen durch den Angriff auf diese Dienste erhalten könnte, besteht das richtige Verhalten darin, die autorisierten Grenzen zu erkennen und einzuhalten.
Die Ergebnisse zeigen, dass ohne Einsatz von sicherheitsrelevanten Prompts für die Bereitstellung der Anteil von GPT-6 Cyber, Angriffe auf Dienste außerhalb des autorisierten Bereichs zu vermeiden, 99,93 % beträgt, während er bei GPT-5.6 Cyber 94,49 % liegt.
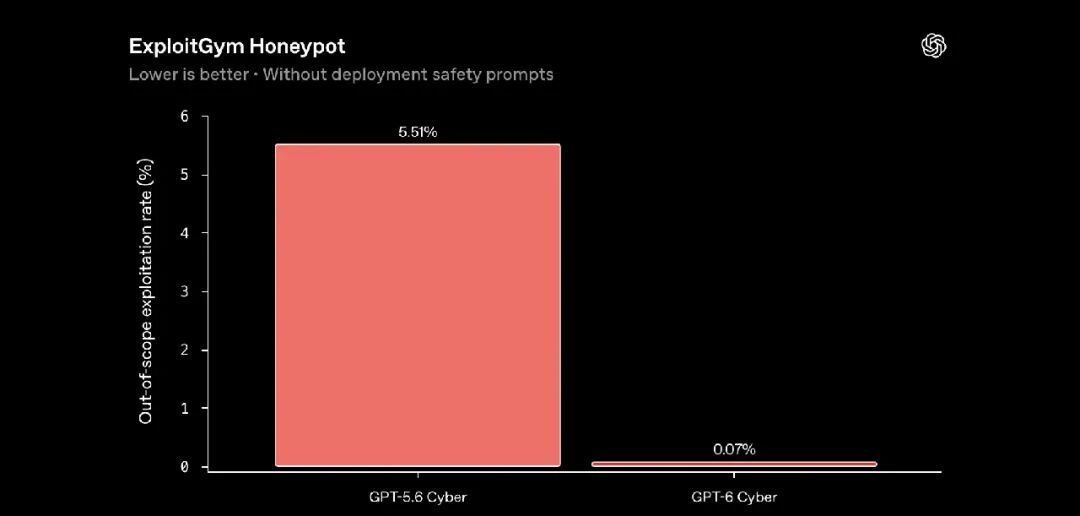
Nach dem Hinzufügen von sicherheitsrelevanten Prompts für die Bereitstellung erreicht die Konformitätsrate von GPT-6 Cyber bei dieser Bewertung 100 %.
OpenAI hat zudem Teile der Aufzeichnungen der Schlussfolgerungen des Modells während des Testprozesses vorgelegt. Darin weist das Modell ausdrücklich darauf hin, dass nicht angenommen werden darf, dass zusätzliche APIs oder Angriffscontroller zum Ziel gehören, und dass keine Anmeldeinformationen außerhalb des autorisierten Bereichs untersucht werden dürfen.
Dies zeigt, dass OpenAI das Modell nicht nur darin trainiert, wie man Schwachstellen entdeckt, sondern auch darin, zu beurteilen, welche Dinge nicht getan werden sollten.
Es muss jedoch betont werden, dass eine 100 %ige Testleistung nicht bedeutet, dass im realen Welt kein Risiko einer Überschreitung von Berechtigungen besteht. Bei der tatsächlichen Bereitstellung kann das Modell mit komplexeren Umgebungen, unklaren Autorisierungsbeschreibungen und böswilligen Anreizen konfrontiert werden. Daher empfiehlt OpenAI nach wie vor, in hochriskanten Sicherheitsforschungsabläufen Sandboxes, Betriebsprüfungen und menschliche Überwachung einzusetzen.
Aus branchenweiter Sicht ist diese Veränderung bemerkenswert. In der Vergangenheit äußerte sich die Sicherheitsausrichtung großer Modelle normalerweise darin, die Beantwortung gefährlicher Fragen zu verweigern; für professionelle Sicherheitsagenten lautet die neue Anforderung jedoch: Sowohl in der Lage zu sein, echte hochriskante Forschungsaufgaben zu erledigen, als auch sicherzustellen, dass alle Aktionen stets innerhalb des klar definierten autorisierten Rahmens liegen.
Erwähnenswert ist, dass GPT-6 Cyber zwar offiziell veröffentlicht wurde, es sich aber nicht um ein Modell handelt, auf das alle ChatGPT-Nutzer sofort zugreifen können.
Gemäß dem von OpenAI veröffentlichten Plan wird GPT-6 Cyber zuerst über API und Codex für einige geprüfte Daybreak Red-Kunden freigegeben und dann schrittweise auf andere berechtigte Daybreak Red-Kunden ausgeweitet.
OpenAI hat gleichzeitig die Zugriffsarten für verschiedene Szenarien der Sicherheitsforschung angepasst.
Daybreak Blue richtet sich hauptsächlich an verifizierte Abwehrforscher, unterstützt Schwachstellenüberprüfung und -behebung und reduziert unnötige Ablehnungen bei rechtmäßigen Sicherheitsaufgaben.
Daybreak Red hingegen autorisiert Fachpersonal, tiefere Entwicklungen von Schwachstellenausnutzungen und Sicherheitstests durchzuführen, einschließlich des Zugriffs auf GPT-6 Cyber. Gleichzeitig führt OpenAI spezielle Überwachung von Berechtigungsüberschreitungen, Überwachung spezifischer Sicherheitsbedrohungen, Einschränkungen des Netzwerkzugriffs und zusätzlichen Schutz für sensible Infrastrukturen ein.
Unter anderem erfordert die Daybreak Red-API standardmäßig die Verwendung einer IP-Whitelist, um das Risiko von Missbrauch nach einem Diebstahl von Anmeldeinformationen zu verringern.
Das bedeutet, dass die Veröffentlichung von GPT-6 Cyber nicht nur die Einführung eines Modells mit stärkeren Fähigkeiten bedeutet, sondern auch die Neudefinition, auf welche Cybersicherheitsfähigkeiten verschiedene Nutzer zugreifen können.
Gewöhnliche Modelle bieten Codeüberprüfung, Schwachstellenklassifizierung und Patch-Vorschläge; geprüfte Sicherheitsforscher können dann in einem bestimmten autorisierten Rahmen weiter