Es ist bereits von KI geknackt worden, und die Gesichtserkennung droht, „arbeitslos“ zu werden.
Wenn KI in jüngsten Cybersicherheitsvorfällen häufig eine Schlüsselrolle spielt, wird die Erkenntnis, dass KI ein zweischneidiges Schwert ist, in der Öffentlichkeit immer stärker anerkannt. KI kann Ihnen nicht nur dabei helfen, Präsentationen zu erstellen, Texte zu verfassen, Bilder zu zeichnen und Code auszugeben, sondern auch Ihre Sicherheit bedrohen. Erst kürzlich berichtete CCTV.com über einen von dem Zwischengericht der Stadt Hangzhou veröffentlichten Fall, der zeigt, dass KI-generierte Videos bereits Gesichtserkennungssysteme umgehen können.
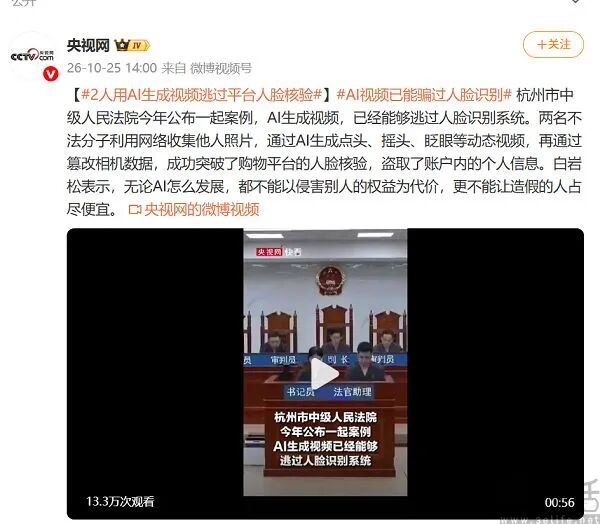
Wie bekannt ist, haben Kriminelle im Internet gesammelte Fotos anderer Personen verwendet, um über KI dynamische Videos mit Aktionen wie Nicken, Kopfschütteln und Blinzeln zu erzeugen. Anschließend haben sie durch Manipulation von Kameradaten die Gesichtsprüfung von Einkaufsplattformen erfolgreich umgangen und persönliche Informationen aus den Konten gestohlen. Dieser Fall zeigt, dass der Missbrauch der KI-Videotechnik bereits die bisherige Vertrauensordnung zu zerstören beginnt.
Nicken, Kopfschütteln und Blinzeln sind Aktionen, die wir vor der Frontkamera des Smartphones durchführen müssen, um einer App zu beweisen, dass wir wir selbst sind. Um das Jahr 2015 herum hat die Deep-Learning-Technologie die Genauigkeit der Gesichtserkennung stark verbessert, die Genauigkeit der Algorithmen hat das Niveau des menschlichen Auges übertroffen und damit technische Hindernisse für die großflächige kommerzielle Nutzung beseitigt. Bis heute ist die Gesichtserkennung zu dem Hauptverfahren für zahlreiche Internetprodukte geworden, um die Identität der Nutzer zu bestätigen.
Nicht nur Finanz-Apps wie Alipay, sondern auch E-Commerce-Plattformen wie JD.com und Taobao sowie sogar Douyin und WeChat nutzen die Gesichtserkennung in großem Umfang. Es ist zu beachten, dass die diesmal von der KI überwundene Gesichtserkennung keine 3D-Strukturlicht-Gesichtserkennung wie Face ID von iPhone ist, sondern eine 2D-Gesichtserkennung. Im Gegensatz zur 3D-Strukturlicht-Technik, die Gesichtsinformationen durch das projizierte Periskop-Strukturlicht scannt und erfasst, durch einen speziellen Algorithmus von „Punkt zu Fläche“ ein dreidimensionales Bild erzeugt und somit ein dreidimensionales Gesicht sieht, sieht die 2D-Gesichtserkennung nur eine ebene Fläche.
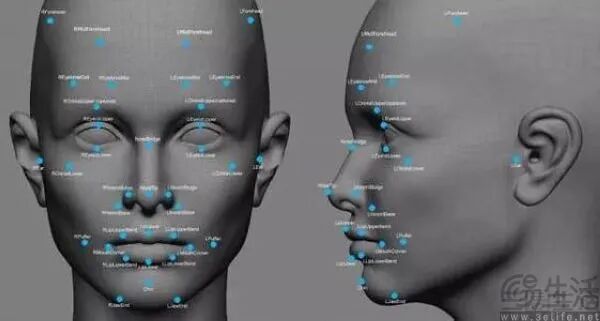
Bei dem Prozess der Gesichtserkennung bis zur Entsperrung auf dem Smartphone sind mindestens Schritte wie Gesichtserkennung, Merkmalsextraktion und Gesichtsidentifikation enthalten. Die Gesichtserkennung bedeutet wie der Name schon sagt, dass das System den Gesichtsbereich des Nutzers präzise aus dem Gesamtbild ausschneidet, um die Überprüfung durchzuführen. Bei der Merkmalsextraktion extrahiert die Computer Vision Informationen wie den Augenabstand, die Nasenbreite, die Kontur des Gesichts, die Hauttextur und die Faltenrichtung aus dem Gesicht. Bei der Gesichtsidentifikation wird das zu erkennende Gesicht mit den relevanten Daten in der Datenbank verglichen, um die Ähnlichkeit zwischen den Gesichtern mithilfe von Algorithmen zu messen.
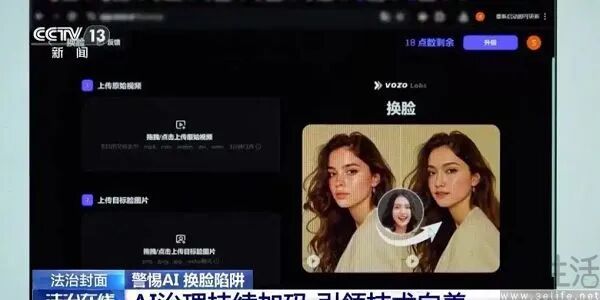
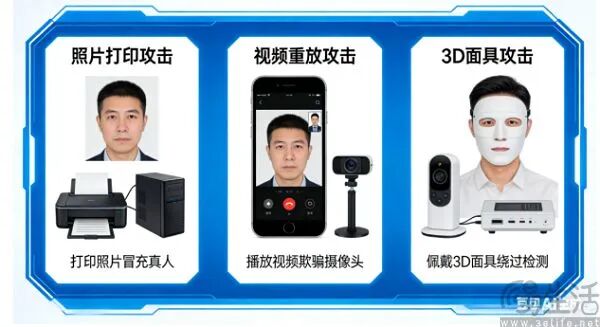
Die 2D-Gesichtserkennung weist jedoch ein tödliches Manko auf: Sie erkennt nur das Gesicht, nicht die Person selbst. Fotos, Videos und sogar Silikonmasken können sie täuschen. Aus diesem Grund haben Entwickler die „Lebenderkennung“ eingeführt. Aktionen wie Nicken, Kopfschütteln und Blinzeln dienen eigentlich dazu, zu beweisen, dass das „Gesicht“ vor der Kamera das Gesicht einer echten Person ist. Bis 2017 tauchte auf Reddit eine Technik namens Deepfake auf, die mit generativen gegnerischen Netzen (GAN) und Deep-Learning-Algorithmen sehr realistische und glaubwürdige Gesichtsaustauschvideos erzeugt.
Um Deepfakes entgegenzuwirken, nutzen Entwickler Licht, um zwischen Videos und echten Personen zu unterscheiden. Da ein echtes Gesicht dreidimensional ist, unterscheiden sich Reflexionsintensität und -winkel verschiedener Teile (z. B. Nase, Wangen, Augen) bei Lichteinfall. Außerdem absorbiert die echte, wasserhaltige Haut einen Teil des Lichts. Fotos und Masken hingegen sind eben und weisen nur ein einheitliches Lichtreflexionsmuster auf. Der Gesichtserkennungsalgorithmus kann Fälschungen leicht erkennen, indem er die feinen Unterschiede der Lichtreflexion vergleicht.
Herkömmliche Deepfake-Inhalte können die echte Reaktion des Lichts auf das menschliche Gesicht nicht wiedergeben, aber KI-Videomodelle schaffen das. Bereits im Jahr 2024, als OpenAI Sora veröffentlichte, wurde es als „Weltensimulator“ bezeichnet. KI kann die Funktionsweise der realen Welt verstehen, vorhersagen und ableiten, einschließlich physikalischer Gesetze, Kausalzusammenhänge und Bewegungen von Objekten.
Bis heute sind Weltmodelle nichts Neues mehr. Die modernste KI kann bereits verstehen, „warum Wasser nach unten fließt“ und „warum ein Ball von einer Wand abprallt“. SOTA-KI-Videomodelle wie Seedance und Keling können bereits so realistisch erzeugt werden, dass man sie kaum von echten Videos unterscheiden kann. Ein KI-Videoersteller hat ausgerufen: „War das KI-Video von Will Smith, der Nudeln isst, früher nicht auch nur ein Witz? Und was ist heute daraus geworden?“
Bereits 2023 wurde das KI-Video von Will Smith, der Spaghetti isst, von Internetnutzern verspottet, es sehe aus wie „eine zahnlose alte Frau, die Luft kaut“. Es gab Fehler wie Gabeln, die durch das Gesicht dringen, Nudeln, die sich wie Schlangen winden, und Kaubewegungen, die wie bei einer Marionette wirken. Das gesamte Video wirkte wie ein Horrorfilm oder ein absurdes Meme-Material. Heute ist „Kinogleichwertige Bildqualität“ bereits zum Standard für hochwertige KI-Inhalte auf Plattformen wie Douyin und Kuaishou geworden.
Mit anderen Worten: Die heutigen Top-KI-Videomodelle können verstehen, wie verschiedene Lichtverhältnisse auf einem menschlichen Gesicht aussehen sollten. Solange Hacker sich die Mühe machen, öffentlich veröffentlichte Fotos von Nutzern zu sammeln und sie der KI zuzuführen, ist es theoretisch machbar, ein sehr lebensechtes Video zu erzeugen, das die nicht auf 3D-Strukturlicht basierende Gesichtserkennung täuscht.
Das KI-Modell analysiert den Inhalt von Bildern, erkennt Elemente wie Subjekt, Hintergrund und Licht-Schatten-Verhältnisse und erzeugt dann auf Basis von Prompt-Anweisungen fortlaufende dynamische Frames, die zu einem flüssigen Video zusammengesetzt werden. Diese Vorgehensweise ist bereits die grundlegende Nutzung von KI-Videomodellen. Je mehr und je detaillierter die Bilder als Schlüsselbilder sind, desto steuerbarer, kohärenter und realistischer wird das von der KI erzeugte Video.
In gewisser Hinsicht ist der von CCTV.com gemeldete Fall, dass KI-Videos bereits Gesichtserkennung täuschen können, eigentlich das Ergebnis einer Kombination neuer Technologie und Social Engineering. Umgekehrt gilt: Wenn Sie fast keine Fotos Ihres täglichen Lebens im öffentlichen Internet veröffentlichen, haben Hacker keine Grundlage, um KI-Videos für Sie zu erstellen.
Aber nach mehr als zwanzig Jahren Einfluss verschiedener sozialer Apps wie QQ, Facebook, Instagram und WeChat sowie der Prägung durch die „Selfie-Kultur“ gibt es kaum Menschen, die fast keine Fotos im Internet veröffentlichen. Daher ist die Täuschung echter Personen durch KI-Videomodelle keine Bedrohung, der nur wenige Menschen gegenüberstehen, sondern eine Herausforderung, der sich die gesamte Gesellschaft gemeinsam stellen muss.
Es ist fast abzusehen, dass mit der schrittweisen Weiterentwicklung der Fähigkeiten von KI-Videomodellen und deren Annäherung an Weltmodelle ihre Fähigkeit, die Funktionsgesetze der Welt zu verstehen, ständig weiterentwickelt wird, sodass immer mehr Internetplattformen von KI getäuscht werden können.
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „San Yi Leben“ (ID: IT-3eLife), Autor: San Yi Jun, veröffentlicht mit Genehmigung von 36Kr.