Kann das Modell die Pose von 3D-Objekten wahrnehmen und anpassen? Der erste interaktive räumliche Inferenz-Benchmark für Projektionsausrichtung
Nachdem ein Objekt erkannt wurde, kann es auch aus einem anderen Blickwinkel identifiziert werden, und man kann sich weiter vorstellen, wie es nach einer Drehung aussieht – all dies hängt mit der räumlichen Wahrnehmung zusammen. Menschen müssen die Form und Ausrichtung von Objekten im Geiste darstellen, die Beziehungen zwischen verschiedenen Blickwinkeln verstehen und die dreidimensionale Geometrie aus zweidimensionalen Projektionen ableiten.
Wenn visuelle Sprachmodelle in interaktive Szenarien eintreten, muss dieses Verständnis zudem in Handlungen umgesetzt werden. Eine einzelne Drehung verändert die Konturen, Proportionen und Verdeckungsverhältnisse des Objekts; das Modell muss die Veränderung zunächst vorhersagen, dann das Ausführungsergebnis beobachten und entscheiden, wie der nächste Schritt anzupassen ist. Kann die korrekte Beantwortung einer räumlichen Beziehungsfrage eine solche kontinuierliche Haltungssteuerung weiter unterstützen?
Bestehende Benchmarks legen jeweils unterschiedliche Schwerpunkte. Statische Benchmarks bewerten das räumliche Schlussfolgern in der Regel anhand von Fragen und Antworten auf feststehenden Bildern, fehlen aber an Handlungsausführung und geschlossenem Feedback; viele interaktive Benchmarks konzentrieren sich auf Aufgabenplanung, Tool-Aufruf oder Pfadsuche. Diese Aufgaben können die Interaktionsfähigkeit prüfen, sind aber schwer in der Lage, gezielt zu überprüfen, ob das Modell dreidimensionale Ausrichtungen aus visuellen Hinweisen verstehen und dieses Verständnis in präzise Drehungen umwandeln kann.
Daher können visuelle Sprachmodelle zweidimensionale Beobachtungen in ein dreidimensionales Verständnis umwandeln, das präzise Handlungen unterstützt?
Dies erfordert, dass das Modell die Geometrie und Haltung des Objekts verknüpft, den Einfluss der Drehung auf die Projektion vorhersagt und die neuen Beobachtungen nach der Handlung zur ständigen Korrektur nutzt. Für Agenten, die Umgebungen erkunden, Geometrie verstehen und Handlungen durchführen müssen, verbinden diese Urteile die visuelle Wahrnehmung mit der praktischen Steuerung – genau die Fähigkeiten, die die Branche durch Bewertungen weiter beobachten möchte.
Aus diesem Grund hat das Team der Xiamen University und der Nanyang Technological University RoTA-Bench vorgeschlagen, um diese Fähigkeit durch interaktive 3D-zu-2D-Projektionsausrichtung zu bewerten.
Link zum Paper: https://arxiv.org/abs/2610.17665
Code und Datensatz: https://github.com/MAC-AutoML/RoTA-Bench
Online-Demo: https://www.modelscope.cn/studios/san2333333/rotabench-anon?mode=full&app_path=%2Fportal
Hugging Face: https://huggingface.co/papers/2610.17665
Im Folgenden ist die Interaktionsoberfläche einer echten Aufgabe in RoTA-Bench dargestellt. Oben links im Bild befindet sich die Zielkontur in Form eines T-Shirts, unten links die aktuelle Projektion des Objekts und rechts die Ansicht des Objekts mit Tiefenschattierung. Die Aufgabe besteht darin, eine Drehbewegung auszuwählen, um die aktuelle Projektion schrittweise an die Zielkontur auszurichten.
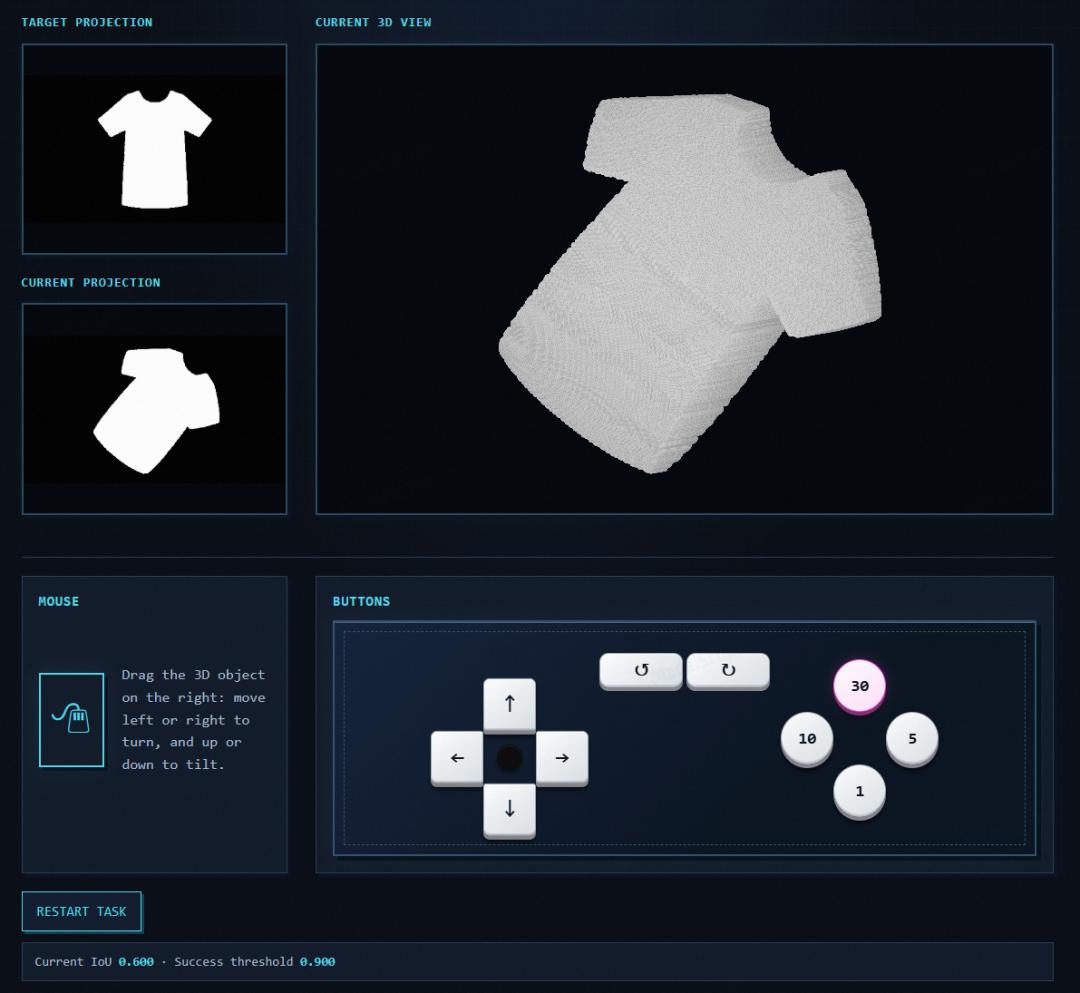
Beispiel für eine echte Aufgabe in RoTA-Bench. Oben links im Bild befindet sich die Zielkontur, unten links die aktuelle Projektion und rechts die unterstützende Ansicht mit Tiefenschattierung; die Schaltflächen unten dienen zur Auswahl von Drehrichtung und -winkel.
Erst ein wenig nach links drehen oder erst nach oben kippen? Soll dieser Schritt um 30° gedreht werden oder nur um 5° angepasst werden? Die Regeln sind intuitiv, aber bei jedem Schritt muss das zweidimensionale Bild mit der dreidimensionalen Haltung verknüpft werden.
Im Experiment erreichte GPT-5.6-Sol eine Erfolgsrate von 17 % bei 100 Testaufgaben; 400 Aufgabenläufe, die gemeinsam von 20 Bachelorstudenten abgeschlossen wurden, waren alle erfolgreich.
Diese Lücke verdient eine weitere detaillierte Betrachtung: Bei welchem Schritt stößt das Modell auf Schwierigkeiten? Bedeutet eine Kontur, die dem Ziel ähnlicher sieht, auch dass die dreidimensionale Haltung korrekter gedreht wurde?
Wie soll der nächste Schritt nach dem Betrachten dieses Bildes gedreht werden?
Nehmen wir das vorherige T-Shirt-Beispiel: Links- und Rechtsdrehung können die Konturen auf beiden Seiten verändern, ein Hochkippen kann das Gesamtverhältnis verändern; wenn dasselbe Objekt eine andere Ausrichtung erhält, kann auch eine Verdeckung auftreten. Das Modell muss die vor ihm liegende Projektion mit der dahinterstehenden dreidimensionalen Haltung verknüpfen und beurteilen, um welche Achse, in welche Richtung und um welchen Winkel gedreht werden soll.
In RoTA-Bench sieht das Modell bei jedem Schritt drei Teile von Informationen: die Zielkontur, die aktuelle Projektion und die unterstützende Ansicht mit Tiefenschattierung aus demselben Blickwinkel wie die aktuelle Projektion. Die unterstützende Ansicht ergänzt die in der binären Kontur fehlenden Hinweise zu Tiefe und Verdeckung.
Anschließend wählt das Modell den nächsten Schritt aus 24 diskreten Drehbewegungen aus: drei Drehachsen, zwei Richtungen (vorwärts und rückwärts), kombiniert mit vier Schrittweiten von 1°, 5°, 10°, 30°. Nach jeder Ausführung rendert die Umgebung das Bild neu, und das Modell nutzt die aktualisierten Beobachtungen und den Interaktionsverlauf zur weiteren Anpassung.
Hier sind sowohl größere Drehungen erforderlich, als auch Raum für Feinabstimmungen vorgesehen. Wenn die Ausrichtung noch stark abweicht, kann eine größere Schrittweite gewählt werden; wenn man sich dem Ziel nähert, können kleinere Winkel ausprobiert werden.
Die Aufgabe ist erfolgreich, wenn das Intersection over Union (IoU) zwischen aktueller Projektion und Zielkontur 0,90 erreicht. IoU misst den Überlappungsgrad der beiden Konturen – je höher der Wert, desto ähnlicher ist die Projektion. Die Bewertung erlaubt maximal 48 Entscheidungen und verfügt über Regeln für aktives Anhalten und Beenden bei Stillstand.
Die Forscher haben die Interaktion auf reine Drehung beschränkt, um das dreidimensionale Ausrichtungsschlussfolgern von Faktoren wie Translation, Greifen und Kontaktreibung zu trennen und das Problem auf „Wie steuert man die Haltung anhand visueller Beweise“ zu konzentrieren.
Woher stammen diese Objekte? Warum ist sichergestellt, dass man sie zurückdrehen kann?
Wenn man direkt gängige dreidimensionale Objekte verwendet, könnte das Modell Urteile anhand von Prioritäten vertrauter Formen treffen.
Um solche semantischen Abkürzungen zu reduzieren, haben die Forscher ausgehend von zweidimensionalen Vektorsymbolen dreidimensionale Objekte unter der Einschränkung eines kugelförmigen Volumens konstruiert. Die generierten Objekte können das Originalbild unter der standardmäßigen Frontalprojektion wiederherstellen und Details beibehalten.
Anschließend wird das Objekt durch eine Kette umkehrbarer diskreter Drehungen in die Anfangshaltung versetzt. Da jeder Schritt umgekehrt werden kann, kann man durch umgekehrte Drehungen zur Zielhaltung zurückkehren, was die Lösbarkeit der Aufgabe aus dem Konstruktionsprozess heraus sicherstellt.
Auf dieser Grundlage haben die Forscher weiter Referenzpfade gesucht und validiert, und die Testaufgaben nach der Länge der Referenzpfade geschichtet ausgewählt. Die Referenzpfade dienen hier zur Aufgabenauswahl und -analyse, garantieren nicht die kürzeste Lösung und werden dem getesteten Modell nicht zur Verfügung gestellt.
Schließlich umfasst RoTA-Bench 674 Aufgaben, von denen 100 Aufgaben einen eingefrorenen Testsatz bilden, während die restlichen 574 für nachfolgendes Training und Forschung zur Verfügung stehen.
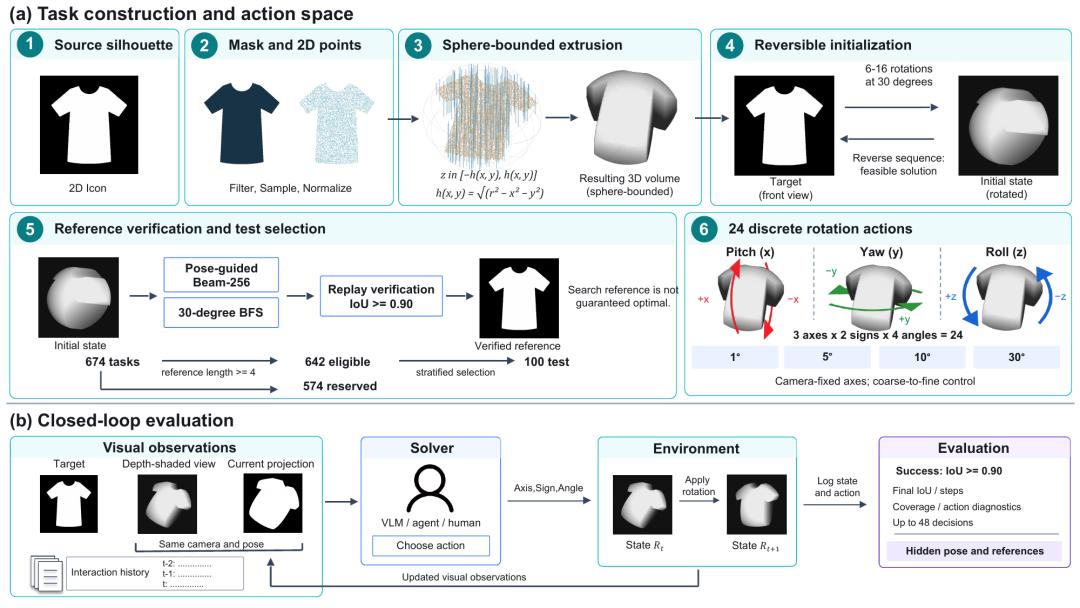
Aufgabenkonstruktion und geschlossener Bewertungsablauf (Bild 2 des Papers). Der obere Teil des Bildes zeigt den Prozess der Generierung dreidimensionaler Objekte aus zweidimensionalen Symbolen, der Initialisierung durch umkehrbare Drehungen, der Validierung von Referenzpfaden und der Auswahl von Testaufgaben; der untere Teil zeigt die geschlossene Bewertung von „Beobachten – Drehung auswählen – Bild aktualisieren“.
Bei denselben Aufgaben: Wie groß ist der Unterschied zwischen Menschen und Modellen?
Die Forscher haben 9 visuelle Sprachmodelle und 2 Agentenkonfigurationen bewertet und 20 Bachelorstudenten eingeladen, an menschlichen Experimenten teilzunehmen.
Bei 100 Testaufgaben betrug die Erfolgsrate von GPT-5.6-Sol 17 %, die höchste beobachtete Modellerfolgsrate bei dieser Bewertung. Im menschlichen Experiment absolvierte jeder Teilnehmer einen Block mit 20 Aufgaben; 20 Teilnehmer deckten den gesamten Testsatz insgesamt viermal ab, mit insgesamt 400 Aufgabenläufen, die alle erfolgreich waren.
Menschen und Modelle verwenden dieselben Aufgaben, visuellen Beobachtungen, Drehbewegungsräume, Entscheidungsbudgets und Erfolgsstandards. Menschen übermitteln Handlungen über Schaltflächen, Modelle über strukturierte Ausgaben – beide werden letztendlich auf dieselben Drehoperationen abgebildet.
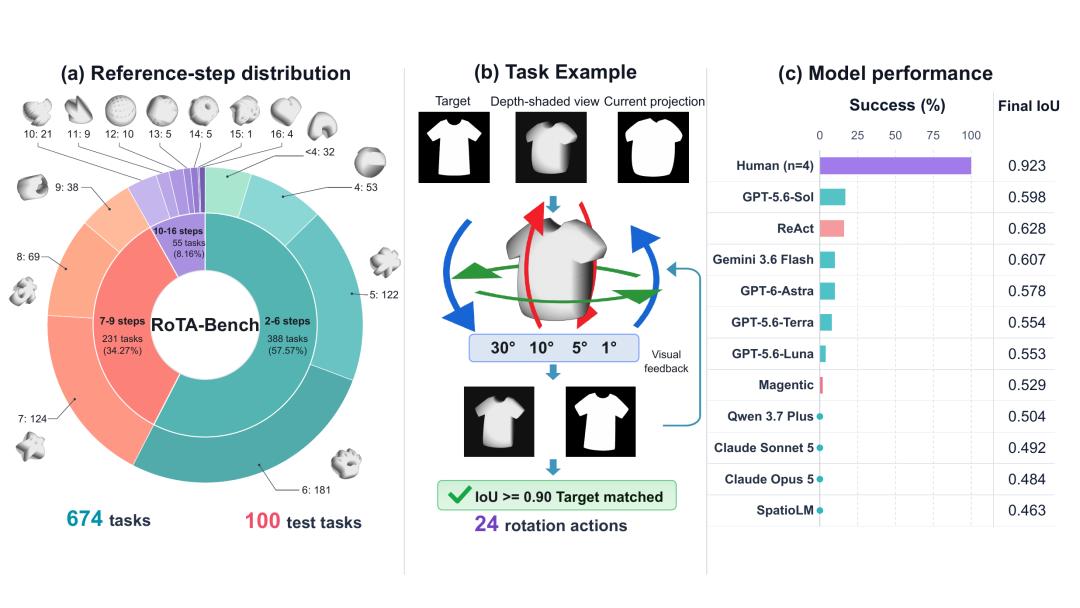
Übersicht über RoTA-Bench (Bild 1 des Papers). Links im Bild befindet sich die Längenverteilung der Referenzpfade, in der Mitte das Beispiel der T-Shirt-Aufgabe, rechts die Erfolgsrate des Testsatzes und der endgültige IoU. Die menschlichen Ergebnisse fassen die vier Läufe jeder Testaufgabe zusammen.
Auch im Drehprozess ist der Unterschied sichtbar. Der durchschnittliche IoU der menschlichen Trajektorie steigt insgesamt mit dem Fortschreiten der Handlungen an und überschreitet schließlich die Erfolgsgrenze; die Modelltrajektorie erreicht dagegen früh ein Plateau, wobei die meisten Werte im Bereich von 0,50 bis 0,63 liegen.
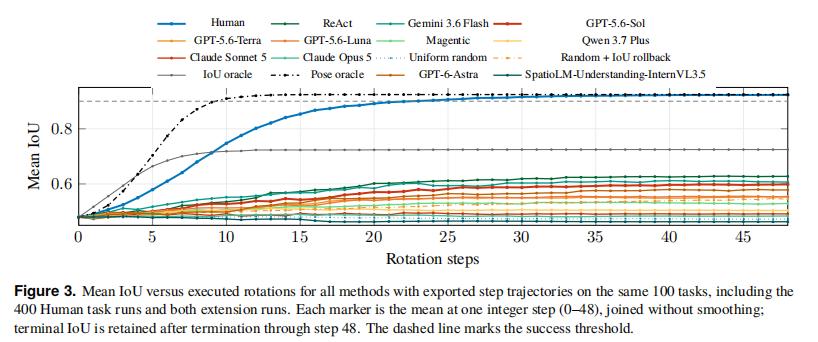
Veränderung des durchschnittlichen Projektions-IoU mit der Anzahl der ausgeführten Drehschritte (Bild 3 des Papers). Die Ergebnisse basieren auf derselben Gruppe von 100 Testaufgaben, einschließlich 400 menschlicher Läufe; die gestrichelte Linie markiert die Erfolgsgrenze von 0,90. Nach dem vorzeitigen Ende der Aufgabe wird der endgültige IoU bis zum 48. Schritt beibehalten.
Aber die Erfolgsrate sagt nur aus, ob die Aufgabe am Ende abgeschlossen wurde. Um den Unterschied zu verstehen, muss man zu jedem einzelnen Schritt zurückkehren: Ist die Richtung richtig gewählt, ist der Winkel angemessen, stimmen die Veränderungen der Projektion und die der dreidimensionalen Haltung überein?
Wohin drehen und um wie viele Grad – wo liegen die jeweiligen Schwierigkeiten?
Hat das Modell die Aufgabe nicht abgeschlossen, liegt das vielleicht nur daran, dass es nicht genug von der Oberfläche des Objekts gesehen hat? Das Paper prüft zunächst die kumulative Beobachtungsabdeckung der Oberfläche: Bei GPT-5.6-Sol beträgt sie 79,58 %, bei Menschen 83,07 %. Die Gesamtabdeckung beider ist ähnlich, aber welche Bereiche genau gesehen wurden und wie diese Beobachtungen genutzt werden, können sich noch unterscheiden.
Daher zerlegen die Forscher jede Drehung weiter in zwei Auswahlmöglichkeiten: die Richtung, also die Drehachse und die positive/negative Richtung; der Winkel, also wie groß die Drehung in diesem Schritt ist.
Zuerst zur Richtung: Wenn es entlang einer bestimmten Richtung mindestens einen gültigen Winkel gibt, der den dreidimensionalen Haltungsfehler verringern kann, wird diese Richtung als „gültige Richtung“ bezeichnet.
Der Anteil, in dem GPT-5.6-Sol eine gültige Richtung wählt, beträgt 58,75 %, bei Menschen 83,91 %; der entsprechende Wert bei gleichmäßig zufälliger Auswahl liegt bei 53,78 %. Dies zeigt, dass die Auswahl einer Drehrichtung, die die Haltung verbessern kann, bereits eine schwierige Aufgabe für das Modell darstellt.
Zum Winkel: Selbst wenn die gültige Richtung ausgewählt wurde, kann ein zu großes oder zu kleines Drehen die Ausrichtung beeinträchtigen. Die Forscher vergleichen innerhalb der ausgewählten gültigen Richtungen den von dem Modell gewählten Winkel mit dem gültigen Winkel, der den Haltungsfehler am stärksten verringert. Der durchschnittliche Winkelunterschied von GPT-5.6-Sol beträgt 6,49°, bei Menschen 2,99°; der Anteil der Auswahl des optimalen gültigen Winkels liegt bei 61,80 % bzw. 71,82 %.
