Das viral gegangene „Astra modifiziert das Qwen-Gehirn“ hat kaum etwas mit dem von uns angestrebten RSI zu tun
Am 2. November veröffentlichten vier Forscher des MIT CSAIL – Rikiya Takehi, Jayden Teoh, Alex Zhang und Omar Khattab – einen Blogbeitrag mit dem Titel „Sparks of Weight-Space Programming“.
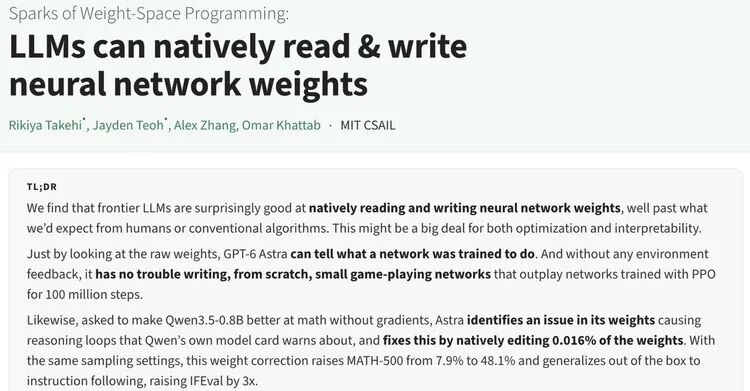
Das Aufsehenerregendste Ergebnis: GPT-6 Astra hat direkt die Gewichte von Qwen3.5-0.8B umgeschrieben, wobei 131.072 Zahlen verändert wurden – das entspricht etwa 0,016 % aller Parameter. Dadurch stieg die Leistung dieses kleinen Modells auf MATH-500 von 7,9 % auf 48,1 %, auf GSM8K von 13,8 % auf 67,1 % und im Befehlsbefolgungstest IFEval von 21,0 % auf 62,3 %.
Dies löste sofort hitzige Diskussionen in allen Kreisen aus.
In demselben Blogbeitrag gibt es noch eine Szene, die eher wie aus einem Science-Fiction-Film wirkt: Ohne dass ein Bild gezeigt, der Name des Spiels genannt oder das Spiel ausgeführt wird, wurden Astra lediglich die 17.253 Gewichte eines Reinforcement-Learning-Netzwerks als Text übergeben – es erkannte, dass es sich um das Spiel Breakout handelt, mit einer Konfidenz von 99 %. Als man ihm dann die Spielregeln und ein Netzwerk mit vollständig auf Null gesetzten Gewichten gab, schrieb es die Parameter auf einmal aus. Dieses noch nie zuvor getestete Netzwerk erzielte bei Breakout eine Punktzahl von 517,4, während die PPO-Baseline, die 100 Millionen Schritte trainiert wurde, nur 15,8 Punkte erreichte.
Gewichte lesen, Gewichte verändern, Gewichte schreiben: KI kann bereits die „Gedankengänge“ einer anderen KI verstehen und sie aktiv verändern. Wann wird sie sich dann selbst verändern? Wenn man alle diese Hinweise zusammennimmt, kommt man unweigerlich auf einen heute sehr populären Begriff:
RSI.
Die Titel der Beiträge lauten überall „Radikale Veränderung des Qwen-Gehirns“, „Dem Qwen das Gehirn umschreiben“, „KI beginnt, das Gehirn anderer zu verändern“ und „Genbearbeitung neuronaler Netze“. Die Autoren selbst haben dies auch in den Ausblick des Blogbeitrags aufgenommen, und ihr Beitrag auf X erreichte innerhalb eines Tages mehr als 5 Millionen Aufrufe.
Während wir aufgeregt waren, haben wir uns etwas Zeit genommen, das öffentliche Repository dieser Experimentreihe durchzusehen.
Das Repository enthält die protokollierten Protokolle von 1.125 Modellaufrufen, die Prompts, die Astra in jeder Runde erhalten hat, seine Antworten, jeden Codeabschnitt, den es ausgeführt hat, die wichtigsten Bewertungsergebnisse und den endgültigen Patch.
Aber nach der Durchsicht haben wir zwei wenig spektakuläre Feststellungen getroffen.
Erstens lässt sich der Anstieg von 7,9 % auf 48,1 % viel einfacher erklären: Qwen hatte ursprünglich einen Bug, bei dem es sich ständig wiederholte und nicht aufhören konnte. Astra hat diesen Bug behoben, und die Punktzahl ist dadurch gestiegen;
Zweitens beruhen alle Fähigkeiten, die die KI in dieser Experimentreihe gezeigt hat, auf der Ausführung eines sehr spezifischen, von Menschen festgelegten Ziels.
Sie hat den Ausführungsprozess automatisiert und ihn sehr gut durchgeführt, aber alle Beweise deuten darauf hin, dass sie das Ziel nicht verstanden hat, geschweige denn ein anderes Modell wirklich verstanden hat.
Nachdem wir diese Arbeit und die daraus resultierenden Diskussionen untersucht haben, sind wir der Meinung, dass sie genau das größte Problem von RSI heute aufdeckt.
„Eindringen in die Gedankengänge“
Im Folgenden werfen wir einen genaueren Blick auf diese Forschung.
Ein neuronales Netzwerk besteht aus mehreren Schichten von Matrizen, und jede Zahl in der Matrix ist ein „Gewicht“. Die Eingabe wird schichtweise mit diesen Zahlen multipliziert und ergibt schließlich die Ausgabe. Alle Fähigkeiten des Modells sind in diesen Zehntausenden, Hunderten Millionen oder Milliarden von Zahlen gespeichert, und das Training besteht darin, diese Zahlen anzupassen. Normalerweise befassen wir uns bei der Arbeit mit Modellen nur mit Eingaben und Ausgaben, niemand liest die Gewichte selbst, da sie nur wie eine Ansammlung von Zahlen aussehen.
Das Ziel dieser Experimentreihe ist es, Astra diese Zahlen lesen zu lassen.
Der Blogbeitrag umfasst insgesamt acht Experimente, deren Hauptakteur GPT-6 Astra ist, und die Nebenakteure sind eine Reihe von Netzwerken:
Vier Reinforcement-Learning-Strategienetzwerke, die kleine Spiele spielen;
Drei kleine Diffusionsmodelle, die geometrische Formen zeichnen;
Drei kleine Sprachmodelle mit nur vier Schichten;
Ein Netzwerk zur Steuerung eines Autos, das vor einer Rampe steckenbleibt;
Ein Go-Netzwerk mit 1,48 Millionen Parametern;
Mehrere Paare von feinabgestimmten Gemma 3 270M;
Und schließlich Qwen3.5-0.8B.
Jedes Experiment folgt dem gleichen Muster: Astra erhält die Gewichte und die Strukturbeschreibung eines Netzwerks sowie eine Aufgabe.
Es gibt vier Gruppen von „Lesexperimenten“.
Man erhält die Gewichte eines Strategienetzwerks und muss beurteilen, welches Spiel es spielt; man erhält die Gewichte eines Diffusionsmodells und muss sagen, welche Form es zeichnen wird; man erhält ein kleines Sprachmodell, bei dem Ein- und Ausgabeschichten entfernt wurden und nur die vier mittleren Schichten übrig bleiben, muss beurteilen, mit welcher Art von Korpus es trainiert wurde, und den Attention-Head finden, der für das „fortlaufende Kopieren des vorherigen Textes“ zuständig ist; man erhält zwei Gemma-Modelle und muss beurteilen, welches davon zu einem „schmeichelhaften Modell“ trainiert wurde, das den Nutzern zustimmt.
Es gibt zwei Gruppen von „Schreibexperimenten“.
Man gibt ihm die Regeln, den Quellcode von drei MinAtar-Kleinsspielen und ein Netzwerk mit vollständig auf Null gesetzten Gewichten, und lässt es direkt spielbare Parameter schreiben; dann gibt man ihm ein 9-Steine-Go-Netzwerk und lässt es von Grund auf ein Modell schreiben, das Go spielen kann.
Es gibt ebenfalls zwei Gruppen von „Veränderungsexperimenten“.
Eine Gruppe dient der Reparatur des Autos: Ein von PPO trainiertes Steuernetzwerk bleibt vor einer Rampe stecken. Astra verändert 3,5 % der Gewichte, sodass es rückwärts fahren und dann die Rampe hinauffahren lernt. Die andere Gruppe betrifft Qwen: Es soll die Gewichte verändern, um die Mathematikleistung zu verbessern. Später haben die Forscher das Experiment noch einmal auf Gemma 3 270M wiederholt.
Diese Designs sind äußerst interessant. Das ist auch einer der wichtigsten Gründe, warum diese Arbeit so aussieht, als handele es sich um RSI.
Die Vorstellung von RSI erfordert drei Komponenten: Die KI muss verstehen, was im Inneren des Modells vor sich geht, sie muss entsprechend Veränderungen vornehmen können, und das veränderte Modell muss leistungsfähiger sein.
Die oben entworfenen drei Arten von Experimenten zum Lesen, Schreiben und Verändern entsprechen jeweils genau einer dieser Komponenten.
Da zudem ein Sprachmodell verändert wurde und ein anderes Sprachmodell die Veränderung vorgenommen hat, ist die Vorstellung von „Modell verändert Modell“ perfekt abgebildet.
Wenn man in diese Richtung weiterdenkt: Wenn Astra Qwen verändern kann, kann es dann im nächsten Schritt auch Astra selbst verändern? Die Autoren haben am Ende des Blogbeitrags fünf Anwendungsbereiche aufgelistet, wobei das rekursive Selbstverbessern einer davon ist, und das Übertragen des Inferenzmoduls eines Modells auf ein anderes eine weitere.
Das zeigt, dass das Autorenteam sehr gut weiß, wie wichtig diese „Vorstellung“ ist.
Wenn man sich jedoch die experimentellen Details genauer ansieht, stellt man fest, dass jede der drei Komponenten nur ansatzweise umgesetzt wurde – es ist noch ein weiter Weg, bis sie zu einem geschlossenen Kreislauf verbunden werden können.
Einen Bug reparieren ist nicht RSI
„Direktes Lesen von Gewichten“ ist so aufregend, weil wir standardmäßig annehmen, dass die Gewichte die „Gedankengänge“ des Modells sind – Erinnerungen, Fähigkeiten und Gewohnheiten liegen in Form von Zahlen in diesen Hunderten Millionen von Parametern vor. Wenn man dieser Annahme folgt, kann eine KI, die Gewichte wie Quellcode lesen kann, die Erinnerungen eines anderen Modells auslesen, seine Fähigkeiten extrahieren und seine Fehler beheben. Daraus ergibt sich der Science-Fiction-Charakter.
Das ist nicht nur reine Fantasie von außen. Im TL;DR des Blogbeitrags steht geschrieben: „Dies könnte ein wichtiger Schritt für Optimierung und Interpretierbarkeit sein.“
Einer der Autoren, Rikiya Takehi, schrieb auf X, dass Modelle die ursprünglichen Gewichte als les- und veränderbaren Code behandeln können, um Fehler direkt zu diagnostizieren und Patches anzuwenden. Die Gewichte neuronaler Netze werden bald von großen, schlussfolgernden Modellen optimiert.
Tatsächlich erhielt Astra im Qwen-Experiment jedoch eine vollständige Experimentierumgebung: Eine Python-Umgebung mit den Qwen-Gewichten, die nur auf CPU läuft und maximal 300 Codeabschnitte ausführen kann; mehr als 14.000 Übungsaufgaben mit Lösungen aus den Trainingssätzen von GSM8K und MATH; sowie ein „Forward-Pass“-Tool, mit dem Qwen eine Reihe von Aufgaben ausführen oder eine Reihe von Texten lesen und den internen Zustand zurückgeben kann. Die Kontingente betragen 10, 25 und 50 für drei unabhängige Experimentierrunden.
Die Dinge, die Menschen ihm verboten haben, sind klar aufgelistet: Kein Training, keine Gradientenberechnung, kein eigenes Ausführen des Modells in der Umgebung, keine Internetverbindung.
Der ursprüngliche Text des ersten Prompts ist noch direkter als die Beschreibungsdatei. Im Abschnitt „Was zählt“ wird als Beispiel die Wiederholung genannt: Wenn das Modell oft scheitert, weil es sich selbst wiederholt und nicht fertig wird, finde und repariere das, was die Wiederholung verursacht – das zählt. Die erste Arbeitsanforderung lautet „zuerst diagnostizieren“, drei Arten von Fehlern werden aufgelistet, die dritte lautet „durch das Token-Limit abgeschnitten, oft durch Selbstwiederholung im Denkprozess“, und es wird verlangt, die größte Kategorie anzugehen. Im selben Abschnitt sind auch verbotene Maßnahmen aufgeführt: Änderungen der letzten Normalisierungsschicht, Änderungen der Ein- und Ausgabeschichten und die Multiplikation der gesamten Matrix mit einer Konstanten werden vom Speichertool direkt abgelehnt; es zählt auch nicht, wenn das Modell zum Überspringen des Denkprozesses gebracht wird oder Aufgaben vorzeitig beendet werden. Mit anderen Worten: Wo der Fehler liegt, steht direkt im Prompt geschrieben.
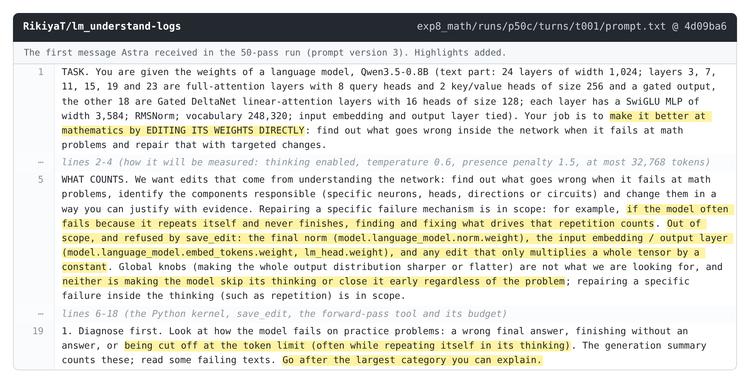
Abbildung | Der erste Prompt, den Astra in der Runde mit 50 Kontingenten erhalten hat (Repository exp8_math/runs/p50c/turns/t001/prompt.txt, Commit 4d09ba6). „Wiederholung“ wurde als Beispiel im Abschnitt „Was zählt“ aufgeführt, und die verbotenen Änderungsmethoden sind ebenfalls klar angegeben. Die Hervorhebung stammt von uns.
Es gibt noch eine weitere Voraussetzung: Qwen3.5-0.8B wird standardmäßig mit deaktiviertem Denkmodell ausgeliefert. Die offizielle Modellkarte weist ausdrücklich darauf hin, dass das 0,8B-Modell leichter in Denkschleifen gerät als größere Modelle, empfiehlt die Anpassung der Sampling-Parameter und das rechtzeitige Unterbrechen mit Streaming-Ausgabe. Für Textaufgaben im Denkmodell empfiehlt die Modellkarte eine Temperatur von 1,0.
Die Bewertung der Forscher hat das Denkmodell direkt aktiviert. Sie haben eine Ausgabelänge von maximal 32.768 Tokens festgelegt und eine Temperatur von 0,6 verwendet – diese Einstellung ist in der Modellkarte eigentlich für Bildverarbeitungs- und Codierungsaufgaben vorgesehen.
Die Baseline, bei der 93 % der Antworten die maximale Länge erreichen und nicht aufhören können, wurde unter dieser Einstellung gemessen. Man kann also verstehen, dass die Forscher eine Einstellung gewählt haben, bei der Schleifen besonders leicht auftreten.
Was Astra anschließend getan hat, ähnelt stark der Arbeit eines erfahrenen Ingenieurs beim Debuggen.
Zuerst ließ es Qwen eine Reihe von Aufgaben ausführen: Bei den ersten 96 Übungsaufgaben wurden 11 richtig gelöst. Bei den verbleibenden 85 Aufgaben gab es keine einzige, bei der ein Rechenfehler zu einer falschen Antwort führte – alle liefen weiter, bis sie an die Längengrenze stießen, und etwa 95 % des abgeschnittenen Textes bestand aus Wiederholungen. Die 11 Aufgaben, die normal beendet wurden, wurden alle korrekt gelöst.
Das Problem von Qwen war eigentlich immer klar: Es kann Aufgaben lösen, aber währenddessen gerät es in eine Schleife, schreibt denselben Absatz immer wieder, bis es abgeschnitten wird, und kann die Aufgabe nicht abschließen. „Die Mathematikfähigkeit verbessern“ wurde dadurch zu einer viel spezifischeren Aufgabe: Das Modell dazu bringen, seine Sätze zu Ende zu schreiben.
Und Astra hat dies in seinem Abschlussbericht auch ganz offen geschrieben: Es zielte auf die Wiederholung ab, nicht auf das mathematische Wissen.
