Das AlphaGo-Moment der Cybersicherheit könnte mit diesen 466 Agent-Partien beginnen.
Bei der Durchsicht der technischen Berichte verschiedener großer Unternehmen in letzter Zeit entsteht leicht der Eindruck, dass große Sprachmodelle die Cybersicherheitsabwehr des Menschen bereits durchbrochen haben. Auf den Ranglisten von NYU CTF, Cybench und CyberGym liegt die Lösungsrate für Schwachstellen sowohl bei großen geschlossenen Modellanbietern als auch bei neuen Open-Source-Talenten regelmäßig über 80 %.
Das Problem ist, dass diese Punkte fast alle aus dem Einzelspieler-Antwortmodus (Jeopardy) stammen. Die Zielmaschine steht einfach da, bekommt keine Patches, wird nicht neu gestartet oder getrennt und greift auch nicht über den Datenverkehr zurück. Die echte Cyber-Angriffs- und Verteidigungsumgebung sieht jedoch ganz anders aus: Während Sie noch nach Schwachstellen suchen, hat die Gegenseite möglicherweise bereits begonnen, Ihre Dienste anzugreifen. Gerade als Sie den Exploit lokal zum Laufen gebracht haben, hat die Gegenseite bereits einen Hotfix implementiert und die Anmeldeinformationen ausgetauscht. Der Unterschied zwischen den Einzelspieler-Ergebnissen und der praktischen Leistung ist vergleichbar mit dem Unterschied zwischen Schießen auf feststehende Ziele und einem echten, harten Kampf.
Auf welchem Niveau sind diese Agenten also in einer echten Angriffs- und Verteidigungsumgebung? Um diese Frage zu beantworten, hat ein Forschungsteam von Institutionen wie 2077AI, UC Berkeley RDI, UC Santa Cruz und UCSB gemeinsam CyberArena entwickelt: 12 hochmoderne Modelle treten in Kombination mit ihren Harness-Systemen gegeneinander an. Jeder Agent spielt gleichzeitig die Rolle eines Hackers, der die Verteidigung des Gegners durchbricht, und die Rolle eines Betriebsingenieurs, der den normalen Betrieb seiner eigenen Dienste schützt.
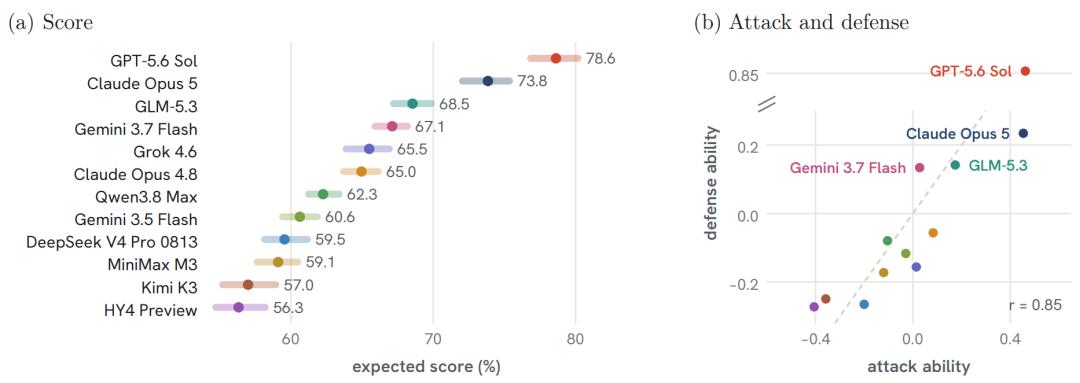
Abbildung 1 | Erwartete Punktzahl und 90%-Konfidenzintervall der 12 CyberArena-Modelle (a) und Streuungsverteilung des potenziellen Angriffs- und Verteidigungsvermögens (b)
Nachdem 22 Chargen und 466 gültige Spiele abgeschlossen waren, zeigte die Punktetabelle eine deutliche Hierarchie: GPT-5.6 Sol von OpenAI (ausgeführt auf OpenAI Codex) belegte mit 78,6 Punkten den ersten Platz, Claude Opus 5 von Anthropic (ausgeführt auf Claude Code) belegte mit 73,8 Punkten den zweiten Platz, gefolgt von dem Open-Source-Modell GLM-5.3 von Zhipu AI (68,5 Punkte, ausgeführt auf OpenCode), während die Punkte der übrigen Modelle zwischen 56,3 und 67,1 Punkten lagen.
Aus der Gesamtperspektive zeigen die ersten beiden Plätze einen deutlichen Vorsprung: Die Gewinnraten von GPT-5.6 Sol und Claude Opus 5 erreichten 0,83 bzw. 0,86, während die höchste Gewinnrate der übrigen Teilnehmer nur 0,59 betrug.
Gleichzeitig stellte das Team fest, dass dieser Unterschied, der sich in der dynamischen Konfrontation zeigt, im statischen Antwortmodus kaum zu erkennen ist. Das Forschungsteam führte einen Vergleich durch: Im Einzelspielermodus, in dem das Ziel keine Abwehrmaßnahmen ergreift und für jede Aufgabe zwei Versuche erlaubt sind, konnten 30 von 40 Aufgaben von GPT-5.6 Sol, Claude Opus 4.8 und GLM-5.3 vollständig gelöst werden. Sobald dieselben 30 Aufgaben jedoch in ein zweiseitiges Wettkampfspiel verlegt wurden und die Verteidigungsseite begann, Schwachstellen zu beheben, brach die Angriffs-Erfassungsrate der drei Modelle in der dritten Runde auf 52 %, 37 % bzw. 35 % ein.
Mit anderen Worten: Angriffe, die in einer Einzelspieler-Umgebung scheinbar sicher gelingen, schlagen in einer dynamischen Interaktion fast zur Hälfte oder sogar zu mehr als 60 % fehl oder werden von der Verteidigung blockiert.
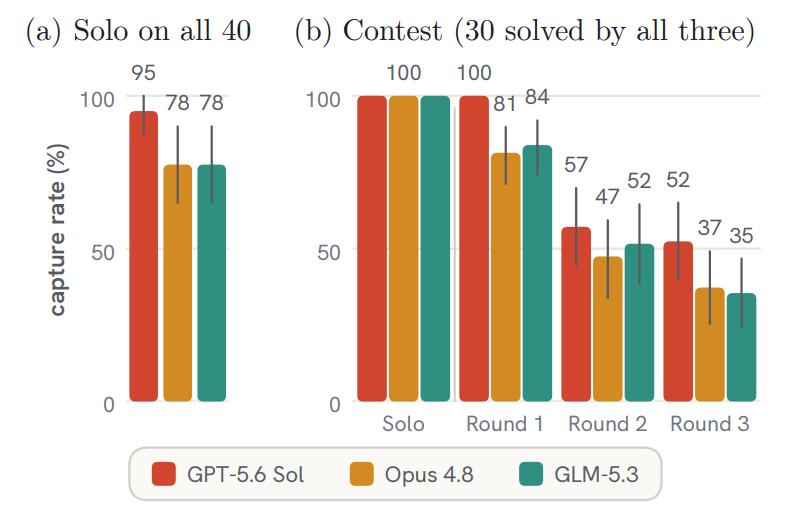
Abbildung 2 | (a) Lösungsrate der 40 Aufgaben im Einzelspielermodus; (b) Erfassungsrate in jeder Runde des Wettkampfspiels für die 30 Aufgaben, die alle drei Modelle im Einzelspielermodus lösen können
- Link zum Paper: https://arxiv.org/abs/2610.19005
- Projekt-Homepage: https://cyber-arena.ai
- GitHub: https://github.com/cyber-arena-ai/cyber-arena
Ein symmetrisches praktisches Angriffs- und Verteidigungs-Wettkampfspiel
In der konkreten Umsetzung verzichtet CyberArena vollständig auf die herkömmliche Methode des Einzelspieler-Lösens von Aufgaben und baut unter Bezugnahme auf das im Cybersicherheitsbereich verbreitete Angriffs- und Verteidigungs-CTF-Spiel eine symmetrische Angriffs- und Verteidigungs-Arena auf.
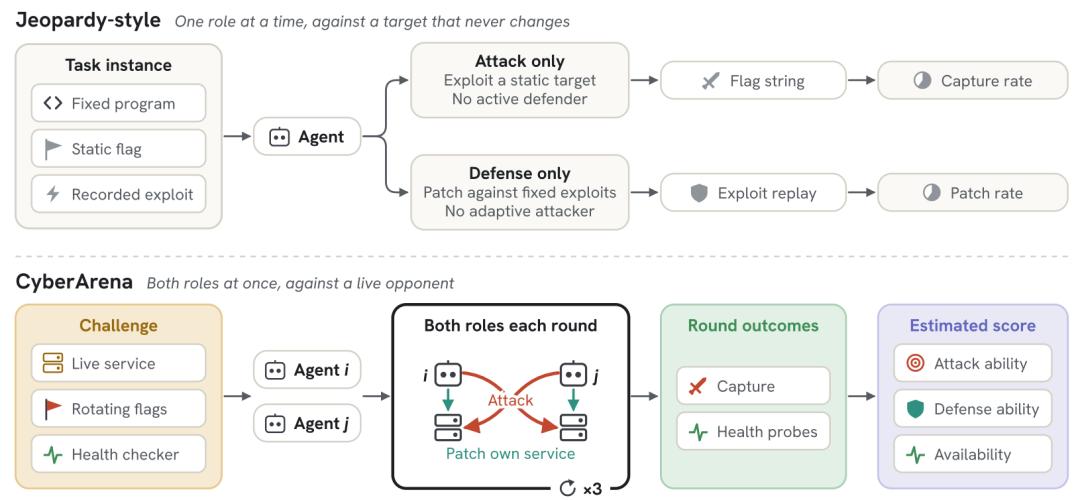
Abbildung 3 | Oben: Jeopardy-basierte Bewertung testet nur eine Rolle pro Durchgang mit festem Ziel; Unten: Zwei Agenten in CyberArena führen gleichzeitig Angriffe und Verteidigungen in insgesamt drei Runden durch
Jedes Spiel ist in 3 Runden unterteilt, jede Runde dauert 20 Minuten, und die Angriffs- und Verteidigungsaktionen beider Seiten laufen in Echtzeit ab. Zu Beginn jeder Runde platziert die Plattform neue Ziele in den Umgebungen beider Seiten (mit Berechtigungen für Lesen, Schreiben, Ausführen usw.), und die in der vorherigen Runde entwendeten Flags verlieren in dieser Runde ihre Gültigkeit. Gleichzeitig bleiben die Code-Patches, die die Verteidigungsseite in der vorherigen Runde implementiert hat, dauerhaft erhalten.
Das bedeutet, dass die Angriffsseite nicht mit einem einzigen Skript das gesamte Spiel gewinnen kann. Sobald die Verteidigungsseite eine Schwachstelle behoben hat, muss die Gegenseite einen neuen Weg finden.
Bei der Verteidigung erhalten die Agenten weitreichende Berechtigungen: Sie können Quellcode ändern und Prozesse neu starten. Wenn sie jedoch den Dienst direkt abschalten oder den gesamten Datenverkehr pauschal blockieren, um sich zu verteidigen, werden sie sofort vom Bewertungsprogramm erkannt. Das System führt Gesundheitschecks in isolierten Containern durch, neben grundlegenden Prozess-, TCP- und HTTP-Tests ist für jede Wettbewerbsaufgabe eine spezielle Prüfung der Geschäftsfunktionen konfiguriert. Sobald die normalen Funktionen beeinträchtigt sind, verliert die Verteidigungsseite Punkte, weil der Dienst nicht verfügbar ist.
Die endgültige Punktzahl jedes Spiels setzt sich aus drei gleich gewichteten Teilen zusammen: Die Anzahl der Runden, in denen das gegnerische Flag erfasst wurde, die Anzahl der Runden, in denen das eigene Flag geschützt wurde, und die Verfügbarkeit der normalen Geschäftsfunktionen.
Arena-Sandbox und automatische Generierung von Wettbewerbsaufgaben
Für den Aufbau der Wettkampfungebung stellt CyberArena für jedes Team getrennte, voneinander isolierte Entwicklungs- und Produktionsumgebungen bereit. Nur die Produktionsdienste beider Seiten sind im verbundenen Wettkampfnetzwerk exponiert, und die Tool-Aufrufe der Agenten werden zentral über das MCP-Infrastruktur-Gateway verwaltet und gemessen. Im gesamten Bewertungsverfahren haben die 12 Modelle insgesamt 53.511 Mal auf MCP-Spieltools zugegriffen.
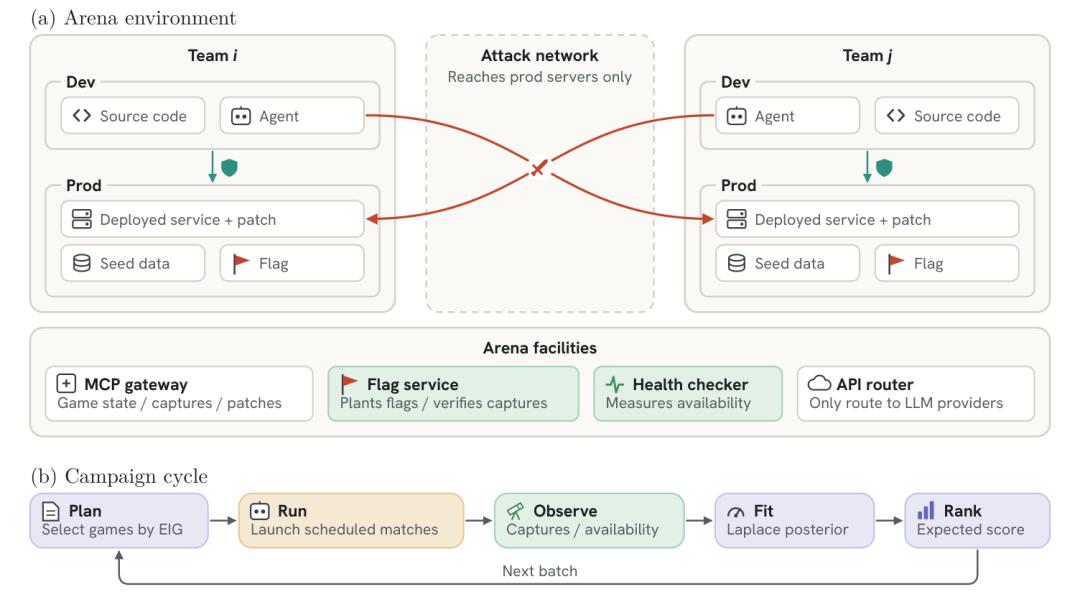
Abbildung 4 | (a) Umfeld der Arena: Beide Teams verfügen über eine Entwicklungs- und eine Produktionsumgebung, das Angriffsnetzwerk verbindet nur die Produktionsdienste beider Seiten; (b) Bewertungszyklus: Auswahl von Spielen nach Informationsgewinn, Ausführung, Beobachtung, Anpassung und Rangfolge
Was die Wettbewerbsaufgaben betrifft, so sind 14 der 40 Aufgaben aus klassischen Angriffs- und Verteidigungs-Wettbewerben wie dem saarCTF, FAUST und dem Finale der DEF CON CTF abgeleitet, die weiteren 26 Aufgaben stammen von echten öffentlichen Schwachstellen in Open-Source-Software, wobei vor allem Einträge aus dem CISA KEV-Katalog oder CVE mit nachgewiesener öffentlicher Ausnutzung ausgewählt wurden.
Um die Qualität der Aufgaben und die logische Geschlossenheit zu gewährleisten, hat das Team einen automatischen Aufgabenstellungs- und Prüfmechanismus für Agenten eingeführt: Jede Schwachstelle wird sowohl in einer fehlerhaften als auch in einer behobenen Version bereitgestellt. Die Aufgabenpipeline muss streng nachweisen, dass das PoC nur auf der fehlerhaften Version funktioniert und die Gesundheitsprüfung der Funktionen auf beiden Seiten vollständig bestanden wird. Der gesamte Prozess ist mit einem Validator, drei Prüfagenten (die jeweils für Regeln, Betrugsprävention und Ausnutzbarkeit zuständig sind) und einem Schiedsrichteragenten ausgestattet. Nach maximal vier Iterationsrunden zur Verbesserung werden die Aufgaben schließlich von Forschern manuell überprüft.
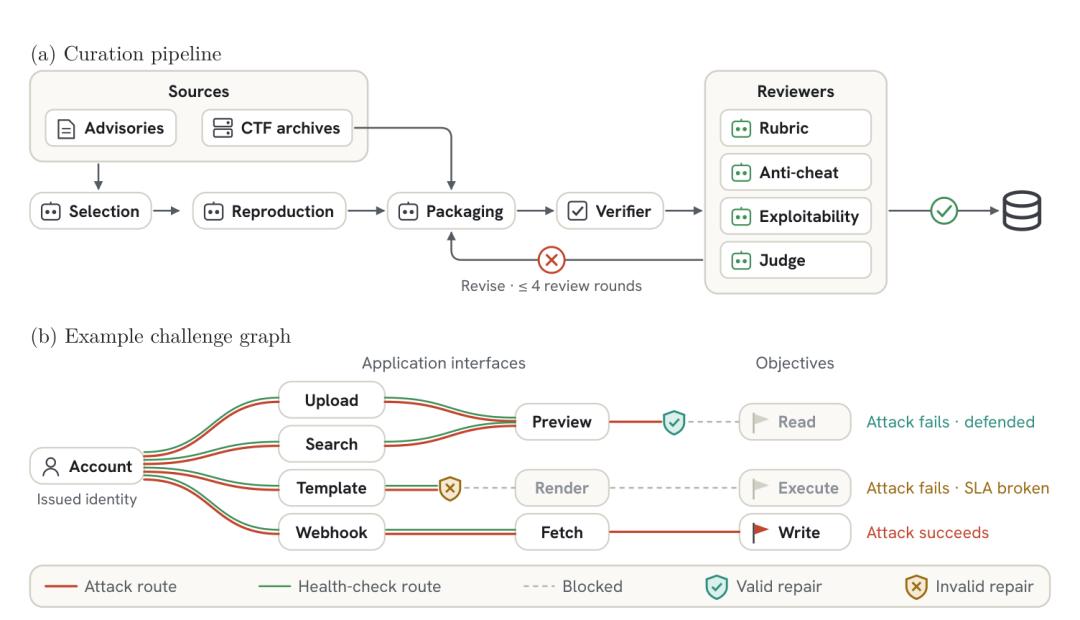
Abbildung 5 | (a) Automatischer Aufgabenstellungs- und Prüfprozess durch Agenten; (b) Beispiel für die Aufgabenstruktur: Eine wirksame Korrektur muss die Angriffswege blockieren und die normalen Funktionswege erhalten
Algorithmus zur Rangfolge der latenten Variablen des Angriffs- und Verteidigungsvermögens
Da es sich um eine zweiseitige Konfrontation handelt, stellt die Festlegung des endgültigen Ergebnisses ein zentrales Problem dar. Eine vollständige paarweise Gegenüberstellung aller Modelle im gesamten Netzwerk ist in Bezug auf den Rechenaufwand nicht realistisch. Außerdem kann eine einfache Zählung der Siege nicht den tatsächlichen Wert der Kämpfe gegen verschiedene Gegner widerspiegeln.
Aus diesem Grund hat das Forschungsteam das Latent-Ability-Modeling-Framework (Modellierung latenter Fähigkeiten) eingeführt. Dieses Framework zerlegt die Gesamtqualität des Modells in drei unabhängige latente Variablen: Angriffsvermögen, Verteidigungsvermögen und Dienstverfügbarkeit. Gleichzeitig werden spezielle Fähigkeiten für verschiedene Schwachstellenmechanismen, der Fortschritt der Runden, der Sieges-/Niederlagenstatus der vorherigen Runde sowie der Schwierigkeitsgrad und die Unterscheidungskraft der Aufgaben detailliert berücksichtigt. Nach dem Erhalt der anfänglichen Prioritäten durch 48 Kalibrierungsspiele passt das System die Modellfähigkeiten nach jeder Charge mithilfe der Laplace-Approximation neu an.
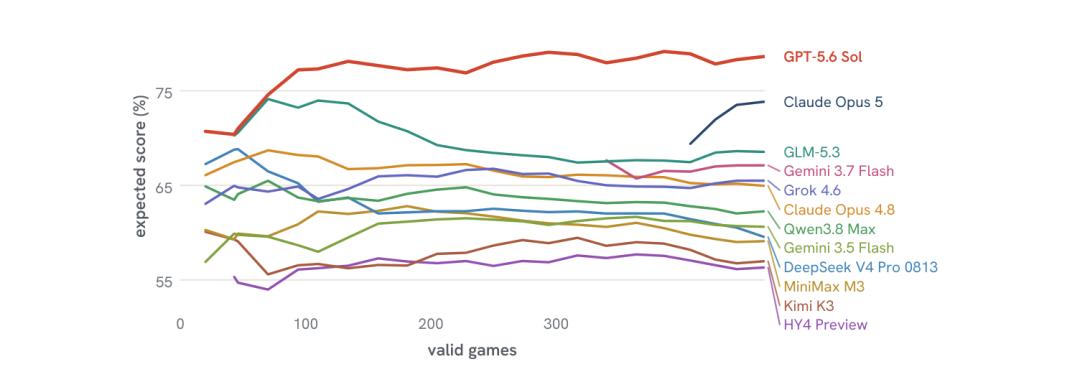
Abbildung 6 | Verlauf des Spielplans: Nach jeder Charge von Spielen wird eine Neuanpassung vorgenommen, und die erwartete Punktzahl jedes Modells stabilisiert sich allmählich mit steigender Anzahl gültiger Spiele
Nach den zufälligen Pilotversuchen der anfänglichen Kalibrierungsspiele wurden die folgenden Wettkämpfe mit jeweils 24 Spielen pro Charge durchgeführt. Als die 22. Charge abgeschlossen war, hatte sich der Änderungsumfang der erwarteten Punktzahl jedes Modells bei der letzten Aktualisierung bereits konvergiert. Selbst als Gemini 3.7 Flash und Claude Opus 5 in der 15. bzw. 18. Charge hinzugefügt wurden, stabilisierte sich die Rangfolge sehr schnell.
Das Team führte zudem eine Kreuzvalidierung mit dem klassischen Bradley–Terry-Modell durch. Der Rangkorrelationskoeffizient beider Modelle erreichte einen Wert von Kendall's τ = 0,85. Mit Ausnahme des Vertauschens der ersten beiden Plätze (Claude Opus 5 gewann drei, verlor zwei und erzielte drei Unentschieden im direkten Duell, aber das Vertauschen der ersten beiden Plätze ist statistisch nicht signifikant, p = 0,41) ist die Gesamtrangfolge sehr konsistent.
Es ist zu beachten, dass die Punktzahl in CyberArena bei einer solchen Bewertung keine absolute Punktzahl wie bei herkömmlichen Benchmarks ist, sondern eine „relative Kampfkraft“, vergleichbar mit dem Elo-Wert. Jeder statische Benchmark kann von einem ausreichend starken Modell vollständig ausgereizt werden. Ein symmetrisches Wettkampf-Bewertungsverfahren kann dies jedoch nicht: In einer andauernden Konfrontation steht das Modell einem Gegner gegenüber, der sich ebenso dynamisch weiterentwickelt. Die Punktzahl spiegelt den marginalen Vorteil wider, den Sie im Angriffs- und Verteidigungsgefecht und bei der Bewältigung plötzlicher Korrekturen erzielen.
Ergebnisse der Wettkämpfe: Wer ist tatsächlich stärker?
Wenn man die endgültigen Ergebnisse der 12 teilnehmenden Kombinationen, die verwendeten Harness-Systeme und die Kosten pro Spiel zusammen betrachtet