Anthropic legt nur geringe Anstrengungen an den Tag, und schon steht der Himmel über den AI-Relay-Stationen kurz vor dem Einsturz?
Ist das KI, für das Sie bezahlen, wirklich das Modell, das der Anbieter versprochen hat?
Beispielsweise behauptet eine Drittplattform, dass sie ein Flaggschiffmodell integriert hat, aber im Hintergrund wird es durch ein billiges kleines Modell oder ein altes Modell ersetzt. Es ist sehr schwer, dies nur anhand des Tons und der Qualität der Antwort zu beurteilen. Oder es kommt vor, dass die offizielle Website eine Aufgabe lösen kann, aber bei Nutzung eines Vermittlungsdienstes hängt sie.
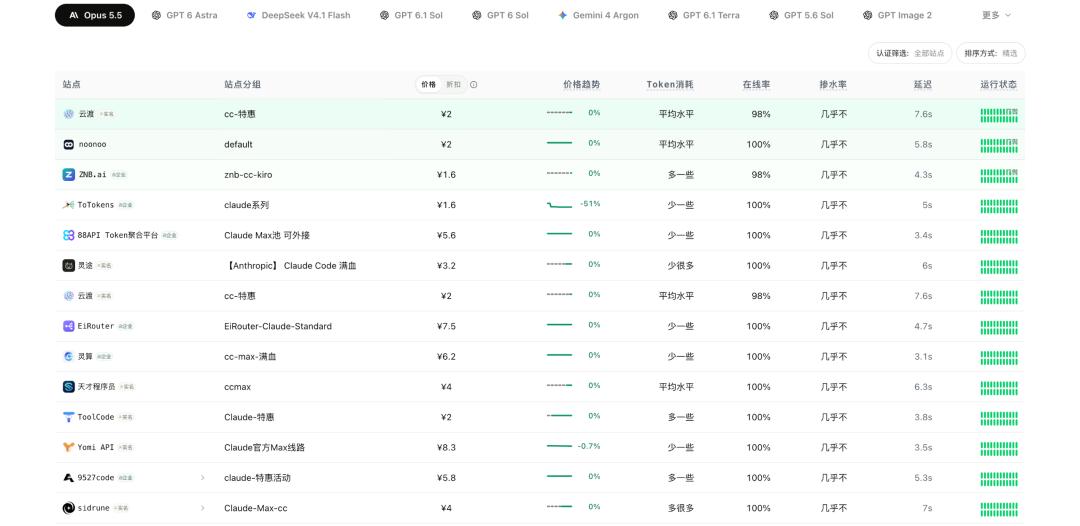
Abbildung | Einige Empfehlungs- und Bewertungsprojekte für KI-API-Vermittler auf GitHub erwähnen alle den Beimischungsgrad von minderwertigen Modellen
Für viele inländische Nutzer, die Modelle über Drittanbieter-APIs, Aggregationsplattformen oder Vermittlungsdienste aufrufen, ist dies wahrscheinlich ein Problem, dem sie regelmäßig begegnen müssen.
Eine scheinbar einfache Modellanfrage durchläuft mehrere Glieder: „Nutzer – Vermittler – vorgelagerter Dienstanbieter – Modell“. Sobald eine der Glieder keine Transparenz aufweist, ist es schwer zu bestätigen, ob das gekaufte Modell tatsächlich dem entspricht, für das man bezahlt hat.
Abbildung | Forschungslink: https://www.anthropic.com/research/provable-inference
Eine kürzlich von Anthropic veröffentlichte Studie versucht, dieses Problem, das bisher nur auf Grundlage von Nutzerbewertungen, Screenshots und subjektiver Erfahrung diskutiert werden konnte, zu einem mathematisch überprüfbaren Problem zu machen.
Dieses quelloffene Forschungsprototyp namens FlashProve kann kryptographische Beweise für die Modellinferenz generieren. Es ermöglicht Dienstanbietern, kryptographische Beweise für die Berechnungsergebnisse des Modells bereitzustellen. Nutzer müssen weder die Modellgewichte erhalten noch das große Modell selbst erneut ausführen, um die Ergebnisse zu überprüfen.
Ohne Offenlegung des Modells kann man trotzdem beweisen, dass „du du selbst bist“
Abgesehen von der Nutzung der offiziellen Anwendungen des Modellanbieters und dem Aufruf der API zur Konversation über die offizielle Website können wir den Zustand des genutzten Modells bestätigen. Bei den meisten API-Aufrufen senden wir eine Anfrage und der Server gibt eine Antwort zurück. Das Modell läuft tatsächlich auf einem entfernten Rechner, und wir können nicht erfahren, welche Berechnungen im Hintergrund tatsächlich durchgeführt wurden.
Das Forschungsprojekt der Stanford University mit dem Titel „Model Equality Testing“ hat einst 31 kommerzielle API-Endpunkte von vier Llama-Modellen aus dem Jahr 2024 getestet und festgestellt, dass die Ausgabeverteilung von 11 dieser Endpunkte statistisch von der Referenzverteilung der von Meta veröffentlichten Gewichte abweicht.
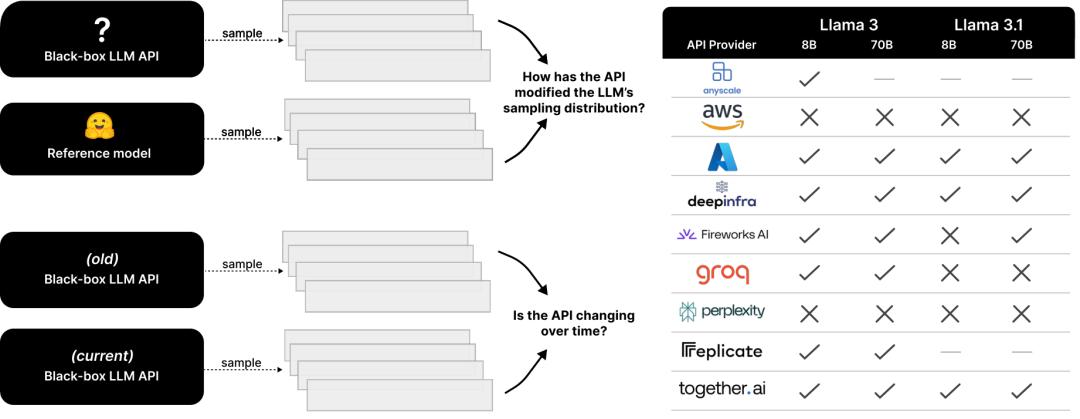
Derselbe Modellname entspricht manchmal nicht demselben Leistungsverhalten. Selbst wenn auf der Diensteseite überall Opus 5.5 angegeben ist, kann man keineswegs garantieren, dass Nutzer das exakt gleiche Modell erhalten.
Manchmal denken wir, dass wir das Modell anhand einiger Fragen identifizieren können, genau wie bei dem kürzlich durchgeführten internen Test von Opus 5.5. Einige Nutzer sagen, man solle das Modell fragen, wohin Karpathy im Mai 2026 gereist ist. Wenn das Modell nicht antworten kann, dass er zu Anthropic gegangen ist, wurde es nicht getestet.
Aber bei der Identifizierung des Modells anhand dieser Fragen stößt man auch auf das Problem des eigenen Routings des Modellanbieters, sodass es oft schwierig ist, die Ursache direkt zu lokalisieren. Falsche Antworten zufällig, unterschiedliche Parameter, unvollständig übermittelter Kontext und der Austausch des Modells im Hintergrund können sich schließlich alle in Äußerungen wie „Warum ist es plötzlich dümmer geworden?“ oder „Das ist doch nicht das Modell, das ich wollte“ äußern.
Der Kern von FlashProve ist eine Technik namens zkSNARK, eine Null-Wissen-Kurz-Beweistechnik.
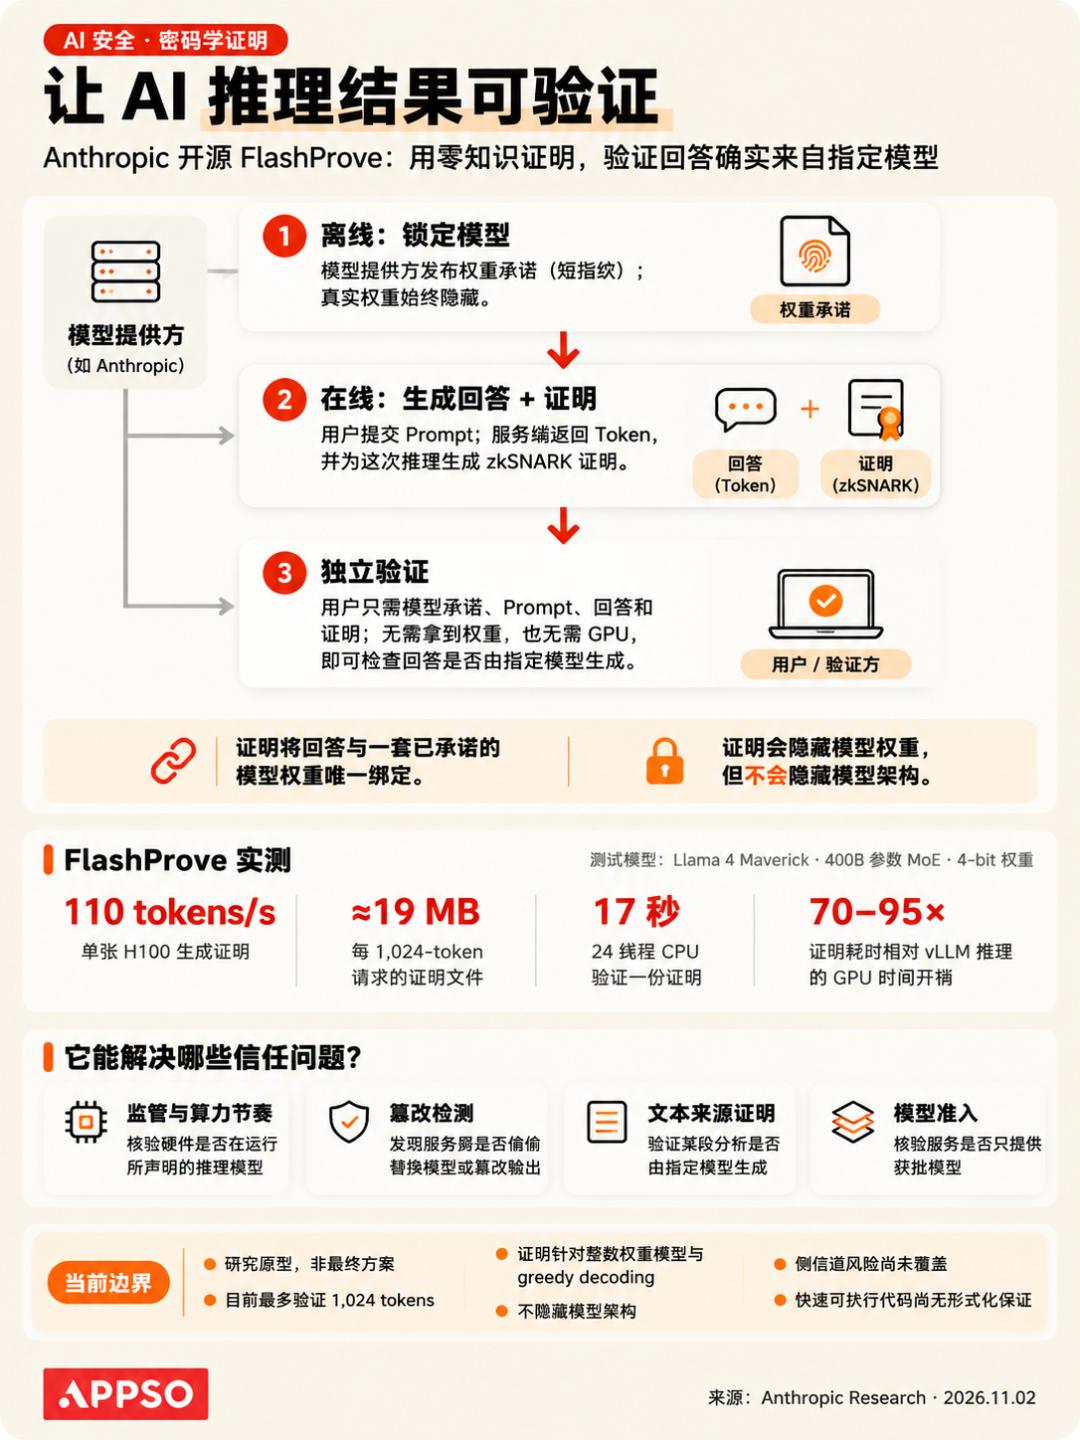
Zuerst generiert der Modellanbieter eine „Verpflichtung“ für die Gewichte. Sie ähnelt einem Satz kryptographischer Fingerabdrücke, die bestimmte Gewichte eindeutig festlegen können, ohne die Gewichte selbst offenzulegen.
Anschließend generiert der Anbieter für eine gegebene Eingabe und die zu prüfende Ausgabe einen Beweis, der überprüft, ob diese Ausgaben mit der vereinbarten Modellberechnung übereinstimmen. Wenn Nutzer die Modellverpflichtung, die Eingabeaufforderung, die Antwort und die Beweisdokumente erhalten, können sie auf ihrem eigenen Computer prüfen: Erzeugt dieses festgelegte Gewicht bei der Verarbeitung dieser Eingabe tatsächlich diese Ausgaben?
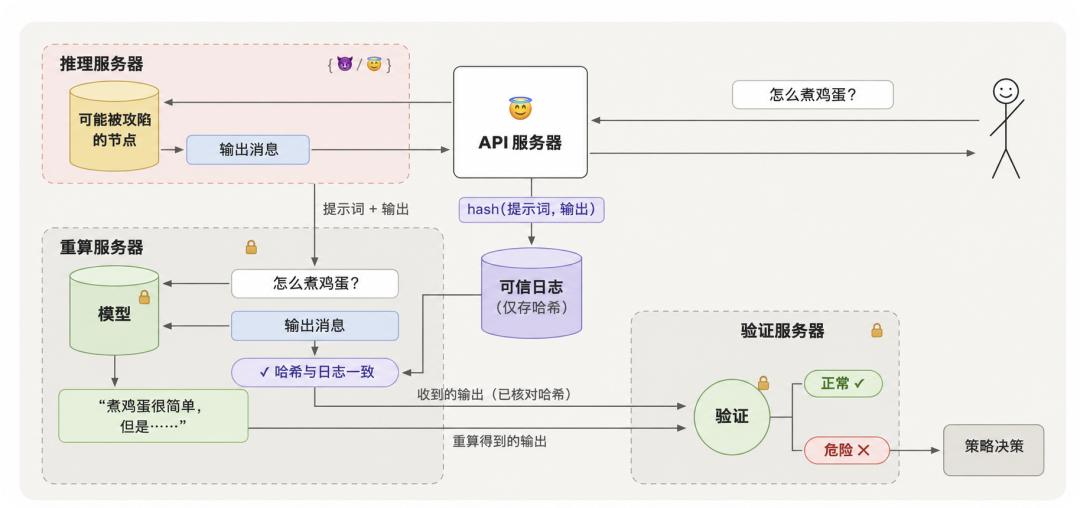
Wenn der Vermittler heimlich ein anderes Modell austauscht oder jemand die Ausgabe ändert, kann der Beweis nicht mehr mit der ursprünglichen Modellverpflichtung übereinstimmen.
Der hier verwendete Null-Wissen-Beweis ist ebenfalls sehr wichtig. Er zielt darauf ab, dass der Prüfer bei der Bestätigung der Berechnungsergebnisse keine Modellgewichte, Zwischenberechnungswerte und Informationen darüber erhält, welche Experten in den einzelnen Schichten des MoE-Modells aufgerufen wurden.
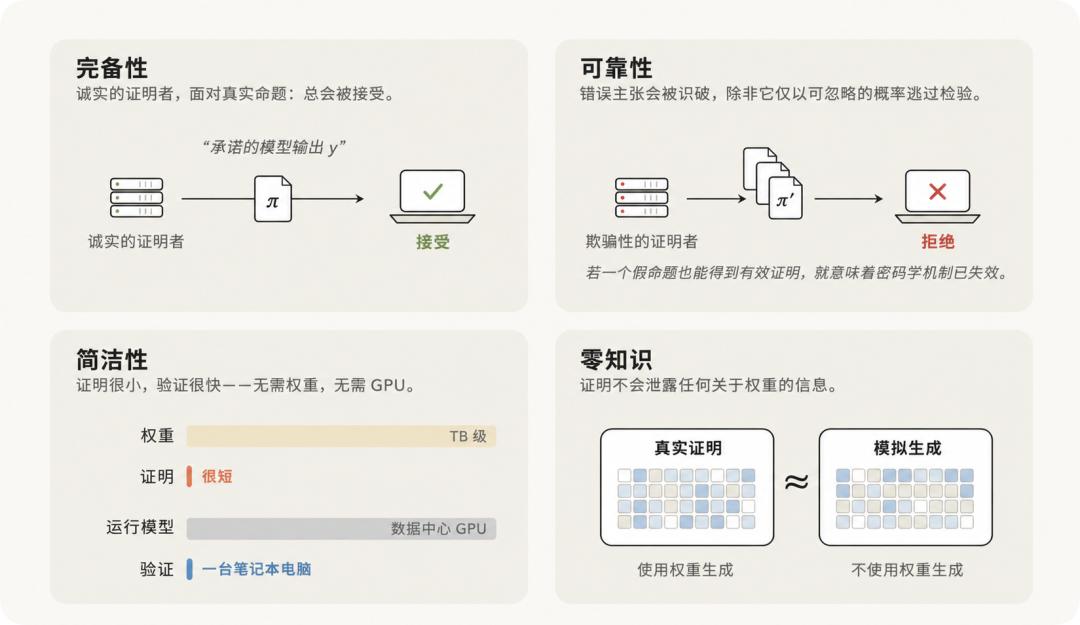
Dies erklärt auch, warum es zuverlässiger ist, als „das KI sich selbst vorstellen zu lassen“. Der im Antworttext genannte Modellname dient nicht mehr als Identitätsnachweis, sondern es wird die Berechnungsbeziehung zwischen der Ausgabe und den angegebenen Gewichten überprüft.
Ein Laptop reicht zur Überprüfung aus
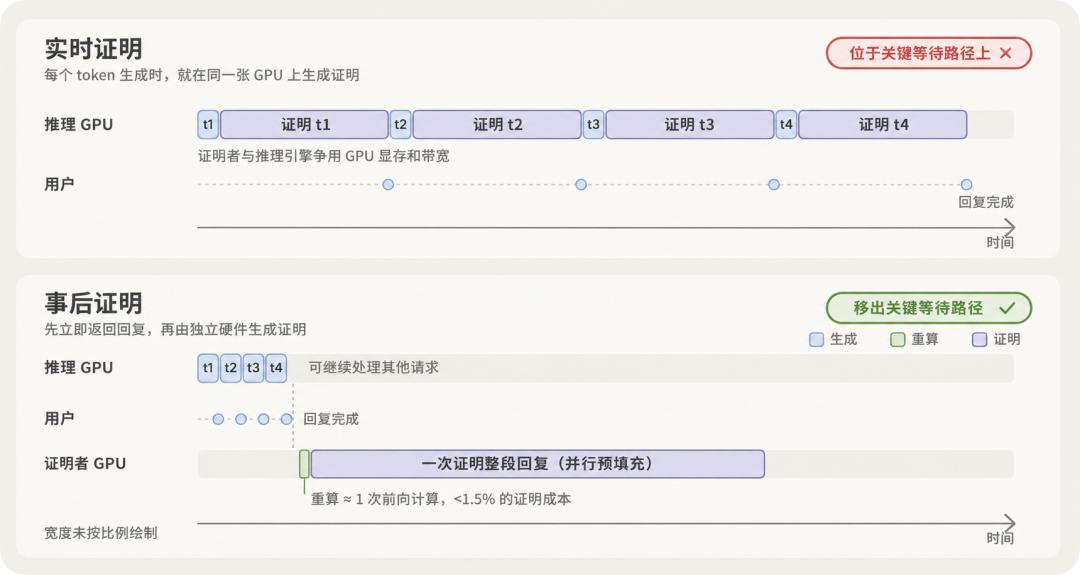
In der Vergangenheit war das größte Hindernis bei der Generierung von Null-Wissen-Beweisen für große Modelle die Kosten. Der Beweiserstellungsprozess kann um mehrere Größenordnungen langsamer sein als die normale Inferenz, und die Beweisdokumente können sehr groß werden.
Anthropic hat Experimente mit Llama 4 Maverick durchgeführt, das öffentliche 4-Bit-Gewichte verwendet. Es handelt sich um ein Misch-Experten-Modell mit 400 Milliarden Parametern, bei dem etwa 17 Milliarden Parameter pro Token tatsächlich aktiviert werden. Laut den von Anthropic veröffentlichten Daten:
- Der Durchsatz bei der Beweiserstellung auf einer einzelnen H100-Grafikkarte beträgt etwa 110 Token pro Sekunde;
- Der Beweis für jede Anfrage mit 1.024 Token ist etwa 19 MB groß;
- Die Überprüfung erfordert keine GPU und dauert auf einer CPU mit 24 Threads etwa 17 Sekunden, auf einem Single-Thread etwa 21 Sekunden;
- Die anfängliche Verpflichtung für die Modellgewichte muss nur einmal generiert werden und dauert etwa 39 Minuten.
Allerdings sind die 110 Token pro Sekunde die Geschwindigkeit der Beweiserstellung, nicht die Ausgabegeschwindigkeit des Modells während der Nutzerkommunikation. Die Beweiserstellung bleibt teuer. Unter den Vergleichsbedingungen von Anthropic beträgt die GPU-Zeit etwa das 70- bis 95-fache der normalen vLLM-Inferenz.
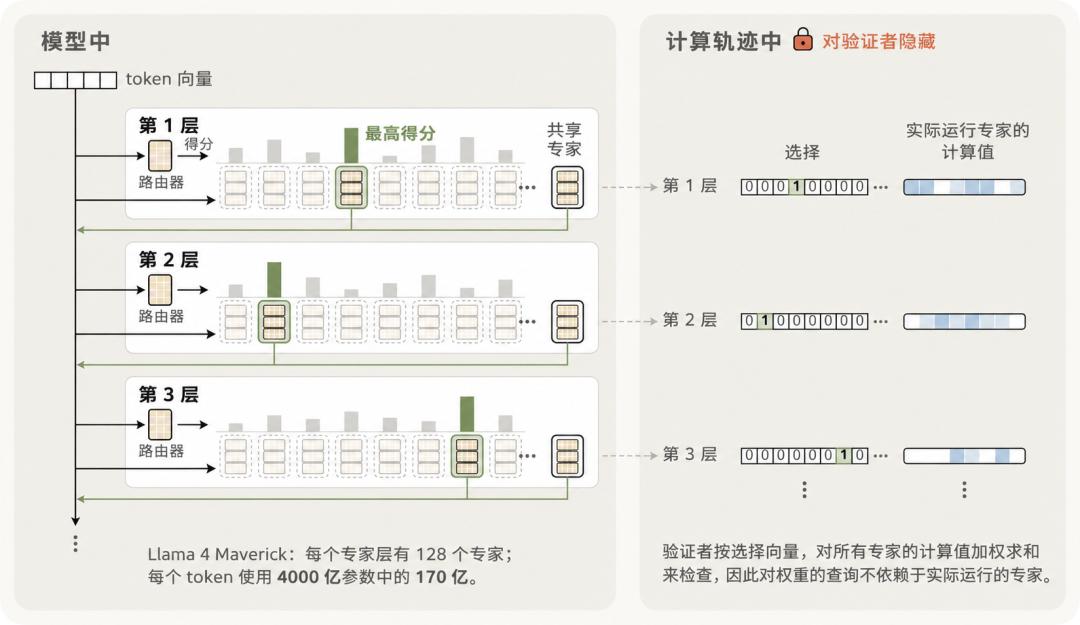
Obwohl sie nicht kostenlos ist, hat diese Lösung eine einst fast unerschwingliche Überprüfungsmethode auf ein Niveau gebracht, das praktische Anwendungsmöglichkeiten eröffnet.
Sie kann aber keine „Leistungsverschlechterung“ erklären
Für Nutzer von Vermittlungsdiensten ist die direkteste Attraktivität dieser Technik natürlich die Erkennung von Modellaustausch. Aber es gibt eine entscheidende Voraussetzung: Wir müssen im Voraus wissen, was die Verpflichtung des Originalmodells ist.
Wenn der Vermittler einen gültigen Beweis vorlegt, der nur beweist, dass die Antwort von Modell B stammt, das er selbst ausgewählt hat, und der Nutzer nicht bestätigen kann, ob Modell B mit dem von ihm gekauften Modell A identisch ist, löst dieser Beweis das Identitätsproblem immer noch nicht.
Die wirklich effektive Nutzungsmethode sollte darin bestehen, dass Modellanbieter, vertrauenswürdige Einrichtungen oder ein transparentes öffentliches Registrierungssystem die Modellverpflichtung veröffentlichen, und Nutzer bei der Überprüfung diesen erwarteten Fingerabdruck fest prüfen. Unter dieser Voraussetzung kann FlashProve von der Bestätigung „diese Berechnung hat tatsächlich stattgefunden“ auf die Bestätigung „die von uns gekaufte Berechnung hat tatsächlich stattgefunden“ aufgestuft werden.
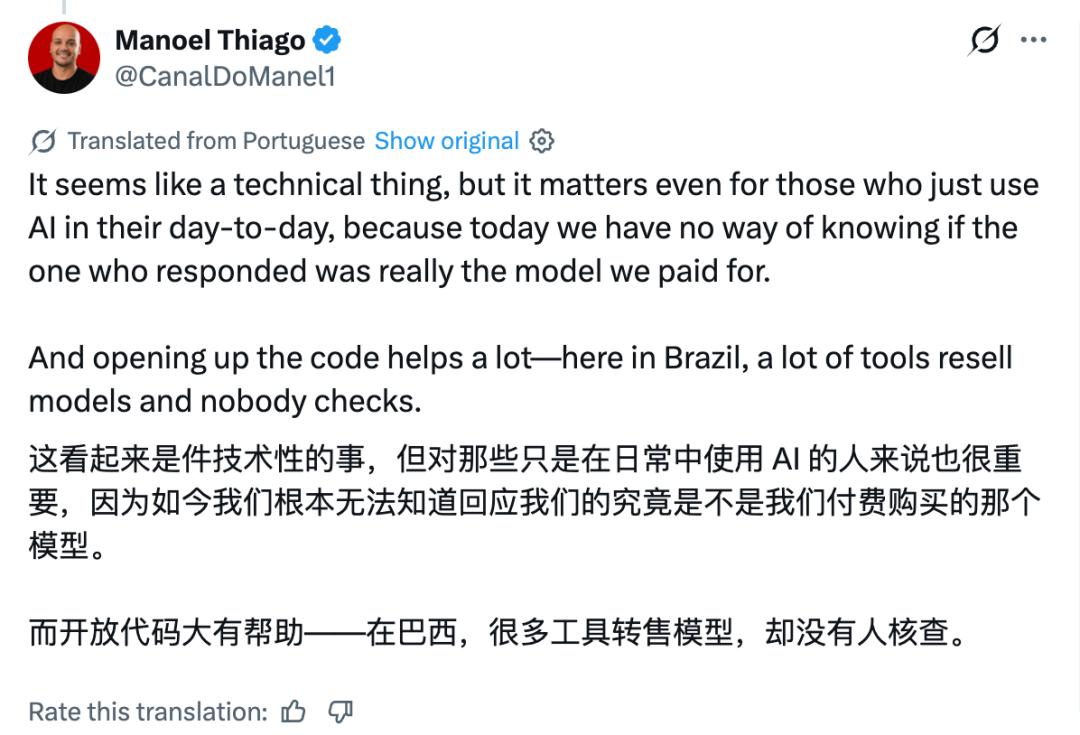
In den sozialen Medien lauten die meisten Kommentare der Nutzer zu dieser Technik: „Es wäre großartig, wenn dies endlich all die Posts beenden könnte, in denen darüber diskutiert wird, ob sie das Modell heimlich geschwächt haben.“
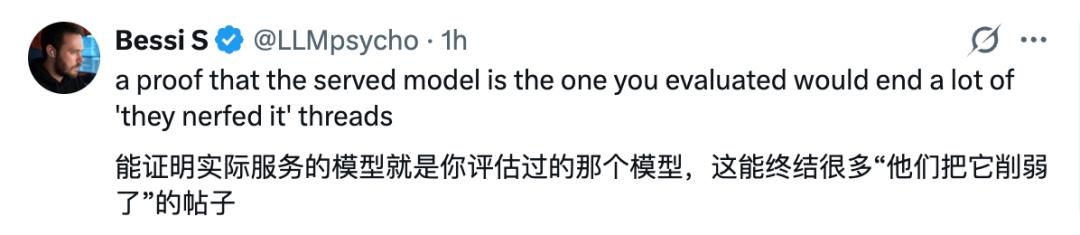
Schließlich ist das Ergebnis, das wir uns am meisten wünschen, sicherlich: „Hört auf zu streiten, zeigt einfach den Beweis.“
Aber selbst wenn die Identität der Gewichte bestätigt ist, gibt es noch andere mögliche Gründe für eine „Leistungsverschlechterung“.
Dass sich die Modellgewichte nicht ändern, bedeutet nicht, dass sich der Dienst überhaupt nicht verändert hat. System-Eingabeaufforderungen, Sicherheitsrichtlinien, Kontextkürzung, abgerufene Inhalte, Quantisierungsverfahren und Decodierungsparameter können alle das endgültige Nutzungserlebnis beeinflussen. Um diese Probleme zu untersuchen, muss klar sein, ob jede dieser Bedingungen auch von der Überprüfung abgedeckt ist. Ein an die Gewichte gebundener Beweis kann nicht automatisch alle Probleme auf Produktebene beantworten.
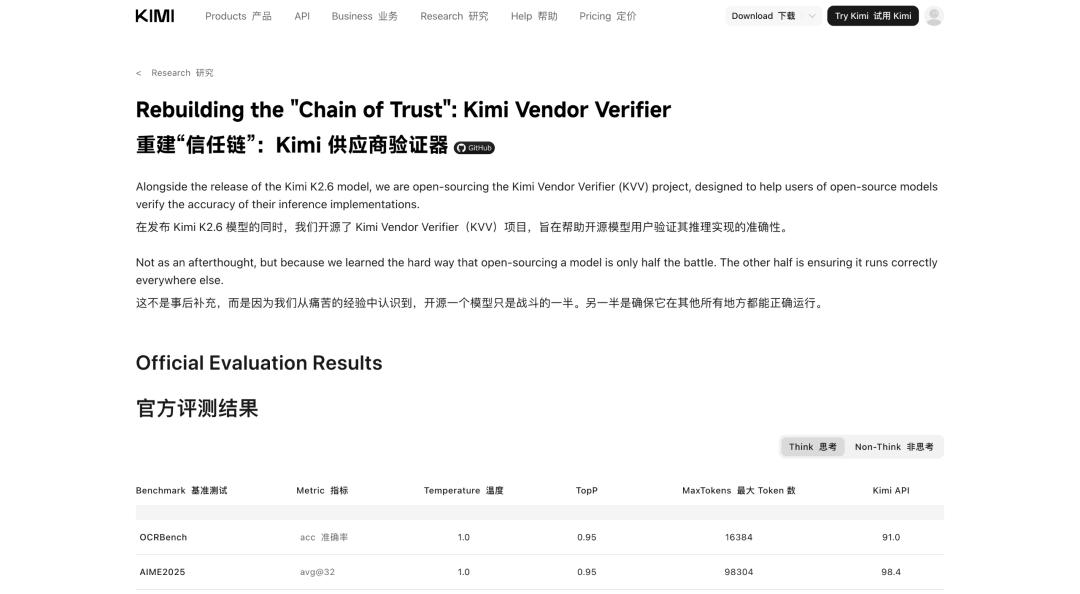
Das Kimi-Team erwähnte bei der Vorstellung von Kimi Vendor Verifier, dass sie nach der Veröffentlichung von K2 Thinking Rückmeldungen aus der Community über ungewöhnliche Benchmark-Ergebnisse erhalten haben. Die Untersuchung bestätigte, dass ein beträchtlicher Teil dieser Fälle auf die falsche Verwendung von Decodierungsparametern zurückzuführen ist. Das Team hat anschließend die relevanten Parameter im Thinking-Modus eingeschrän