Bei einem 5000 Wörter langen Anforderungsdokument kann selbst Claude nur 14 % der geforderten Inhalte liefern, wir haben 28 verschiedene Agent-Kombinationen in praktischen Untersuchungen geprüft.
Heutzutage sind Agenten bereits in der Lage, Werkzeuge geschickt aufzurufen, Dateien zu ändern und Tests auszuführen. Aber können sie angesichts eines großen, langfristig weiterentwickelten Softwaresystems ausgehend von einer neuen Anforderung eine vollständige Funktionalität liefern?
Wenn Produktmanager neue Anforderungen stellen, erhalten Entwickler in der Regel keine Dateilisten oder Funktionssignaturen. Zuerst müssen die Einschränkungen verstanden, Modulabhängigkeiten verfolgt und dann beurteilt werden, wo geändert werden soll, wie geändert werden soll und wie nachgewiesen werden kann, dass die Änderung korrekt ist. Diese Analysen beeinflussen die anschließende Lieferung.
Institutionen wie die Fudan-Universität, die City University of Hong Kong und die Chinese University of Hong Kong haben LoLBench vorgeschlagen, das Agenten in Softwaresysteme mit durchschnittlich etwa 2,4 Millionen Quellcodezeilen einbringt, um den gesamten Prozess von der Funktionsvorschlag bis zur Modulbereitstellung zu bewerten und die Wahrnehmungsfähigkeit, Anforderungen im System umzusetzen, sowie die Implementierungsfähigkeit, modulübergreifende Änderungen durchzuführen zu prüfen.
Link zum Papier: https://arxiv.org/abs/2609.37143
Datensatz: https://huggingface.co/datasets/lolbench26/LoLBench
Die Experimente haben kritische Bruchstellen aufgezeigt: Agenten können möglicherweise lokale Teile korrekt ändern, übersehen aber gleichzeitig notwendige gleichzeitige Änderungen in anderen Modulen. Selbst wenn Implementierungsrichtlinien ergänzt werden, bleiben die meisten Aufgaben ungelöst, es besteht noch eine große Lücke zwischen dem Verständnis der Anforderungen und der vollständigen Lieferung.
Langfristige Codeaufgaben neu definieren
Welche langfristigen Codeaufgaben haben einen praktischen ingenieurstechnischen Wert?
„Langfristig“ darf sich nicht nur an Zeitaufwand, Rundenanzahl oder Token-Verbrauch messen. Wenn ein Agent beispielsweise jede Minute eine Zahl ausgibt und von 1 bis 1000 zählt, ist der Zeitaufwand zwar sehr hoch, aber es reicht eine einfache Schleife. Aufgaben zur lokalen Fehlerbehebung wie bei SWE-bench decken ebenfalls nicht die Herausforderungen von der Anforderungsanalyse bis zur Modulbereitstellung ab.
Die langfristigen Codeaufgaben, auf die sich LoLBench konzentriert, sind Modulentwicklung für komplexe Systeme. Nach Erhalt einer neuen Anforderung analysieren Entwickler wiederholt: Welche Verhaltensweisen müssen implementiert werden? Kann die vorhandene Architektur dies unterstützen? Welche Abhängigkeiten werden betroffen sein? Wie lässt sich dies überprüfen? LoLBench bezieht diese Analysen, die normalerweise im Kopf des Entwicklers stattfinden, in die Bewertung ein und lässt den Agenten die Ableitung von der Benutzerabsicht bis zum Implementierungsplan selbst durchführen.
Diese Art von Aufgaben weist gleichzeitig Wahrnehmungskomplexität und Implementierungskomplexität auf: Erstere beschreibt die Schwierigkeit, Vorschläge zu verstehen, implizite Einschränkungen und modulübergreifende Abhängigkeiten zu erkennen sowie den Änderungsumfang und die Implementierungsspezifikation abzuleiten. Letztere beschreibt die Schwierigkeit, die Spezifikation in korrekte dateiübergreifende Änderungen umzuwandeln und durch Tests und Korrekturen zu verhindern, dass vorhandene Funktionen beschädigt werden.
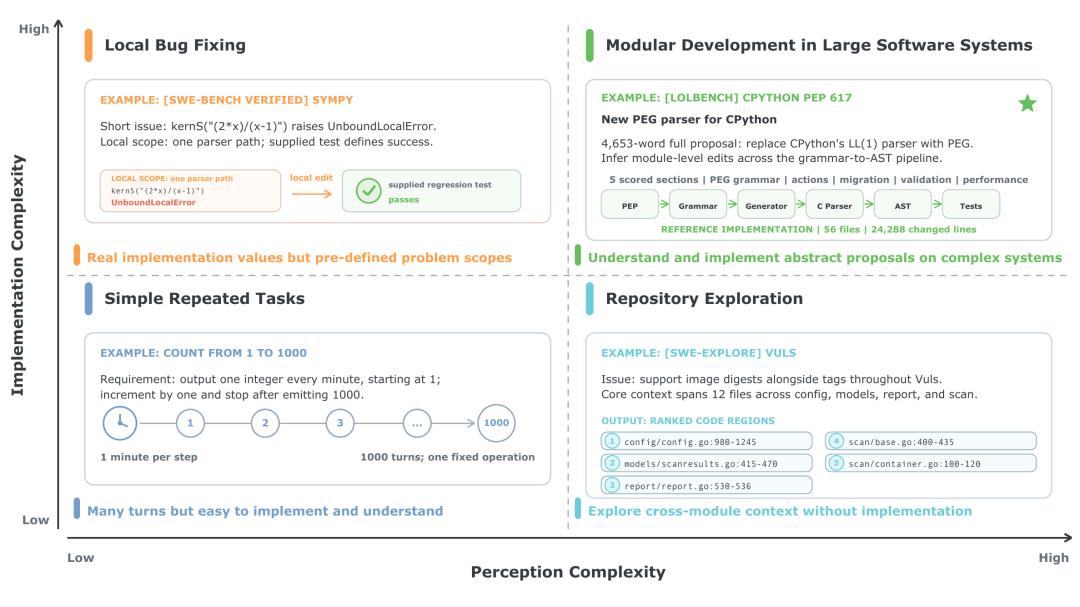
Abbildung 1 Vergleich zwischen Wahrnehmungskomplexität und Implementierungskomplexität.
Wie LoLBench beide Arten von Komplexität gleichzeitig bewertet
Ableitung der Implementierungsspezifikation aus dem Funktionsvorschlag
LoLBench wählt 100 Aufgaben aus Community-Funktionsvorschlägen (Enhancement Proposal) und den entsprechenden zusammengeführten PRs aus, die 29 Systeme, 8 Sprachen und 5 Bereiche abdecken.
Agenten erhalten nur den Vorschlag und das Code-Repository vor der Implementierung, wobei der Vorschlag durchschnittlich etwa 5000 englische Wörter umfasst. Die Bewertung findet in einer vom Netz getrennten Docker-Umgebung statt, um zu verhindern, dass Agenten die stromaufwärts liegende Implementierung abrufen.
Beispielsweise schlägt PEP 617[1] vor, den LL(1)-Parser von CPython durch PEG zu ersetzen. Bei der Implementierung müssen Syntaxdefinition, Parsergenerierung, abstrakte Syntaxbäume und Fehlermeldungen durchgängig verbunden werden. Der Agent muss die gesamte Implementierungskette erkennen.
In Bezug auf die Wahrnehmungskomplexität beträgt die durchschnittliche Erwähnungsrate der Zielklassennamen der Referenzimplementierung in den Vorschlägen bei LoLBench nur 7,3 %, weniger als die Hälfte von SWE-bench Verified (15,9 %) und weniger als ein Fünftel von FeatureBench (38,7 %). Der Agent muss die Verbindung zwischen Anforderungen und Code selbst ableiten.
Umsetzung der Spezifikation in die ingenieurstechnische Lieferung
In Bezug auf die Implementierungskomplexität haben die LoLBench-Repositories durchschnittlich etwa 2,4 Millionen Quellcodezeilen, was etwa dem 9,4-fachen von SWE-bench Verified und dem 4,9-fachen von FeatureBench entspricht. Bei der Implementierung werden durchschnittlich 5499 Zeilen geändert, während die beiden letztgenannten Werte 38 bzw. 2050 betragen. Bei jeder Aufgabe werden durchschnittlich 64,9 Dateien, 40,1 Klassen und 195,9 Funktionen geändert. Die Anzahl der Dateien ist 25-mal so hoch wie bei dem einen und 4,2-mal so hoch wie bei dem anderen. Modulübergreifende Zusammenarbeit und Überprüfung sind schwieriger.
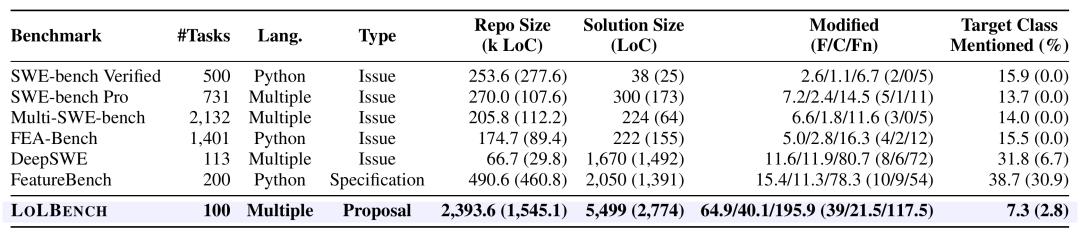
Tabelle 1 Vergleich zwischen LoLBench und vorhandenen Codeaufgaben-Bewertungsdatensätzen.
LoLBench überprüft die Korrektheit der Lieferung durch zwei Arten von Tests: Neue Funktionstests (F2P) erfordern, dass sie vor der Implementierung fehlschlagen und nach der Implementierung bestehen. F2P prüft das Verhalten über öffentliche Schnittstellen und erlaubt unterschiedliche interne Implementierungen. Regressionstests (P2P) erfordern, dass sie sowohl vor als auch nach der Änderung bestehen.
Auf der Grundlage der ursprünglichen Tests des Projekts erstellte das Forschungsteam fehlerhafte Implementierungen wie fehlende Funktionen und manipulierte Anforderungen als Varianten, ergänzte Testfälle, um nicht erkannte Fehler zu identifizieren, und erhöhte die Testabdeckung des Referenzpatches.
Nach der Erweiterung stieg die Erkennungsrate von 1688 Varianten von etwa 61 % auf 96 %, und die durchschnittliche Zeilenabdeckung von F2P pro Aufgabe stieg von etwa 60 % auf 79 %.
Leistung und Engpässe von 28 Agenten-Kombinationen
Selbst bei Austausch des Modells oder des Gerüsts beträgt die maximale Lösungsrate des Agenten nur 14 %
Das Forschungsteam bewertete 28 verfügbare Kombinationen aus 6 fortschrittlichen Modellen und 5 Gerüsten, wobei die maximale Bearbeitungszeit pro Aufgabe 6 Stunden betrug. Opus 5 in Kombination mit Claude Code oder mini-SWE-agent erreichte mit 14 % die höchste Lösungsrate, während der Median aller Kombinationen nur 2 % betrug.
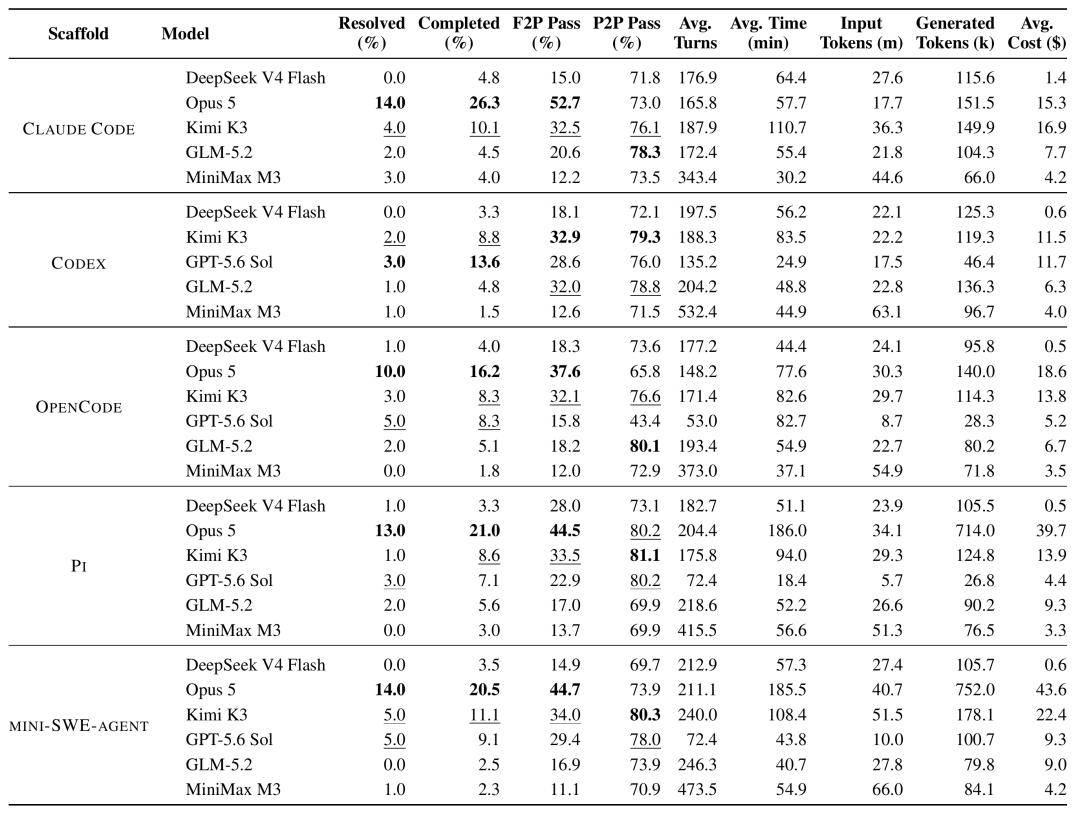
Tabelle 2 Wichtigste experimentelle Ergebnisse aus dem Papier
Bei gleicher Verwendung von Opus 5 weisen mini-SWE-agent und Claude Code die gleiche Lösungsrate auf. Der Zeitaufwand von erstem ist 3,2-mal so hoch wie der von zweitem, und die generierten Token sind 5-mal so hoch. Höherer Verbrauch führt nicht zu einer höheren Lösungsrate.
Ein großer Teil der Interaktionen und Token wird für die Code-Lokalisierung aufgewendet
Betrachtet man den Token-Verbrauch, so macht die Lokalisierungsphase durchschnittlich 52,4 % der nicht zwischengespeicherten Eingabetoken und 45,4 % der generierten Token aus. Betrachtet man die Anzahl der Interaktionsrunden des Agenten, so ist die Anzahl der Interaktionsrunden in der Lokalisierungsphase ebenfalls deutlich höher als in anderen Phasen.
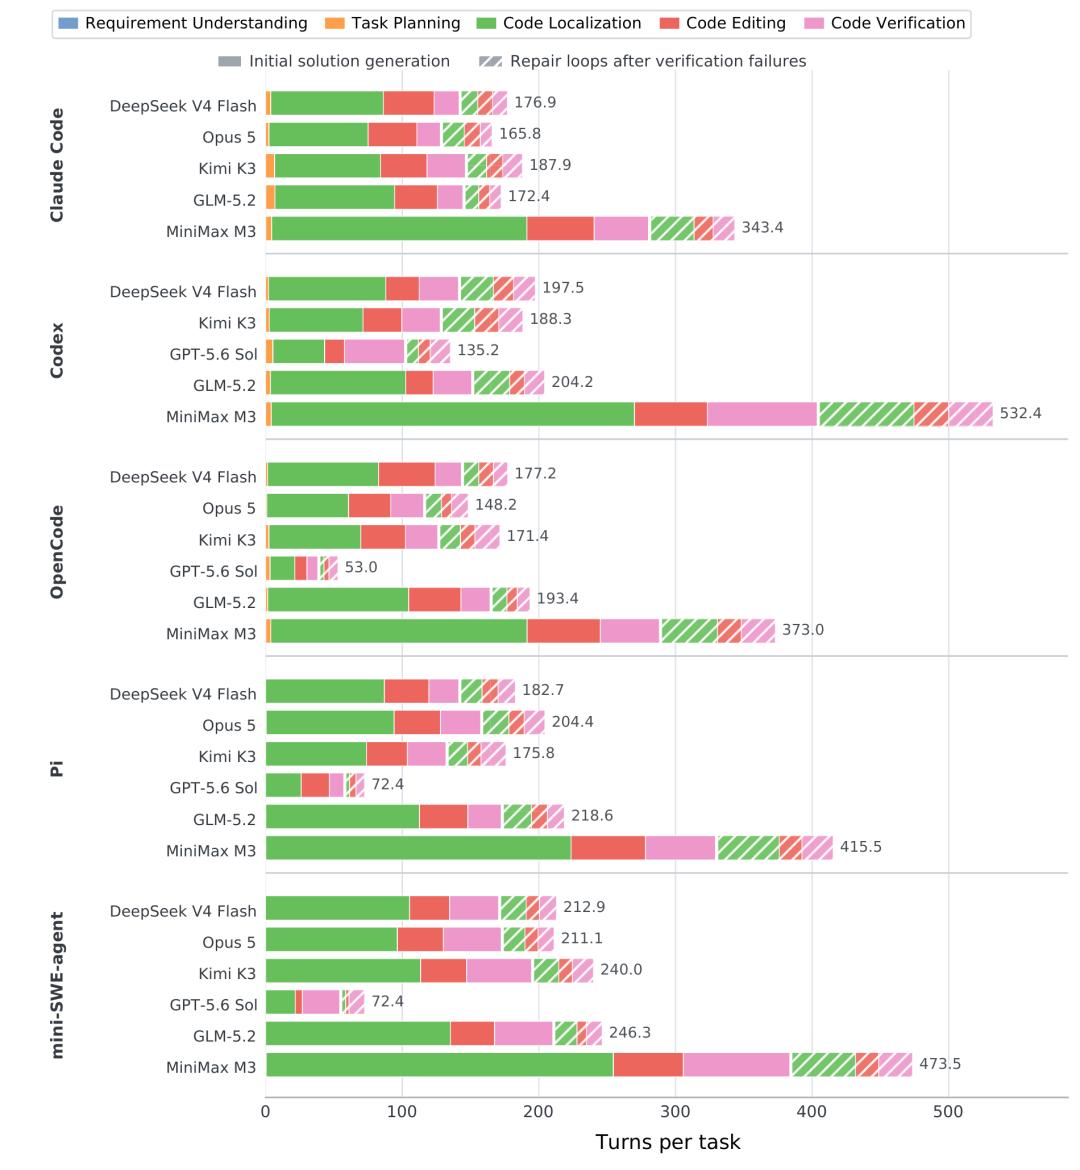
Abbildung 2 Durchschnittliche Anzahl von Interaktionsrunden in jeder Phase.
Verglichen mit den vorhandenen Dateien und Funktionen, die bei der Referenzimplementierung geändert werden, liegt die Genauigkeit der Dateiänderung bei allen 28 Agentengruppen zwischen 38,0 % und 80,4 %, die Trefferquote zwischen 30,3 % und 65,0 %. Die Genauigkeit der Funktionsänderung liegt zwischen 54,2 % und 65,6 %, die Trefferquote zwischen 20,8 % und 53,4 %. Die Genauigkeit der Code-Lokalisierung ist niedrig und die Abdeckung ist noch unvollständig.
Auch nach Ergänzung der Änderungsrichtlinien ist es für Agenten schwierig, die vollständige Lieferung durchzuführen
Das Forschungsteam behielt den ursprünglichen Funktionsvorschlag bei und stellte zusätzlich den aus der Referenzimplementierung exportierten geänderten Dateibaum und die API-Implementierungsspezifikation bereit, um dem Agenten bei der Bestimmung des Änderungsumfangs zu helfen. Die Lösungsrate von Opus 5+Claude Code stieg von 14 % auf 34 %, die von GPT-5.6 Sol+Codex von 3 % auf 25 % und die von DeepSeek V4 Flash+OpenCode von 1 % auf 17 %.
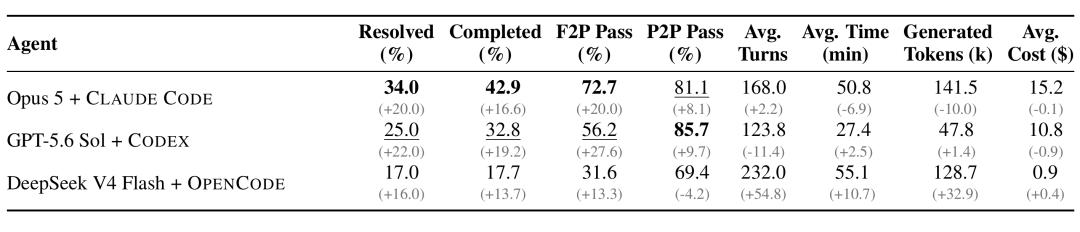
Tabelle 3 Experimentelle Ergebnisse nach Ergänzung des geänderten Dateibaums und der API-Implementierungsspezifikation
Die Ergänzung von Änderungsrichtlinien kann die Wahrnehmungsbelastung verringern, aber bei der besten Kombination sind immer noch 66 % der Aufgaben ungelöst. Der Agent muss weiterhin Module koordinieren, Schnittstellen implementieren und die Überprüfung bestehen, was darauf hindeutet, dass die Implementierungskomplexität großer Systeme ebenfalls sehr hoch ist.
Von der Codegenerierung zur Weiterentwicklung großer Softwaresysteme
Diese Ergebnisse liefern überprüfbare Richtungen für die Agentenentwicklung: Kann die Repository-Abrufung kritische Abhängigkeiten abdecken, ist die Implementierungsspezifikation vor dem Codieren vollständig und kann die Überprüfung modulübergreifende Versäumnisse rechtzeitig erkennen?
Der Wert der Softwaretechnik liegt darin, ob Benutzeranforderungen zuverlässig umgesetzt werden können. Agenten müssen verstehen, warum Änderungen stattfinden, wie sie das System beeinflussen, und die Änderungen vollständig implementieren. LoLBench hofft, die Bewertung der Agentenfähigkeiten von der Codegenerierung hin zur Unterstützung der kontinuierlichen Weiterentwicklung von Software voranzutreiben, sodass das Lieferergebnis zum Maßstab für die Prüfung der Fähigkeiten des Agenten wird.
Referenz: PEP 617: https://peps.python.org/pep-0617/
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „AI Era“, Autor: AI Era; Redakteur: LRST, veröffentlicht mit Genehmigung von 36Kr.