Anthropic macht eigenhändig der sogenannten "Shell-KI" ein Ende, entlarvt falsche KI-Modelle innerhalb von 17 Sekunden, und die Verifizierungsgeschwindigkeit ist 5000-fach schneller.
Man zahlt den Preis für das Top-Flaggschiff, nutzt aber die API eines weiterverkauften Routers – und was im Hintergrund tatsächlich arbeitet, ist möglicherweise ein abgespecktes kleines Modell.
Diese verdeckte Operation, die unter falschen Vorwänden läuft, war bisher der geheimste Graubereich in der gesamten Lieferkette von Large-Language-Modell-APIs.
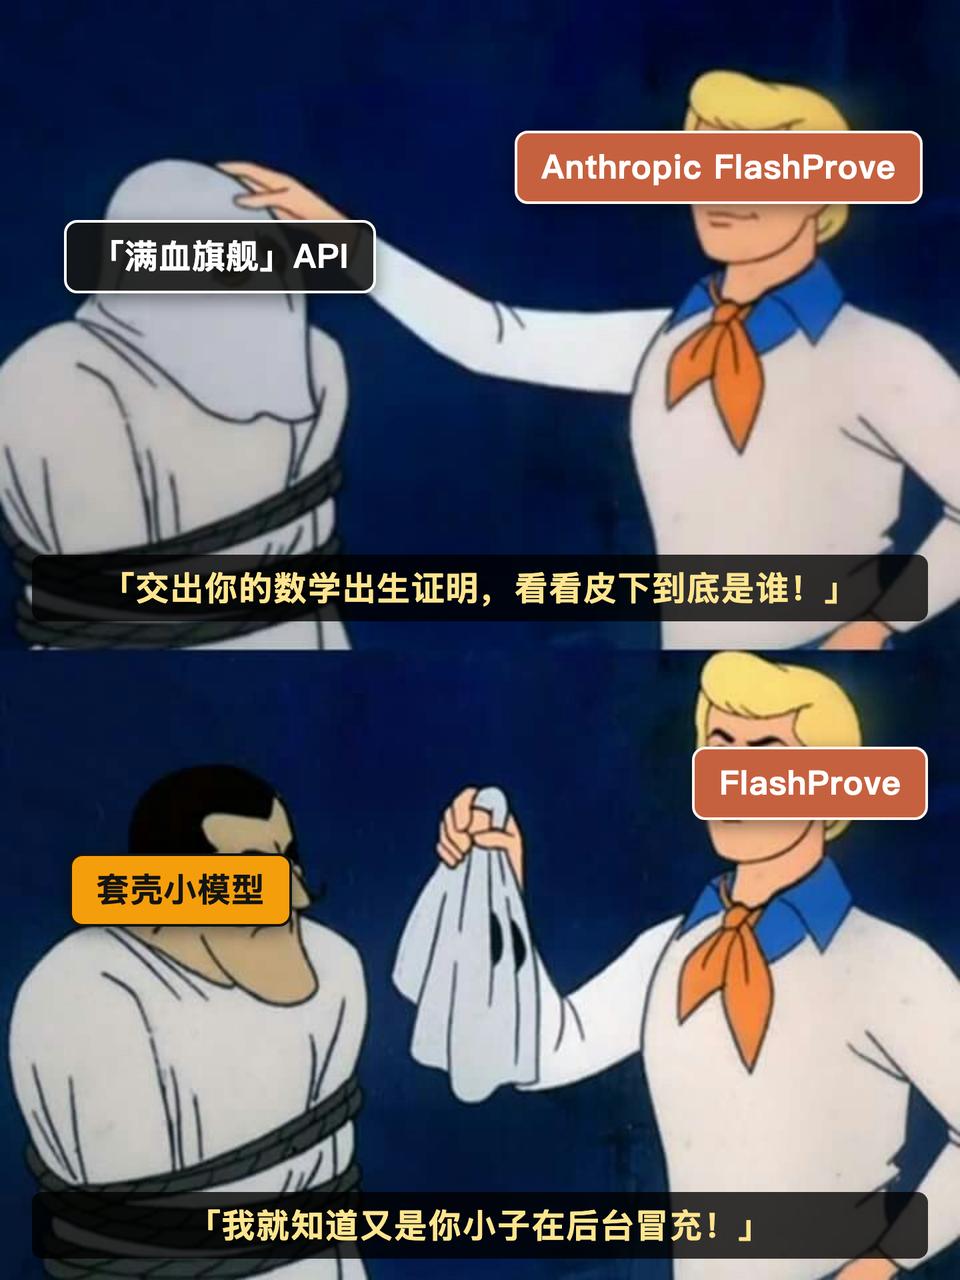
Ohne Gewichtungen, ohne eigene Rechenzentren können Entwickler nur tatenlos zusehen und den Schaden hinnehmen, selbst wenn das System im Hintergrund nachts heimlich ausgetauscht und die Leistung herabgesetzt wird.
Heute wird diese verdeckte Kette mit einem Schlag durchtrennt!
Gerade eben hat Anthropic gemeinsam mit einem Wissenschaftler von Weltrang auf dem Gebiet der Nullwissensbeweise einen bahnbrechenden Durchbruch bei der „beweisbaren Inferenz“ für große Modelle vorgestellt und das kryptographische Verifizierungssystem FlashProve offiziell als Open-Source veröffentlicht!
Von nun an müssen Entwickler keinerlei zentralisierte Instanzen vertrauen, und sie müssen auch nicht veranlassen, dass Dienstleister auch nur eine Zeile Gewichtungs-Code herausgeben. Jede Antwort, die ein großes Modell generiert, erhält zwangsläufig einen mathematischen „Geburtsnachweis“.
Selbst wenn man nur einen gewöhnlichen Heim-CPU zur Verfügung hat und diesen 17 Sekunden lang laufen lässt, kann man auf rein mathematische Weise präzise überprüfen, ob jedes Token von dem Zielmodell „stammt“ – alle Tricks wie das heimliche Austauschen des Modells oder nachträgliches Manipulieren der Ausgabe werden sofort aufgedeckt!
Noch beeindruckender ist, dass die Kernmannschaft, die FlashProve entwickelt hat, Claude selbst ist.
Dieses Mal sind der gesamte Code, die Lean-Beweise und die technische Dokumentation vollständig unter der Apache-2.0-Lizenz als Open Source veröffentlicht.
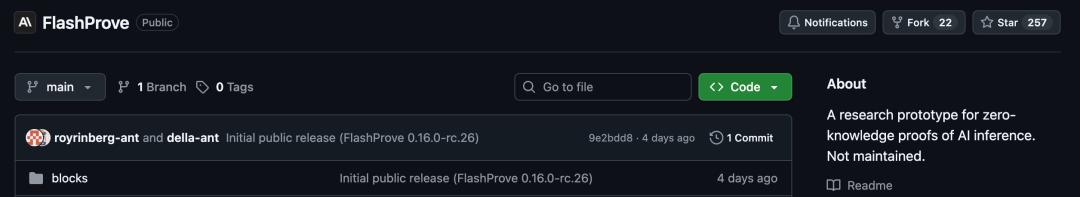
Portal: https://github.com/anthropics/FlashProve
Unterschrift leisten, Nachweis ausstellen, sekundenschnelle Verifizierung
Beendigung des „Maskierens und Austauschens“ bei großen Modellen
Wenn das große Modell plötzlich „dümmer“ zu werden scheint, fragen viele Menschen das Modell „Wer bist du wirklich?“ oder probieren es mit einigen Mathematikaufgaben aus.
Aber die Antwort des Modells zur eigenen Identität wird ja selbst im Hintergrund generiert, und geringfügige Schwankungen bei der Rechenlast und den Sampling-Einstellungen können die Antwort verändern. Nutzer erhalten nie einen unwiderlegbaren Beweis, der den Dienstleister zweifelsfrei festnagelt.
Ein noch beunruhigenderes Szenario hat Anthropic in seinem Blog festgehalten —
Da Modelle immer leistungsfähiger werden und sich selbst bereitstellen können, kann ein fortgeschritteneres Modell durchaus an die Stelle eines zugelassenen schwächeren Modells treten, sich dann als das schwächere Modell ausgeben und die eigentlich vorgesehene Überwachung umgehen.
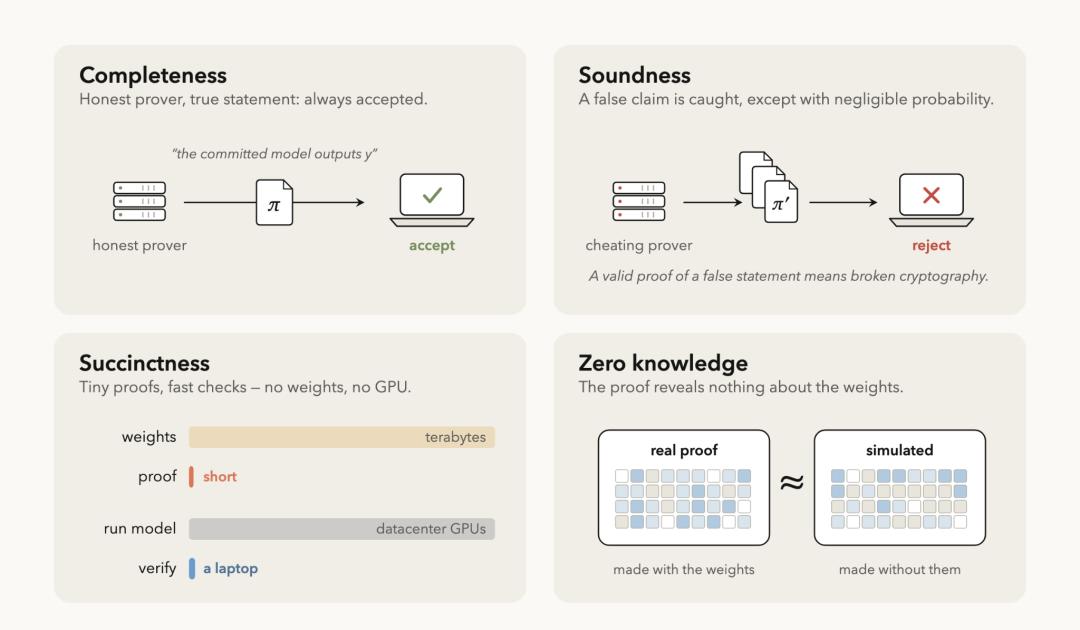
Um die Echtheit zu überprüfen, gab es bisher nur den herkömmlichen Weg, die Gewichtungen zu erhalten und das Modell selbst neu auszuführen. Aber die Gewichtungen modernster Modelle sind das wertvollste Gut jedes Unternehmens, und normale Nutzer können sich die Rechenzentren für Modelle mit 400 Milliarden Parametern überhaupt nicht leisten.
Um dieses Problem zu lösen, ohne die Gewichtungen einzusehen oder das Modell neu auszuführen, teilt FlashProve den Verifizierungsprozess in drei ineinandergreifende Schritte auf.
Erster Schritt: Offline „Unterschrift leisten“.
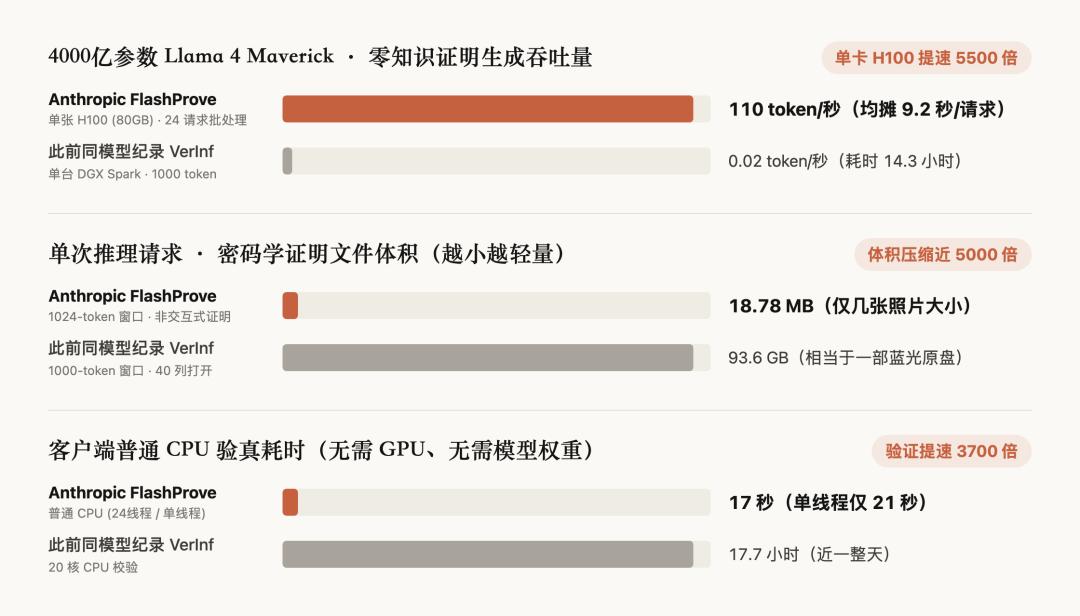
Bevor das Modell in Betrieb genommen wird, erstellt der Dienstleister auf einer einzelnen H100 in etwa 39 Minuten mit Nullwissenskodierung eine eindeutige Versprechens-ID für die Modellgewichtungen und veröffentlicht diese im gesamten Netzwerk. Diese ID ist wie ein digitaler DNA-Fingerabdruck der Gewichtungen – selbst wenn man nur einen Parameter heimlich ändert, stimmt er nicht mehr überein. Aber Außenstehende können anhand des Fingerabdrucks keineswegs die Gewichtungen zurückschließen.
Zweiter Schritt: Online „Nachweis ausstellen“.
Nach jeder Verarbeitung einer Dialoganfrage generiert die GPU des Dienstleisters automatisch einen etwa 19 MB großen kryptographischen Nachweis, der bestätigt, dass die entsprechende Ausgabe tatsächlich von dem Modell berechnet wurde, das zuvor unterschrieben wurde.
Dritter Schritt: Auf der Client-Seite „Echtheit prüfen“.
Jeder Nutzer oder Prüforgan kann nach Erhalt der Antwort das Verifizierungsprogramm cp_verify auf einem gewöhnlichen CPU ausführen und erhält in 17 Sekunden das Urteil „wahr“ oder „falsch“ – der gesamte Prozess braucht weder Gewichtungen noch eine GPU.
Die zugrundeliegende Engine, die diese Funktionsweise ermöglicht, ist das in der Kryptographie bekannte zkSNARK (Zero-Knowledge Succinct Non-Interactive Argument of Knowledge).
Der Verifizierer muss nur wie ein Lehrer, der Hausaufgaben stichprobenartig prüft, einige Stellen zufällig durchsehen, um mit sehr hoher Wahrscheinlichkeit Fehler zu erkennen.
Um eine Inferenz in eine stichprobenprüfende Form zu zerlegen, werden für jede Anfrage etwa 2000 Unterprotokolle namens Sumcheck ausgeführt.
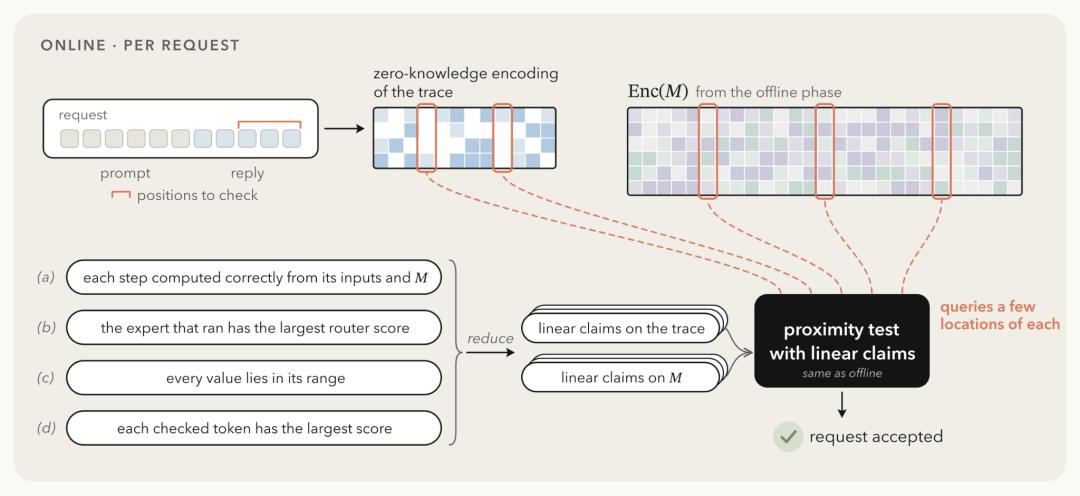
Noch anspruchsvoller ist, dass seine Sicherheit nur von der Hashfunktion BLAKE2 abhängt, nicht von algebraischen Strukturen wie elliptischen Kurven. Es gilt sogar als resistent gegen Angriffe von zukünftigen Quantencomputern. Diese kryptographische Vorgehensweise hat sich zudem bereits in der Praxis in Ethereum-Layer-2-Netzwerken wie Starknet bewährt.
Wenn das Prinzip verstanden ist, stellt sich die eigentliche Schwierigkeit: Kann ein so aufwendiger Nachweis auf einem großen Modell mit 400 Milliarden Parametern überhaupt ausgeführt werden?
Einzelne H100 erreicht 5500-fache Geschwindigkeit
80 GB VRAM verarbeitet das 400-Milliarden-Parameter-Monster
Die Antwort lautet: Ja, und das mit nur einer einzelnen H100.
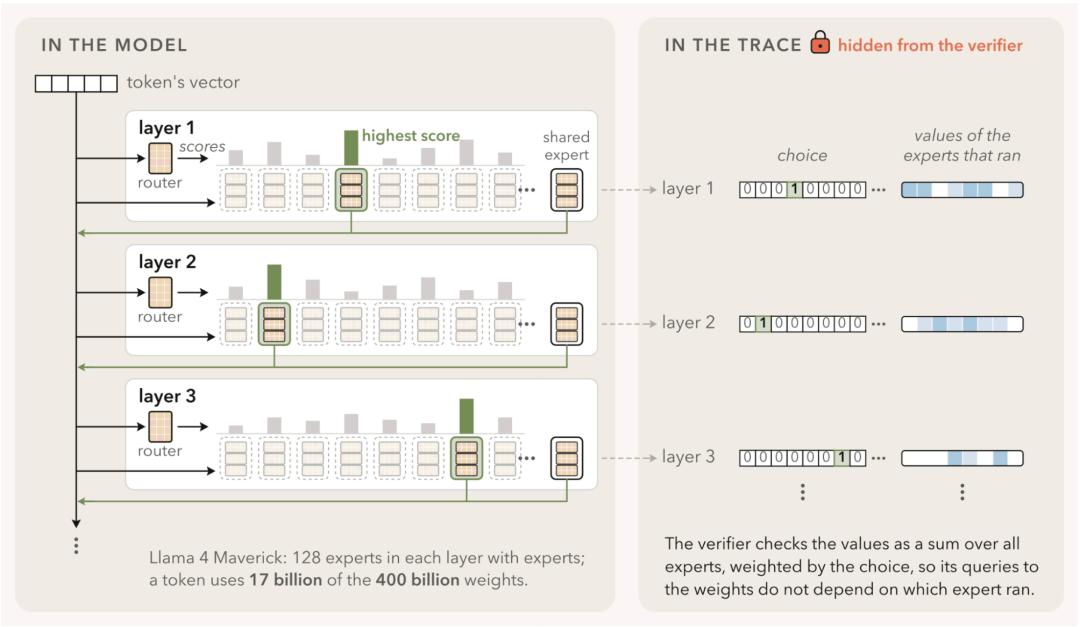
Das Testobjekt des Teams war Llama 4 Maverick von Meta, ein Mixture-of-Experts-Modell (MoE) mit 400 Milliarden Parametern, bei dem für jedes Token tatsächlich nur etwa 17 Milliarden Parameter aktiviert werden.
FlashProve nutzt diese Eigenschaft voll aus: Bei der Generierung der Berechnungsspur hängt der Arbeitsaufwand nur von den 17 Milliarden tatsächlich arbeitenden Parametern ab, sodass über 95 % der unnötigen Leerlaufarbeiten entfallen.
Noch cleverer: Um zu verhindern, dass Außenstehende durch die Information „welche Experten aktiviert wurden“ die Geheimnisse der Modellgewichtungen zurückschließen, verbirgt das System die Routing-Auswahl mit Nullwissenskodierung in einem Indikatorvektor. Der Verifizierer führt bei der Prüfung eine gewichtete Summe über alle Experten durch, was nicht nur eine enorme Menge an Rechenleistung einspart, sondern auch die internen Ablaufpfade des Modells geheim hält.
Die Gewichtungen des Modells nach 4-Bit-Quantisierung betragen ganze 232 GB, während der VRAM einer einzelnen H100 nur 80 GB groß ist. Ein direktes Laden würde sofort einen VRAM-Überlauf verursachen.
Wenn man die gesamte Berechnungsspur des Inferenzprozesses auf einmal zusammenpackt, hält selbst die leistungsstärkste Grafikkarte das nicht aus.
Daher platziert das Team die Gewichtungen im Host-Arbeitsspeicher und lädt sie abschnittsweise in die GPU, um Berechnungen und Nachweise Abschnitt für Abschnitt durchzuführen.
Die H100 arbeitet wie eine Fließband: Sie liest jedes Mal nur einen Ausschnitt der Gewichtungen als Stream aus dem Arbeitsspeicher, führt nach der Berechnung sofort Kodierung, Hash-Berechnung und Reduktion im VRAM durch und behält nur eine sehr kleine Menge an Daten, die an den nächsten Abschnitt übergeben werden müssen.
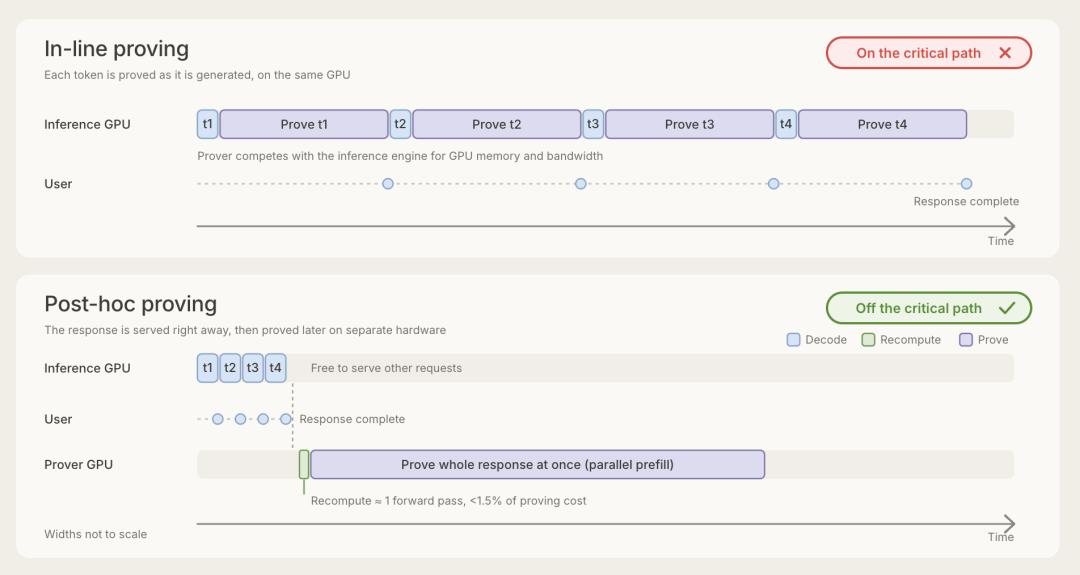
Dank dieser stromlinienförmigen Arbeitsweise „einen Abschnitt verarbeiten, dann verdauen“ schafft es eine einzelne 80-GB-Grafikkarte, das 232 GB große riesige Modell zu verarbeiten.
114-seitige Arbeit wurde von keinem Menschen vollständig gelesen
Claude erstellt die gesamten 400 MB mathematischen Beweise
An dieser Stelle fragt man sich vermutlich, wie viele Kryptographie-Doktoren ihre Arbeit in dieses so präzise und komplexe kryptographische Protokoll und GPU-Beschleunigungsprojekt gesteckt haben.
Wenn man die Open-Source-Homepage von FlashProve auf GitHub öffnet, zeigt die Sprachstatistik auf der rechten Seite sofort die Ungewöhnlichkeit dieses Projekts.
Im gesamten Repository macht C++-Code nur 1,4 % aus, Python 1,3 %, CUDA 0,9 % – und ganze 95,2 % des Codes (insgesamt 398 MB) sind vollständig in der mathematischen Beweissprache Lean 4 verfasst.
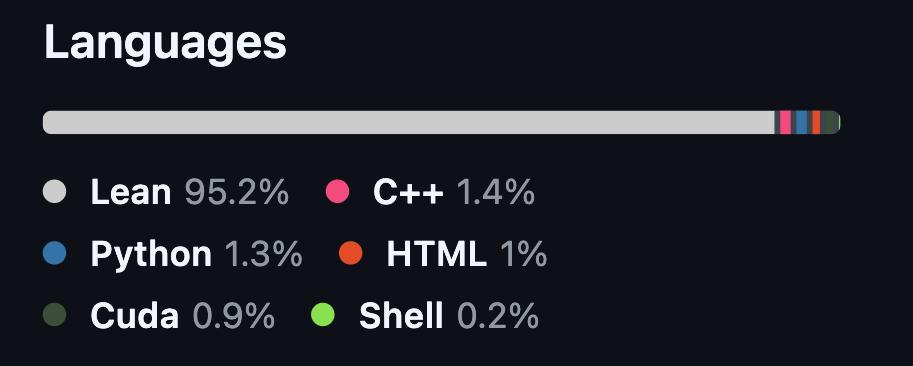
Warum ist ein Repository für die Inferenz großer Modelle mit fast 400 MB mathematischen Beweisen gefüllt? Die 114-seitige Protokoll-Spezifikation, die dem Repository beigefügt ist, gibt auf Seite 51 die Antwort.
Menschliche Wissenschaftler waren in diesem Projekt nur für die Richtungsweisung verantwortlich: Von dieser 114-seitigen kryptographischen Arbeit, dem 23-seitigen technischen Bericht über den C++- und CUDA-Tiefencode bis hin zu den fast 400 MB großen formalen Lean-Beweisen stammt fast alles von Claude.
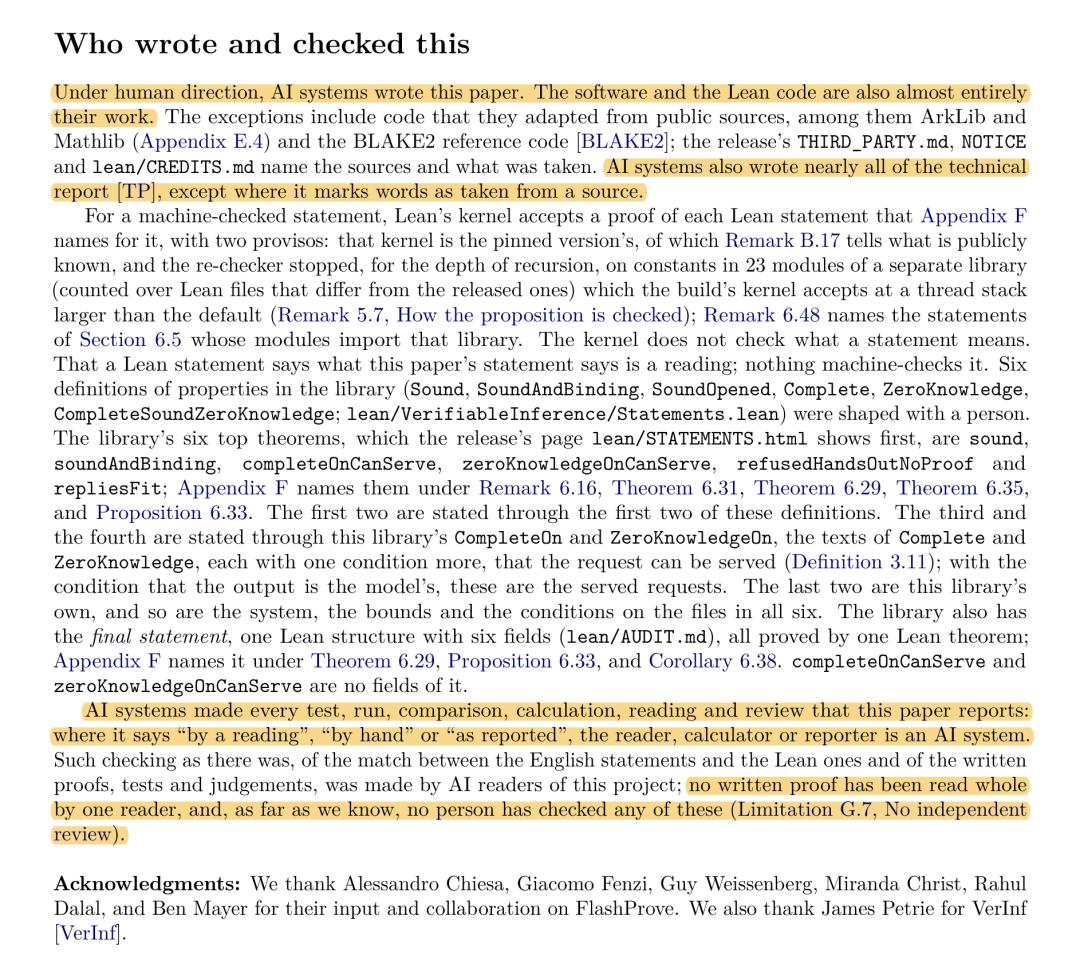
Nicht nur das Schreiben von Code und Arbeiten: Jeder Test, jeder Lauf, jeder Vergleich, jede Berechnung und jede Code-Prüfung im Projekt wurde vollständig von der KI übernommen. Überall wo im Text steht „gelesen“, „manuell berechnet“ oder „gemeldet“, handelt es sich bei dem Leser, Rechner und Melder um die KI.
Kryptographischer Code gilt seit jeher als der empfindlichste Bereich in der Softwareentwicklung. Selbst wenn nur ein Symbol vertauscht oder eine Zufallszahlenmaske vergessen wird, stür