Das Princeton AI Lab hat die große Prüfung zum Thema „Räumliche Intelligenz“ erstellt: Menschen erreichen 83,3 %, während die großen Modelle einen Höchstwert von 39,7 % erzielen.
Kann KI die dreidimensionale Welt wirklich verstehen?
Die Planung des nächsten Schritts, die rechtzeitige Anpassung nach dem Verschieben eines Bechers und die Durchführung von Operationen vor der Änderung der Umgebung stellen dynamische Aufgaben an KI mit immer komplexeren räumlichen Anforderungen. Eine der Grundlagen zur Unterstützung dieser Verhaltensweisen ist das zuverlässige Verständnis des vorliegenden Raums: Wo befinden sich Objekte? Können Beobachtungen aus verschiedenen Perspektiven miteinander übereinstimmen?
Forscher des Princeton AI Lab haben ein neues Prüfblatt für räumliche Intelligenz vorgelegt: Same Space or Not (SSoN). Es entfernt Echtzeitänderungen und Aktionssteuerung, stellt nur vier statische Innenraumbilder zur Verfügung und lässt das Modell dasjenige Bild finden, das nicht zur selben Szene gehört, und erklären, warum.
- Projekt-Homepage: https://sson.aisexam.com/
- Papier-Link: https://arxiv.org/abs/2610.23959
- Datensatz: https://huggingface.co/datasets/HuiziCao/SSoN
- Code-Link: https://github.com/sson-benchmark/SSoN
- Feinabstimmungsgewichte: https://huggingface.co/HuiziCao/SSoN-Qwen2.5-VL-7B-LoRA
Die Ergebnisse zeigen einen deutlichen Unterschied: Bei den vollständigen 1000 Fragen erreicht die menschliche Genauigkeit 83,3 %. Unter den sechs getesteten visuell-sprachlichen Modellen (VLM) führt GPT-6 Astra Pro mit 39,7 %, die restlichen fünf liegen alle unter dem zufälligen Basiswert von 25 % bei der Auswahl aus vier Optionen. Ohne die Komplexität dynamischer Interaktionen zeigt sich der Mensch-Maschine-Unterschied bereits beim grundlegenderen statischen perspektivenübergreifenden Verständnis.
Warum liegt der Wert unter 25 %? Das ist die Erwartung bei blindem Raten mit gleicher Wahrscheinlichkeit, nicht die untere Grenze der Fähigkeit. SSoN erstellt speziell stark störende Ansichten, die „wie verändert aussehen, aber räumlich korrekt sind“. Wenn das Modell Unterschiede im Aussehen erkennen kann, aber nicht beurteilen kann, ob sie aus Perspektivenänderungen stammen, kann es systematisch fehlgeleitet werden, sodass seine Leistung sogar unter das blinde Raten fällt. Das bedeutet nicht, dass es überhaupt keine visuelle Fähigkeit hat, sondern zeigt die Lücke zwischen dem Erkennen von Unterschieden und dem Verständnis des Raums auf.
Und 39,7 % sind nur die Punktzahl für die richtige Auswahl der Antwort, wobei die Begründungen einiger Antworten immer noch nicht haltbar sind.
Warum liegen alle 17 visuellen Encoder unter der Zufallslinie? Wenn das Modell tatsächlich die dreidimensionale Rekonstruktion durchführt, warum erreicht es dann immer noch nicht die Hälfte der richtigen Antworten? Dieses Prüfblatt schichtet Schicht für Schicht auf, „wo die räumliche Intelligenz hängt“.
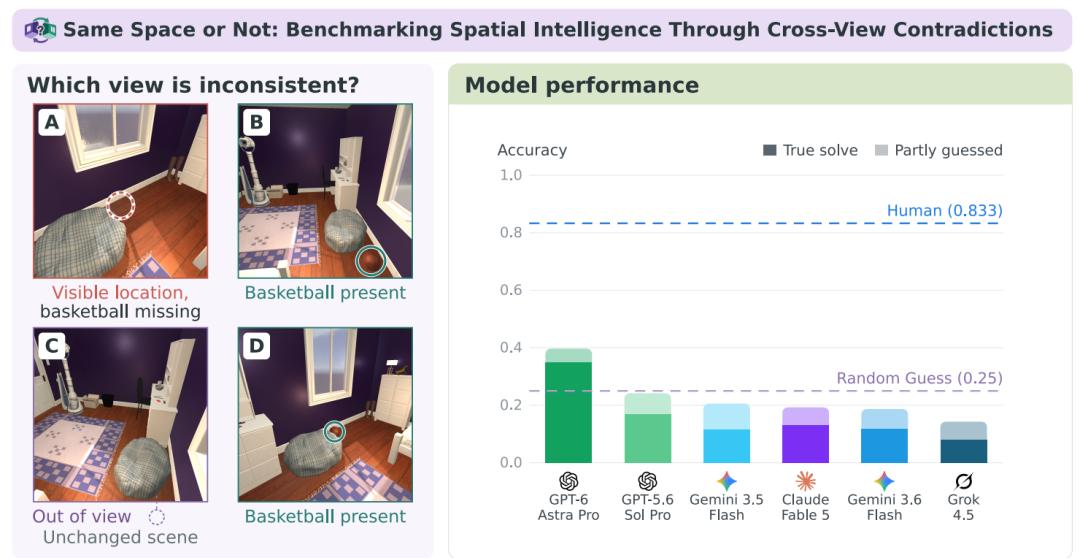
Abbildung 1|SSoN-Aufgabe und Ergebnisse bei den vollständigen 1000 Fragen. Die menschliche Antwortgenauigkeit beträgt 83,3 %, die höchste Genauigkeit der getesteten VLM liegt bei 39,7 %; das Säulendiagramm unterscheidet weiter zwischen richtigen Auswahl mit ausreichenden Belegen und richtigen Auswahl mit unbegründeten Erklärungen.
Kollektive einseitige Schwäche der räumlichen Intelligenz:
Austausch und Details sind relativ einfach, aber Rotation und Verschiebung werden zu gemeinsamen blinden Flecken
Die Regeln von SSoN sind sehr einfach: Drei der vier Bilder stammen aus einer unveränderten dreidimensionalen Szene, eines aus einer bearbeiteten Version. Es gibt keine festgelegte „korrekte Referenzabbildung“ und keine im Voraus markierten anomalen Objekte. Das Modell muss selbst entscheiden: Welche Beobachtungen können sich gegenseitig bestätigen und welches Bild kann nicht mit ihnen koexistieren.
Der Basketball im Bild ist ein Beispiel dafür. B und D bestätigen gemeinsam seine Position; C zeigt diese Position nicht und zeigt Objekte, die in anderen Ansichten nicht zu sehen sind, aber all das kann durch Perspektivenänderungen erklärt werden. A zeigt jedoch die Position, an der sich der Basketball befinden sollte, der Basketball fehlt trotzdem. Der Schlüssel liegt darin, ob die räumlichen Beziehungen konsistent sind. Nur aufgrund von „sieht anders aus“ kann man leicht falsch wählen.
Wenn man die Ergebnisse nach Fragetypen aufteilt, zeigen die sechs Bearbeitungstypen ungefähr drei Schwierigkeitsstufen und skizzieren auch verschiedene Lücken in der räumlichen Fähigkeit der aktuellen Modelle.
Austausch und Detailänderungen sind die relativen Vorteilsbereiche des Modells. Der Positionsaustausch zweier Objekte oder Änderungen des Aussehens wie Form, Farbe und Textur desselben Objekts liefern Hinweise für die Beurteilung der Objektzuordnung und der Unterschiede im Aussehen. Die Genauigkeit der sechs getesteten Modelle bei diesen beiden Typen liegt über ihrer jeweiligen Gesamtleistung; das leistungsstärkste Astra Pro erreicht bei beiden Typen über 80 %.
Spiegelung und Löschung liegen in der mittleren Ebene, sind aber für die meisten Modelle immer noch sehr schwierig. Bei Spiegelungsfragen muss beurteilt werden, ob die Raumstruktur tatsächlich links-rechts gespiegelt ist, um visuelle Änderungen auszuschließen, die durch den Seitenwechsel der Kamera verursacht werden; bei Löschfragen muss unterschieden werden zwischen „das Objekt ist wirklich verschwunden“ und „es ist nur verdeckt oder aus dem Sichtfeld gerückt“. Nicht sichtbar zu sein, bedeutet nicht, nicht zu existieren. Bei Spiegelungsfragen liegen außer Astra Pro alle fünf anderen Modelle unter dem zufälligen Basiswert von 25 %; bei Löschfragen beträgt die höchste Punktzahl dieser fünf Modelle nur 42,57 % von Sol Pro.
Verschiebung und Rotation zeigen allgemeinere Mängel im geometrischen Schlussfolgern auf. Die höchste Genauigkeit der sechs Modelle bei Verschiebungsfragen beträgt nur 27,20 %; bei Rotationsfragen ist sie noch niedriger, der Höchstwert liegt nur bei 9,54 %. Menschen erreichen bei diesen beiden Typen über 70 %. In nachfolgenden Experimenten konnte die Punktzahl dieser beiden Typen auch dann nicht effektiv verbessert werden, wenn dem Modell explizit mitgeteilt wurde, was die sechs Bearbeitungstypen sind.
Wenn ein Stuhl im Bild seine Position und Ausrichtung ändert, ist es dann der Stuhl, der sich bewegt hat, oder die Kamera? Wenn es im Raum noch mehrere Stühle mit gleichem Aussehen gibt, muss das Modell zuerst dieselbe Instanz identifizieren und dann die Position und Ausrichtung anhand von Referenzen wie Tisch und Wand beurteilen. Nach dem Erkennen von Objekten und dem Feststellen von Unterschieden im Aussehen muss das Modell noch die Hürde des „Verstehens dreidimensionaler Beziehungen“ überwinden.
SSoN erweitert diese Prüfung auf sieben Innenraumszenenquellen und deckt sechs Arten von dreidimensionalen Bearbeitungen ab: Austausch, Detailänderung, Spiegelung, Löschung, Verschiebung und Rotation. 1000 Fragen und 4000 Bilder lassen die Fähigkeitsunterschiede unter der Gesamtpunktzahl nacheinander sichtbar werden: Welche Änderungen das Modell bereits relativ leicht erfassen kann und welche räumlichen Beziehungen sie gemeinsam Punkte verlieren lassen.
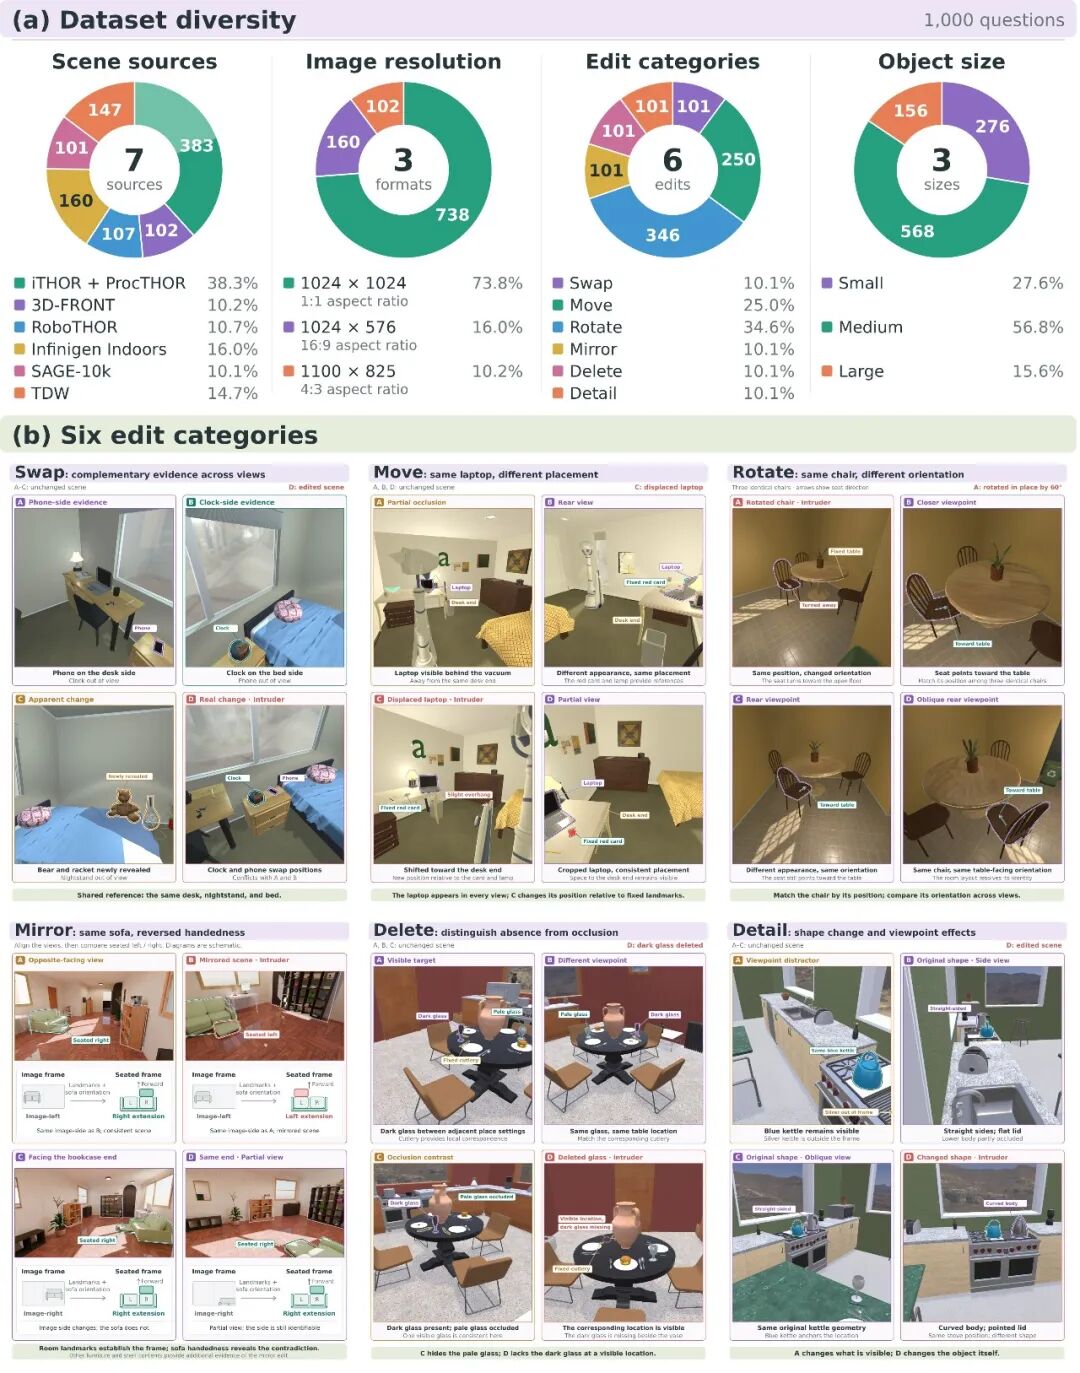
Abbildung 2|Sieben Szenenquellen, sechs Arten von dreidimensionalen Bearbeitungen sowie verschiedene Bildformate und Objektgrößen. Perspektivenänderungen können visuelle Unterschiede erzeugen, echte Bearbeitungen können auch nur lokale Hinweise hinterlassen.
Bei Verwendung von 17 visuellen Encodern liegen alle immer noch unter der Zufallslinie
Gibt es eine andere Lösung? Da es nur ein anomales Bild gibt, reicht es dann nicht aus, direkt das Bild zu finden, das am wenigsten mit den anderen drei übereinstimmt?
Die Forscher testeten diese Idee mit insgesamt 17 visuellen Encodern der Serien CLIP, ViT und DINOv2. Bei der Auswahl der Ausreißeransicht anhand der Ähnlichkeit von Bildmerkmalen liegt die Genauigkeit nur zwischen 16,9 % und 21,7 %, alle unter dem zufälligen Basiswert von 25 %.
Dieses Ergebnis zeigt die Wirkung der starken Störung konkret auf: Eine korrekte neue Perspektive kann einen großen Teil des sichtbaren Inhalts ändern, während eine echte Bearbeitung möglicherweise nur lokale Hinweise hinterlässt. Auswahlregeln, die auf globalen Unterschieden im Aussehen beruhen, können die beiden nicht zuverlässig unterscheiden.
Auch VLM werden von diesen oberflächlichen Unterschieden fehlgeleitet. In diagnostischen Experimenten in der Entwicklungsphase zogen legale, aber leicht irreführende Ansichten mehr falsche Auswahl an; nachdem sie durch klare frontale Referenzen ersetzt wurden, verbesserte sich die Leistung bei vielen Fragetypen deutlich. Der Ersatz reduziert gleichzeitig Störungen und erhöht direkte Belege, sodass die schwierigen Positionen klarer werden: Dass man eine Änderung vor Augen erkennen kann, garantiert nicht, dass man sie auch aus einer anderen Perspektive schlussfolgern kann.
Menschen können vorübergehend eine unbekannte Perspektive akzeptieren und dann Objekte überprüfen, die mit anderen Bildern in Verbindung stehen. SSoN prüft genau, ob das Modell diesen Schritt der perspektivenübergreifenden räumlichen Integration abschließen kann.
Fast 30 % der Erklärungen selbst für richtige Antworten bestehen die Prüfung nicht
Auffälliger als die niedrigen Punktzahlen ist, dass einige richtige Optionen nicht unbedingt mit korrekten räumlichen Urteilen übereinstimmen.
Das Modell könnte A richtig auswählen, aber behaupten, dass ein Objekt, das sich überhaupt nicht geändert hat, verschoben wurde; es könnte auch Hinweise liefern, die wahr sind, aber nicht ausreichen, um andere Ansichten auszuschließen. Wenn man nur A, B, C, D betrachtet, werden diese Antworten alle als richtig gewertet.
SSoN prüft daher gleichzeitig Antwort und Belege. „True solve“ erfordert eine richtige Auswahl, und die Erklärung muss mit den Bildfakten übereinstimmen und das perspektivenübergreifende Widerspruchsurteil ausreichend unterstützen. Von insgesamt 1368 richtigen Auswahl bei den sechs Modellen bestanden 29,5 % diese Prüfung nicht. Die höchste Modellgenauigkeit sank von 39,7 % Antwortgenauigkeit auf 34,9 % True solve.
Fast 30 % der richtigen Auswahl fehlen an wirksamer Unterstützung, was zeigt, dass „richtig ausgewählt“ nicht „klar erklärt, warum“ ersetzen kann. Diese Prüfung zielt auf die vom Modell geschriebene Erklärung ab, ohne Rückschlüsse darauf zu ziehen, wie es intern tatsächlich denkt.
Ist es dann möglich, dass die Fragen selbst zu knifflig sind und es nicht genügend Belege gibt?
SSoN hat sowohl bei der Erstellung der Fragen als auch bei der Korrektur Prüfungen durchgeführt: Bei der Konstruktion wird verlangt, dass das anomale Bild und mindestens zwei normale Ansichten verfügbare Belege liefern, um Mehrdeutigkeitsfragen und offensichtliche Rendering-Abkürzungen auszuschließen; bei der Korrektur werden alle richtigen Modellantworten einer manuellen Belegprüfung unterzogen. Durch die Iteration von mehr als 10.000 entwickelten Kandidatenfragen werden manuell gefundene Probleme ständig zu neuen Generierungsbeschränkungen, sodass schließlich diese 1000 Fragen übrig bleiben.
Ein Prüfblatt muss lösbar sein, und die Antwort muss belegt sein. Nur dann kann das Modell verlangt werden, tatsächlich den Widerspruch in der Szene zu erkennen.
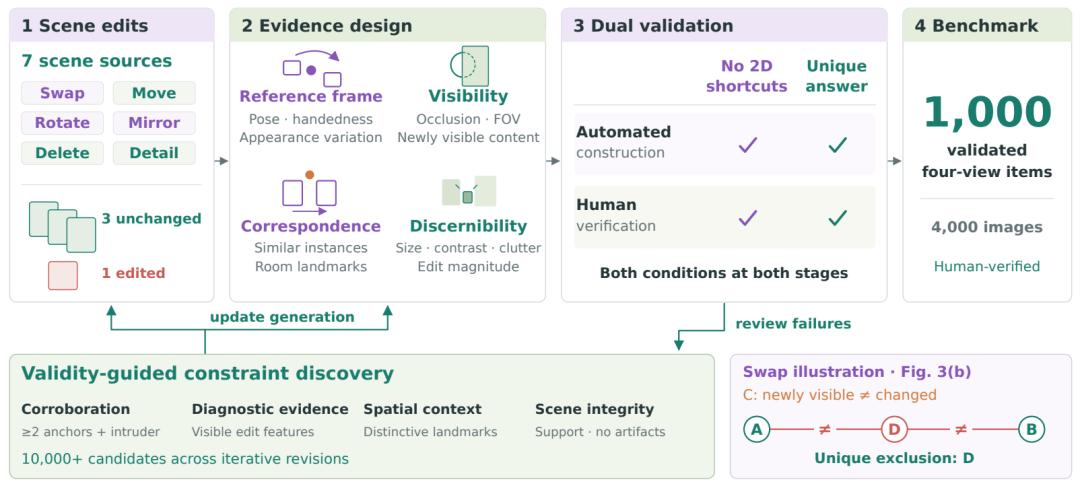
Abbildung 3|SSoN gewährleistet Belege der Fragen und eindeutige Antworten durch automatische Prüfung und manuelle Überprüfung jeder Frage und schließt visuelle Abkürzungen aus. Die Bewertung der Erklärungen deckt zusätzlich alle richtigen Auswahl ab, und das endgültige Label wird manuell festgelegt.
Hinweise, Rekonstruktion, Kameraparameter – welche Hilfe kann die Situation retten?
Da die Schwierigkeit im perspektivenübergreifenden Schlussfolgern liegt, wird sich die Leistung verbessern, wenn man dem Modell mehr Lösungsmethoden beibringt oder es tatsächlich eine dreidimensionale Szene rekonstruieren lässt?
Die Forscher wählten zusätzlich 100 Fragen aus, um einen Interventionssatz zu bilden, dessen ursprüngliche Antwortgenauigkeit 24 % und True solve 12 % beträgt. Alle nachfolgenden Vergleiche werden innerhalb dieses festen Fragensatzes durchgeführt.
Zuerst zu den Hinweisen. Die Forscher leiten das Modell an, Umgebungsreferenzen zu suchen, Objekte abzugleichen, Verdeckungen zu beurteilen oder zuerst das Layout der Szene zu beschreiben; sie teilen ihm auch direkt die sechs möglichen Bearbeitungstypen mit, ohne den Typ der aktuellen Frage preiszugeben. Wenn vergleichende Anleitung und Wissen über Bearbeitungstypen kombiniert werden, erreicht die Genauigkeit 48 % und True solve 34 %. Hinweise können helfen, lassen das Modell aber immer noch nicht die Hälfte der Fragen richtig beantworten.
Was passiert, wenn das Modell tatsächlich die dreidimensionale Rekonstruktion durchführt und dann die Kameraperspektive überprüft? Dieser vollständige, durch Ausführungsprüfung abgesicherte Ablauf ergibt eine Genauigkeit von 47 % und einen True solve-Wert von 34 %. Die Typen Löschung und Detailänderung zeigen gute Leistungen, Verschiebung und Rotation sind immer noch schwierig. Die bloße Hinzufügung der dreidimensionalen Rekonstruktion zum Lösungsprozess reicht nicht aus, um die Mängel im geometrischen Urteil