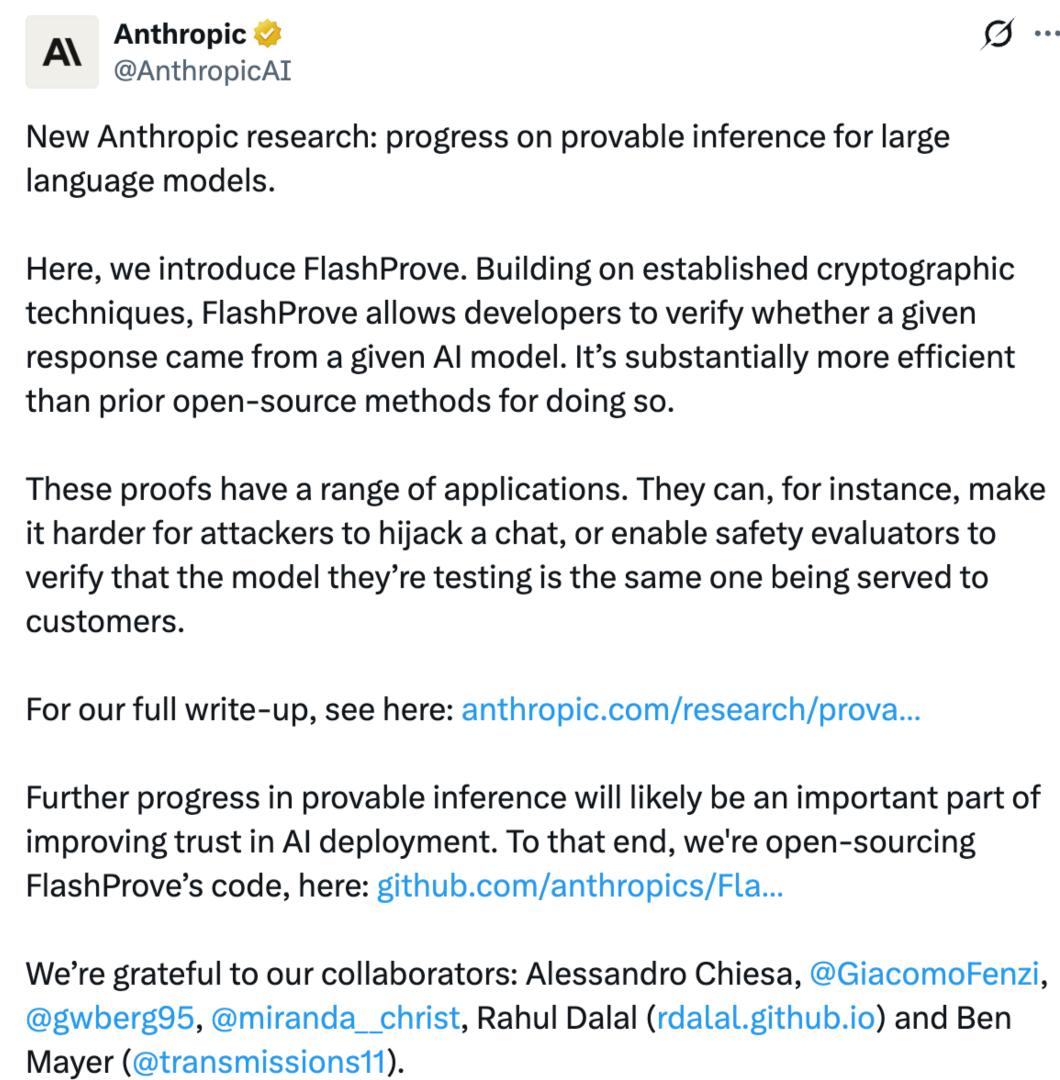
Gerade hat Anthropic FlashProve quelloffen veröffentlicht und für große Sprachmodelle einen "Fälschungsschutz-Identitätsausweis" ausgestellt.
Gerade hat Anthropic in einem Beitrag erklärt, dass „neue Fortschritte bei der überprüfbaren Schlussfolgerung großer Sprachmodelle erzielt wurden“, und hat ein System namens FlashProve quelloffen gestellt. Es basiert auf der kryptographischen Beweistechnik der Null-Wissen-Beweise, die es Modellanbietern ermöglicht, zu beweisen, dass eine bestimmte Antwort tatsächlich von dem angegebenen Modell generiert wurde, ohne die Modellgewichte öffentlich zu machen.
Was bedeutet das?
Ist die KI, für die Sie normalerweise bezahlen, wirklich das Modell, das der Dienstleister verspricht? Angenommen, ein Unternehmen kauft API-Dienste für ein Top-Großmodell, und der Dienstleister verspricht, das leistungsstärkste Modell zu verwenden, ersetzt es aber im Hintergrund heimlich durch ein kleines Modell mit niedrigeren Kosten – kann der Nutzer das erkennen?
Oder anders ausgedrückt: Eine Drittanbieter-Modell-Routing-Plattform ersetzt bei der Weiterleitung von Anfragen heimlich das ursprünglich angegebene Modell. Auch wenn die Qualität der endgültig zurückgegebenen Antwort gut ist, welche Möglichkeit hat der Nutzer, zu beweisen, dass sie tatsächlich von dem von ihm bezahlten Modell stammt?
Derzeit können Nutzer in der Regel nur auf die Versprechen des Dienstleisters vertrauen und es ist schwierig, dies technisch unabhängig zu überprüfen. Die neu veröffentlichte Forschung von Anthropic versucht genau dieses Problem zu lösen.
Noch bemerkenswerter ist, dass diese Technologie bereits an einem Mischexpertenmodell mit insgesamt 400 Milliarden trainierbaren Parametern getestet wurde: Eine einzelne NVIDIA H100 GPU kann etwa 110 Schlussfolgerungsnachweise generieren, die jeweils einem Token entsprechen, und die Nachweisdokumente für eine Anfrage mit 1024 Token haben eine Größe von etwa 19 MB.
In der Vergangenheit konzentrierte sich die Forschung im Bereich des Null-Wissen-Maschinellen Lernens hauptsächlich auf kleinere Modelle, während FlashProve die überprüfbare Schlussfolgerung weiter auf Szenarien großer Sprachmodelle ausweitet.
Derzeit hat Anthropic den Beweiserzeuger von FlashProve, die C++- und Lean-Überprüfer sowie zugehörige technische Dokumentationen und formale Beweise quelloffen gestellt.
- Offizieller Blog: https://www.anthropic.com/research/provable-inference
- GitHub: https://github.com/anthropics/FlashProve
Ein „Identitätsausweis“ für KI-Antworten
Anthropic nennt diese Technologie „beweisbare Schlussfolgerung“ (Provable Inference). Im offiziellen Blog stellt das Team zunächst vier Arten von Vertrauensproblemen vor, mit denen KI-Dienste konfrontiert sind, und versucht, diese Anforderung zu erfüllen: Nutzer senden eine Anfrage an einen KI-Dienst, können aber nicht bestätigen, von welchem Modell die zurückgegebene Antwort tatsächlich stammt.
Beispielsweise können Drittanbieter zur Kostensenkung das vom Nutzer angegebene Hochleistungsmodell durch ein günstigeres Modell ersetzen; zudem können Schlussfolgerungsserver angegriffen werden, was zu Manipulationen an Modellgewichten oder Ausgabetoken führt. Für Forscher, die Sicherheitsbewertungen durchführen, verliert das Bewertungsergebnis seine Zuverlässigkeit, wenn sie nicht bestätigen können, dass das Testobjekt mit dem tatsächlich bereitgestellten Modell übereinstimmt.
Der Kerngedanke dieser Technologie besteht darin, dass der Modellanbieter zunächst auf kryptographische Weise eine Verpflichtung (Commitment) für eine Gruppe festgelegter Modellgewichte generiert, was dem Erstellen eines verschlüsselten Fingerabdrucks für die Modellversion entspricht. Danach kann der Anbieter bei jeder Anfrage des Nutzers einen Null-Wissen-Beweis (zkSNARK) beifügen, der belegt, dass die Antwort tatsächlich von dem zuvor zugesagten Modell auf der Grundlage der entsprechenden Eingabe generiert wurde.
Auf diese Weise können Nutzer die Identität des Modells anhand der Modellverpflichtung, der Eingabe, der Antwort und der Nachweisdokumente unabhängig überprüfen, ohne die Modellgewichte erhalten oder das Modell selbst neu ausführen zu müssen. Der Beweiserstellungsprozess gibt keine Modellgewichte preis, kann aber bestätigen, ob die Ausgabe von dem angegebenen Modell stammt. Natürlich beweist er nur die Herkunft der Antwort, nicht ob der Inhalt der Antwort korrekt ist.
Modell mit 400 Milliarden Parametern erreicht eine Beweisgeschwindigkeit von 110 Token/s
Um die Machbarkeit des Schemas zu überprüfen, hat Anthropic Meta's Llama 4 Maverick für Tests ausgewählt. Es handelt sich um ein MoE-Modell mit 400 Milliarden Parametern, bei dem für jedes Token tatsächlich etwa 17 Milliarden Parameter aktiviert werden.
Auf einer einzelnen NVIDIA H100 GPU erreicht der Durchsatz der Beweiserstellung von FlashProve etwa 110 Token/s, und jede Nachweisdokument hat eine Größe von etwa 18,78 MB. Die Überprüfungsseite erfordert keine GPU, und die Überprüfung eines Beweises mit einer CPU mit 24 Threads dauert etwa 17 Sekunden. Es ist zu beachten, dass der aktuelle Test ein Anfragefenster von 1024 Token verwendet und jeder Beweis tatsächlich eines der Ausgabetoken darin prüft.
Diese Effizienzsteigerung hängt mit den Optimierungen zusammen, die FlashProve für die MoE-Architektur vorgenommen hat: Die Beweisberechnung konzentriert sich hauptsächlich auf die tatsächlich aktivierten Experten, anstatt jedes Mal alle Parameter des Modells zu verarbeiten. Gleichzeitig verwendet das System einen stapelweisen nachträglichen Beweis, bei dem die Beweise einheitlich nach Abschluss der Schlussfolgerung generiert werden, was den Aufwand durch wiederholte Berechnungen senkt.
Allerdings erfordert die Beweiserstellung immer noch zusätzliche Kosten. Laut den Tests von Anthropic beträgt die GPU-Zeit, die zum Generieren von Beweisen benötigt wird, etwa das 70- bis 95-fache der normalen vLLM-Schlussfolgerung. Darüber hinaus unterstützt das System derzeit hauptsächlich ein Kontextfenster von 1024 Token und wurde für ganzzahlige Modelle und Greedy Decoding validiert, es kann noch nicht alle Modelle und Schlussfolgerungsverfahren direkt abdecken.
Um die Glaubwürdigkeit des Systems weiter zu erhöhen, hat Anthropic zudem die Lean-Sprache für formale Verifikation verwendet, um maschinell überprüfbare Beweise für die zentralen Sicherheitseigenschaften des Protokolls wie Vollständigkeit, Zuverlässigkeit und Null-Wissen-Eigenschaft zu erstellen, und hat den Code, die Protokollbeschreibungen und zugehörigen Beweise unter der Apache 2.0-Lizenz quelloffen gestellt. Die formale Verifikation bedeutet jedoch nicht, dass alle tatsächlich ausgeführten Codes die gleiche Garantie erhalten, zwischen dem schnellen C++-Überprüfer und dem formalen Protokoll ist noch eine weitere Prüfung erforderlich.
Eine Gruppe von Nutzern könnte diesen „Identitätsausweis“ dringend benötigen
Derzeit rufen viele Nutzer Modelle verschiedener Hersteller über Drittanbieter-API-Umsteigestellen oder Modellaggregationsplattformen auf. Solche Dienste senken die Hürde für den Modellaufruf, führen aber auch zu einer Informationsasymmetrie: Nutzer können den Modellnamen auswählen, können aber nicht unbedingt unabhängig bestätigen, welches Modell tatsächlich im Hintergrund ausgeführt wird.
Beispielsweise kann der Dienstleister in einer Aufrufkette mit mehrfacher Weiterleitung theoretisch aus Kostengründen Anfragen, die eigentlich von einem Hochleistungsmodell verarbeitet werden sollen, an ein Modell mit niedrigeren Aufrufkosten weiterleiten. Für Nutzer ist es auch dann, wenn sie eine Veränderung der Antwortqualität feststellen, schwierig zu beurteilen, ob es sich um die inhärente Zufälligkeit des Modells, eine Änderung des Dienststatus oder eine Änderung des tatsächlich aufgerufenen Modells handelt.
Ohne unabhängige Überprüfungsmittel ist es für Nutzer schwierig, allein anhand der zurückgegebenen Ergebnisse zu bestätigen, welches Modell sie tatsächlich aufgerufen haben.
Ein Netznutzer ist der Ansicht, dass normale Nutzer beim Aufrufen von Modellen über Drittanbieter nur schwer bestätigen können, ob die Antwort auf dem Bildschirm tatsächlich von dem beworbenen großen Modell stammt, von dem Dienstleister durch ein kostengünstigeres Modell ersetzt wurde oder sogar von einem Man-in-the-Middle manipuliert wurde.
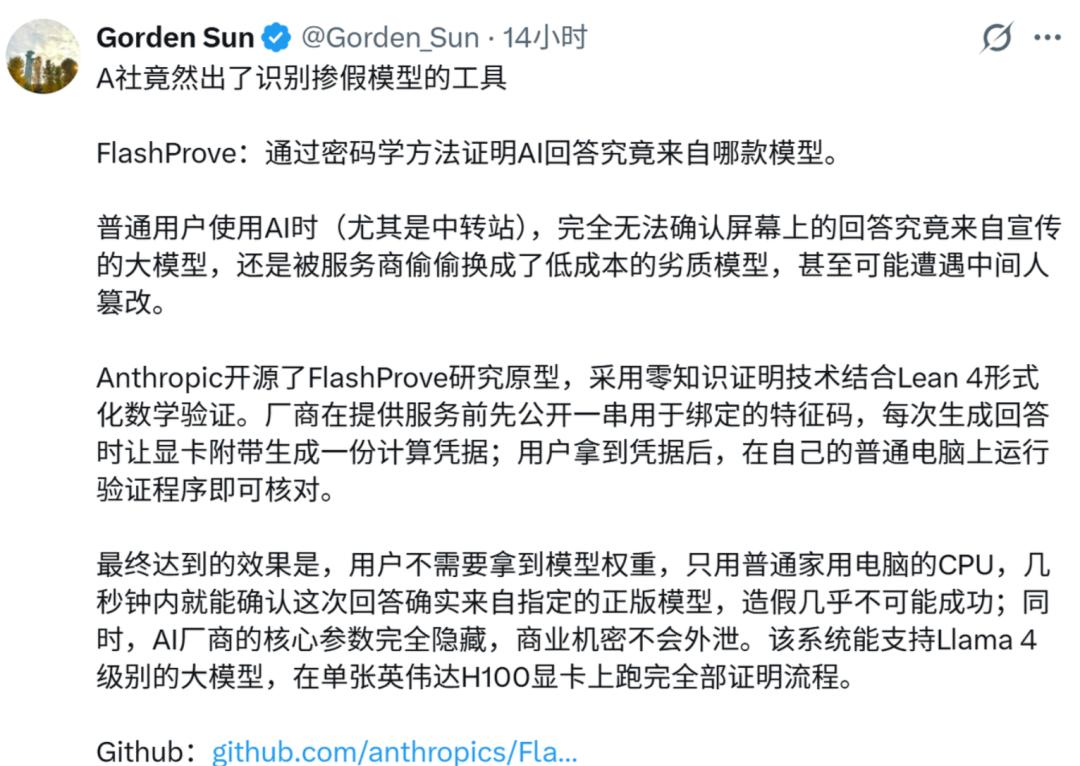
FlashProve bietet einen neuen Prüfansatz. Wenn der Modellanbieter die Gewichtsverpflichtung einer bestimmten Version im Voraus veröffentlicht, kann er bei der Rückgabe der Antwort auch den entsprechenden kryptographischen Beweis bereitstellen. Nutzer müssen sich nicht vollständig auf die mündlichen Versprechen des Dienstleisters verlassen, sondern können durch die Überprüfung des Beweises bestätigen, ob die Anfrage tatsächlich von dem Modell mit den angegebenen Gewichten verarbeitet wurde.
Es besteht noch ein gewisser Abstand zur großflächigen Anwendung
Natürlich zeichnet Anthropic ein vielversprechendes Bild, weist aber gleichzeitig ausdrücklich darauf hin, dass FlashProve derzeit noch ein Forschungsprototyp ist und mehrere technische und theoretische Einschränkungen aufweist.
Erstens sind die Beweiserstellungskosten nach wie vor hoch. Obwohl es um mehrere Größenordnungen schneller ist als Vorgängersysteme, ist die GPU-Zeit, die zum Generieren von Beweisen benötigt wird, immer noch etwa 72 bis 94 Mal höher als bei normaler Schlussfolgerung (vLLM), was bedeutet, dass die Dienstkosten deutlich steigen werden, wenn für jede Anfrage ein Beweis in Echtzeit generiert werden muss.
Zweitens sind die derzeit unterstützten Berechnungsformen begrenzt. Die aktuellen Experimente richten sich an Modelle mit ganzzahliger Arithmetik und Greedy Decoding. Für andere Schlussfolgerungsverfahren wie Gleitkommarechnung und zufälliges Sampling sind weitere Erweiterungen erforderlich.
Darüber hinaus ist die Kontextlänge begrenzt. Die aktuellen Experimente zeigen eine maximale Kontextbeweisgröße von 1024 Token. Für lange Kontexte, groß angelegte Agent-Workflows und komplexe Mehrrunden-Interaktionen ist das Problem der effizienten Generierung und Überprüfung von Beweisen noch zu lösen.
Ein weiterer Punkt, der besonders erläutert werden muss, ist: FlashProve beweist, dass die Antwort tatsächlich von dem angegebenen Modell stammt, es beweist aber nicht, dass die Antwort selbst korrekt ist. Das heißt, wenn das angegebene Modell Halluzinationen erzeugt, kann FlashProve diese Antwort dennoch erfolgreich überprüfen. Es löst Probleme der Modellidentität und der Integrität der Schlussfolgerung, nicht Probleme der Modellfähigkeit und der faktischen Genauigkeit.
Dennoch ist es lobenswert, dass die Open-Source-Bereitstellung von FlashProve neue Möglichkeiten für die vertrauenswürdige Steuerung der gesamten KI-Industriekette bringt. Mit den steigenden Anforderungen an die Bestätigung der Modellidentität durch Compliance-Regulierung, Sicherheit der Modelllieferkette und hochwertige Szenarien (medizinische Diagnose, finanzielle Entscheidungsfindung, Rechtsanalyse) tritt der „unveränderliche Identitätsausweis für Modelle“ aus dem rein akademischen Konzept in die Phase der praktischen technischen Umsetzung ein.
In Zukunft liefern Modellanbieter den Nutzern möglicherweise nicht mehr nur Antworten und Token, sondern zusätzlich ein kryptographisches Zertifikat, das beweist, dass „dies tatsächlich von dem von Ihnen angegebenen Modell generiert wurde“.
Referenzlinks:
https://x.com/AnthropicAI/status/2117710942826123294
https://www.anthropic.com/research/provable-inference
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „Machine Heart“ (ID: almosthuman2014), Autor: Machine Heart, das sich auf KI konzentriert, und wird von 36Kr mit Genehmigung veröffentlicht.