GPT-6 Astra modifiziert das Qwen-Gehirn radikal: Mit nur 0,016 % angepassten Parametern schießen die Mathematikleistungen sprunghaft nach oben
Mit einer Änderung von nur 0,016 % der Gewichte ist die Mathematikleistung eines großen Modells mit 800 Millionen Parametern von 7,9 % auf 48,1 % gestiegen.
Noch erstaunlicher ist, dass diejenige, die diese Gewichte manuell modifiziert hat, ausgerechnet ein anderes großes Modell namens GPT-6 Astra ist.
Kürzlich hat das Forschungsteam von MIT CSAIL eine recht kühne Methode zur KI-Optimierung vorgestellt. Sie ließen GPT-6 Astra die Gewichte neuronaler Netze direkt analysieren, Probleme des Modells lokalisieren und dann die Parameter ändern, so wie ein Programmierer Code liest und modifiziert.
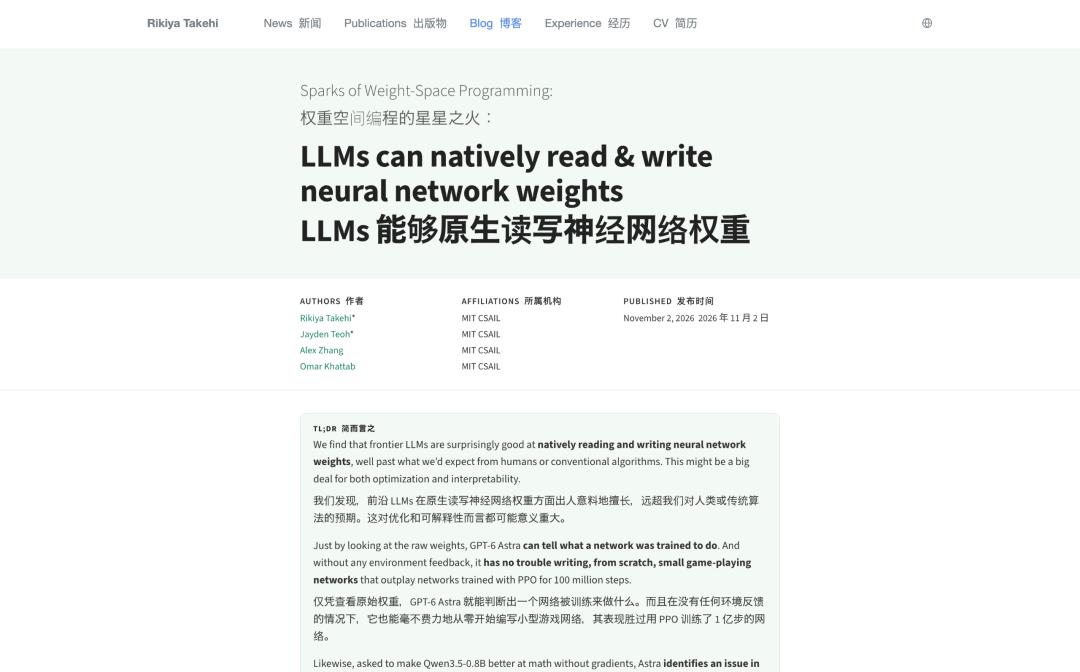
Abbildung | Adresse des Forschungsblogs: https://rikiyat.github.io/blog/weight-space-programming/
Während des gesamten Prozesses wurde kein herkömmliches Gradiententraining verwendet. Die Forscher modifizierten nur 131072 Parameter von Qwen3.5-0.8B, wodurch seine Leistung auf MATH-500 von 7,9 % auf 48,1 % gesteigert wurde, auf GSM8K von 13,8 % auf 67,1 %, und die Fähigkeit zur Einhaltung von Anweisungen verbesserte sich ebenfalls deutlich.
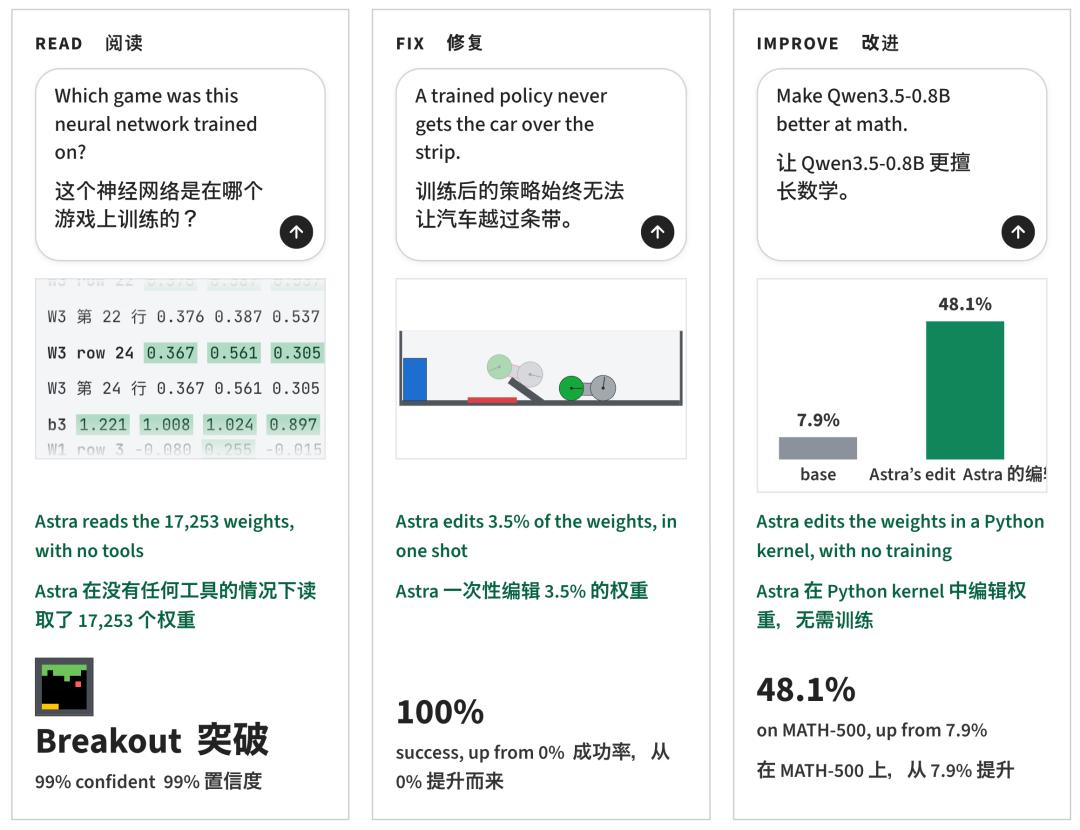
Diese Forschung wird als „Gewichtsraum-Programmierung“ (Weight-Space Programming) bezeichnet.
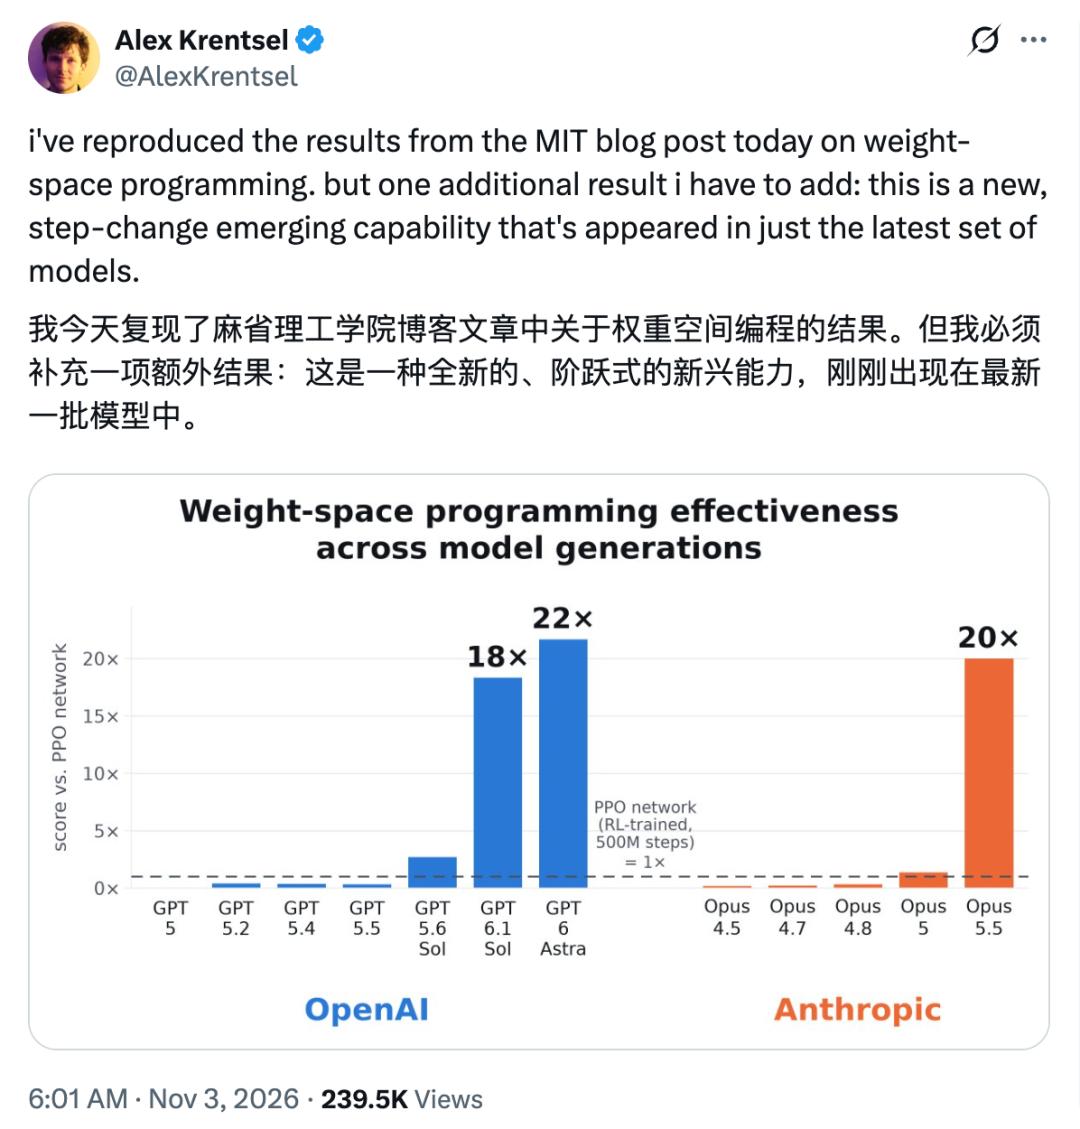
Nachdem die Nachricht verbreitet wurde, glauben einige, dass dies eine „stufenweise Fähigkeit“ ist, die gerade erst in der neuesten Generation von Modellen aufgetaucht ist. Wenn große Modelle die Gewichte eines anderen Modells direkt lesen und schreiben können, ist es in Zukunft für KI, die KI optimiert, möglicherweise nicht einmal mehr nötig, neu zu trainieren.
Dies ist eine völlig neue, stufenweise aufstrebende Fähigkeit, die gerade erst in der neuesten Gruppe von Modellen erschienen ist.
Aber es tauchten schnell auch Zweifel auf. Einige wiesen darauf hin, dass Qwen ursprünglich ein schwerwiegendes Problem mit wiederholtem Schließen hatte. Der starke Anstieg der Mathematikleistung könnte nur darauf zurückzuführen sein, dass Astra diesen Fehler behoben hat, was nicht bedeutet, dass ein Modell aus dem Nichts neue mathematische Fähigkeiten erworben hat.
Was hat GPT-6 Astra eigentlich mit diesem Modell gemacht, um die Leistung von 7,9 % auf 48,1 % zu bringen?
Vom Schreiben von Code zur direkten Modifikation von Modellgewichten
Im Allgemeinen können wir, wenn wir wollen, dass KI bessere Antworten generiert, normalerweise nur die eingegebenen Prompt-Wörter ändern. Und wenn Entwickler die Ausgabe des Modells ändern möchten, können sie es mit Daten feinabstimmen.
Die Gewichtsraum-Programmierung versucht dagegen, die Gewichte des trainierten Modells direkt zu modifizieren, also die Zahlen, die bei der Berechnung des neuronalen Netzes verwendet werden, direkt zu ändern.
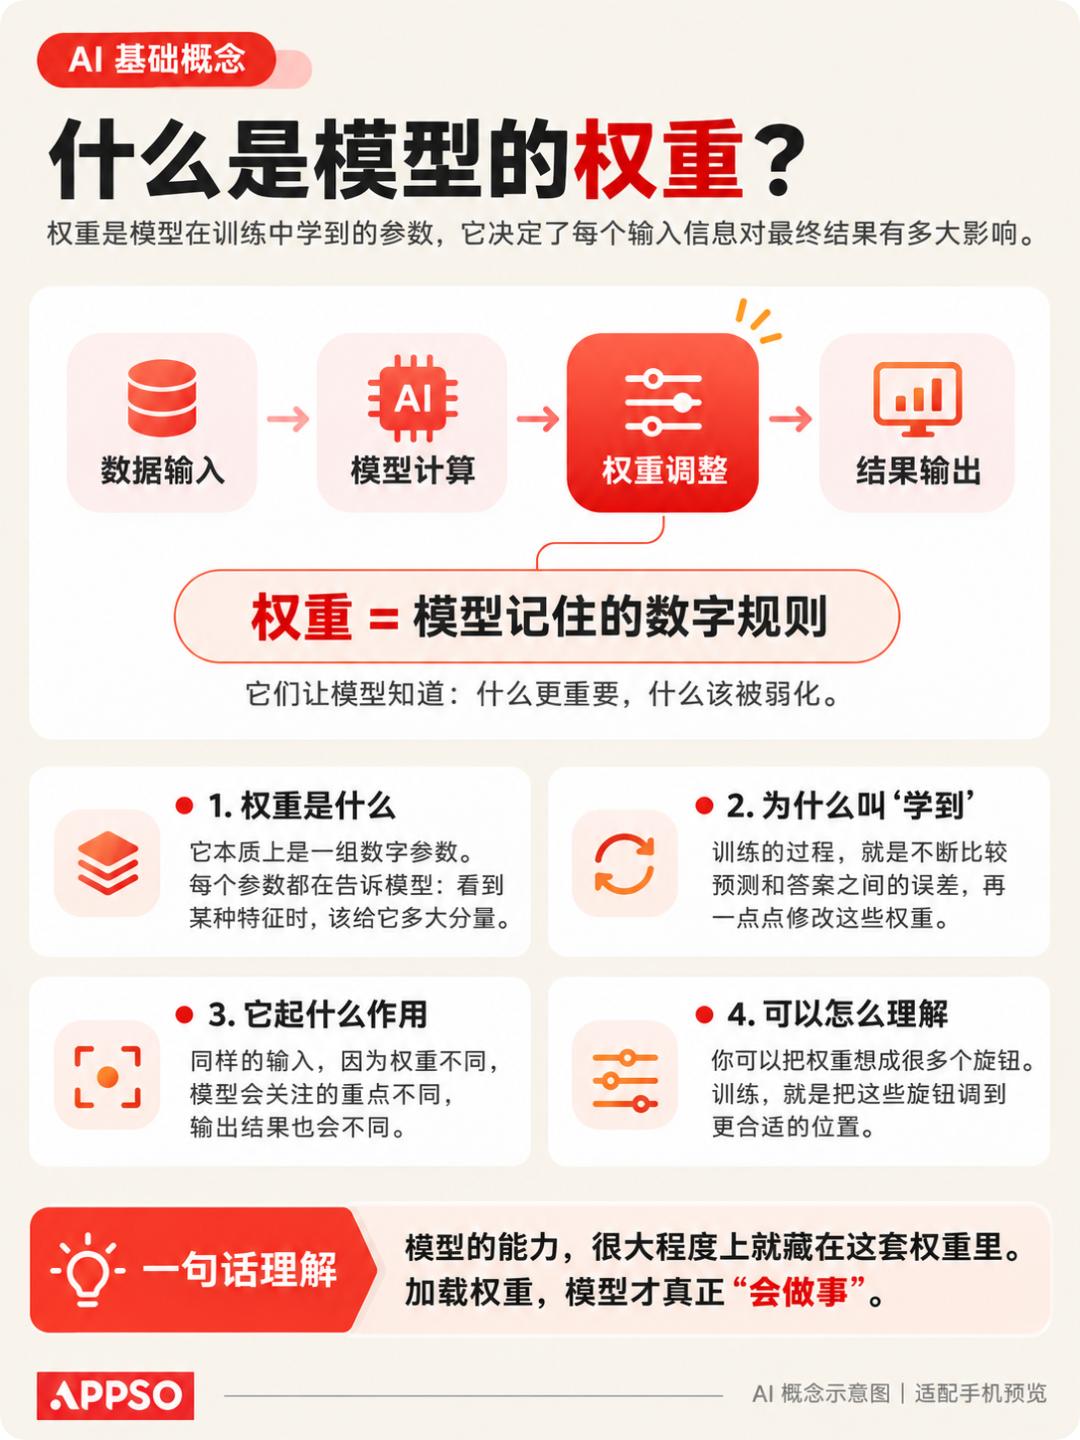
Die sogenannten Gewichte können wir als eine große Anzahl einstellbarer Knöpfe im neuronalen Netzmodell verstehen, jeder Knopf ist ein Zahlenwert. Unterschiedliche Werte bestimmen, ob die Daten bei der Übertragung im Netzwerk verstärkt, geschwächt oder auf andere Weise an der Berechnung teilnehmen.
Und das Modelltraining, von dem wir oft hören, besteht zu einem großen Teil darin, diese Knöpfe ständig anhand massiver Daten anzupassen, damit es allmählich lernt, korrekte Ausgaben aus Eingaben zu erzeugen.
Nach Abschluss des Trainings sind das Wissen, die Gewohnheiten und die Verhaltensneigungen des Modells auf komplexe Weise in diesen Zahlen kodiert; ein Modell kann Millionen, Milliarden oder noch mehr Gewichte haben.
Nach allgemeiner Auffassung ist der Teil, an dem große Sprachmodelle an der Modelliteration teilnehmen können, auf das Schreiben von Trainingscode, das Anpassen von Hyperparametern, das Optimieren von Prompts und sogar das Entwerfen vollständiger Trainingsabläufe beschränkt. Bei all diesen Arbeiten werden die Gewichte von Modellen mit Hunderten Milliarden oder Billionen von großen Parametern selbst jedoch weiterhin hauptsächlich von Optimierungsalgorithmen aktualisiert.
Jetzt beginnt sich das Objekt der Optimierung großer Modelle von „Wie man ein Modell trainiert“ zu „Aus welchen Zahlen das Modell selbst besteht“ zu verlagern. Die Gewichtsraum-Programmierung ermöglicht es großen allgemeinen Sprachmodellen, die Gewichte neuronaler Netze direkt nach Zielen in natürlicher Sprache zu lesen und zu modifizieren; in einigen Experimenten benötigt das Modell nicht einmal Rückmeldungen aus der Umgebung.
Nach dem Lesen der Gewichte beginnt die KI, selbst Gewichte zu schreiben
Um die Plausibilität dieses Durchbruchs zu beweisen, testete das Forschungsteam zunächst, ob große Modelle nur anhand der Gewichte verstehen können, was ein neuronales Netz gelernt hat.
In dem Experiment konnte GPT-6 Astra anhand der ursprünglichen Gewichte des Modells schlussfolgern, welche kleinen Netze mit identischer Struktur jeweils für welches Spiel optimierte Modelle sind, und anhand der Gewichte beurteilen, ob das Diffusionsmodell Kreise, Quadrate oder Dreiecke generiert.
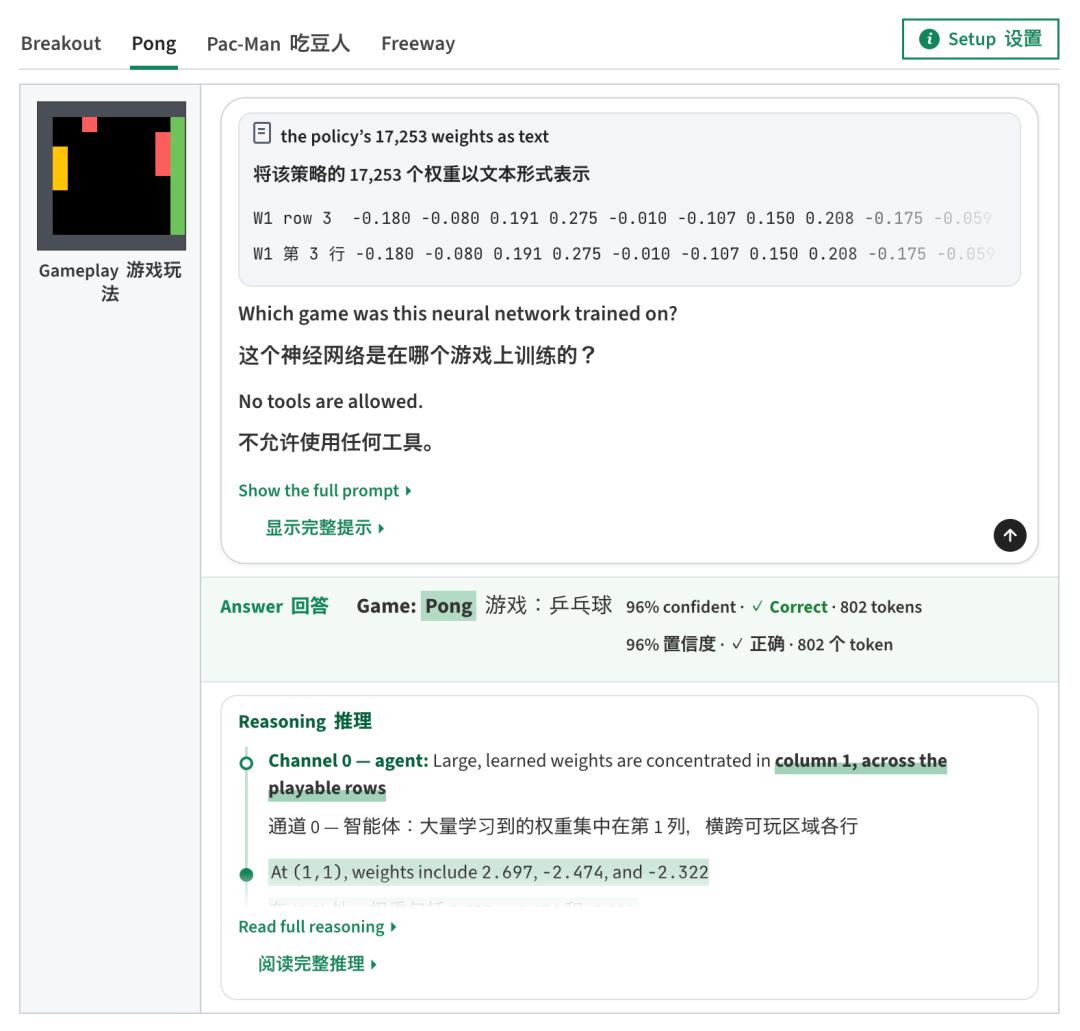
Bei mehreren kleinen Sprachmodellen konnte es auch nur anhand der Gewichte der Zwischenschicht beurteilen, ob das Trainingskorpus zu Python, Englisch oder japanischer Romanisierung gehört, und die Aufmerksamkeitsköpfe finden, die für das Kopieren vorheriger Inhalte verantwortlich sind.
Nachdem bewiesen wurde, dass große Modelle Gewichte lesen können, testete das Forschungsteam weiter, ob sie „schreiben“ können, also Gewichte modifizieren.
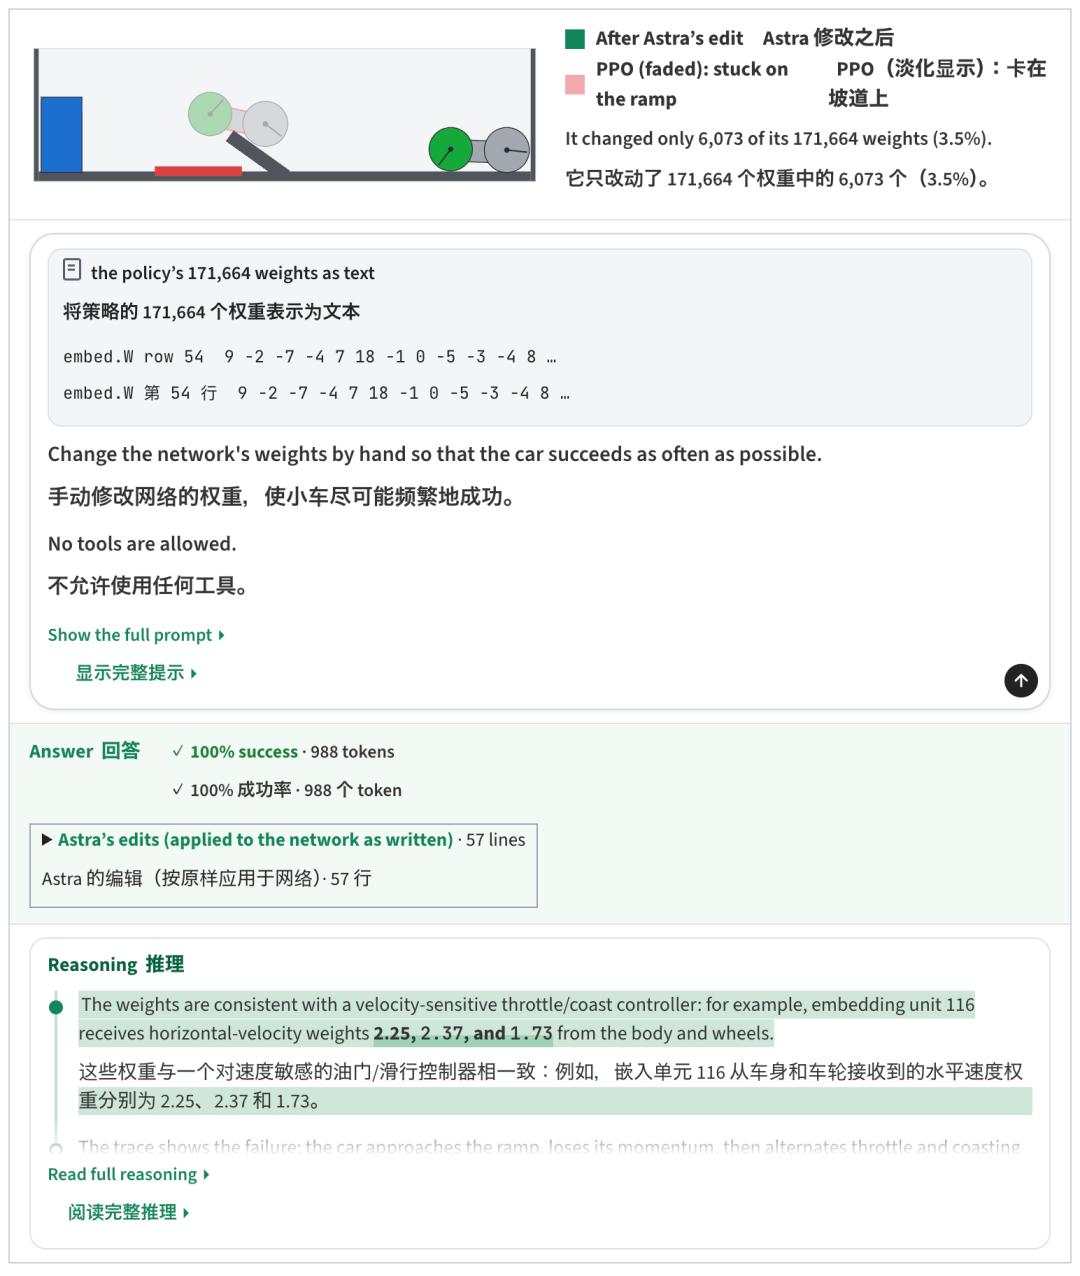
Das Forschungsteam trainierte ein Steuernetz für kleine Fahrzeuge mit dem Verstärkungsalgorithmus PPO und lief etwa 1 Milliarde Schritte. Das Ergebnis war, dass das kleine Fahrzeug direkt den Hang hinauffuhr, aber dort steckenblieb; bei 256 Prüfrunden gelang es kein einziges Mal.
Astra erhielt die Erläuterungen zu den Netzgewichten, der Szene, den Ein- und Ausgaben sowie die Aufzeichnung eines fehlgeschlagenen Prozesses. Es reichte in einer Antwort einen Parameter-Patch ein, modifizierte nur 3,5 % der Gewichte und fügte dem Netzwerk den Steuerpfad hinzu „zuerst zurückfahren, um Kraft zu sammeln, dann mit voller Geschwindigkeit vorwärts“, wodurch die Erfolgsrate von 0 auf 100 % gesteigert wurde.
In einer weiteren Gruppe von Experimenten generierte Astra die Gewichte des Spielnetzwerks von Grund auf anhand der Spielregeln und der Netzwerkstruktur. Diese Netze, die kein Training durchlaufen haben, übertrafen in drei MinAtar-Spielen alle PPO-Netze, die 100 Millionen Schritte trainiert wurden. Bei der 9×9-Go-Aufgabe übertraf das generierte Netz nach begrenzten Vorwärtstests und Modifikationen auch das PPO-Netz gleicher Größe, das 20 Millionen Runden trainiert wurde.
Diese Ergebnisse deuten auf eine phantasievolle Möglichkeit hin: Große Modelle könnten die Regeln und Strategien in natürlicher Sprache direkt in neuronale Netze „kompilieren“.
Änderung von nur 0,016 % der Parameter, Mathematikleistung stieg um 40 Prozentpunkte
Was diese Forschung wirklich bekannt gemacht hat, ist die Modifikation von Qwen3.5-0.8B.
Die kleinen Modelle für die vorherigen kleinen Spiele konnten die Gewichte alle in Text umwandeln und dann an GPT-6 Astra zur Verarbeitung übergeben, aber ein Modell mit 800 Millionen Parametern lässt sich nicht direkt in den Kontext einfügen. Die Forscher gaben Astra eine Python-Umgebung, die Gewichte lesen und modifizieren kann, sowie Übungsaufgaben und Antworten aus den Trainingssätzen von GSM8K und MATH, mit der Anforderung, dieses kleine Modell besser in Mathematik zu machen.
Es kann die Gewichte mithilfe von Python analysieren, das Modell über spezielle Tools testen und auch die verborgenen Zustände, Neuronaktivierungen und Aufmerksamkeitsinformationen während des Modellbetriebs einsehen, darf jedoch keine Gradienteninformationen verwenden oder Training durchführen.
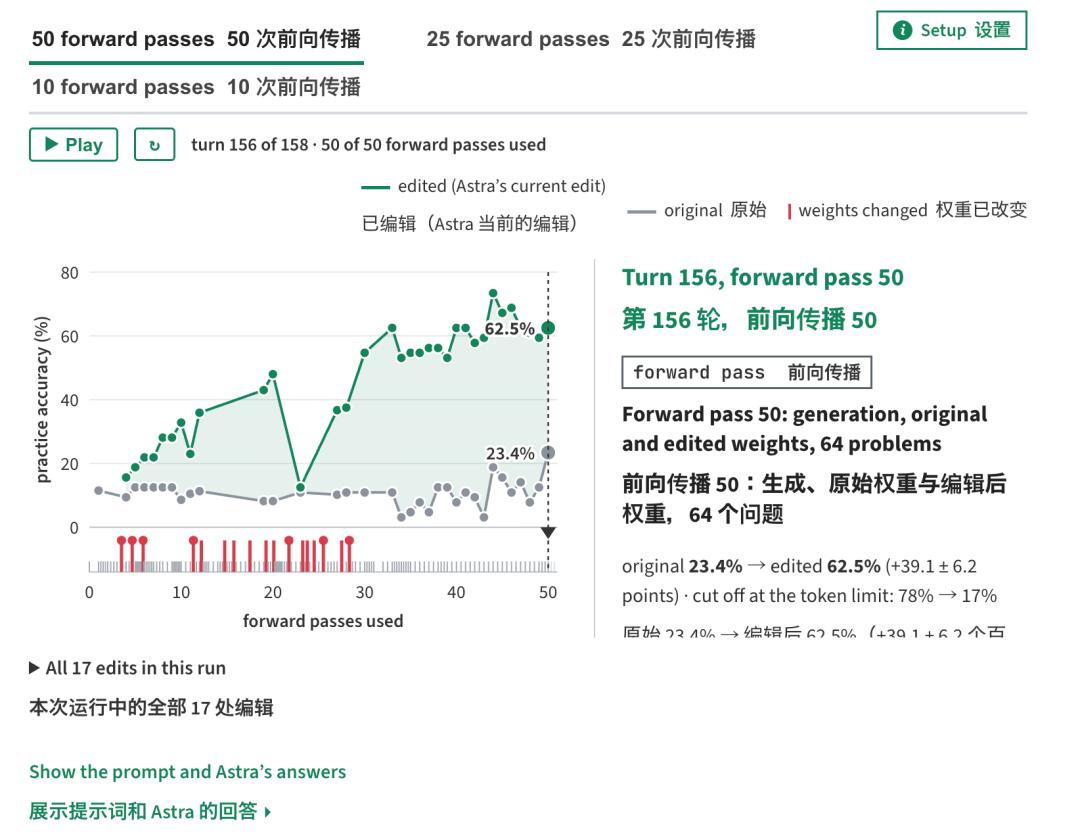
Astra stellte schließlich fest, dass eine große Anzahl von Antworten des Modells in wiederholtes Schließen geriet. Unter den 96 ursprünglich geprüften Übungsantworten generierten 85 davon bis zur Obergrenze von 32768 Tokens und lieferten immer noch keine endgültige Antwort. GPT-6 Astra lokalisierte dieses Problem in einer bestimmten Richtung, die von einigen MLP-Schichten erzeugt wurde, und unterdrückte die Schleife, indem es diese Richtung löschte.
In der Einstellung mit 50 erlaubten Vorwärtstests verbesserte das modifizierte Modell nicht nur die Mathematikleistung: MATH-500 stieg von 7,9 % auf 48,1 %, GSM8K von 13,8 % auf 67,1 %.
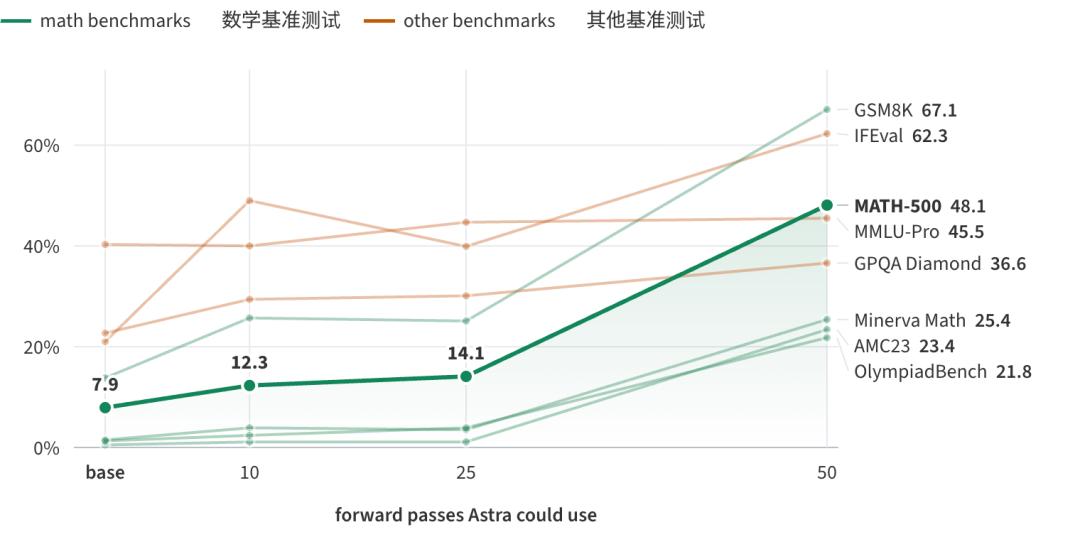
Sogar die Leistung bei der Einhaltung von Anweisungen nach IFEval stieg von 21,0 % auf 62,3 %; der Anteil der Antworten, die auf MATH-500 die Token-Obergrenze erreichten, sank von 93,0 % auf 33,1 %. Die gesamte Modifikation betraf nur 131072 Parameter.
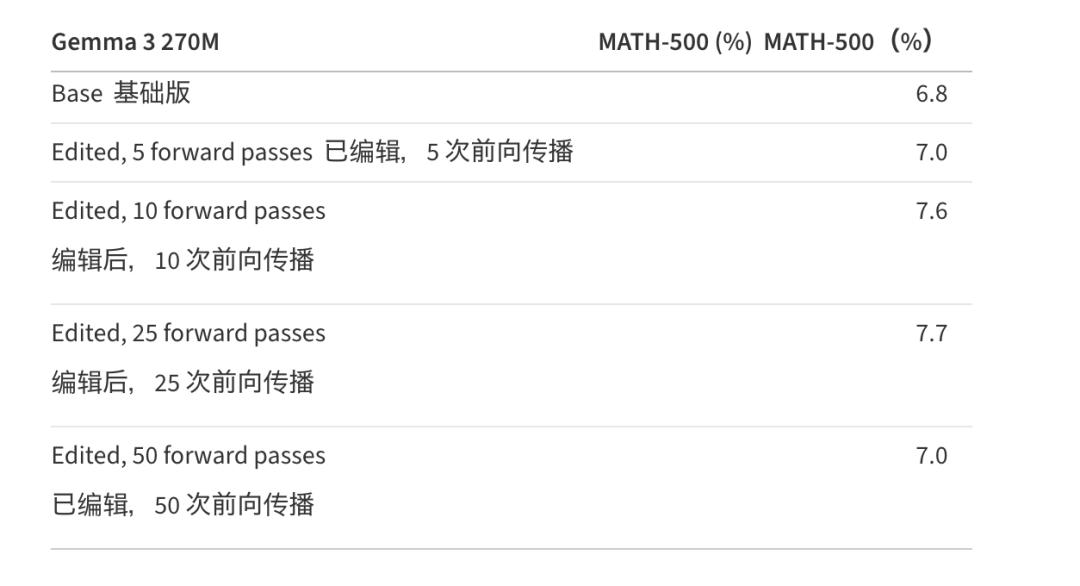
Das Forschungsteam führte jedoch auch entsprechende ergänzende Experimente durch. Bei Gemma 3 270M, das selten Schließschleifen aufweist, brachte die Modifikation von Astra keine eindeutige Verbesserung. Seine Basisleistung auf MATH-500 betrug 6,8 %, die Version nach 50 Vorwärtstests erreichte 7,0 %.
Am Ende des Forschungsblogs wird erwähnt, dass Astra hauptsächlich Hindernisse beseitigt hat, die das Modell daran gehindert haben, Antworten abzuschließen, statt dem Modell neues mathematisches Wissen einzufügen. Es ist kaum möglich, Fähigkeiten hinzuzufügen, die das Modell ursprünglich nicht hatte.
Starke Leistungssteigerung oder nur Behebung eines Fehlers?
Auf X fassen viele Diskussionen diese Forschung als „KI direkt reparieren lassen durch KI“ zusammen. Wenn diese Methode zuverlässig genug ist, müssen Entwickler in Zukunft möglicherweise nicht für jeden Modellfehler neu Daten sammeln und feinabstimmen, sondern nur das stärkere Modell die Gewichte prüfen, Fehler finden und lokal reparieren lassen.
Einige Nutzer posteten, dass sie die Ergebnisse im Blog bereits reproduziert haben und dies für eine „stufenweise Fähigkeit“ halten, die gerade erst in der neuesten Generation von Modellen aufgetaucht ist.
Andere Nutzer sagten, dass ihr Team ähnliche Experimente durchgeführt hat und festgestellt hat, dass das Claude-Modell auch vollständige, lauffähige Gewichte neuronaler Netze von Grund auf schreiben kann.
