36Kr Exklusive Erstveröffentlichung | Ein Associate Professor der Shanghai Jiao Tong University entwickelt optische Rechenchips, hat innerhalb von einem halben Jahr nach der Gründung des Unternehmens fünf aufeinanderfolgende Finanzierungsrunden von Yunqi Partners, Atomic Venture Partners und anderen Investoren erhalten, und die Chips wurden bereits zum Tape-out geschickt.
Bildquelle / Unternehmen
Dieser Text ist ca. 3300 Wörter lang, die empfohlene Lesezeit beträgt 8 Minuten
Autorinnen丨Ou Xue
Redaktion丨Yuan Silai
Hard Krypton erfuhr, dass das optische Rechenchip-Unternehmen Zhizi Guangyuan eine Seed-Finanzierungsrunde im Wert von mehreren hundert Millionen Yuan abgeschlossen hat. Seit seiner Gründung hat das Unternehmen fünf aufeinanderfolgende Seed-Finanzierungsrunden abgeschlossen, zu den Investoren gehören Haitong International Innovation Center, Yunqi Capital, Cathay Pacific Haitong, Xianfeng Changqing, Atom Venture Capital, Tongxin Capital und der KI-Zukunftsfonds der Shanghai Jiao Tong University. Die Mittel werden hauptsächlich für die Forschung und Entwicklung von Kernchips und die Iteration der Tape-Outs, die Einstellung hochqualifizierter Talente und den Aufbau des Teams sowie die Erweiterung von Anwendungszenarien und ökologische Partnerschaften verwendet.
Zhizi Guangyuan wurde im Mai 2026 gegründet und konzentriert sich auf die Forschung und Entwicklung rekonstruierbarer volloptischer Rechenarchitekturen und photonischer Prozessoren. Es nutzt die parallelen Recheneigenschaften des Lichts, um direkt an KI-Berechnungen teilzunehmen, um die Engpässe traditioneller elektronischer Chips bei der Miniaturisierung von Herstellungsverfahren, dem Stromverbrauch und der Wärmeabfuhr zu umgehen, und treibt die optische Berechnung von der spezialisierten Beschleunigung zu einer universelleren Rechenplattform voran.
Derzeit hat Zhizi Guangyuan ein Forschungs- und Entwicklungsteam von fast 50 Personen aufgebaut. Die Kernmitglieder arbeiten seit langem auf dem Gebiet der optischen Berechnung und des Chipdesigns, haben gemeinsam Dutzende von optischen Chips entworfen, getestet und validiert und fast 20 Arbeiten in Serienzeitschriften von Nature/Science veröffentlicht. Gründer Cheng Yuan ist außerordentlicher Professor an der Fakultät für Künstliche Intelligenz der Shanghai Jiao Tong University, beschäftigt sich seit langem mit der Forschung an photonischen Chips und Edge-Intelligenz, war ehemaliger Mitbegründer/CTO von Xinmir Technology und leitete den Aufbau des Full-Stack-Produktsystems.
Auf Produktebene plant Zhizi Guangyuan zwei Produktlinien: photische Beschleunigungskarten für Serverseite und optische Rechenchips für die Endgeräteseite. Die ersten Versionen der zugehörigen Chips beider Produkte wurden bereits zum Tape-Out geschickt, und es ist geplant, innerhalb der nächsten sechs Monate nacheinander einsetzbare Produkte auf den Markt zu bringen.
Derzeit wandelt sich der Wettbewerb um KI-Rechenleistung von der bloßen Verfolgung von Spitzen-Rechenleistung hin zur Frage, wie viel gültige intelligente Ausgabe pro Kilowattstunde Strom unterstützt werden kann. Da sich KI von einzelnen Frage-Antwort-Interaktionen zu fortlaufendem Denken von Agenten, Tool-Aufrufen und Aufgabenausführung entwickelt, steigt der Token-Verbrauch schnell, Kosten, Stromversorgung und Wärmeabfuhr werden zu realen Einschränkungen für die Erweiterung der Rechenleistung.
Traditionelle elektronische Chips nähern sich bereits der Obergrenze des Mooreschen Gesetzes, es ist schwierig, mit dem Nachfragewachstum nur durch Miniaturisierung von Herstellungsverfahren Schritt zu halten. Der Ansatz der optischen Berechnung besteht darin, Matrixoperationen auf Interferenz- und Beugungsprozesse des Lichts abzubilden und eine große Anzahl paralleler Multiplikations-Additions-Operationen direkt durch die Ausbreitung des Lichts durchzuführen.
Cheng Yuan erklärte, dass die KI tatsächlich Rechenträger mit sehr niedrigem Stromverbrauch, die nicht auf fortschrittliche Herstellungsverfahren angewiesen sind und die technisch umsetzbar sind, benötigt, und die optische Berechnung hat natürliche Vorteile bei Parallelität, Latenz und Energieeffizienz.
Derzeit befindet sich die Branche für optische Berechnung in der frühen Phase der technischen Umsetzung, in China laufen mehrere technische Routen parallel, es gibt nur wenige verfügbare Produkte auf dem Markt, die meisten davon sind kleine spezialisierte Berechnungen, die große reale Aufgaben kaum unterstützen können und auch schwer zwischen verschiedenen Aufgaben wechseln können.
„Universelle optische Berechnung ist der Branchentrend, er erfordert jedoch die gemeinsame Förderung von Architektur, Bauelementen, Verfahren, Verpackung und Test sowie Softwaresystemen“, sagte Cheng Yuan.
Genauer gesagt ist die technische Route von Zhizi Guangyuan eine rekonstruierbare volloptische Rechenarchitektur. Durch raumzeitliche Rekonstruktion wird eine flexible Anpassung an verschiedene Modelle und Rechenaufgaben erreicht; die technischen Vorteile von Interferenzberechnung und Beugungsberechnung werden kombiniert, mit Hilfe von Chiplet werden Interferenz und Beugung modular in dieselbe Architektur integriert, mehrere optische Rechenkerne auf einem einzelnen Chip kaskadiert, um den Rechenumfang zu erweitern und gleichzeitig Rechengenauigkeit und Flexibilität zu berücksichtigen. Darüber hinaus treibt das Unternehmen gleichzeitig die Technologien „optische Übertragung und optische Berechnung“ sowie volloptische Nichtlinearität voran, um die fotoelektrische Umwandlung in wichtigen Rechenschritten zu reduzieren und durch Software-Hardware-kollaborative Kalibrierung die Rechengenauigkeit und die Chipkonsistenz zu verbessern.
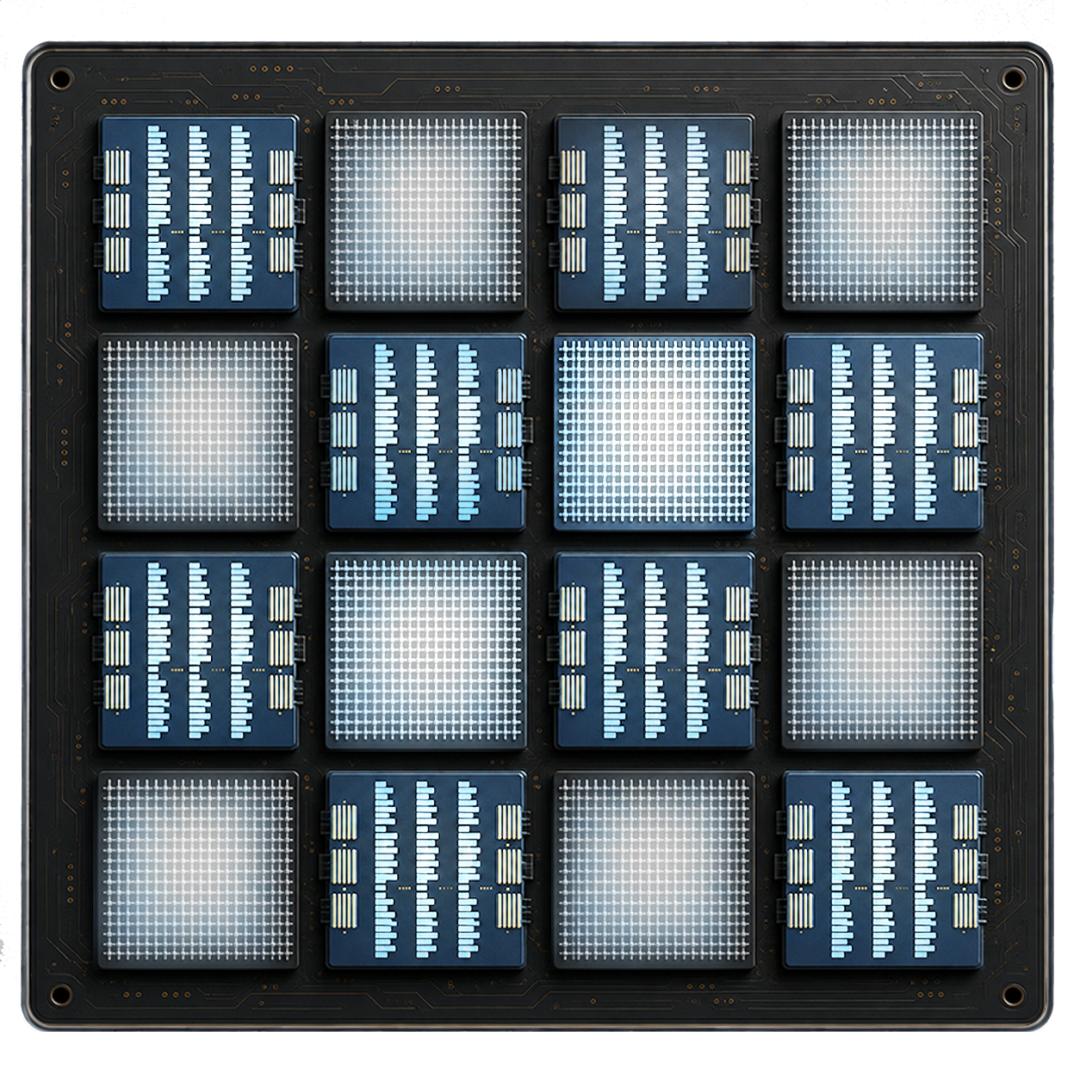
Rekonstruierbar: Interferenz x Beugung x Chiplet (Bildquelle / Unternehmen)
„Rekonstruierbarkeit“ bestimmt, wie viele Aufgaben die optische Berechnung anpassen kann. Zhizi Guangyuan entwirft von der untersten Chipebene aus eine raumzeitliche Rekonstruktionsarchitektur, um Rechenbeziehungen in Raum und Zeit zu modulieren. Wenn sich die Aufgaben ändern, passt es sich durch Neukonfiguration des Lichtwegs oder Anpassung der Planungsalgorithmen an, ohne dass für jede Anwendung ein neuer Chip entworfen werden muss. „Volloptisch“ zielt auf Energieeffizienz ab: Lassen Sie Kommunikationslicht direkt an der Berechnung teilnehmen und behalten Sie wichtige nichtlineare Operationen im optischen Bereich, sodass die fotoelektrische Umwandlung in der Rechenkette gegen Null geht.
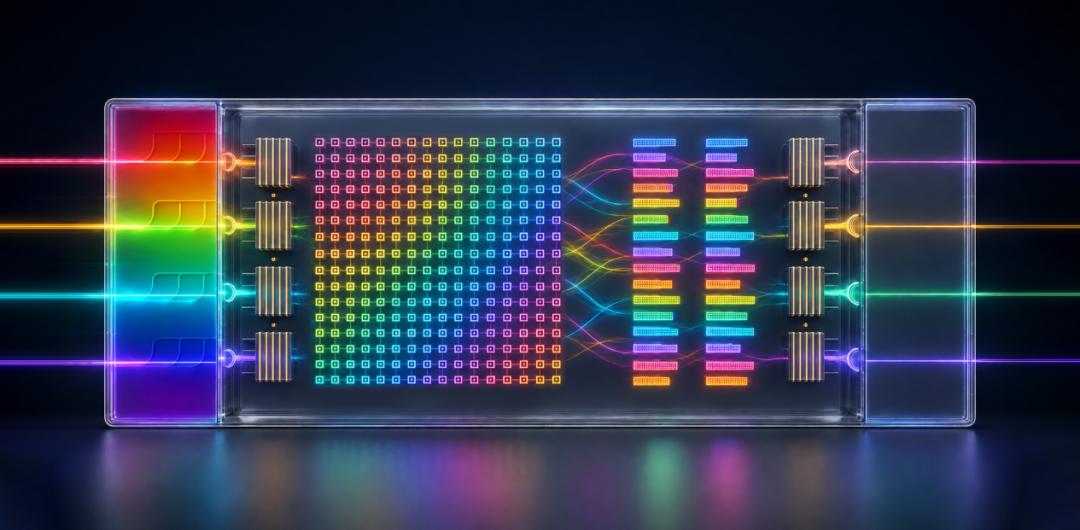
Volloptisch: optische Übertragung und optische Berechnung x Nichtlinearität (Bildquelle / Unternehmen)
Auf Produktebene zielt Zhuolong OPU-08 auf die Beschleunigung von Serverberechnungen ab, nimmt die Form einer PCIe-photoelektrischen Beschleunigungskarte an und konzentriert sich auf groß angelegte Matrixoperationen bei KI-Inferenz. Es hat die Spezifikationen von 256×256 Rechenkernen und 150 TOPS Rechenleistung, kann an vorhandene Server angeschlossen werden und bietet „photonische Token“ für die Cloud-Bereitstellung großer Modelle. Xuanjian TOCU-07 zielt auf niedrigenergieintelligente Geräte auf der Edge-Seite ab, hat die Spezifikationen von 128×128 Rechenkernen und 100 TOPS Rechenleistung. Neben der photoelektrischen Berechnung unterstützt es auch das Sammeln von schwachem natürlichem Umgebungslicht für direkte Berechnungen, wodurch die fotoelektrische Kodierung auf diesem Eingangspfad entfällt.
Cheng Yuan erklärte, dass Zhuolong die gleiche Form wie die derzeit gängigen photoelektrischen Beschleunigungskarten für Server hat, sein Highlight liegt in der universelleren Matrixbeschleunigung und Modellanpassungsfähigkeit; Xuanjian ist auf niedrigenergieintensive Szenarien auf der Endgeräteseite ausgerichtet, und ähnliche Produkte auf dem Markt sind noch selten. Das langfristigere Ziel ist ein universelles photonisches GPGPU für integriertes Training und Inferenz, dessen erste Version voraussichtlich Ende 2027 oder Anfang 2028 auf den Markt kommt.
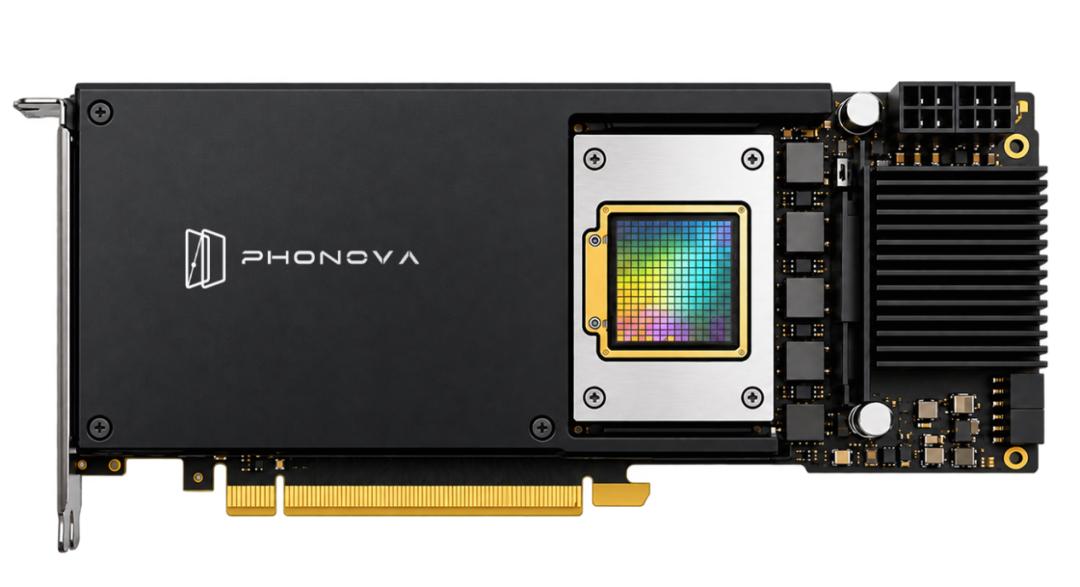
Server-photoelektrische Beschleunigungskarte Zhuolong OPU-08 (Bildquelle / Unternehmen)
Auf technischer Umsetzungsebene steht die optische Berechnung vor Konsistenzproblemen wie Bauelementunterschieden, Rauschen und Temperaturdrift. Durch die Zusammenarbeit von Software- und Hardware-Kompensationsmodulen fügt Zhizi Guangyuan automatisierte nanosekundengenaue Kalibriermodule in optische Chips ein. Das Unternehmen gibt an, dass der Fehler von Matrixoperationen auf das Niveau von 10^-6 gesenkt werden kann, um die Genauigkeitskonsistenz von Massenchips zu verbessern. Derzeit arbeitet das Unternehmen mit inländischen Fertigungs-, Verpackungs- und Testwerken zusammen, um die Massenproduktion voranzutreiben, aber die Produktleistung muss noch nach der Rücksendung der Chips getestet und validiert werden.
Gemäß dem Plan des Unternehmens liegt der aktuelle Schwerpunkt auf dem Abschluss der Verpackung und des Tests, der gemeinsamen Abstimmung der Karten, der Modellanpassung und der Kundenvalidierung von Zhuolong und Xuanjian, um sicherzustellen, dass die Produkte wie geplant auf den Markt kommen; danach werden schrittweise größere optische Rechenkarten und universelle photonische GPGPUs vorangetrieben.
Das Unternehmen hofft, auf der Grundlage der Akkumulation des Teams in der Forschung und Entwicklung von Spitzentechnologien, der technischen Umsetzung von Chips und der Bereitstellung von Systemebenenprodukten den Prozess der praktischen Anwendung von optischen Chips um 2-3 Jahre zu beschleunigen. Die Umsetzung dieses Ziels erfordert noch die gemeinsame Unterstützung der oberen und unteren Industriekette.
Cheng Yuan erklärte, dass das Unternehmen auch den Schwerpunkt auf die KI-Rechenleistungsinfrastruktur, die optische Kommunikations- und Silizium-Photonik-Industriekette sowie die oberen und unteren Glieder wie Fertigung, Verpackung und Test legen wird. Die Reife der optischen Kommunikations- und Silizium-Photonik-Industriekette bietet die Grundlage für Bauelemente, Verfahren und Verpackung für die optische Berechnung; die industrielle Zusammenarbeit wird sich um Verfahren, Verpackung und Test, Serverhersteller, Endanwendungs partner und Modellanpassung drehen.
Langfristig setzt sich Zhizi Guangyuan dafür ein, die Umsetzung der universellen optischen Berechnung voranzutreiben, sodass derselbe Satz von Hardware innerhalb des für Licht geeigneten Rechenbereichs verschiedene Modelle und Aufgaben anpassen kann, und schließlich ein integriertes photonisches GPGPU für Training und Inferenz sowie das dazugehörige Softwaresystem aufzubauen.
„Spezialisierung ist der erste Schritt der optischen Berechnung zur praktischen Anwendung, Universalität ist der nächste Schritt, damit die optische Berechnung zu einer Rechenleistungsinfrastruktur wird“, sagte Cheng Yuan.
Im Folgenden finden Sie Auszüge aus dem Interview von Hard Krypton mit Cheng Yuan, dem Gründer von Zhizi Guangyuan (redaktionell bearbeitet):
Hard Krypton: Warum wird in der Branche selten Interferenz und Beugung auf einem einzigen optischen Rechenchip gemischt? Warum hat Zhizi Guangyuan diese Route gewählt?
Cheng Yuan: Die Realisierung der Mischung von Interferenz und Beugung auf einem einzigen optischen Rechenchip ist zunächst eine Innovation auf Architekturebene. Unser Team treibt die systemweite Modellanpassung seit langem auf der Ebene der rekonstruierbaren Architektur voran und steht in der Forschung an der internationalen Spitze.
Diese Technologie wird eingesetzt, um die Einschränkungen traditioneller optischer Rechenarchitekturen bei Flexibilität und Rechenumfang zu durchbrechen, die Rekonstruierbarkeit innerhalb des optischen Chips zu erreichen und einen volloptischen Rechenpfad auf Basis von Interferenz und Beugung zu verwenden. Die Rekonstruierbarkeit bestimmt, wie viele Aufgaben die optische Berechnung anpassen kann, der volloptische Pfad öffnet einen größeren Raum für Energieeffizienz und senkt den Bedarf an fotoelektrischer Umwandlung auf nahezu Null. Nur wenn Rekonstruierbarkeit und Volloptik erreicht werden, kann die sogenannte universelle optische Berechnung realisiert werden – die Anpassung verschiedener Aufgaben und Modelle auf demselben Satz von Hardware. Die Schwierigkeit liegt darin, wie interne Operationen der optischen Berechnung gesteuert werden können, um den rekonstruierbaren Algorithmus im Inneren des optischen Chips zu realisieren und gleichzeitig die konsistente Leistung jedes Chips zu gewährleisten. Dies erfordert die Zusammenarbeit der gesamten Industriekette von Architekturdesign, Verfahren bis Verpackung und Test.
Hard Krypton: Die Produkte befinden sich derzeit im Tape-Out, wie ist der Fortschritt bei Kunden und Massenproduktion?
Cheng Yuan: Derzeit haben wir viele interessierte Kunden gesammelt. Ein Kartenhersteller plant die Einführung einer photoelektrischen Beschleunigungskarte, unser optischer Chip wird als Ko-Prozessor-Beschleunigungsmodul auf seinem GPGPU fungieren. Im Hinblick auf die Massenproduktion haben wir bereits Kooperationen mit bekannten inländischen Fertigungs-, Verpackungs- und Testherstellern aufgebaut und arbeiten an der entsprechenden Massenproduktion. Gleichzeitig arbeiten wir mit Software-Hardware-Kalibrierungs- und Kompensationsmodulen zusammen, um die Konsistenz der fertigen optischen Chips zu gewährleisten.
Hard Krypton: Was ist das Schwierigste, was die optische Berechnung auf dem Weg zur praktischen Anwendung überwinden muss?
Cheng Yuan: Das Schwierigste ist die stabile Lieferung und die Konsistenz in der Massenproduktion. Die experimentelle Leistung eines einzelnen Chips muss zu einer stabilen Leistung von Massenprodukten in der Kundenumgebung werden. Bauelementunterschiede, Rauschen und Temperaturdrift beeinflussen alle das Rechenergebnis. Deshalb haben wir auf unterster Ebene nanosekundengenaue Kalibriermodule mit Software-Hardware-Kooperation hinzugefügt und Verpackung, Test und Modellanpassung bereits in die Entwurfsphase vorgezogen, um technische Umsetzungsprobleme von der Quelle zu lösen und zu vermeiden, dass Probleme bis zur Lieferung auftauchen.
Standpunkte der Investoren:
Yunqi Capital erklärte: Yunqi ist seit langem überzeugt, dass die optische Berechnung neue Durchbrüche für die KI-Rechenleistungsinfrastruktur bringen kann. Das Team