Warum lässt sich die Rechenleistung des Fahrzeugcockpits nicht gleichberechtigen, nachdem die Gleichberechtigung des intelligenten Fahrens verwirklicht wurde?
Anfang 2025 leitete BYDs „Göttliches Auge“ die Demokratisierung des intelligenten Fahrens ein. Hochstufenfunktionen des intelligenten Fahrens drangen schnell in Fahrzeugmodelle der 100.000-Yuan-Klasse oder sogar darunter vor, womit die Demokratisierung des intelligenten Fahrens offiziell begann.
Doch die Demokratisierung der intelligenten Fahrzeugkabine geriet in neue Schwierigkeiten. Zuerst ist die Demokratisierung der intelligenten Kabine in Bezug auf die „Verfügbarkeit“ längst abgeschlossen. Daten des Gasgoo Auto Research Institute zeigen, dass die Durchdringungsrate intelligenter Kabinen bei inländischen Pkw im August 2026 87,5 % erreichte und damit nahe an der vollständigen Verbreitung liegt. Die Konfigurationsrate intelligenter Kabinen bei Modellen unter 100.000 Yuan stieg von 52 % auf 70 %. Großbildschirme, Spracherkennung und Fahrzeuginternet sind nicht mehr ausschließlich hochpreisigen Fahrzeugen vorbehalten, die grundlegende Hardware der Kabine hat die Preisabnahme bereits abgeschlossen.
Aber die Verbreitung von Hardware bedeutet nicht, dass die Erfahrung gleichmäßig verteilt ist. Derzeit sind hochwertige Chips wie der Qualcomm 8295 hauptsächlich in Modellen mit einem Preis von über 200.000 Yuan verbaut, während die Hauptmodelle mit einem Preis von unter 200.000 Yuan weiterhin hauptsächlich mit dem Qualcomm 8155 ausgestattet sind.
Vor nicht langer Zeit hat die Branche des intelligenten Fahrens eine neue Lösung vorgeschlagen: Momenta hat das Konzept „Großes Modell definiert Chip“ vorgebracht, um die gemeinsame Definition und synchrone Iteration von Algorithmusmodellen und Chiparchitekturen zu realisieren. Dies bestätigt auch, wie die Rechenleistung mit der Iteration von Modellen Schritt halten kann, ist zu einem Kernproblem geworden, das intelligente Fahrzeuge beantworten müssen.
Gleichzeitig verlagert sich der Wettbewerb um die Intelligenz der Fahrzeugkabine von der Frage „ob es funktioniert“ zu der Frage „ob es gut funktioniert und langfristig iteriert werden kann“. Fortschrittlichere KI-Funktionen der Kabine und kontinuierlich aktualisierte aktive intelligente Erfahrungen sind nach wie vor an die Chipkonfigurationen in den Preisstufen gebunden.
Noch wichtiger ist, dass die Kabine den Demokratisierungspfad des intelligenten Fahrens kaum nachahmen kann. Die Funktionsgrenzen des intelligenten Fahrens haben sich bereits eingependelt, der Bedarf an Rechenleistung kann im Voraus berechnet werden, während die Fähigkeiten der großen Modelle für die Fahrzeugkabine noch schnell expandieren und jedes Quartal neue Anwendungen eingeführt werden. In der Phase der Fahrzeugmodellentwicklung ist es schwierig, den zukünftigen Verbrauch an Rechenleistung vorherzusagen.
Vor diesem Hintergrund ist die einfache Vorinstallation größerer Rechenleistung bei der Auslieferung keine zuverlässige Lösung mehr. Die Branche muss tatsächlich ein System zur Aktualisierung der Rechenleistung aufbauen, das durch intelligente Upgrades angetrieben wird. Die Hauptlinie des Wettbewerbs um intelligente Kabinen verlagert sich damit vom Wettbewerb um feste Rechenleistung zum Wettbewerb um evolvierbare Rechenleistung.
01.
Mehr Fähigkeiten verlagern sich auf die Endseite
Die Vorinstallationsmethode verliert ihre Gültigkeit auf der Kabinenseite
Die Zusammenarbeit von Ende und Cloud ist längst ein Branchenkonsens. Die Cloud übernimmt komplexe Schlussfolgerungen und plattformübergreifende Ökosystemaufrufe, die Endseite übernimmt die ständige Wahrnehmung und Reaktion im Millisekundenbereich, verarbeitet gleichzeitig Interaktionen in Szenarien mit schwachem oder keinem Netzwerk und lässt sensible Daten wie Sprache und Insassenzustände lokal in einem geschlossenen Kreislauf berechnen, um die Anforderungen an den Datenschutz und die Datenkonformität zu erfüllen.
Die Intelligenz der Fahrzeugkabine hat bereits eine aufsteigende Kurve gezeichnet: von der frühen Ära 1.0 der Intelligenz mit festen Anweisungen und einfachen Frage-Antwort-Interaktionen bis zur heutigen Ära 4.0 der Intelligenz mit aktiven Diensten basierend auf Gedächtnis und Entscheidungen. Jeder Abschnitt dieser Kurve kann nur funktionieren, wenn das Endseitenmodell tatsächlich auf dem Fahrzeug läuft.
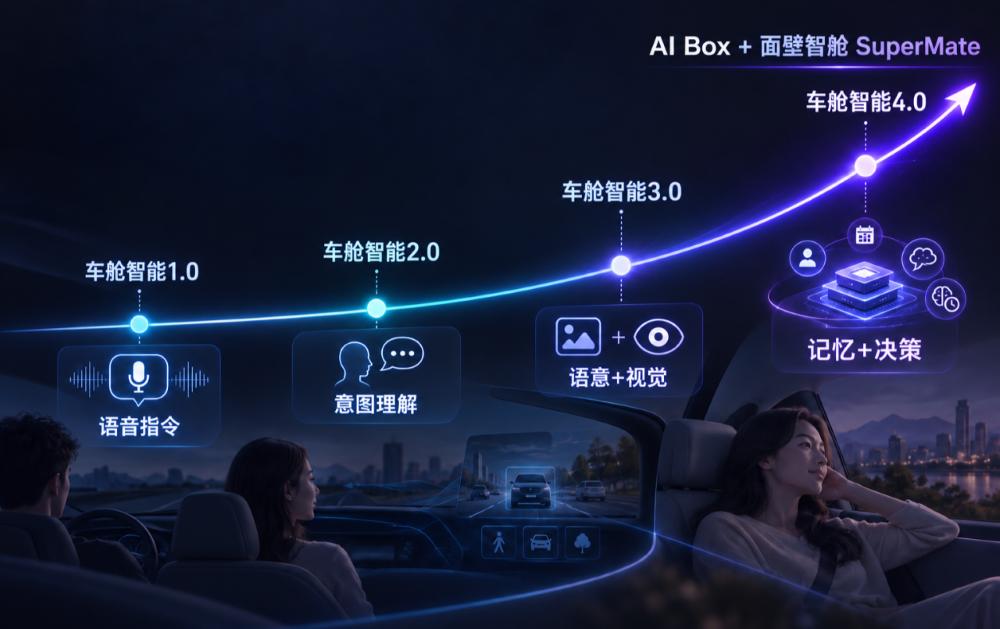
▲ Schematische Darstellung der Evolution der intelligenten Kabine von Version 1.0 bis 4.0
Die Endseiten-Rechenleistung ist bereits zum Kernfundament für hochwertige intelligente Erfahrungen in der Kabine geworden. Die häufigen und nahen Interaktionserfahrungen in der Kabine müssen auf der lokalen Endseiten-Rechenleistung basieren. Wenn die Iteration der Endseiten-Rechenleistung nicht mit dem Aktualisierungsrhythmus der Modelle Schritt halten kann, wird sie in den tatsächlichen Nutzungsszenarien des Fahrzeugs schließlich scheitern.
Wenn immer mehr häufige Interaktionen und Steuerungsaufgaben der Kabine auf die lokale Seite verlagert werden, werden die angeborenen Einschränkungen der Endseiten-Hardware zu einem unumgänglichen Problem.
Im Gegensatz zur Cloud-Rechenleistung unterliegen fahrzeugspezifische Kabinenchips strengen Beschränkungen in Bezug auf Leistungsaufnahme, Wärmeableitung, Hardwarekosten und die Stromversorgungsbedingungen des gesamten Fahrzeugs. Die Obergrenze der Chip-Rechenleistung ist festgelegt, die verfügbaren Speicherressourcen sind begrenzt, sodass größere Modelle nicht unbegrenzt geladen werden können. Gleichzeitig führt die Hochlast-Schlussfolgerung zu Druck durch Leistungsaufnahme und Wärmeentwicklung, was die Stabilität des Kabinensystems beeinträchtigt.
Darüber hinaus besteht in der Branche der intelligenten Kabinen ein Widerspruch für die Endseiten-Intelligenz: Der Iterationszyklus großer Modelle beträgt 3-4 Monate, während die Entwicklung von fahrzeugspezifischen Kabinen-SoCs von der Auswahl bis zur Serienproduktion mindestens ein halbes Jahr bis zu einem Jahr dauert.
Die Kabinenmodelle entwickeln sich rasant, aber sobald die Hardware des Fahrzeugterminals festgelegt ist, ist die Rechenleistung im Wesentlichen blockiert. Nachfolgende Software-OTA kann kaum die Grenzen der Hardware durchbrechen, was zu einem Fehlpass-Dilemma führt, dass „die Rechenleistungsversorgung nicht mit der Evolution der Modelle Schritt halten kann“.
Auf der Strecke des intelligenten Fahrens werden die Grenzen von Szenarien wie Fahren, Einparken und aktiver Sicherheit immer klarer. Automobilhersteller können Hardware nach Bedarf konfigurieren und einen angemessenen Rest an Rechenleistung vorhalten.
Aber die großen Modelle für die Kabine folgen einer völlig anderen Logik: Die Fähigkeitsgrenzen der Modelle expandieren jedes Quartal kontinuierlich. Bei der Planung von Fahrzeugmodellen in diesem Jahr ist es schwierig, vorherzusagen, wie viel Rechenleistung die Interaktionen und Agenten in der Kabine in zwei Jahren benötigen werden.
Dieses Problem macht die Vorinstallation von Rechenleistung für Hersteller zu einer „Wette“ auf die Zukunft: Wenn die vorbehaltene Rechenleistung zu gering ist, stehen die neu ausgelieferten Fahrzeuge vor dem Problem veralteter Fähigkeiten. Wenn aber zu viel Rechenleistung vorbehalten wird, steigen die Kosten des gesamten Fahrzeugs unnötig an.
Dieser Widerspruch wird durch die Preispositionierung der Fahrzeugmodelle weiter verstärkt. Hochpreisige Modelle verfügen im Allgemeinen über ausreichende Gewinnspannen, um mehr überschüssige Rechenleistung vorzuinstallieren. Preisgünstige Modelle sind jedoch durch Kostenbeschränkungen eingeschränkt und haben keine zusätzliche Gewinnspanne, um für den ungewissen zukünftigen Bedarf an Rechenleistung zu zahlen.
Dasselbe technische Problem entwickelt sich schließlich zu einer Marktdifferenzierung: Kontinuierlich iterierte intelligente Kabinenerfahrungen sind meist im hochpreisigen Preissegment zu finden.
02.
Rechenleistung wird zu einem unabhängigen Modul für steckbare Upgrades
Lösung des Problems des Fehlpasses zwischen Rechenleistung und Modell
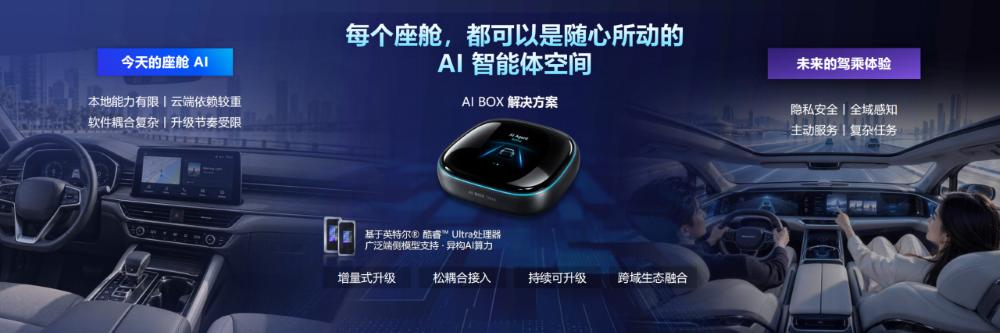
Für die Pflichtfrage „Wie kann die Rechenleistung mit der Iteration von Modellen Schritt halten“ gibt es in der Branche eine Lösung auf offener Route: Statt an einen einzelnen festen Chip gebunden zu sein, wird die Rechenleistung zu einem steckbaren, separat aktualisierbaren unabhängigen Modul gemacht.
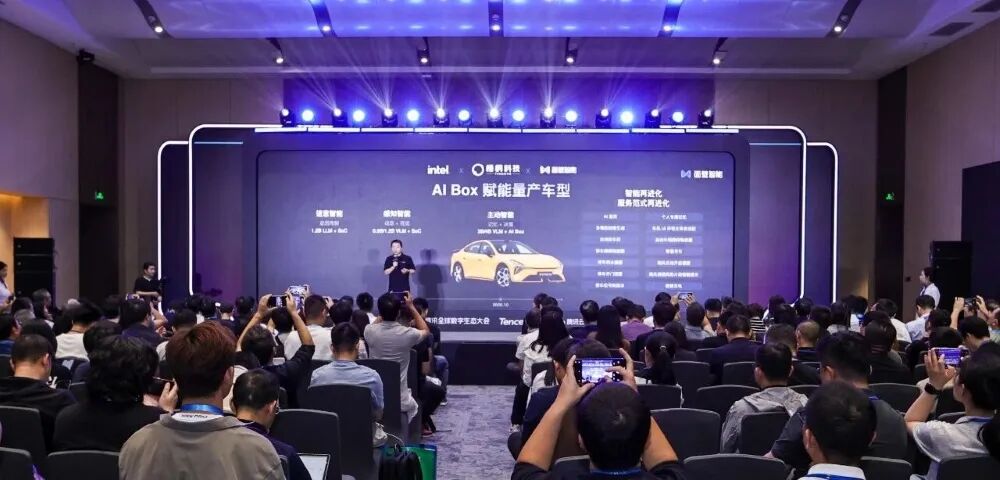
Die AI Box, die von Facewall Intelligence in Zusammenarbeit mit Partnern wie Wutong Technology und Intel entwickelt wurde, ist genau ein Serienprodukt dieser offenen Route.
▲ Intelligente Kabinenlösung auf Endseite für AI Box
Als gering invasives, konfigurierbares modulares Rechenleistungsknoten bietet sie den Benutzern leistungsstärkere Endseiten-Intelligenz und stellt gleichzeitig eine unabhängige, steckbare Rechenleistungs- und Intelligenzlösung für die Fahrzeugcomputingplattform bereit, was eine serienreife Lösung für das Problem des Fehlpasses zwischen Rechenleistung und Modell bietet.
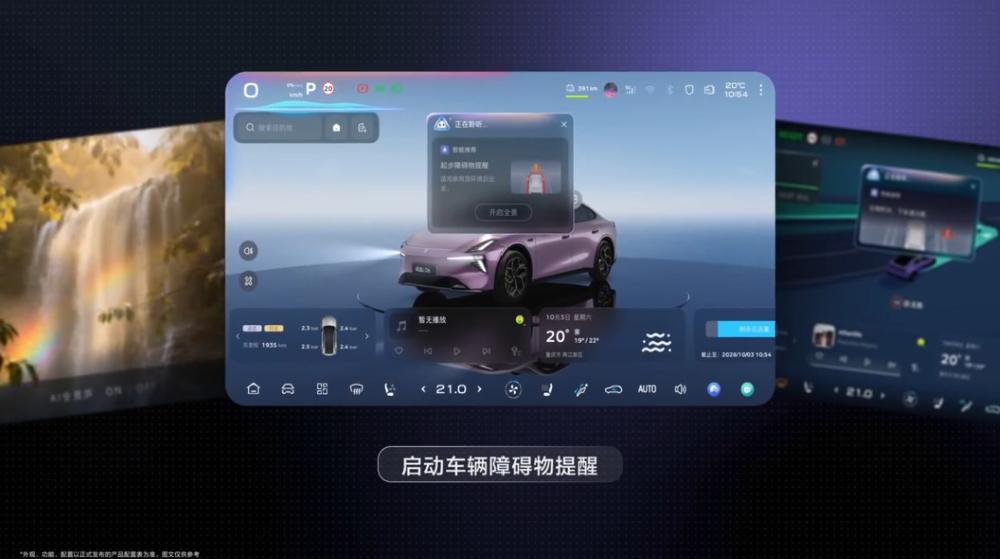
Darüber hinaus unterstützt es OTA-Upgrades, sodass Automobilhersteller den Benutzern kontinuierlich intelligente Anwendungen und Dienste auf Basis fortschrittlicher Endseiten-Großmodelle anbieten und den intelligenten Lebenszyklus des Fahrzeugs verlängern können.
▲ Die kontinuierlich aktualisierbare Fähigkeit, die die AI Box bietet
Derzeit wird die AI Box als Option auf dem Chang'an Deep Blue L06 montiert und offiziell ausgeliefert, sie ist mit dem 4B-VLM-Modell und mehreren Endseitenmodellen ausgestattet. Das Projekt wurde im Juli erstmals vorgestellt und erreichte im Oktober die Vorinstallations-Serienproduktion, der gesamte Zyklus betrug nur drei Monate.
▲ Chang'an Deep Blue L06 mit montierter AI Box
Die offene Route eignet sich besser für Automobilhersteller, die keine Fähigkeiten zur selbst entwickelten Chip haben, aber ihre Wettbewerbsfähigkeit bei der Kabinenintelligenz behalten wollen, sowie für Modelle, die auf ausländische Märkte expandieren. Die strengen Datenkonformitätsanforderungen im Ausland erhöhen den Wert der lokalen Endseiten-Berechnung weiter.
Bei der offenen Route setzt man darauf, dass in dem Zyklus der schnellen Modelliteration Flexibilität wertvoller ist als Bestimmtheit.
Die offene Route der modularen Rechenleistungsaktualisierung hat das erste Serienprodukt hervorgebracht, aber um von einem einzelnen Fall zu einem branchenweiten allgemeinen Paradigma zu werden, müssen noch drei branchenspezifische Variablen bewältigt werden.
Auf dem Automobilmarkt besteht Unsicherheit bei dem Modell der intelligenten Option: Ob Verbraucher bereit sind, zusätzliche Kosten für nachfolgende intelligente Upgrades zu zahlen, muss noch langfristig vom Markt validiert werden.
Gleichzeitig müssen externe modulare Rechenleistungsmodule die Hürden der fahrzeugspezifischen Zuverlässigkeit und die Abgrenzung der Haftung bei Fehlern überwinden, was auch die Frage aufwirft, ob Automobilhersteller bereit sind, die Hardware-Ressourcen der Kabine freizugeben.
Ob man die zusätzliche Rechenleistung an externe modulare Lösungen übergibt, stellt die Offenheit der Automobilhersteller auf die Probe.
03.
Das Wettrüsten um die Zahlen der Modellparameter gerät ins Stocken
Übergang zum Wettbewerb um die „Intelligenzdichte“
Die durch die feste Rechenleistung verursachten Schwierigkeiten sind kein einzigartiges Problem der Automobilbranche, Roboter, Smartphones und IoT-Geräte stehen alle vor demselben Engpass.
Aber der reine Parameterwettbewerb um die TOPS-Rechenleistung hat unter den Einschränkungen der Bedingungen für intelligente Kabinen einen Engpass erreicht. Auf den Pressekonferenzen großer Hersteller werden oft große Modelle mit Dutzenden von Milliarden Parametern vorgestellt, aber der tatsächliche Umfang der Kabinenmodelle, die tatsächlich in die Vorinstallations-Serienproduktion von Fahrzeugen gelangen, ist weitaus geringer als der angegebene Wert. Die meisten Endseitenmodelle, die tatsächlich auf dem Fahrzeugterminal laufen, liegen im Bereich von 0,9B bis 3B, die angegebenen Papierparameter lassen sich kaum in echten Fahrzeugen umsetzen.
Das Dichtegesetz, das von Forschern der Tsinghua-Universität und Facewall Intelligence vorgeschlagen wurde, liefert einen neuen Wettbewerbsmaßstab: Die Fähigkeitsdichte großer Modelle verdoppelt sich etwa alle 3,5 Monate, und die Rechenleistung, die für das gleiche Intelligenzniveau benötigt wird, nimmt kontinuierlich ab.
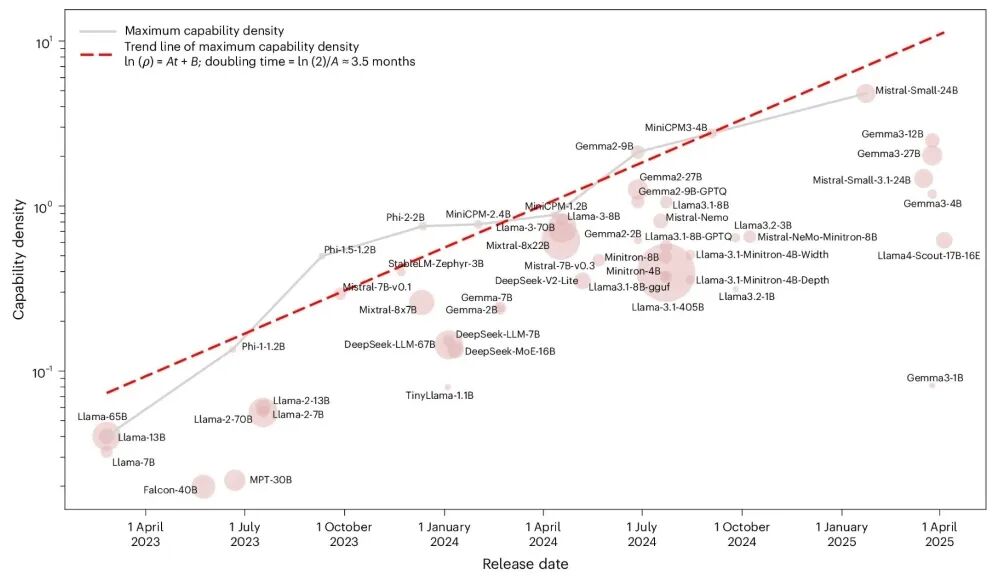
▲ Das Dichtegesetz, das von Forschern der Tsinghua-Universität und Facewall Intelligence vorgeschlagen wurde
Sobald der modulare Aktualisierungsmechanismus die Fesseln der festen Hardware-Rechenleistung bricht, verlagert sich der Schwerpunkt des Branchenwettbewerbs natürlich vom reinen Wettbewerb um die Papier-Rechenleistungsgröße zum Wettbewerb um die Effizienz der Rechenleistungsnutzung. Der Parameterwettbewerb bleibt nur auf dem Papier von Pressekonferenzen stehen, während die Modelldichte der Kern ist, der den Unterschied der Serienproduktionserfahrung bestimmt.
Für den Dichtewettbewerb muss man niemandes Slogan glauben, Ranglisten und