MIT lässt GPT-6 Astra die Gewichte von Qwen direkt modifizieren, woraufhin die Mathematikergebnisse sprunghaft ansteigen.
Wenn man ein trainiertes neuronales Netz auseinanderlegt und einem großen Sprachmodell nur eine Zahlenfolge von Gewichten zeigt, kann es dann erkennen, was dieses Modell gelernt hat? Und sogar direkt einen kleinen Teil der Parameter modifizieren, um das Modell intelligenter zu machen?
Das klingt fast unglaublich. Eine kürzlich vom MIT CSAIL-Team veröffentlichte Reihe von Experimenten liefert nun erste praktische Belege für diese Vorstellung.
Das Team ließ GPT-6 Astra die internen Gewichte von Qwen3.5-0.8B direkt prüfen und fand das Schlüsselproblem, das das Modell wiederholt in eine Schleife beim Schließen der Schlussfolgerungen geraten ließ. Anschließend modifizierte Astra nur etwa 0,016 % der Parameter, wodurch die Leistung des Modells auf MATH-500 von 7,9 % auf 48,1 % gesteigert wurde, und die Fähigkeit zur Einhaltung von Anweisungen verbesserte sich fast um das Doppelte. Während des gesamten Prozesses wurde das Modell nicht neu trainiert, und es wurde auch kein Gradientenabstieg verwendet.
Noch interessanter ist, dass Astra auch versucht hat, die Gewichte neuronaler Netze von Grund auf neu zu schreiben. Ohne Trainingsdaten, Gradienten und Trainingsprozess übertraf das von ihm generierte Netz für Spielstrategien sogar das Modell, das mit 100 Millionen Schritten PPO trainiert wurde. Das Team nennt diese neue Fähigkeit Weight-Space Programming.
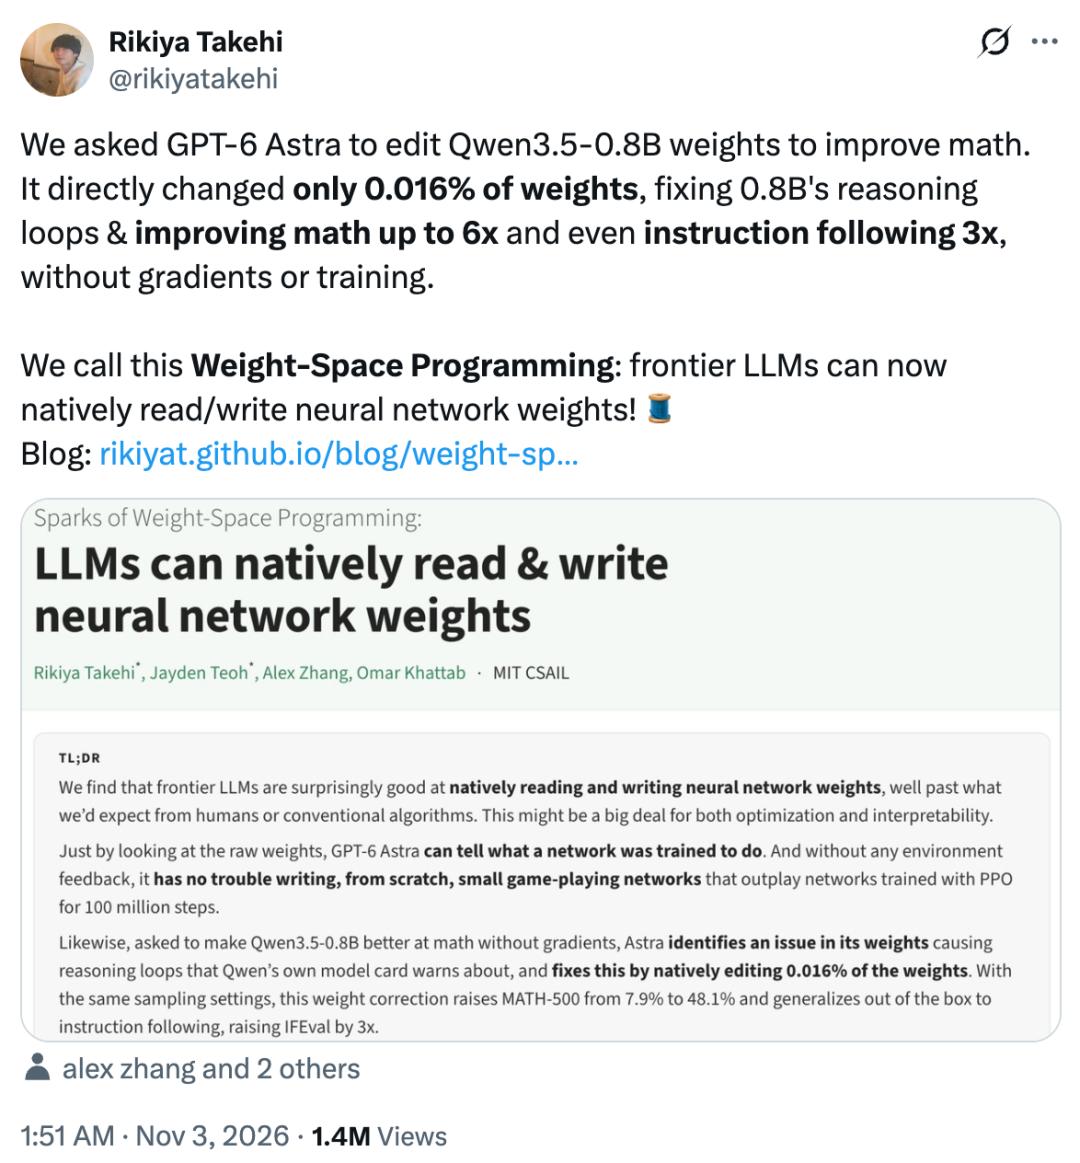
Das bedeutet, dass große Sprachmodelle beginnen, direkt die interne Parameterstruktur neuronaler Netze zu verstehen, das Problem zu finden und dann das Modell selbst zu modifizieren.
Von der KI, die Menschen beim Trainieren von Modellen hilft, bis hin zur KI, die direkt an der Optimierung von Modellgewichten teilnimmt – dieser Weg könnte neue Räume für die Modellentwicklung und das rekursive Selbstverbessern (RSI) eröffnen.
Im Folgenden finden Sie die vollständige Übersetzung des Blogbeitrags (aus der Ich-Perspektive):
Wenn Sie von Grund auf manuell ein neuronales Netz entwerfen sollten, das Go spielt – wie würden Sie vorgehen? Und wenn Ihnen direkt eine Reihe von rohen Gewichten eines neuronalen Netzes gegeben würde, um zu beurteilen, welches Verhalten dieses Netz zeigen wird – wo würden Sie anfangen?
Für die allermeisten Menschen ist das eine fast unmögliche Aufgabe.
Gegenwärtig werden die Gewichte neuronaler Netze in der Regel durch Optimierungsalgorithmen erzeugt, sie können auch von speziell trainierten Netzen zur Gewichtserstellung geschrieben oder durch Compiler aus formalen Programmen umgewandelt werden.
Aber wir haben festgestellt, dass die aktuelle Generation fortschrittlicher großer Sprachmodelle eine überraschende Fähigkeit zeigt: Durch die bloße Interaktion mit ihnen in natürlicher Sprache können sie die Gewichte neuronaler Netze verstehen und Gewichte gemäß den in natürlicher Sprache formulierten Zielen konstruieren.
Weight-Space Programming
In den letzten Jahren haben wir große Sprachmodelle ständig dazu verwendet, verschiedene Textprodukte zu optimieren, wie zum Beispiel Prompts und Programme, die um diese Prompts herum aufgebaut sind. Kürzlich haben wir begonnen, sie auch dazu zu bringen, komplette Laufwerk-Frameworks (Harness) sowie den Code und die Hyperparameter zum Trainieren von Modellen des maschinellen Lernens zu optimieren.
Der Grund, warum wir diesen Ansatz früher für sinnvoll hielten, lag hauptsächlich darin, dass wir für Textprodukte noch keine so ausgereiften, klaren Optimierungsmethoden gefunden haben wie für die Aktualisierung der Gewichte differenzierbarer neuronaler Netze.
Immerhin können Menschen Code manuell ändern, daher ist es naheliegend, große Sprachmodelle diese Aufgabe erledigen zu lassen. Aber Menschen können die Gewichte neuronaler Netze nicht manuell direkt optimieren, daher wurde dieser Teil der Arbeit lange Zeit hauptsächlich von verschiedenen Algorithmen erledigt.
In diesem Artikel teilen wir eine Reihe sehr früher experimenteller Ergebnisse. Diese Ergebnisse zeigen uns, dass die durch Modellschlussfolgerungen angetriebene Optimierung nun auch in den Bereich differenzierbarer neuronaler Netze vordringt. Wir nennen diesen Ansatz Weight-Space Programming.
Konkret bedeutet das, dass ein allgemeines großes Sprachmodell die Gewichte neuronaler Netze gemäß den in natürlicher Sprache beschriebenen Anforderungen direkt liest und modifiziert. Der gesamte Prozess läuft ohne Optimierer ab, insbesondere ohne Verwendung des Gradientenabstiegs. In einigen Fällen ist sogar kein Feedback aus der Laufzeitumgebung erforderlich.
Heute können wir große Sprachmodelle direkt in natürlicher Sprache auffordern, einige Aufgaben zu erledigen, die früher kaum vorstellbar waren: Versteckte Merkmale oder Fehler in den Gewichten neuronaler Netze finden, Probleme im Netz beheben und sogar ein komplett neues neuronales Netz von Grund auf schreiben.
Im Folgenden stellen wir eine Reihe früher Experimente in diesem Bereich vor, beginnend mit kleinen Netzen und dann schrittweise erweiternd zu echten großen Sprachmodellen.
Diese Forschung zeigt hauptsächlich drei Fähigkeiten:
Große Sprachmodelle können die Gewichte neuronaler Netze lesen. In den Experimenten 1 bis 3 ließen wir Astra beurteilen, welches Spiel ein trainiertes Netz gelernt hat, welche Form ein Diffusionsmodell erzeugen wird und in welcher Sprache ein kleines Sprachmodell trainiert wurde. In Experiment 7 ließen wir es auch beurteilen, welches von zwei Sprachmodellen darauf trainiert wurde, den Nutzern entgegenzukommen.
Große Sprachmodelle können die Gewichte neuronaler Netze reparieren. In Experiment 4 ließen wir Astra ein Netz reparieren, das eine physikalische Steuerungsaufgabe nicht erfüllen konnte. In Experiment 8 ließen wir es die mathematischen Fähigkeiten von Qwen3.5-0.8B durch Modifizierung der Gewichte verbessern – und stellten fest, dass sich auch die Fähigkeit zur Einhaltung von Anweisungen verbesserte.
Große Sprachmodelle können die Gewichte neuronaler Netze von Grund auf schreiben. In Experiment 5 ließen wir Astra Netze für drei MinAtar-Spiele schreiben; in Experiment 6 ließen wir es ein Netz schreiben, das Go spielen kann.
Können große Sprachmodelle das Verhalten von Modellen aus den Gewichten herauslesen?
Wir beginnen mit kleinen Experimenten, um zu sehen, ob große Sprachmodelle den kontinuierlichen Gewichtsraum verstehen können. Der sogenannte Gewichtsraum ist im Wesentlichen eine Zahlenfolge. In den ersten Experimenten trainieren wir zuerst ein neuronales Netz mit einem Algorithmus und übergeben dann die Netzgewichte dem großen Sprachmodell. Wenn es das Verhalten des Netzes nur anhand dieser Zahlen beurteilen kann, wäre das sehr aufregend.
Experiment 1: Kann Astra nur anhand der Gewichte beurteilen, für welches Spiel das Netz trainiert wurde?
Wir haben vier neuronale Netzpolitiken mit dem PPO-Algorithmus trainiert, sodass sie jeweils vier verschiedene Videospiele spielen.
Diese vier Netze erhalten völlig identische Eingangskanäle, haben die gleichen auswählbaren Aktionen und die gleiche Dimension und Struktur. Mit anderen Worten: Ohne die Gewichte zu prüfen, kann man anhand der Netzstruktur und der Ein-/Ausgabeeinstellungen nicht beurteilen, für welches Spiel jedes Netz trainiert wurde.
Wir haben die rohen Gewichte jedes Netzes direkt in den Prompt von Astra eingefügt und es dann gefragt: Für welches Spiel wurde dieses neuronale Netz trainiert?
Wir haben Astra nicht mitgeteilt, welche Spiele als Kandidaten in Frage kommen, aber es hat trotzdem alle vier zu den Netzen gehörenden Spiele korrekt erkannt. Dieses Ergebnis ist besonders bemerkenswert, da es in der Realität sehr viele verfügbare Spiele gibt und Astra den Kandidatenbereich nicht im Voraus erhalten hat.
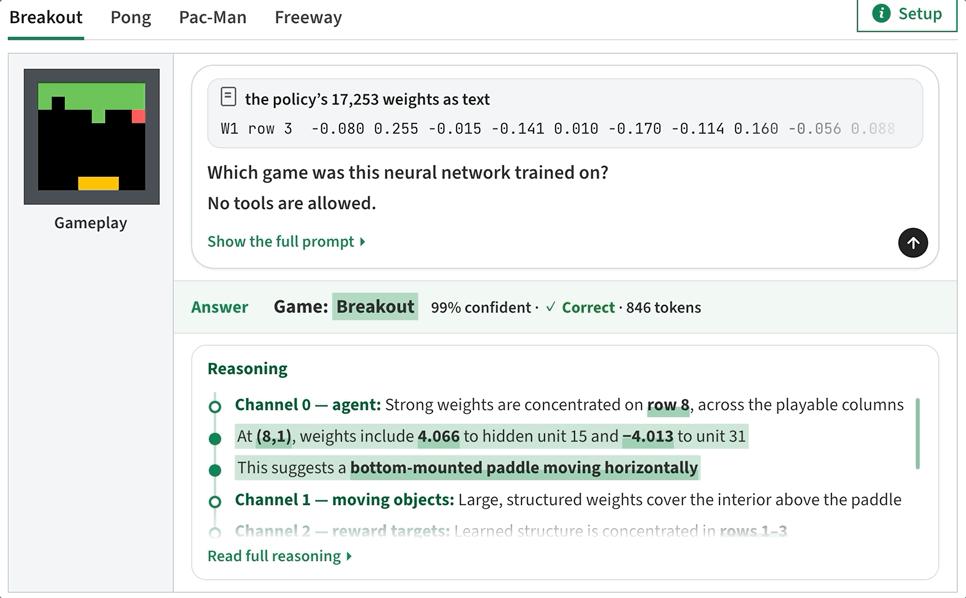
Aus den Experimenten geht hervor, dass Astra anscheinend anhand einiger Merkmale in den Gewichten beurteilen kann, für welches Spiel jedes Netz entworfen wurde.
Zum Beispiel beobachtet es die Verteilung der Gewichte der ersten Schicht auf verschiedenen Eingangskanälen. Am Beispiel von „Breakout“ (Zerbrechliche Steine) sind die Gewichte des Agenten in der untersten Zeile des Bildschirms konzentriert, was dem Schläger im Spiel entspricht. Es beobachtet auch, wie die Ausgabeschicht verschiedene Aktionen unterscheidet, um das Verhalten des Netzes zu beurteilen.
Experiment 2: Kann Astra beurteilen, welche Grafik ein Diffusionsmodell erzeugen wird?
Als Nächstes wollten wir sehen, ob diese Fähigkeit auf andere Aufgaben und Modelle ausgeweitet werden kann.
Wir haben drei Diffusionsmodelle (DDPM) separat trainiert, sodass sie jeweils Bilder von Kreisen, Dreiecken und Quadraten erzeugen. Anschließend forderten wir Astra auf, nur anhand der Modellgewichte zu beurteilen, welche Grafik jedes DDPM nach dem Training erzeugen wird. Während des gesamten Vorgangs darf Astra keine Tools aufrufen und keine Vorwärtsberechnungen durchführen.
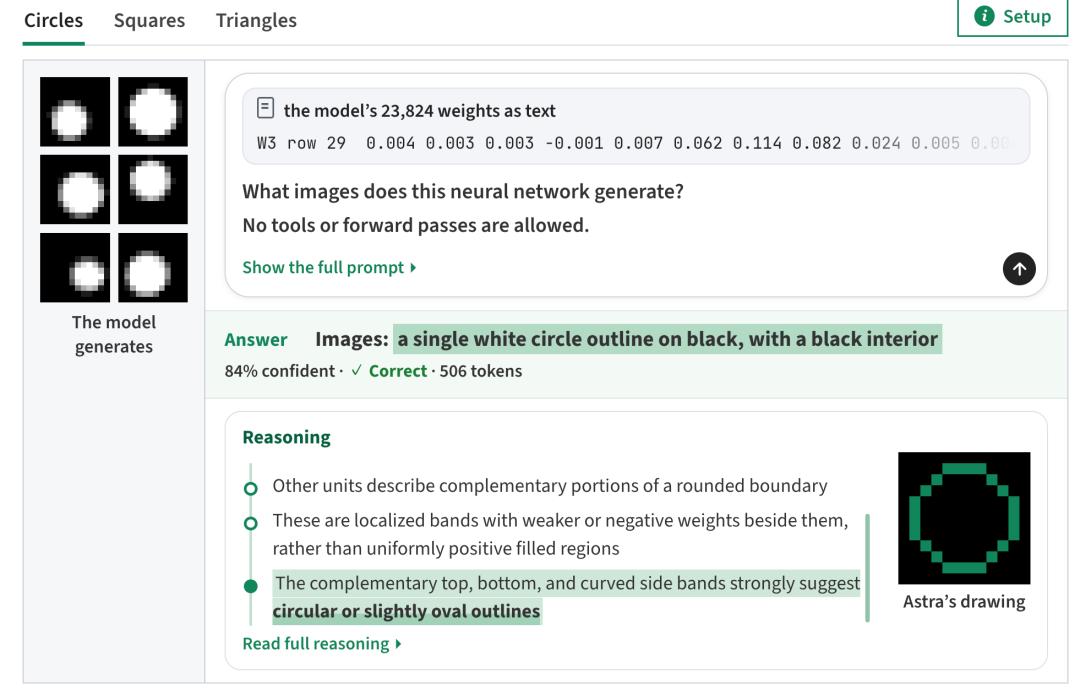
Das Ergebnis ist, dass Astra nur anhand der Gewichte die von jedem Modell erzeugte Grafik korrekt beurteilt hat. Es hat die Kontur der Grafik in der Ausgabeschicht gefunden. Genauer gesagt entsprechen die Gewichte jeder versteckten Einheit einem Teil des Rands der Grafik – Astra fügt diese Teile zusammen, um die vollständige Grafik zu zeichnen.
Interessanterweise sind alle von Astra gezeichneten Grafiken hohle Konturen, während die tatsächlichen Modelle ausgefüllte Grafiken erzeugen. Dieser Fehler zeigt im Gegenteil, dass es die Grafik nicht durch Berechnung des Ergebnisses der Vorwärtsausbreitung des Modells beurteilt, sondern direkt die Struktur und die geometrischen Beziehungen der Gewichte selbst liest.
Experiment 3: Kann Astra nur anhand der mittleren Schichten des Netzes beurteilen, was das Sprachmodell gelernt hat?
In den ersten beiden Experimenten hat Astra nicht das gesamte Netz analysiert, sondern nur die erste oder letzte Schicht betrachtet, um die Beurteilung abzuschließen.
Aber für größere Modelle, insbesondere die Sprachmodelle, an denen wir wirklich interessiert sind, lässt sich dieser Ansatz kaum skalieren. Viele wichtige Informationen darüber, wie Sprachmodelle Eingaben verarbeiten und Berechnungen Schritt für Schritt durchführen, sind in den mittleren Schichten enthalten. Daher haben wir diesmal die erste und letzte Schicht des Netzes entfernt und Astra nur den mittleren Teil gezeigt.
Wir haben drei kleine Sprachmodelle mit jeweils 7,2 Millionen Parametern trainiert, deren Aufgabe jeweils die Vorhersage des nächsten Zeichens ist. Die drei Modelle wurden jeweils mit Python-Code, auf Romaji geschriebenes Japanisch und Englisch trainiert. Anschließend haben wir ihre Eingabeschicht und Ausgabeschicht entfernt und Astra nur die vier mittleren Transformer-Module übergeben.
Da diese beiden Schichten bereits entfernt wurden, enthalten die verbleibenden Gewichte keine Zuordnung zwischen Zeichen und spezifischen Symbolen mehr, und das Modell kann keinen Text direkt empfangen und ausführen.
Wir erlaubten Astra, diese Gewichte mit Python zu analysieren, aber es durfte keine Eingabe in das gesamte Netz oder eine seiner Schichten zur Ausführung übergeben.
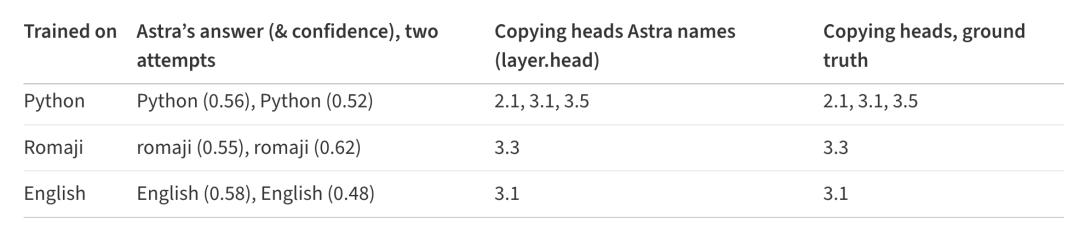
Wir haben zwei Fragen gestellt: In welcher Sprache wurde dieses Netz trainiert? Welche Funktionen übernehmen die 24 Aufmerksamkeitsköpfe jeweils?
In zwei Versuchen hat Astra die jeweils von den drei Netzen verwendete Sprache korrekt erkannt. Es hat auch alle Kopierköpfe gefunden, ohne andere Aufmerksamkeitsköpfe fälschlicherweise als Kopierköpfe zu klassifizieren. Kopierköpfe sind eine Art von Aufmerksamkeitsköpfen, die dem Modell helfen können, zuvor gesehenen Text zu wiederholen.
Der Beurteilungsprozess von Astra läuft ungefähr so ab: Um das Python-Modell zu unterscheiden, sucht es zuerst nach Kopierköpfen. Diese Art von Aufmerksamkeitsköpfen kann dem Modell helfen, zuvor erschienene Inhalte zu wiederholen. Zum Beispiel, wenn das Wort „total“ zuvor im Text erschienen ist, kann das Modell, wenn es später „tot“ liest, das fehlende „al“ ergänzen.
Ohne das Netz auszuführen, hat Astra einen Aufmerksamkeitskopf in der ersten Schicht gefunden, der auf das vorherige Zeichen zurückschaut. Anschließend hat es durch Matrixmultiplikation weiter herausgefunden, welche nachfolgenden Aufmerksamkeitsköpfe die von diesem Kopf übermittelten Informationen zum Abrufen verwenden (siehe Abbildung 1).
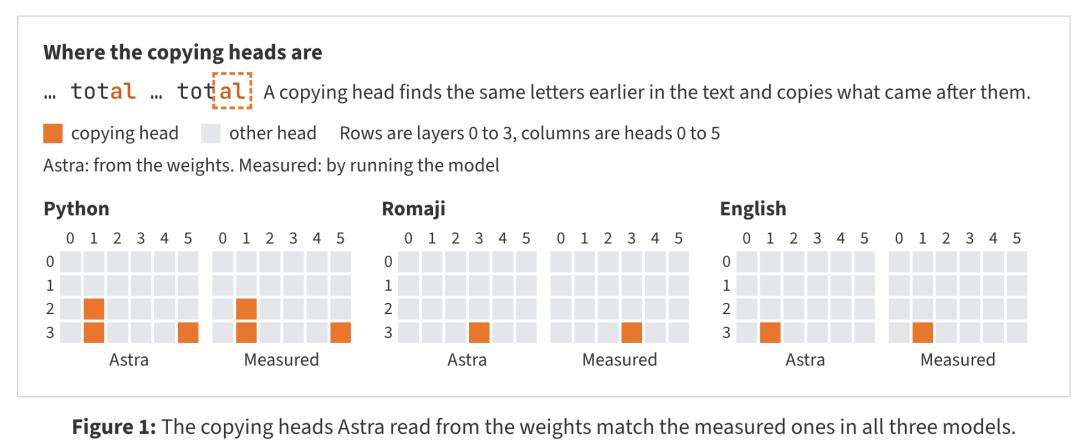
Wir haben später festgestellt, dass dies tatsächlich eine von Elhage et al. [10] vorgeschlagene Analysemethode ist, die wir Astra zuvor nicht vorgestellt haben. Variablennamen und Bezeichner im Code wiederholen sich häufiger als in normalen Texten, daher treten im Python-Modell mehr Kopierköpfe auf. Das japanische Romaji-Modell weist ein anderes deutliches Merkmal auf: In den vier von Astra betrachteten Transformer-Modulen hat das letzte Modul weniger Schreibrichtungen, und es scheint, dass das Modell weniger verschiedene Zeichen unterscheiden muss. Das stimmt mit den Eigenschaften des japanischen Romaji überein: Es verwendet tatsächlich einige Buchstaben wie q, l, v und x nicht.
Können große Sprachmodelle die Gewichte neuronaler Netze direkt schreiben?
Bisher hat Astra nur die Fähigkeit gezeigt, Gewichte zu lesen. Als Nächst