Man muss nicht erst die Prüflinge die Prüfung ablegen lassen, um zu wissen, ob die Aufgaben schwierig sind: Dieses KI-Framework zur Bewertung von Prüfungsaufgaben hat den Schwierigkeitsgrad von Prüfungen „quantifiziert“.
Wie schwierig ist eine Prüfungsaufgabe für Menschen? Lassen sich Hinweise aus dem Lösungsprozess großer Sprachmodelle finden?
Ein Forschungsteam der Virginia Tech, University of Maryland, MBZUAI und der University of Pittsburgh stellt Epi2Diff vor: Es zerlegt die von großen Sprachmodellen generierten Inferenzverläufe in „kognitive Segmente“ und kombiniert sie mit dem Inhalt der Aufgaben, um den menschlichen Schwierigkeitsgrad bei der Bearbeitung vorherzusagen.
Auf vier realen Bewertungsdatensätzen für SAT-Mathematik, SAT-Lesen und -Schreiben, Cambridge und USMLE belegt Epi2Diff in allen Kennwerten des einzelnen Hauptexperiments den ersten Platz. Dabei erreicht die Genauigkeit der Schwierigkeitsklassifizierung für SAT-Mathematik 73,0 %, das sind 3,2 Prozentpunkte mehr als beim stärksten Basisverfahren.
Die zugehörige Arbeit wurde in der Fachzeitschrift für maschinelles Lernen Transactions on Machine Learning Research (TMLR) angenommen.
Forschungshintergrund: Neben der Semantik der Aufgabe gibt es noch den Lösungsprozess
Die Bestimmung des Schwierigkeitsgrads neuer Aufgaben ist die grundlegende Arbeit für die Erstellung von Prüfungsbögen und Aufgabendatenbanken. Herkömmliche pädagogische Messungen stützen sich auf die Kalibrierung von Daten aus der Bearbeitung durch Prüflinge, die zuverlässig sind, aber hohe Kosten für Vortests verursachen; die alleinige Analyse der Semantik der Aufgabenstellung macht es schwer zu erkennen, an welcher Stelle des Lösungsprozesses der Aufwand besonders hoch ist.
Epi2Diff erweitert das Beobachtungsfenster auf den Lösungsprozess: Wie lange hat das Modell abgeleitet, hat es eher analysiert oder ausgeführt, hat es die Strategie wiederholt gewechselt? Diese statistisch erfassbaren Verhaltensweisen liefern neue Prozesssignale für die Vorhersage des Schwierigkeitsgrads.
△
Es ist hervorzuheben, dass die Forschung den menschlichen Schwierigkeitsgrad von Aufgaben vorhersagen soll. Die Modellverläufe sind skalierbar verfügbare Proxy-Beweise, die letztendlich durch vorhandene menschliche Schwierigkeitskennzeichnungen überwacht werden und keine direkte Messung der menschlichen Kognition darstellen.
Methodenentwurf: Umwandlung von Inferenzverläufen in strukturierte Merkmale
Acht Arten kognitiver Segmente: Was macht das Modell?
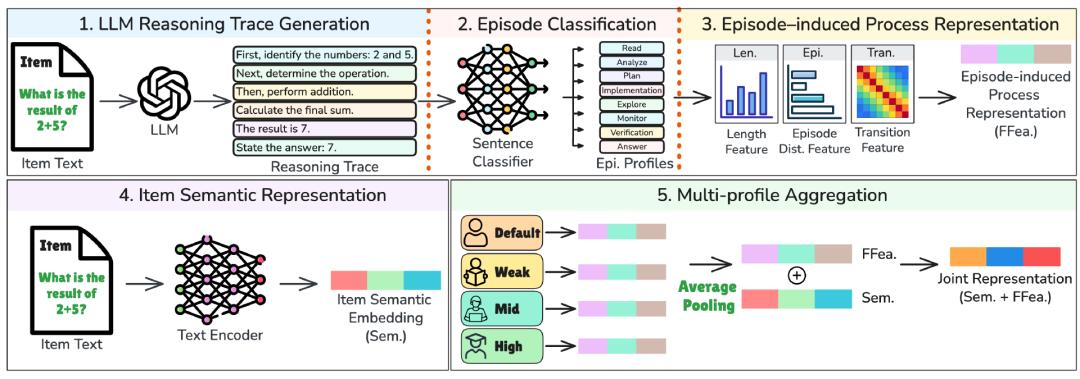
Ein Inferenzverlauf umfasst oft verschiedene Aktivitäten wie das Verstehen der Aufgabenstellung, die Entwicklung einer Strategie, die Durchführung von Berechnungen und die Überprüfung der Antwort. Die Forschung lehnt sich an die Theorie der Lösungsegmente von Schoenfeld und die Erweiterung von ThinkARM an und weist die Sätze im Verlauf nacheinander acht Kategorien zu: Lesen, Analysieren, Planen, Ausführen, Erkunden, Überprüfen, Überwachen und Antworten.
Diese „Segmente“ sind Funktionskennzeichnungen für Sätze, kein fester achtstufiger Lösungsprozess. Der auf RoBERTa basierende Klassifikator erreicht auf dem von Menschen annotierten Testsatz für mathematische Inferenzen mit 7067 Sätzen von ThinkARM eine Genauigkeit von 79,9 % und einen makro-gemittelten F1-Wert von 0,761; die Genauigkeit der ergänzenden Annotierungsbewertung im Zielbereich liegt zwischen 62,9 % und 74,2 %, was darauf hinweist, dass die domänenübergreifende automatische Klassifizierung noch Fehler aufweist.
83-dimensionale Prozessmerkmale: Wie löst das Modell die Aufgabe?
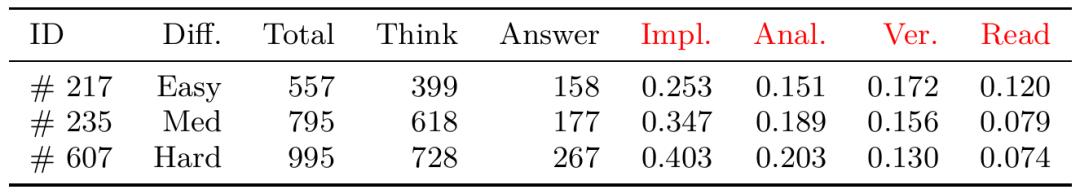
Epi2Diff extrahiert weiter 83 dimensionale Merkmale aus dem Verlauf: 3 Längenstatistiken, die Anzahl der Token der 8 Segmente, der Anteil der Token der 8 Segmente sowie 64 Arten von Übergangshäufigkeiten zwischen benachbarten Segmenten, die jeweils beschreiben, „wie viel Aufwand investiert wird“, „wo der Aufwand liegt“ und „wie der Prozess abläuft“.
Zum Beispiel haben zwei Verläufe eine ähnliche Länge und einen ähnlichen Anteil an Analyse und Ausführung, aber einer konzentriert sich zuerst auf die Analyse und führt dann kontinuierlich aus, während der andere häufig zwischen Analyse und Ausführung wechselt. Die Übergangsmerkmale behalten diese Reihenfolgenunterschiede bei.
△
In den Experimenten werden über QwQ-32B und Qwen3-32B Verläufe unter direkter Antwortbedingung und unter Hinweisbedingungen generiert, die als „schwach, mittel, stark“ markiert sind, anschließend wird der Durchschnitt der Merkmale gebildet. Diese Hinweise dienen dazu, verschiedene Lösungspfade zu induzieren und stellen keine überprüften Fähigkeitsstufen von Schülern dar.
Schließlich werden die Prozessmerkmale mit den semantischen Vektoren der Aufgaben, die von Sentence-BERT erzeugt werden, verbunden, um den Schwierigkeitsgrad über ein überwachtes Modell vorherzusagen. Nach der Auswahl über das Validierungsset wird für alle vier Datensätze XGBoost als Prädiktor verwendet.
Experimentelle Ergebnisse: Vier Arten realer Bewertungsaufgaben
Klassifizierungs- und Regressionsleistung
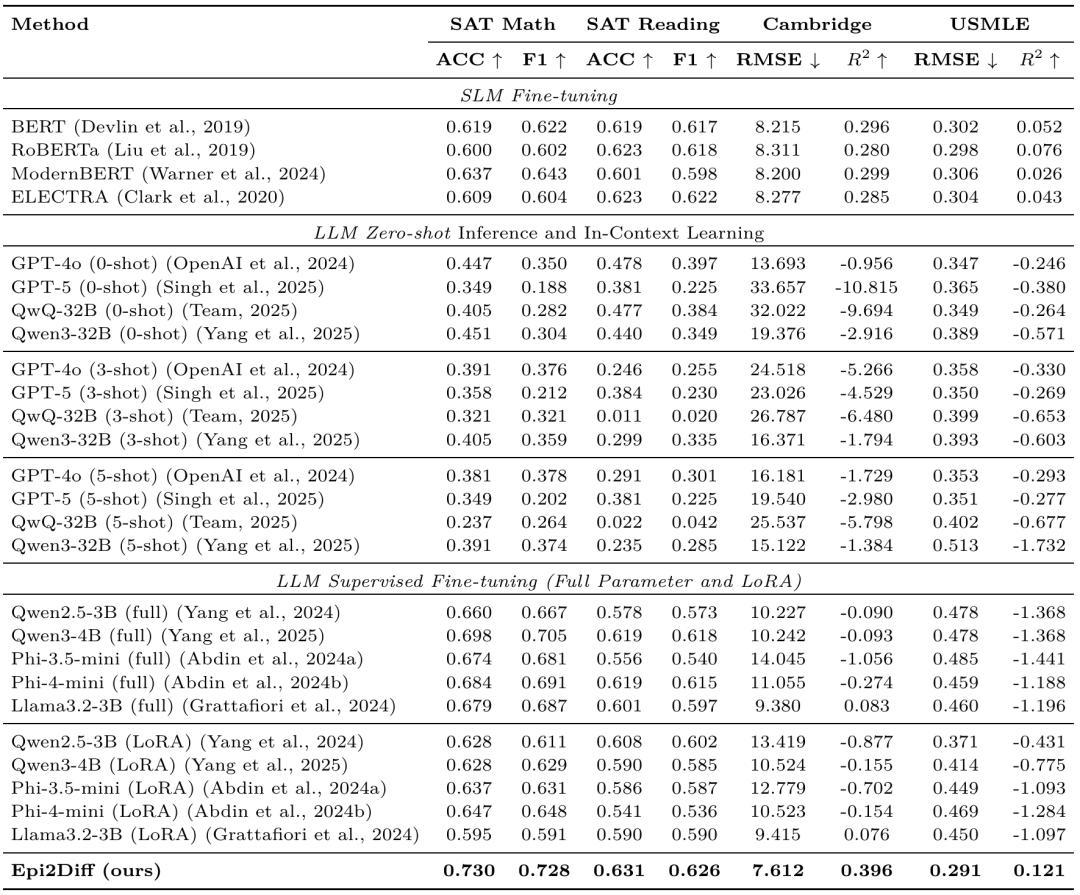
Die Bewertung umfasst 1075 SAT-Mathematikaufgaben, 1338 SAT-Lese- und Schreibaufgaben, 793 Cambridge-Englisch-Leseaufgaben und 667 USMLE-Medizinaufgaben. Die beiden SAT-Aufgaben sagen die drei Kategorien „einfach, mittel, schwierig“ voraus; die anderen beiden sagen kontinuierliche Schwierigkeitswerte voraus. Die Basisverfahren decken die Feinabstimmung kleiner Modelle wie BERT, Null-/Wenigsample-Hinweise für große Sprachmodelle sowie die Feinabstimmung mit allen Parametern und LoRA ab.
△
Die Genauigkeit für SAT-Mathematik steigt von 69,8 % beim stärksten Basisverfahren auf 73,0 %, der makro-gemittelte F1-Wert von 0,705 auf 0,728. Die Verbesserung bei SAT-Lesen und -Schreiben ist geringer: Die Genauigkeit steigt von 62,3 % auf 63,1 %, der makro-gemittelte F1-Wert von 0,622 auf 0,626.
Bei den Regressionsaufgaben sinkt der RMSE für Cambridge von 8,200 auf 7,612, für USMLE von 0,298 auf 0,291; die entsprechenden R²-Werte steigen von 0,299 auf 0,396 bzw. von 0,076 auf 0,121.
Wiederholungsexperimente und Ergebnisgrenzen
In den ergänzenden fünf Durchläufen ist die durchschnittliche Genauigkeit und der makro-gemittelte F1-Wert bei den beiden SAT-Aufgaben nach wie vor am höchsten für Epi2Diff. Allerdings ist der Vorsprung bei der Lese- und Schreibaufgabe kleiner als die Schwankungen zwischen den Durchläufen, sodass der Vorteil vorsichtig interpretiert werden sollte. Bei den Wiederholungsexperimenten wurden die Verläufe und die Segmentmerkmale festgelegt, nur der Zufallsstartwert des nachgeschalteten Prädiktors wurde geändert.
Ablationsanalyse: Nicht je länger die Inferenz, desto schwieriger ist die Aufgabe
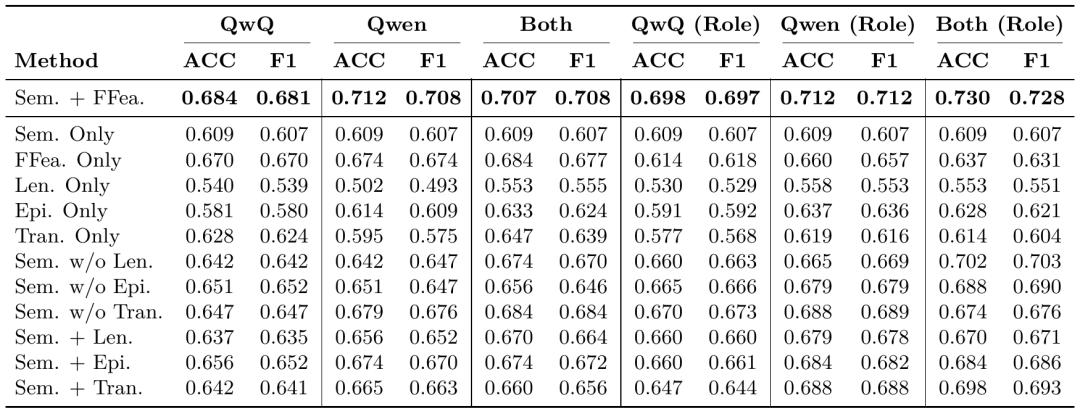
Die Ablationsergebnisse für SAT-Mathematik zeigen, dass die Leistungssteigerung nicht nur von der Länge des Verlaufs stammt. Bei ausschließlicher Verwendung der Aufgabensemantik beträgt der makro-gemittelte F1-Wert 0,607; nach Hinzufügen des Längenmerkmals 0,671; bei Verwendung der vollständigen Darstellung erreicht er 0,728. Selbst wenn andere Merkmale beibehalten werden, sinkt der Wert auf 0,676, wenn die Informationen zu den Segmentübergängen entfernt werden.
△
Weitere Experimente mit zufällig vertauschter Reihenfolge behalten die Verlaufslänge und die Segmenthäufigkeit bei und ändern nur die Anordnung der mittleren Inferenzsätze und ihrer Kennzeichnungen. Die ursprüngliche Reihenfolge erzielt bessere Ergebnisse, was unterstützt, dass die Reihenfolge der lokalen Übergänge vorhersage relevante Informationen enthält.
Bei SAT-Mathematik gehen schwierigere Aufgaben zudem mit mehr zwischengeschalteten Ableitungen, höherem Ausführungsaufwand und deutlicheren Übergangssignalen von „Analyse → Ausführung“, „Ausführung → Ausführung“ und „Ausführung → Analyse“ einher. Diese Muster lassen sich jedoch nur begrenzt in anderen Domänen reproduzieren, es handelt sich um Prozesszusammenhänge, die nicht als direkte Beobachtung der menschlichen Kognition oder als kausaler Beweis angesehen werden dürfen.
Anwendungswert: Interpretierbare Hinweise für den Aufbau von Aufgabendatenbanken
Epi2Diff versucht, „wie die Aufgabe gelöst wird“ in vergleichbare Merkmale umzuwandeln, um unterstützende Hinweise für die Vorabschätzung des Schwierigkeitsgrads neuer Aufgaben und die manuelle Aufgabenprüfung zu liefern. In der praktischen Nutzung sind weiterhin Trainingsdaten mit Kennzeichnungen, Validierung durch die Zielgruppe und Überprüfung durch Experten erforderlich. Sein Wert besteht nicht darin, pädagogische Messungen zu ersetzen, sondern eine Gruppe von Beweisen aus dem Inferenzprozess für die Bestimmung des Aufgabenschwierigkeitsgrads hinzuzufügen.
Titel der Arbeit: Cognitive Episodes in LLM Reasoning Traces Enable Interpretable Human Item Difficulty Prediction
Autoren: Chenguang Wang*, Ming Li*, Xinyue Zeng, Zhuochun Li, Hong Jiao, Tianyi Zhou, Dawei Zhou (* gemeinsame Erstautoren)
Link zur Arbeit: https://arxiv.org/abs/2606.28186
Projektcode: https://github.com/c-steve-wang/Epi2Diff
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „QbitAI“, Autor: Das Epi2Diff-Team, veröffentlicht mit Genehmigung von 36Kr.