Der 66-jährige Yann LeCun veröffentlicht eine neue Forschungsarbeit, die das Scaling Law herausfordert: Ein Modell mit 109 Millionen Parametern übertrifft jenes mit 72 Milliarden Parametern, und größere Modelle verstehen die Welt nicht zwangsläufig besser.
Der 66-jährige Yann LeCun kehrt mit einem neuen Papier an die Spitze der KI-Forschung zurück.
Diesmal richtet er seine Kritik an einer tief verwurzelten Vorstellung in der Großmodellbranche: Um KI ein besseres Verständnis der Welt zu vermitteln, müssen ständig Parameter hinzugefügt und Trainingsdaten erweitert werden.
Am 29. Oktober veröffentlichten LeCun und Randall Balestriero, Assistenzprofessor für Informatik an der Brown University, gemeinsam ein neues 37-seitiges Papier mit dem Titel „Proving and Improving the Platonic Representation Hypothesis with JEPAs“. Das Papier stellt die These auf, dass unter bestimmten Bedingungen KI-Modelle verschiedener Modalitäten auch bei unabhängigem Training gegeneinander ausrichtbare Weltrepräsentationen erlernen können.
Noch auffälliger ist eine Reihe von Zahlen: Ein von dem Forschungsteam trainiertes Text-JEPA mit nur 109 Millionen Parametern übertraf in Tests zur modalitätsübergreifenden Repräsentationsausrichtung große Sprachmodelle wie Qwen2.5-72B und Llama-3-70B.
Der Parameterumfang unterscheidet sich um etwa das 660-fache.
In einem weiteren Experiment erreichte das Modell mit der neuen Methode bereits mit 21,6 Millionen Trainingsstichproben das Niveau der Repräsentationsausrichtung, das ein Nächstes-Token-Vorhersagemodell mit 900 Millionen Stichproben erzielt. Die Anzahl der Stichproben unterscheidet sich um etwa das 42-fache.
Diese Ergebnisse lassen leicht eine Frage aufkommen: Hat die KI-Branche in den letzten Jahren mit den enormen Investitionen in das Training immer größerer Modelle den falschen Weg eingeschlagen?
Aber das ist nicht die Schlussfolgerung, die das Papier eigentlich vermitteln möchte.
LeCuns neues Papier stellt die „Nur-Größe-zählt“-These infrage: Warum können 109 Millionen Parameter 72 Milliarden herausfordern?
In diesem Papier wollen die Autoren LeCun und Balestriero eine grundlegendere Frage beantworten als die nach der Modellgröße: Was bestimmt eigentlich, ob KI, wenn sie die Welt auf unterschiedliche Weise über Text, Bilder und andere Kanäle beobachtet, ein ähnliches internes Verständnis entwickeln kann?
Für LeCun, der seit langem die Weltmodell-Route vertritt, ist dies auch eine wichtige theoretische Erkundung.
Der Ausgangspunkt dieser Forschung stammt von einer vor zwei Jahren vom Forschungsteam des Massachusetts Institute of Technology vorgestellten, recht philosophisch angelegten Hypothese.
Im Jahr 2024 veröffentlichten Minyoung Huh, Brian Cheung, Tongzhou Wang und Phillip Isola auf der ICML das Papier „The Platonic Representation Hypothesis“.
Die Forscher beobachteten ein interessantes Phänomen: Mit zunehmender Fähigkeit verschiedener Modelle scheinen sich die internen Repräsentationsstrukturen von Bildmodellen und Sprachmodellen immer stärker zu ähneln.
Beispielsweise kann man eine Szene, in der eine Katze auf einem Sofa liegt, mit einem Foto beschreiben oder die gleiche Bedeutung mit einem Text ausdrücken. Bilder bestehen aus Pixeln, Text aus Tokens – beide sehen völlig unterschiedlich aus, beziehen sich aber auf dasselbe reale Objekt. Wenn KI tatsächlich eine gemeinsame Struktur hinter diesen Inhalten erlernt, können sich die Darstellungen der Beziehungen zwischen Dingen in verschiedenen Modellen allmählich angleichen.
Das ist der Kern der „Platonischen Repräsentationshypothese“: Verschiedene KI-Modelle tendieren möglicherweise zu einer gemeinsamen statistischen Repräsentation der realen Welt.
Die Studie von 2024 beobachtete, dass eine Vergrößerung des Modellumfangs oft mit einer Angleichung der modalitätsübergreifenden Repräsentationen einhergeht, aber sie hat nicht bewiesen, dass dieses Phänomen zwangsläufig auftritt, und auch nicht erklärt, welche Trainingsmethoden es effizienter erreichen können.
LeCun und Balestriero versuchen, einen Schritt weiterzugehen. Sie erstellen im Papier einen mathematischen Rahmen, in dem verschiedene Modalitäten als Beobachtungen desselben zugrunde liegenden Weltzustands betrachtet werden, und untersuchen, unter welchen Bedingungen Modelle gegeneinander ausrichtbare Darstellungen erlernen können.
Die Antwort hängt mit den im Trainingsprozess konstruierten positiven Stichprobenpaaren zusammen.
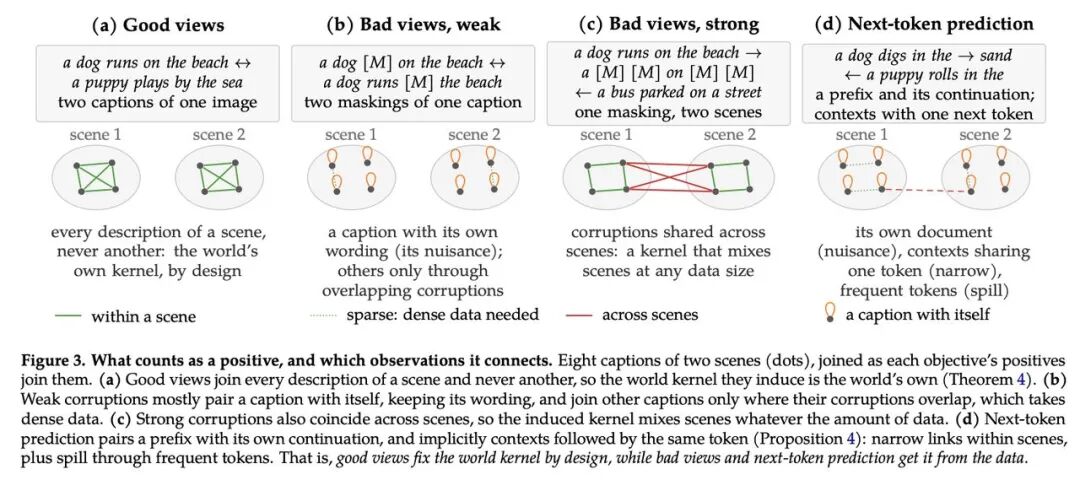
Die Forscher bezeichnen eine Datenbeziehung als Good Views, was als gültige Beobachtung derselben Szene verstanden werden kann.
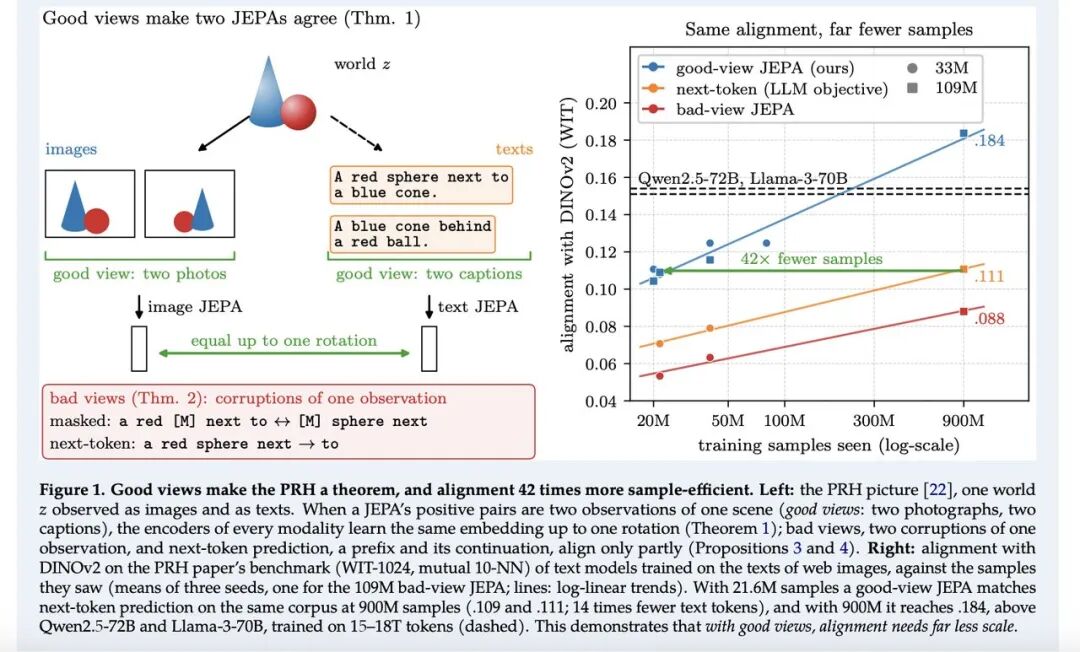
Beispielsweise zeigen zwei Fotos derselben Szene oder zwei Texte, die jeweils dieselbe Szene beschreiben, obwohl ihre konkreten Inhalte nicht völlig identisch sind, gemeinsam auf einen bestimmten Zustand in der realen Welt. Im Gegensatz dazu beschreibt das Papier eine andere Konstruktionsmethode für Trainingsstichproben als Bad Views: beispielsweise das Präfix und der nachfolgende Inhalt desselben Textabschnitts oder verschiedene Segmente, die durch Verdecken derselben Eingabe gewonnen werden.
Der Unterschied zwischen beiden besteht darin, dass erstere dem Modell dabei hilft, die gemeinsamen Informationen hinter verschiedenen Beobachtungen zu extrahieren; letztere kann das Modell dazu veranlassen, mehr Repräsentationskapazität für die Verarbeitung modalitätsspezifischer Details zu verwenden.
Das Papier stellt die These auf: Wenn verschiedene JEPA-Modelle durch positive Stichprobenbeziehungen trainiert werden, die bestimmten Bedingungen entsprechen, können sie auch dann, wenn sie unterschiedliche Modalitäten verarbeiten, Repräsentationsräume erlernen, die sich nur um eine Rotationstransformation unterscheiden.
Die sogenannte „Rotation“ bedeutet nicht, die Bildausrichtung zu ändern, sondern eine mathematische Transformation der hochdimensionalen Vektoren im Inneren des Modells durchzuführen, damit die Darstellungen verschiedener Modelle zueinander passen. Dies ist ein mathematisches Ergebnis mit klaren Voraussetzungen, kein Beweis dafür, dass alle vorhandenen KI-Modelle bereits ein völlig identisches Weltverständnis haben.
Anschließend überprüft das Forschungsteam diese Theorie durch Experimente. Das Papier vergleicht Textmodelle und visuelle Modelle mit unterschiedlichen Trainingsstrategien und untersucht dabei vor allem, wie ähnlich ihre internen Repräsentationsstrukturen sind. Die Ergebnisse zeigen, dass das mit Good Views trainierte Text-JEPA eine herausragende Leistung bei der modalitätsübergreifenden Repräsentationsausrichtung zeigt.
Der spezifische im Papier angegebene Indikator für die modalitätsübergreifende Repräsentationsausrichtung: Je höher die Punktzahl, desto ähnlicher sind die Repräsentationsstrukturen der Modelle – es handelt sich nicht um eine Punktzahl für die Gesamtleistung von Sprachmodellen.
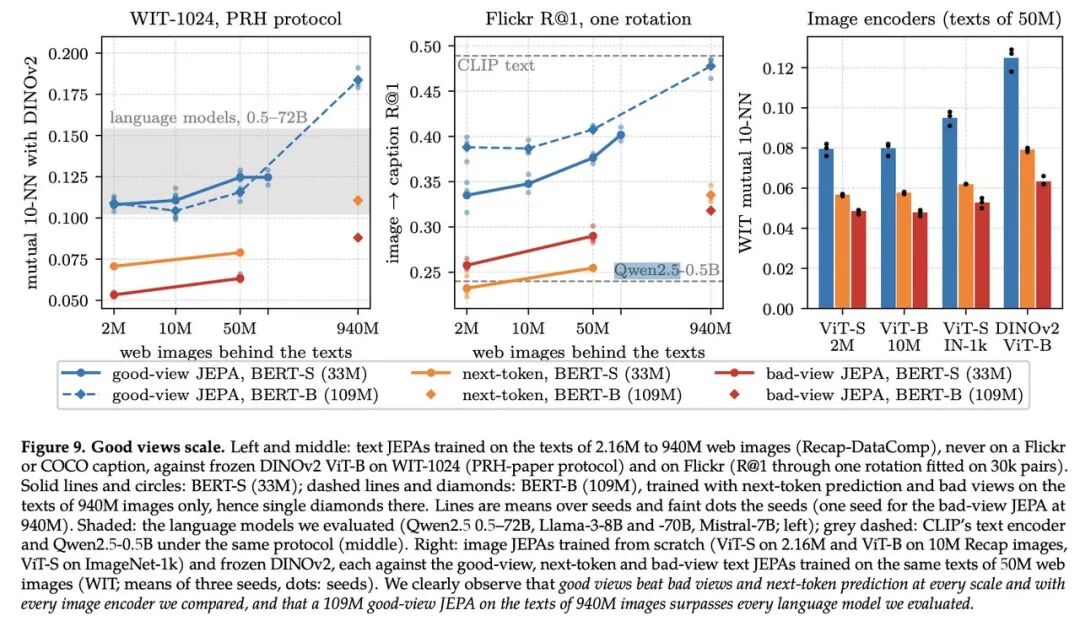
Dabei erreichte das Text-JEPA mit 109 Millionen Parametern eine Punktzahl von 0,184, höher als die 0,154 von Qwen2.5-72B. Das bedeutet, dass bei diesem Test ein kleines Modell mit nur etwa einem Sechshundertstel der Parameteranzahl eines großen Sprachmodells eine Repräsentationsstruktur erlernt hat, die dem visuellen Modell näher kommt.
Es ist aber zu beachten, dass dieses „Übertreffen“ strenge Grenzen hat. Es bedeutet nicht, dass die Fähigkeiten von JEPA in mathematischer Schlussfolgerung, Codegenerierung oder Wissensabfrage die von Qwen2.5-72B übertreffen. Das Papier vergleicht die modalitätsübergreifende Repräsentationsausrichtung, nicht die allgemeinen Fähigkeiten von Großmodellen, die Entwickler kennen.
Ein weiteres wichtiges Experiment bezieht sich auf die Trainingseffizienz.
Die Forscher stellten fest, dass unter demselben Korpus und denselben Vergleichseinstellungen das Good Views-Trainingsschema mit etwa 21,6 Millionen Stichproben das Niveau der Repräsentationsausrichtung erreichen kann, das die Nächstes-Token-Vorhersage mit 900 Millionen Stichproben erzielt.
Berechnet nach der Anzahl der Stichproben steigt die Effizienz um etwa das 42-fache; berechnet nach der tatsächlichen Anzahl der gelesenen Text-Tokens liegt der Unterschied bei etwa dem 14-fachen.
Das zeigt: Welche Informationsbeziehungen das Modell während des Trainings erlernen soll, ist möglicherweise wichtiger, als es einfach mehr Text verarbeiten zu lassen. Noch interessanter ist, dass das Forschungsteam versucht hat, diese Fähigkeit zur Repräsentationsausrichtung in praktische Anwendungen umzuwandeln.
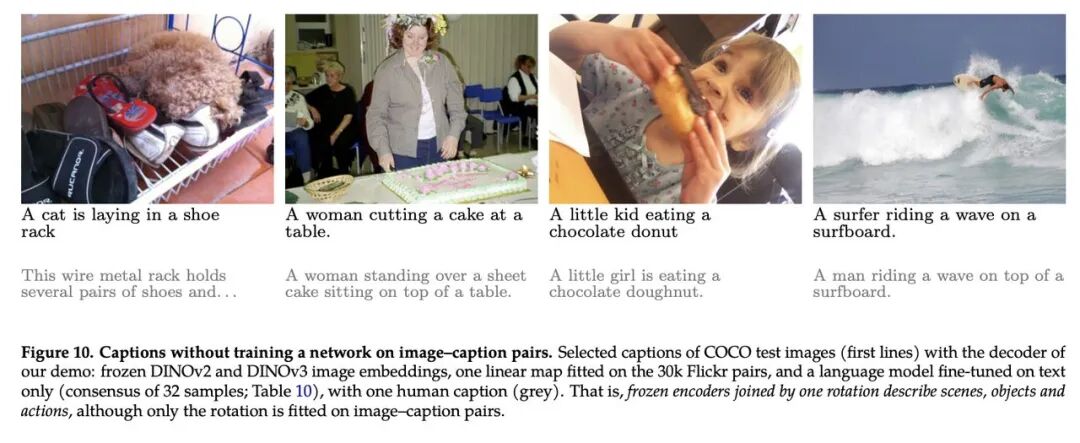
Sie verbinden das separat trainierte visuelle Encoder und das Textmodell durch eine lineare Transformation, um ein Bildbeschreibungssystem aufzubauen. Auf dem COCO-Datensatz erzielte das System eine CIDEr-Punktzahl von 0,838. In einem weiteren Experiment, das keine paarweisen Bild- und Textdaten zur Anpassung der Ausrichtungstransformation benötigt, erreichte das Modell eine Top-5-Klassifizierungsgenauigkeit von 64 % auf ImageNet-100 und übertraf damit einige der im Papier verglichenen Sprachmodell-Lösungen. Dadurch bleiben die Forschungsergebnisse nicht auf mathematische Beweise beschränkt, sondern zeigen auch den praktischen Anwendungsraum, den die modalitätsübergreifende Repräsentationsausrichtung eröffnen kann.
Mit 66 Jahren verlässt er Meta, um ein Startup zu gründen – Warum hält LeCun immer noch an JEPA fest?
Hinter diesem Papier steht eigentlich die Fortsetzung von LeCuns eigener Forschungsgeschichte.
LeCun wurde am 8. Juli 1960 in Frankreich geboren und ist dieses Jahr 66 Jahre alt. Er war ehemaliger Chef-KI-Wissenschaftler bei Meta und einer der Pioniere der Forschung zu Faltungsneuronalen Netzen. Zusammen mit Geoffrey Hinton und Yoshua Bengio erhielt er 2018 den ACM Turing Award.
In der heutigen Großmodellbranche ist LeCun eine recht besondere Persönlichkeit. Er ist nicht nur einer der wichtigen Begründer der Deep-Learning-Welle, sondern auch ein Forscher, der seit langem Vorbehalte gegen die derzeitige Hauptrichtung großer Sprachmodelle hegt.
Bereits in den 1980er Jahren begann LeCun, die Anwendung neuronaler Netze in der Computervision zu erforschen. Er trieb die Entwicklung von Faltungsneuronalen Netzen voran, sodass Maschinen handschriftliche Zeichen und Bildinhalte effektiver erkennen können. Später wurden diese Forschungen zu einer wichtigen Grundlage für die moderne Computervision und das Deep Learning.
2013 trat LeCun Facebook bei und beteiligte sich an der Gründung von FAIR (Facebook AI Research). Danach arbeitete er etwa 12 Jahre lang bei Meta, nacheinander als Gründungsleiter von FAIR und Chef-KI-Wissenschaftler. Mit dem Boom großer Sprachmodelle, der durch ChatGPT ausgelöst wurde, wurden die Unterschiede zwischen LeCun und der technischen Hauptrichtung der Branche immer deutlicher.
Er leugnet nicht den praktischen Nutzen von LLM, betont aber wiederholt: Die bloße Vorhersage des nächsten Tokens reicht nicht aus, um intelligente Systeme zu bauen, die die physische Welt verstehen, Umweltzustände merken und komplexe Handlungen schlussfolgern und planen können. In seiner Vorstellung soll die zukünftige KI nicht nur Sprache und Wissen aus riesigen Textmengen lernen, sondern wie Menschen und Tiere durch Beobachten der Umgebung die abstrakte Struktur der Welt erlernen.
Das ist auch der Grund, warum er seit Jahren JEPA (Joint-Embedding Predictive Architecture, gemeinsame Einbettungsvorhersagearchitektur) vorantreibt. Anders als Trainingsmethoden, die das Modell dazu zwingen, Eingabedetails zu rekonstruieren, konzentriert sich JEPA stärker auf das Erlernen abstrakter Repräsentationen und die Durchführung von Vorhersagen im Repräsentationsraum.
Im November 2025 kündigte LeCun öffentlich an, Meta verlassen zu wollen, um ein neues KI-Forschungsunternehmen zu gründen und das Forschungsprogramm für fortgeschrittene maschinelle Intelligenz (Advanced Machine Intelligence, AMI) weiter voranzutreiben. Er sagte damals ausdrücklich, dass das Ziel des neuen Unternehmens darin bestehe, den nächsten KI-Durchbruch voranzutreiben: Systeme zu bauen, die die physische Welt verstehen, über dauerhafte Erinnerung verfügen und die Fähigkeit zu Schlussfolgerungen und komplexer Handlungsplanung besitzen.
Im März 2026 schloss AMI Labs eine Finanzierungsrunde von etwa 1 Milliarde US-Dollar ab. Im Gegensatz zu einer großen Anzahl von Startups, die sich auf die Produktentwicklung rund um vorhandene LLM konzentrieren, nimmt AMI Labs Weltmodelle als zentrales Forschungsrichtung.
Dieser Hintergrund verleiht dem aktuellen Papier eine zusätzliche Bedeutung.
Nachdem er den Turing Award erhalten und über ein Jahrzehnt Forschungserfahrung in großen Technologieunternehmen gesammelt hat, hat er sich nicht dafür entschieden, sich aus der Öffentlichkeit zurückzuziehen, sondern die vertraute Forschungsplattform verlassen, um an der Gründung eines neuen Unternehmens mitzuwirken und eine technische Route weiter voranzutreiben, die noch nicht bewiesen hat, dass sie die vorherrschenden LLM ersetzen kann.
Darin liegt eine bemerkenswerte wissenschaftliche Beharrlichkeit: In einer Branche, die zunehmend Wert auf Modellgröße, Kapitalinvestitionen und die Geschwindigkeit der Produktveröffentlichung