Warum kann der intelligenteste Code-Assistent deine Nachrichten nicht sofort beantworten?
Viele Ingenieure, die KI in ihre tägliche Forschungs- und Entwicklungsarbeit integrieren, haben eine ähnliche frustrierende Erfahrung gemacht: Sie haben gerade einen Prompt eingegeben, stehen auf, um ein Glas Wasser zu holen, und stellen bei der Rückkehr fest, dass der Prozess im Terminal längst auf halbem Weg stecken geblieben ist. Der Cursor steht einsam auf dem Bildschirm und wartet darauf, dass Sie manuell die Eingabetaste zur Bestätigung drücken.
In der vergangenen Zeit haben alle Arten von Programmierassistenten auf dem Markt in ihrer Werbung betont, wie schnell die Generierung ist: Tippen Sie eine Zeile natürlicher Sprache ein, und das große Modell gibt sofort Hunderte von Codezeilen aus, und alle Testfälle im Terminal sind grün. In echten Softwareteams verwandelt sich diese scheinbar beeindruckende sofortige Rückmeldung jedoch in einen hochfrequenten Energieverbrauchskampf.
Jedes Mal, wenn der Agent eine Datei liest, eine Zeile der Konfiguration ändert oder einen Befehl ausführt, muss er auftauchen, um um Genehmigung zu bitten. Nachdem Sie den Geschäftshintergrund im Gruppenchat klar erläutert haben, gehen Sie zum Code-Review-Tool, um Änderungen vorzuschlagen, und müssen den gesamten Kontext erneut übertragen.
Sobald die Aufgabe die Fehlerbehebung über mehrere Module oder die Abhängigkeitsumstrukturierung betrifft, wird das Sitzungsfenster schnell durch Dutzende von Kontextrunden überlastet, und bei der geringsten Unachtsamkeit gibt das Modell irrelevante Antworten.
Diese peinliche Situation wurde in einem Architekturplan eines der führenden technischen Teams im Land offen gelegt.
Am Abend des 31. Oktober 2026 veröffentlichte das DeepSeek Harness-Team einen langen technischen Artikel mit dem Titel „Erkundung des Super-Agent-Designs: Auf dem Weg zu einem autonomeren Agent-System“ im offiziellen WeChat-Konto, in dem ein Forschungsprototyp-Design für die Software-Engineering systematisch erläutert wird.
Laut der Offenlegung des offiziellen langen Artikels hat das Team am Anfang nicht übermäßig dargestellt, wie schnell der Code des großen Modells laufen kann, sondern hat direkt einen Kernprinzip hervorgehoben: die Aufmerksamkeit des Menschen so wenig wie möglich zu beanspruchen und so viel Wert wie möglich zu liefern.
Dieser lange technische Artikel weist direkt auf die peinlichste Engstelle der aktuellen KI-Programmierung hin: Da die einzelne Generierungsfähigkeit des zugrunde liegenden Modells immer stärker wird, hat sich die Engstelle, die das Ausgabevolumen begrenzt, längst geändert. Was das Team tatsächlich blockiert, ist die Aufmerksamkeitsgrenze menschlicher Entwickler.
Den Agenten zu zwingen, im Chat-Fenster sofort zu antworten und um Genehmigung zu bitten, erschöpft den Menschen oft nur. Ihn in den Hintergrund zu verlegen und zu einem verteilten System zu machen, das sich selbst planen und voneinander isoliert arbeiten kann, ist der richtige Weg, auf dem KI wirklich in das Software-Engineering integriert wird.
01
Je schneller KI Code schreibt, desto beschäftigter werden die Menschen
In der vorhandenen Architektur von Programmieragenten ist das serielle Muster einer einzelnen Sitzung nie kostengünstig, es verbraucht die Energie des Menschen.
Die derzeit gängigen Code-Assistenten, egal ob Befehlszeilentools oder Desktop-Plug-Ins, sind im Grunde an einen einzigen Denk- und Handlungszyklus gebunden.
Dieses kleine Dialogfeld enthält zu viele verschiedene Aufgaben: Es muss die menschliche Sprache verstehen, gleichzeitig Befehle ausführen, um Dateien zu lesen und zu schreiben, und muss den extrem langen Kontext von Dutzenden von Tool-Aufrufen aushalten.
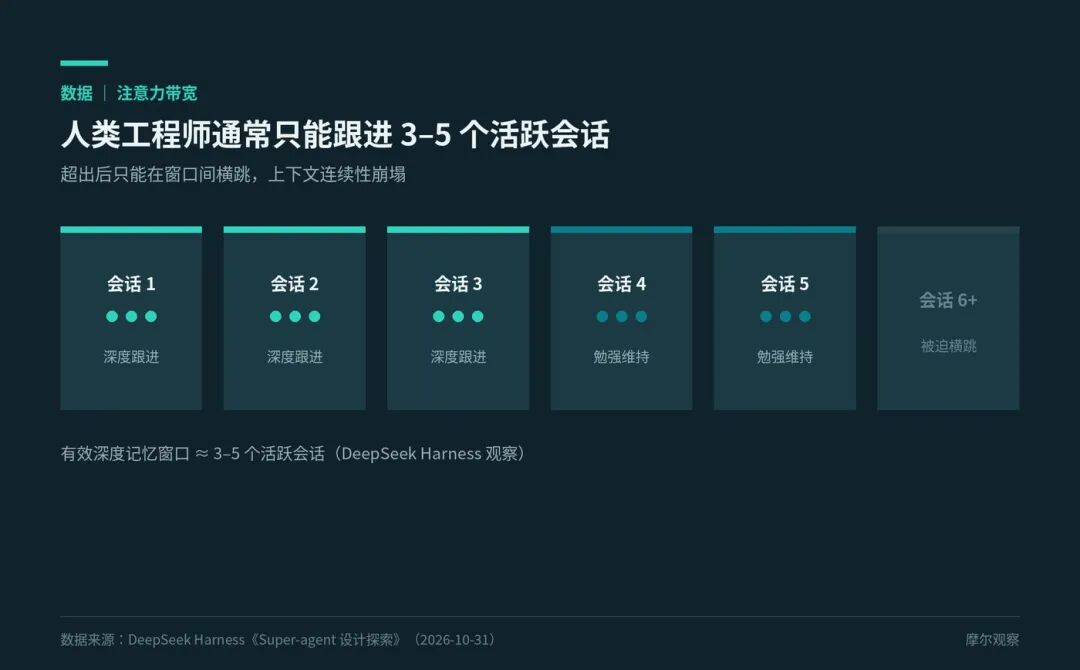
Laut der Beobachtung des DeepSeek Harness-Teams in dem langen Artikel kann ein menschlicher Ingenieur in der tatsächlichen Arbeit normalerweise nur drei bis fünf aktive Sitzungen gleichzeitig behalten, die er tief im Gedächtnis behalten und effektiv verfolgen kann.
Sobald diese Anzahl überschritten wird, kann das menschliche Gehirn die Kontinuität mehrerer Kontexte nicht aufrechterhalten und ist gezwungen, ständig zwischen verschiedenen Chat-Fenstern hin und her zu wechseln.
Ein realistischeres Problem als die Fähigkeit des Modells liegt in der Zusammenarbeitlücke. In echten Forschungs- und Entwicklungsszenarien ist die Kommunikation nie punktuell. Der Produktmanager kann im Instant-Messaging-Gruppenchat eine Anpassung des Plans vorschlagen, der Architekt gibt zwei Zeilen Anmerkungen im Code-Review, und die CI-Pipeline meldet im Hintergrund einen Kompilierungsfehler.
Unter der Architektur einer einzelnen Sitzung sind diese drei Informationen auf verschiedenen Plattformen verteilt, die Agenten sind voneinander getrennt, und das einzige Synchronisationsband ist der überlastete menschliche Entwickler in der Mitte.
Dieses Design macht Entwickler zu billigen Kontext-Übertragungsarbeitern und Genehmigungswerkzeugen für häufige Klickbestätigungen. Das Modell scheint vor dem Bildschirm sofort zu antworten, aber tatsächlich überträgt es die umständlichste Verwaltung des Multitasking-Zustands an den Menschen.
Wenn der größte Teil der Energie des Ingenieurs darauf verwendet wird, die Ausführungsabsicht des Modells vor einigen Minuten zu überprüfen, wird die sogenannte Effizienz zu einer versteckten Energieverschwendung.
02
Den „Planungsbeamten“ und den „Arbeiter“ vollständig trennen
Da der einzelne Zyklus komplexe Aufgaben nicht bewältigen kann, ist die intuitivste technische Lösung, das Teile-und-Herrsche-Prinzip aus modernen Betriebssystemen zu übernehmen.
Der im langen Artikel zerlegte Prototyp-Plan hat den Kern, das System in zwei Ebenen zu unterteilen: Auf der Vorderseite befindet sich dauerhaft ein Router, der für die Gesamtübersicht verantwortlich ist, und auf der Rückseite sind mehrere voneinander unabhängige Worker angeschlossen. Die beiden sind in Bezug auf Verantwortung, Berechtigungen und Modellressourcenkonfiguration klar entkoppelt.
Der Router, der dauerhaft im Gruppenchat oder im Hintergrund des Repositorys ausgeführt wird, dient als Planungszentrum des Systems. Er ist nur dafür verantwortlich, eingehende Ereignisnachrichten zu lesen, die Absicht zu bewerten und Arbeitsaufträge mit strengen Berechtigungsgrenzen zu generieren, die offiziell als Ticket mit Autorisierungsschreiben bezeichnet werden.
Der Router selbst muss nicht einmal zugrunde liegende hochriskante Ausführungswerkzeuge konfigurieren, und für die Ressourcenzuweisung muss nur ein leichtgewichtiges Modell ausgeführt werden. Er berührt keine spezifischen Codeänderungen und nimmt nicht an langwierigen logischen Schlussfolgerungen teil. Das Ziel ist es, den globalen Interaktionskanal offen zu halten, damit er nicht aufgrund einer komplexen Aufgabe in eine Deadlock gerät.
Die Worker, die den harten Knochen kauen, sind die Worker, die automatisch im Hintergrund gestartet werden, nachdem sie das Arbeitsauftrag erhalten haben. Jeder Worker verfügt über eine unabhängige Ausführungssitzung und einen isolierten Arbeitsbereich.
Solange die Umgebung es erlaubt, weist das System dem Worker automatisch einen unabhängigen temporären Git-Arbeitsbaum zu, sodass er in einer sauberen Kopie des Codes beliebig arbeiten kann, und Änderungen an der Konfiguration und Ausführung von Tests wirken sich nicht auf den Hauptzweig aus.
Diese physische Isolierung unterbricht direkt die gegenseitige Verschmutzung zwischen langen Aufgaben.
Die Entwicklung einer neuen Schnittstelle und die Fehlerbehebung im Online-Betrieb können von verschiedenen Workern im Hintergrund parallel vorangetrieben werden. Selbst wenn einer von ihnen aufgrund einer Code-Endlosschleife abstürzt, verschmutzt er nicht den Hauptzweig und verwechselt auch nicht den Hauptkontext des Routers.
Die groben und anstrengenden Aufgaben werden von isolierten Unterknoten im Hintergrund verarbeitet, und der Planungsbeamte liefert die Ergebnisse einheitlich an den Menschen. Nur so erhält die parallele Ausführung von Multitasking eine zuverlässige technische Unterstützung.
03
Lassen Sie nicht alle Informationen das Gehirn stören
Neben der Trennung von Ausführung und Planung ist es der Schlüssel dafür, ob der Agent wirklich in das Team einziehen kann, in dem komplexen Nachrichtenstrom Zurückhaltung zu bewahren.
In der täglichen Kooperationsumgebung entstehen ständig Gruppenchats, Code-Commit-Pipelines und Fehler bei automatisierten Tests. Wenn der Agent wie ein neuer Praktikant ist, der gerne Aufmerksamkeit sucht und zu jeder Nachricht einschreitet, wird die Aufmerksamkeit des gesamten Forschungs- und Entwicklungsteams sofort von Benachrichtigungen überflutet.
DeepSeek hat in seinem Design einen Ereignisfilter- und Direktvermittlungsmechanismus eingeführt, der ähnlich wie traditionelle Netzwerkprotokolle funktioniert. Wenn es viele Nachrichten gibt, blockiert das System zuerst das Geplauder und Störgeräusche mit einigen leichten Code-Regeln. Nur echte Ereignisse, die auf die Whitelist treffen, werden an das große Modell übergeben, um die Absicht zu verstehen.
Für potenzielle Aufgaben, die aus der Diskussion abgeleitet werden, hat das System einen sehr zurückhaltenden Standardmodus in der Berechtigungssteuerung festgelegt. DeepSeek fügt eine strenge Beschränkung für die aktive Übernahme von Aufgaben hinzu: Standardmäßig ist nur der Beobachtungsmodus aktiviert.
Selbst wenn das große Modell sofort erkennt, dass der Code Mängel aufweist und umstrukturiert werden sollte, notiert es diese Aufgabe nur leise im lokalen Protokoll, dass es diese Aufgabe übernehmen könnte. Ohne die Zustimmung des Menschen wagt es nicht, eigenmächtig den Arbeitsauftrag zu übernehmen, um den Code zu ändern.
Ein weiteres sehr praktisches Design im Ingenieurbereich ist das Abonnement-Direktvermittlung. Nachdem ein Worker einen Pull Request übernommen hat, erstellt das System automatisch eine viele-zu-viele-Ereigniszuordnung im Hintergrund.
Alle nachfolgenden Bewertungsmeinungen zu diesem PR werden vom zugrunde liegenden System direkt an den Worker-Prozess übermittelt, der für diese Aufgabe verantwortlich ist, ohne dass sie erneut über den Router weitergeleitet werden müssen.
Laut den von dem DeepSeek Harness-Team veröffentlichten Simulationsdaten ist nach der Beseitigung der wiederholten Störung des Hauptsteuerungskerns die Anzahl der redundanten Entscheidungen des Planungszentrums um etwa 30 % gesunken, und die für das Lesen des Caches erforderlichen Rechenressourcen sind um mehr als ein Drittel reduziert.
Nur wenn die Kommunikationskette im Kontext der tatsächlich arbeitenden Einheiten komprimiert wird, kann das System in der Mehrparteienzusammenarbeit ruhig bleiben.
04
Nur wenn die Kostenrechnung stimmt, kann das System in das Team aufgenommen werden
Wenn der technische Plan von der Einzelmaschinendemonstration zum dauerhaften Einsatz im Team übergeht, hängt die endgültige Bewertung nie davon ab, wie intelligent ein einzelnes Gespräch ist, sondern nur von der Robustheit und Betriebseffizienz des gesamten Systems.
In der blinden Vorstellung vieler Teams scheint der Agent umso besser zu sein, je allmächtiger er ist. Am besten verfügt er über unbegrenztes Gedächtnis und denkt im Hintergrund unaufhörlich autonom. Aber in der realen Rechenbuchhaltung wird dieses Luftschloss jederzeit aufgrund eines kurzen Netzwerkausfalls oder eines Prozessabsturzes zusammenbrechen.
Was DeepSeek in dem langen Artikel zeigt, ist eine typische entzauberte ingenieurstechnische Perspektive. Um die unvermeidlichen Blockaden und Anomalien während des lang andauernden Betriebs zu bewältigen, trennt das System die Zustandsspeicherung vollständig von der Modellberechnung.
Der Autorisierungszustand der Aufgabe, der Fortschritt des Arbeitsauftrags und der Interaktionsverlauf werden alle auf einer lokalen leichtgewichtigen Datenbank gespeichert, und die Ausführungsumgebung ist vollständig containerisiert.
Selbst wenn der lokale Host neu gestartet wird oder der Sitzungsprozess zeitüberschreitet, kann das System durch einen externen unabhängigen Watchdog-Mechanismus wieder aktiviert werden, liest den letzten Schnappschuss aus der Datenbank und fährt mit der Ausführung fort, ohne dass der Mensch den gesamten Kontext erneut eingeben muss.
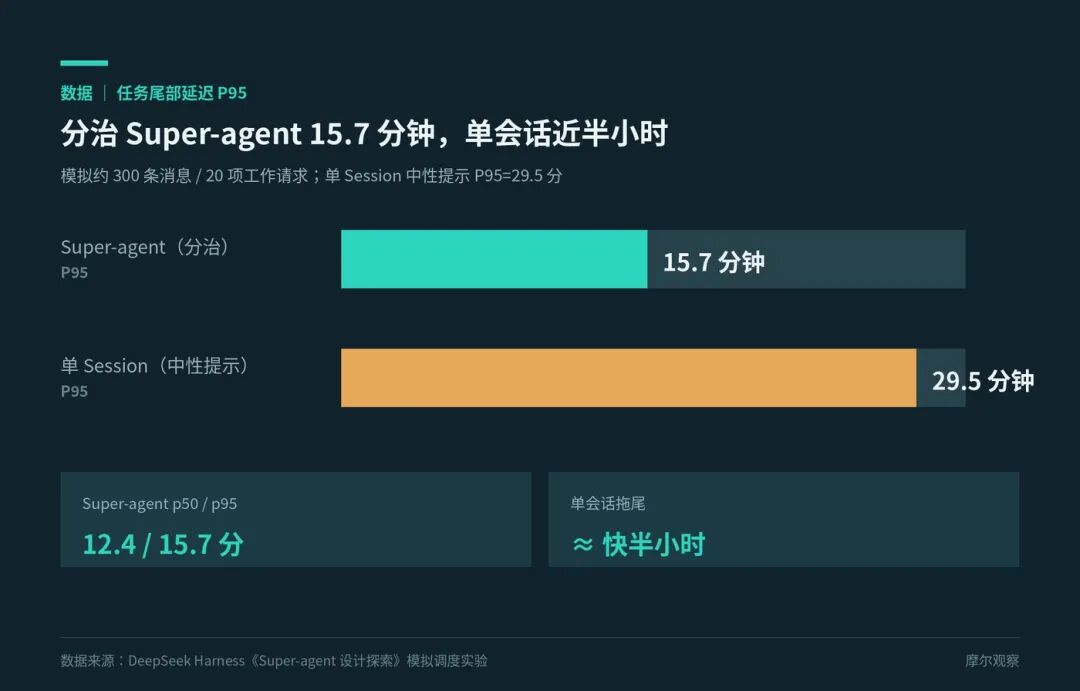
In einem simulierten Planungsexperiment des Teams mit etwa 300 Nachrichten und 20 Arbeitsanforderungen zeigte dieses Teile-und-Herrsche-System einen offensichtlichen technischen Vorteil bei der Aufgabenabschlusszeit. Bei hohem gleichzeitigen Nachrichtenaufkommen wurde die Latenz am Ende des Systems (P95-Aufgabendauer) streng innerhalb von 15,7 Minuten gehalten.
Im Gegensatz dazu wurde bei dem nicht geschichteten Einzel-Sitzungs-Plan, sobald die Parallelität anstieg, die langsamste Aufgabe direkt auf fast eine halbe Stunde verzögert.
Diese systemweite Durchsatzrate ist nicht kostenlos. Die gleichzeitige Ausführung mehrerer Prozesse und die sorgfältige Zustandswartung nutzen im Wesentlichen mehr Modellaufrufe und Cache-Ausgaben, um die Stabilität der gesamten Ausführung und die Befreiung der menschlichen Aufmerksamkeit zu erreichen.
Für das Software-Engineering ist diese zusätzliche Ausgabe an Rechenressourcen in der Buchhaltung des Teams lohnend, solange sie Entwickler aus der endlosen Kontextausrichtung retten kann.
