Mehrere hundert Millionen US-Dollar fließen in die Mathematikforschung, Sam Altman: OpenAI verfügt über weitere bisher nicht veröffentlichte Erkenntnisse.
Gibt es noch unveröffentlichte mathematische Entdeckungen bei OpenAI?
In dem am 29. Oktober veröffentlichten Interview „Cheeky Pint“ enthüllte Altman, dass die Investitionen von OpenAI in die mathematische Forschung auch viele noch nicht veröffentlichte Entdeckungen umfassen.
Der Moderator John Collison fragte nach: Gibt es noch weitere Ergebnisse außer diesen 700 Beweisen?
Altman antwortete:
Ja, natürlich gibt es die.
In den letzten Monaten haben die mathematischen Ergebnisse von OpenAI immer wieder hitzige Diskussionen ausgelöst.
Nach der Veröffentlichung der Ergebnisse begannen die Forscher, die veröffentlichten Materialien zu zerlegen, die darin enthaltenen Ideen zu verstehen und die entscheidenden Schritte der Herleitung zu überprüfen.
Im Bereich der Biologie sind die von KI vorgeschlagenen Lösungen bereits auf den Versuchstisch gelangt.
Das Modell analysiert Daten und erarbeitet Entwürfe, die Forscher wählen die Lösungen aus, führen Experimente durch und geben die experimentellen Ergebnisse an das Modell zurück, um die Entwürfe weiter zu verbessern.
Von der Überprüfung mathematischer Herleitungen bis zur Validierung biologischer Entwürfe verwandeln Menschen und KI die Ergebnisse jeder Runde in den Ausgangspunkt für die nächste Erkundung.
Wichtige Entdeckungen müssen veröffentlicht werden
Was passiert mit den Mathematikern?
Als es um die Investitionen in die mathematische Forschung ging, nannte der Moderator eine Größenordnung von mehreren hundert Millionen Dollar, was Altman bestätigte.
Er fügte jedoch hinzu, dass diese Investition auch andere unveröffentlichte Entdeckungen umfasst.
Was die Art und Weise der Veröffentlichung dieser Ergebnisse betrifft, räumte Altman ein, dass es hier ein Dilemma gibt.
Altman vertritt die Auffassung, dass wichtige Entdeckungen in der Grundlagenwissenschaft veröffentlicht werden sollten.
Altman ist der Ansicht, dass die Menschheit grundlegende wissenschaftliche Erkenntnisse besitzen sollte und wichtige wissenschaftliche Entdeckungen der Welt mitgeteilt werden müssen.
Aber die berufliche Entwicklung und das Erfolgserlebnis der Wissenschaftler stammen zu einem großen Teil von der Entdeckung selbst.
Er hofft, einen Weg zu finden, bei dem die Welt von der Wissensvermittlung profitiert und gleichzeitig die Forscher in diesen Bereichen langfristig dazu angeregt werden, sich auch an zukünftigen wissenschaftlichen Arbeiten zu beteiligen.
Nach der Veröffentlichung der Ergebnisse müssen die Forscher zudem dabei unterstützt werden, die Ideen zu verstehen und die Herleitungen zu überprüfen, damit diese Entdeckungen zur Grundlage nachfolgender Forschungen werden.
Was ergänzen Mathematiker zu den KI-Manuskripten?
Auf GitHub haben Mathematiker das unabhängige Revisionsprojekt oai-math-revised ins Leben gerufen.
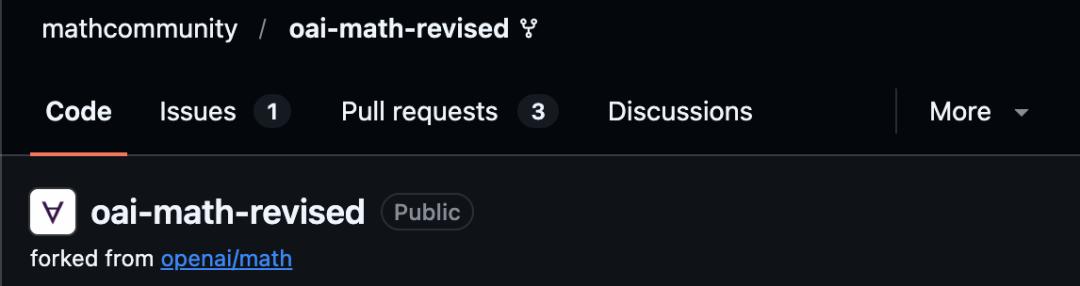
Mathematiker haben das Projekt oai-math-revised gestartet, um gemeinsam die von OpenAI veröffentlichten mathematischen Forschungsmanuskripte zu überarbeiten.
Dieses Projekt zielt auf zwei Schwächen einiger mathematischer Manuskripte von OpenAI ab: schwer verständliche Ausführungen und unvollständige Zitate.
Dazu laden die Projektinitiatoren Studenten, Postdoktoranden, Professoren und Mathematikbegeisterte zur gemeinsamen Teilnahme ein, um Literatur zu ergänzen, die Ausführungen verständlicher zu machen, Fehler zu erkennen und soweit möglich zu korrigieren.
Wenn die KI ein mathematisches Papier vorlegt, muss die wissenschaftliche Gemeinschaft es noch zu Wissen machen, das andere verstehen, überprüfen und nutzen können.
Wie diese Folgearbeiten unterstützt werden können, ist ebenfalls ein Aspekt, der bei der Veröffentlichung von Ergebnissen berücksichtigt werden muss.
OpenAI versucht derzeit, die Art der Veröffentlichung von Ergebnissen anzupassen.
Am 26. Oktober stufte das Unternehmen die an diesem Tag neu veröffentlichten relevanten Forschungsmanuskripte als „rohe Forschungsdaten“ ein und stellte verschiedene Maßnahmen vor, darunter die Einladung externer Experten zur Leitung und die Organisation von Teams zur Erklärung der Ergebnisse.
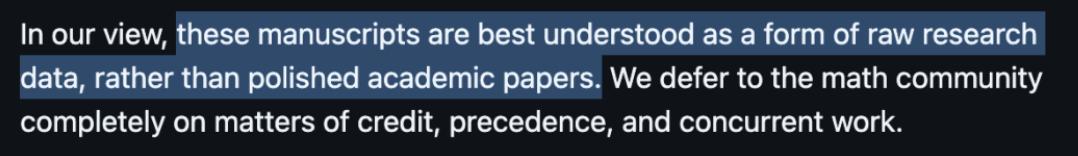
OpenAI stuft diese Manuskripte als „rohe Forschungsdaten“ ein und weist darauf hin, dass sich die relevanten Ergebnisse in unterschiedlichen Validierungsstadien befinden.
Auch das mathematische Repository des Unternehmens macht deutlich, dass sich die relevanten Ergebnisse in unterschiedlichen Validierungsstadien befinden und einige noch keine formalen, computergesteuert überprüfbaren Beweise enthalten.
Nach der Veröffentlichung der Manuskripte werden Erklärung, Überprüfung und Überarbeitung fortgesetzt.
Nur wenn mehr Forscher diese Ergebnisse verstehen und bestätigen, welche Methoden weiterverwendet werden können, können neue Forschungen auf dieser Grundlage durchgeführt werden.
Etwa jeder sechste Beitrag
gibt an, dass große Sprachmodelle verwendet wurden
Im Bereich der Biologie nutzen Forscher große Sprachmodelle zunehmend aktiv in ihrer Arbeit.
Am 30. Oktober veröffentlichte Epoch AI eine Statistik zu biologischen Preprints:
Von den 4922 untersuchten bioRxiv-Preprints im September 2026 gaben 846 an, große Sprachmodelle verwendet zu haben, was einem Anteil von 17,19 % entspricht.
Etwa jeder sechste Beitrag tut dies.
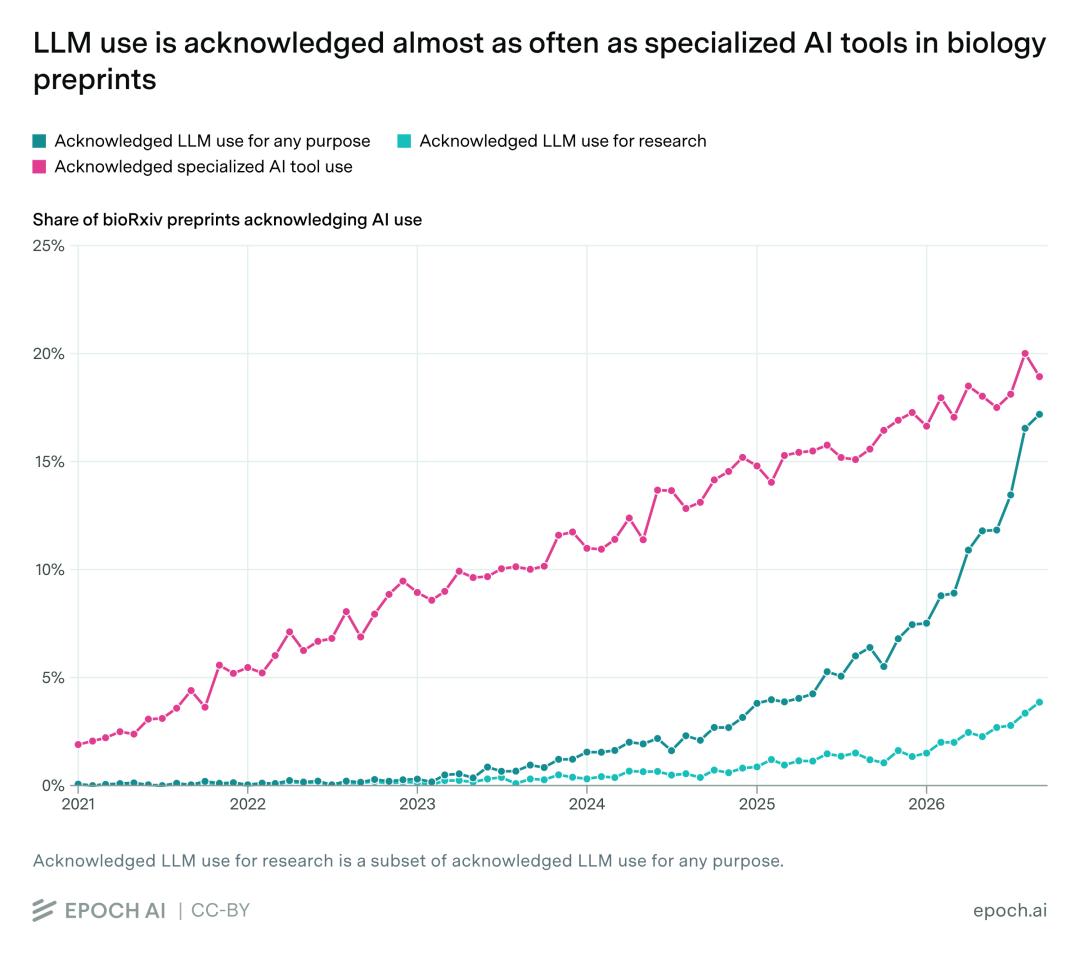
Der Anteil der biologischen Preprints, die die Verwendung großer Sprachmodelle offenlegen, steigt kontinuierlich an. (Quelle: Epoch AI)
Im September 2025 lag dieser Offenlegungsanteil bei 6,40 %. Ein Jahr später nähert er sich bereits dem Anteil von 18,94 % an, der im selben Monat für spezielle KI-Tools verzeichnet wurde.
Diese offengelegten Anwendungsbereiche betreffen Arbeiten wie Literaturrecherche, Schreiben, Programmierung und Forschungsanalyse:
Im selben Monat gaben 190 Preprints an, große Sprachmodelle für Forschung oder Analyse verwendet zu haben, was 3,86 % aller untersuchten Preprints entspricht.
Nach der Klassifizierung von Epoch umfasst dies Versuchsplanung, Datenkennzeichnung und statistische Analyse; Schreiben, Literaturübersichten, Code und Berechnungen werden jeweils anderen Nutzungskategorien zugeordnet.
Diese Statistiken von Epoch zeigen: Große Sprachmodelle sind bereits in mehreren Phasen der wissenschaftlichen Forschung beteiligt.
Im Einzelnen: Welche Aufgaben übernimmt das Modell in einer Studie, und wie beurteilen, überprüfen und nutzen die Forscher seine Ausgaben?
Von der Datenanalyse
bis zur Einbeziehung von Versuchsrückmeldungen
Zwei kürzlich veröffentlichte Kooperationen zeigen, wie Menschen und KI die Forschung schrittweise vorantreiben.
Am 21. Oktober gaben OpenAI, PerturbAI und Scripps Research eine Kooperation bekannt:
Tausende von Agenten, die von GPT-Rosalind angetrieben werden, analysieren getrennt voneinander vorhandene experimentelle Daten von Millionen von Mäusegehirnzellen.
Laut Bericht des Teams dauerte diese Runde der Datenanalyse und -erklärung 32 Minuten.
Jeder Agent analysiert die Zellreaktionen im Zusammenhang mit einer Genstörung, sucht relevante Literatur und erarbeitet dann eine Erklärung.
Diese Analyseergebnisse münden schließlich in einem Inferenzgraphen, der Gene, Zellveränderungen und mögliche biologische Mechanismen miteinander verbindet.
Forscher können diesem Graphen folgen, um Hinweise auszuwählen, die im nächsten Schritt überprüft werden sollen, und weitere Experimente zu entwerfen.
Mit diesen Hinweisen müssen die Experimente anschließend noch Rückmeldungen liefern.
In einer anderen Studie nutzt das Biotechnologieunternehmen Generate Biomedicines KI, um Proteine zu entwerfen und Medikamente zu entwickeln.
Am 27. Oktober veröffentlichte das Team Fortschritte bei der Umgestaltung von CAR-T-Rezeptoren mithilfe von Claude Code: Sie wollten den Teil des Rezeptors, der Signale im Inneren überträgt, verkürzen und gleichzeitig seine Funktionsfähigkeit erhalten.
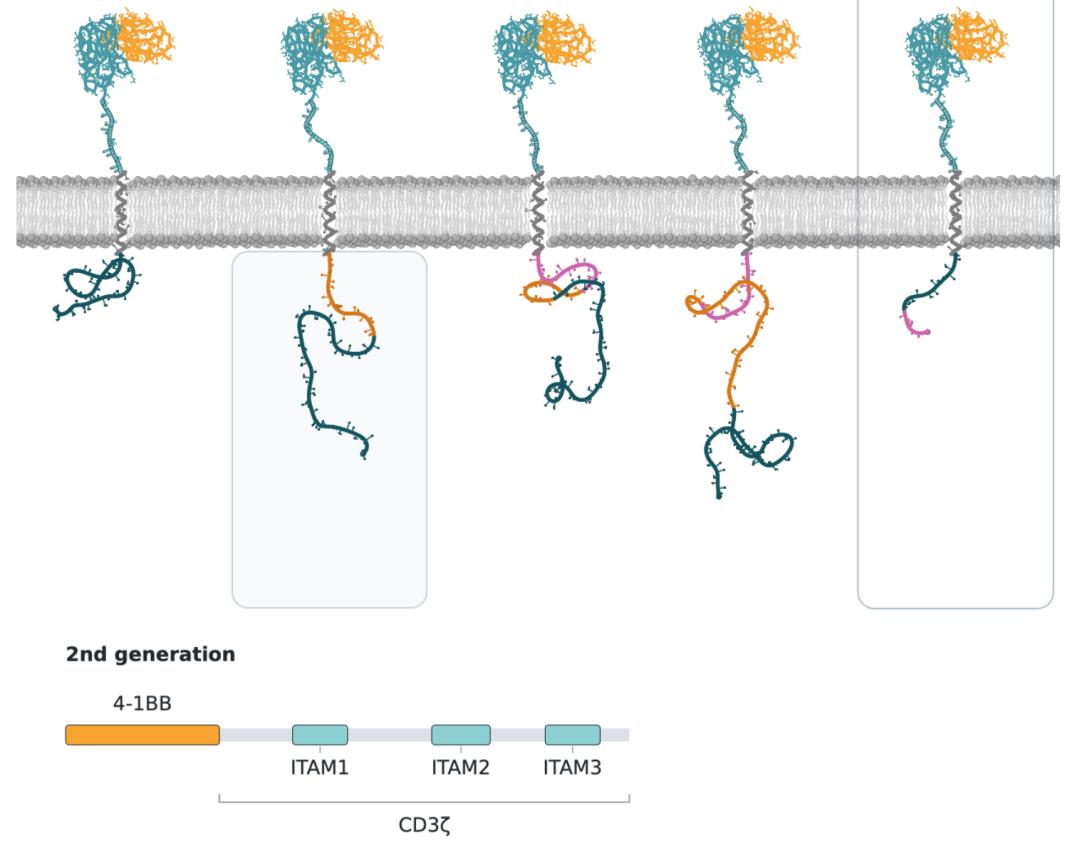
Strukturvergleich verschiedener CAR-Rezeptoren, der graue Querstreifen im Bild stellt die Zellmembran dar. (Quelle: Generate Biomedicines)
CAR-Rezeptoren ähneln der „Erkennungs- und Aktivierungseinheit“ von T-Zellen: Der extrazelluläre Teil erkennt das Ziel, der intrazelluläre Teil überträgt Signale, sodass die T-Zelle reagiert.
Aus den gemeinsam mit dem Modell entworfenen Lösungen wählten die Forscher 186 für die erste Runde von Experimenten aus. Sobald die Ergebnisse vorliegen, werden sie an das System zurückgegeben, um die Lösungen weiter zu modifizieren und weitere Experimente durchzuführen.
Nach drei Runden von Entwurf und Auswahl erhielt das Team eine nur aus 45 Aminosäuren bestehende Signalstruktur, die etwa 70 % kürzer ist als die als Kontrolle dienende Signalstruktur der zweiten Generation von CAR-Rezeptoren.
Das Team berichtete, dass in In-vitro-Experimenten bei gleicher mRNA-Dosis mehr CAR-Rezeptoren auf der Oberfläche der T-Zellen mit dem neuen Entwurf auftraten und die Fähigkeit, Zielzellen abzutöten, länger aufrechterhalten wurde.
Dieser Entwurf wurde schrittweise in aufeinanderfolgenden Runden von Versuchsrückmeldungen optimiert.
Kann KI-gestützte Forschung
zu ASI führen?
Von zeilenweisen mathematischen Herleitungen bis zu aufeinanderfolgenden Runden biologischer Experimente dringt KI zunehmend in mehr Phasen der wissenschaftlichen Forschung vor.
Sie findet Hinweise, erarbeitet Entwürfe und passt die Lösungen dann anhand der Validierungsergebnisse an.
Wenn wir den Blick auf Künstliche Superintelligenz (ASI) richten, stellt sich eine weitere Frage: Können die von KI erzielten wissenschaftlichen Ergebnisse umgekehrt die Entwicklung der KI selbst beschleunigen?
Bereits 2025 gab Google DeepMind bekannt: AlphaEvolve hat einen Berechnungskern im Training von Gemini um 23 % beschleunigt, wodurch die gesamte Trainingsdauer um 1 % verkürzt wurde.
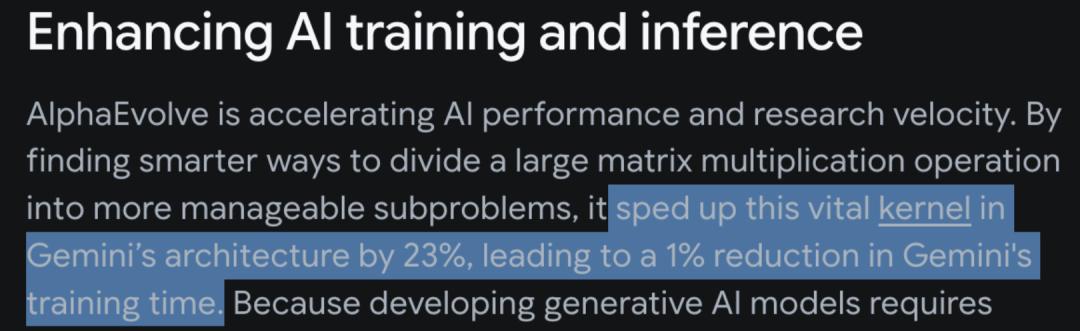
Die von AlphaEvolve gefundene Algorithmusoptimierung wird bereits zur Verbesserung der Trainingseffizienz von Gemini verwendet. (Quelle: Google DeepMind)
Die von der KI vorgeschlagenen und validierten Optimierungslösungen werden bereits zur Verbesserung des Modelltrainings verwendet.
Einen Schritt weiter: Wenn das System in der Lage ist, stärkere Systeme der nächsten Generation selbst zu entwickeln, und diese nächste Generation dann die KI-Entwicklung weiter vorantreibt, entsteht der Kreislauf, den sich RSI (Rekursive Selbstverbesserung) vorstellt.
Wenn ein solcher Kreislauf aufrechterhalten werden kann, könnte er zu einer treibenden Kraft auf dem Weg zur ASI werden.
Von einer einzelnen lokalen Optimierung bis zur kontinuierlichen Förderung neuer Entdeckungen bietet dieser Weg noch viele Möglichkeiten.
Angesichts der Zukunft von ASI werden Menschen und KI möglicherweise auf eine Weise gemeinsam forschen, die heute kaum vorstellbar ist.
Und all dies beginnt vielleicht mit immer neuen Versuchen: Eine Idee schneller zu validieren, eine Entdeckung sorgfältiger zu bestätigen und dem nächsten Forscher zu ermöglichen, seine neue Erkundung früher zu beginnen.
Quellen:
https://cheekypint.transistor.fm/39/transcript
https://www.theverge.com/ai-artificial-intelligence/1023054/altman-cheeky-pint-ai-math-interview
https://epoch.ai/data-insights/biorxiv-llms-vs-ai-tools
https://openai.com/index/building-scientific-understanding-with-academic-communities/?utm_source=chatgpt.com