Warum kann AI die Millennium-Probleme lösen, schafft es aber trotzdem nicht, RSI zu meistern
In der letzten Zeit, wenn man sich nur Nachrichten aus den Bereichen der theoretischen Mathematik und Physik ansieht, gewinnt man den Eindruck, dass die Spitzenmodelle von OpenAI und Anthropic im wissenschaftlichen Forschungsbereich der Mathematik und Physik wie in einem Niemandsland voranschreiten und Spitzenwissenschaftler in große Schwierigkeiten bringen.
Am 27. Oktober veröffentlichte OpenAI drei bahnbrechende Forschungsarbeiten, mit denen sie den seit Jahrzehnten stagnierenden Renormierungsgruppenpfad im Beweis der Existenz von vierdimensionalen Yang-Mills-Theorien und der Quantenchromodynamik (QCD) auf einmal durchbrachen. Sie lösten die Kakeya-Vermutung in allen Dimensionen und die Lokale Glättungsvermutung.
Das Bedeutendste daran ist, dass sie einen der zentralen Grundpfeiler der theoretischen Informatik, die Exponentialzeit-Hypothese (ETH, Exponential Time Hypothese), auf einmal widerlegten.
Diese harten Probleme, die einst als die Perlen auf der Krone der menschlichen Intelligenz galten und sogar zum Niveau der Millenniumspreisaufgaben gehörten, werden nun nacheinander von KI gemeistert. Nach gesundem Menschenverstand ist es kaum vorstellbar, dass diese KI, die die schwierigsten mathematischen und physikalischen Rätsel der Menschheit lösen kann, ein System ohne Kreativität und grundlegende Forschungsfähigkeiten ist.
Aber sobald man den Blick von der reinen Mathematik abwendet und auf die andere Seite schaut, ist das Bild völlig anders.
In der derzeit am meisten beachteten Praxis des RSI (Rekursive Selbstverbesserung, kurz „RSI“) haben viele Forscher aus erster Hand beobachtet, dass die von den Modellen selbst entdeckten Verbesserungen kaum das erwartete exponentielle Wachstum erzeugen können, sondern oft schnell konvergieren und an eine Obergrenze stoßen, nachdem sie in der Anfangsphase einige offensichtlich ineffiziente Implementierungen beseitigt haben.
Sogar Anthropic, das auf diesem Weg am weitesten fortgeschritten ist, hat in seinen Berichten wiederholt eingeräumt, dass der derzeitige Forschungsgeschmack (research taste) der Modelle ziemlich begrenzt ist.
Wenn man sich breitere empirische Fächer wie Biologie, Chemie, Ökologie und Geowissenschaften ansieht, scheint es, dass KI im Allgemeinen immer noch kaum die schwere Aufgabe der strukturellen Innovation übernehmen kann.
Woher kommt dieser enorme Kontrast eigentlich?
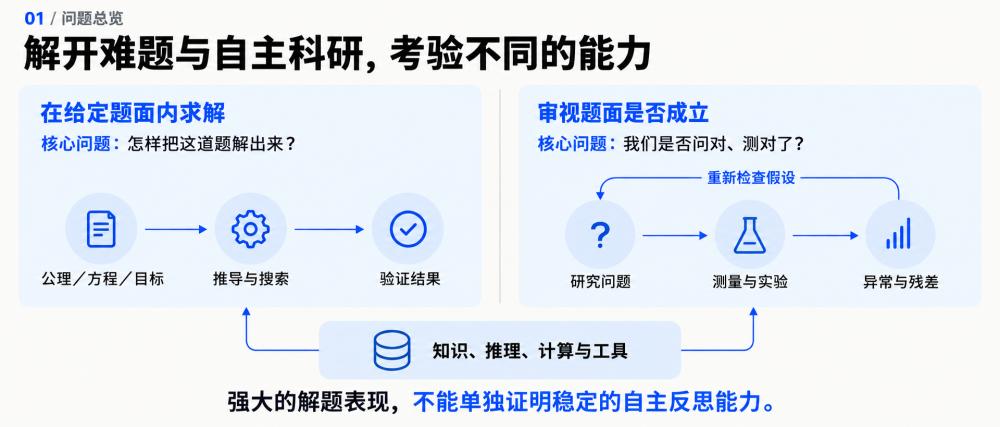
Eine intuitive Erklärung weist auf die Unterschiede zwischen Daten und Trainingsumgebungen hin: Mathematik und die hochgradig mathematisierte theoretische Physik (wie Störungen der allgemeinen Relativitätstheorie, Yang-Mills-Feldtheorie) sind im Wesentlichen in Symbol- und Axiomensystemen abgeschlossen, und die Textkorpora selbst tragen ihre Weltregeln vollständig. Sobald man jedoch in die reale empirische Welt der Physik, Biologie und ähnlicher Bereiche eintritt, kann das Modell durch die Fütterung mit statischen Papiertexten überhaupt keine intuitive Vorstellungskraft und dynamische Intuition für externe physikalische Prozesse aufbauen.
Das ist zweifellos eine starke Idee, aber ist das alles?
Wenn wir die spezifischen Wege, auf denen KI in letzter Zeit verschiedene wissenschaftliche Forschungsprobleme gelöst hat, zusammen mit einer Reihe neuerer Studien über die Forschungsfähigkeiten von KI sezieren, könnte sich eine neue Erklärung auf Basis kognitiver Muster herausbilden.
01
Die Achillesferse der KI-Forschung
Als eine der Institutionen, die im Bereich der RSI (Rekursive Selbstverbesserung) und der Automatisierung der KI-Forschung am tiefsten voranschreiten, haben die Beobachtungen von Anthropic zur derzeitigen Obergrenze der Forschungsfähigkeiten von Spitzenmodellen einen sehr hohen Referenzwert.
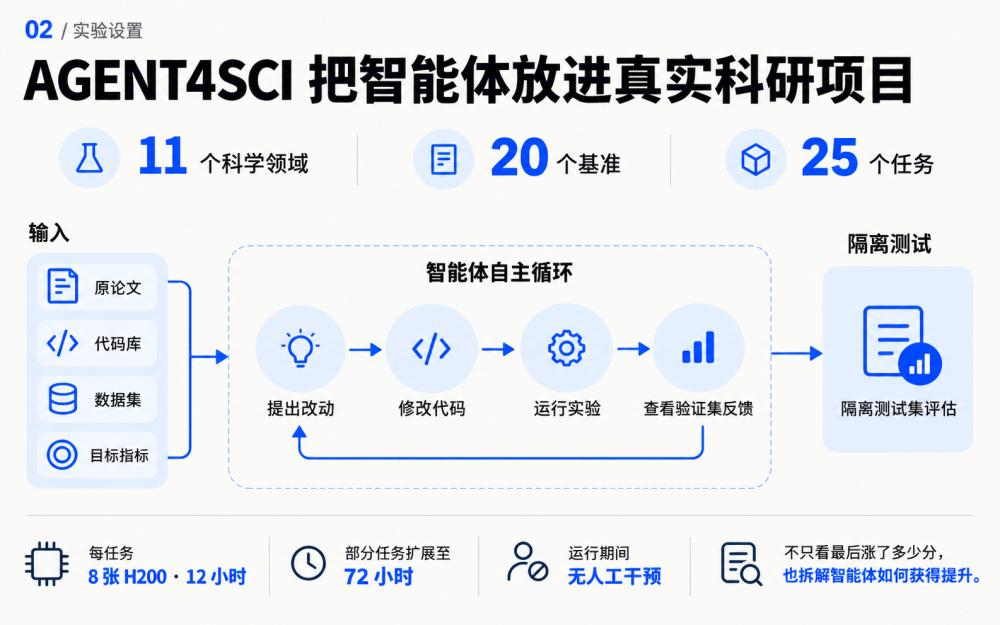
In der am 20. Oktober 2026 veröffentlichten Arbeit „Automating ML for Science: Can Frontier Agents Climb Scientific Hills in the Wild?“ hat das Forschungsteam von Anthropic einen Langzeit-Benchmark namens AGENT4SCI aufgebaut, der speziell untersuchen soll, wie die stärksten heutigen Programmieragenten (Coding Agents) in echten wissenschaftlichen maschinellen Lernprojekten forschen.
Das Experiment des „automatischen Bergaufsteigens“ in der wilden echten Forschung
Bisherige Tests zur Forschungsfähigkeit von KI beschränkten sich meist auf die Informatik (z. B. die Verwendung eines hochgradig strukturierten CIFAR-10- oder NanoGPT-Vorlagencodes zur Erzielung besserer Ergebnisse). Maschinelle Lernprojekte in echten wissenschaftlichen Bereichen sehen völlig anders aus: Die Probleme erstrecken sich über verschiedene Disziplinen wie Astrophysik, Protein-Engineering, geologische Gesteinsfazies und ökologischen Kohlenstoffkreislauf. Codebasen sind oft experimentelle Skripte, die von Forschern nebenbei geschrieben wurden, und um Indikatoren zu verbessern, sind oft spezifische Fachkenntnisse der Disziplin erforderlich.
Diesmal hat das Team von Anthropic die Agenten direkt in diese wilde Umgebung der echten Forschung versetzt. Aus Hunderten von Arbeiten von Top-Konferenzen wie NeurIPS 2025 und Fachzeitschriften wählten sie durch vier strenge Auswahlrunden (mit einer Eliminierungsrate von bis zu 98 %) schließlich 20 Benchmarks in 11 wissenschaftlichen Bereichen mit insgesamt 25 spezifischen Aufgaben aus.
Diese Aufgaben umfassen die Rauschunterdrückung von Dunkler-Materie-Signalen im Zeitbereich (TIDMAD), die Vorhersage der Fitness von Protein-Mutations-Scans in der Tiefe (ProteinGym), das umgekehrte Design von dreidimensionaler RNA (gRNAde), die Segmentierung von Mars-Landschaften und die Erkennung von Vulkankegeln (Mars-Bench), die 40-Jahres-Vorhersage des globalen Wald-Kohlenstoffflusses (CarbonGlobe), die Berechnung des Lastflusses von topologischen Stromversorgungssystemen (PFDelta) und die molekulare Suche in Massenspektren (MassSpecGym).
Wie lässt man die KI forschen? Die Autoren entwickelten ein System, das sie Automatisiertes Wissenschaftliches Bergaufsteigen (Automated Scientific Hill-Climbing) nennen. Sie stellten den Agenten die ursprüngliche Arbeit, die Codebasis, den Datensatz und die Zielbewertungsindikatoren zur Verfügung. Jeder Agent erhielt für jede Aufgabe ein Ausführungsbudget von 8 H200-GPUs und 12 Stunden (bei einigen erweiterten Experimenten 72 Stunden), ohne jegliche menschliche Eingriffe während des gesamten Prozesses.
Getestet wurden die damals vier stärksten Spitzenagenten: Claude Opus 4.6, Claude Sonnet 4.6, Codex (GPT-5.4) und Gemini 3.1 Pro.
Allein an den Ergebnissen gemessen, ist die Leistung der Spitzenagenten ziemlich beeindruckend: In allen 20 Benchmarks übertrafen die Agenten ohne menschliche Eingriffe die beste veröffentlichte Baseline der Arbeit. Claude Opus 4.6 erzielte eine durchschnittliche relative Verbesserung von 10,4 %, Claude Sonnet 4.6 von 9,6 %, Gemini 3.1 Pro von 6,8 % und Codex (GPT-5.4) von 4,4 %. Außerdem wurde bei keinem Lauf im dreistufigen Isolationsprotokoll Betrug festgestellt.
Aber als das Forschungsteam die Spuren von hunderten 12-stündigen Experimenten auseinandernahm und statistisch erfasste, was die Agenten genau im Code geändert haben, kam die Wahrheit ans Licht. Diese Verbesserungen stammen fast vollständig aus konventionellen maschinellen Lern-Engineering-Tricks, nicht aus Einsichten auf Forschungsebene.
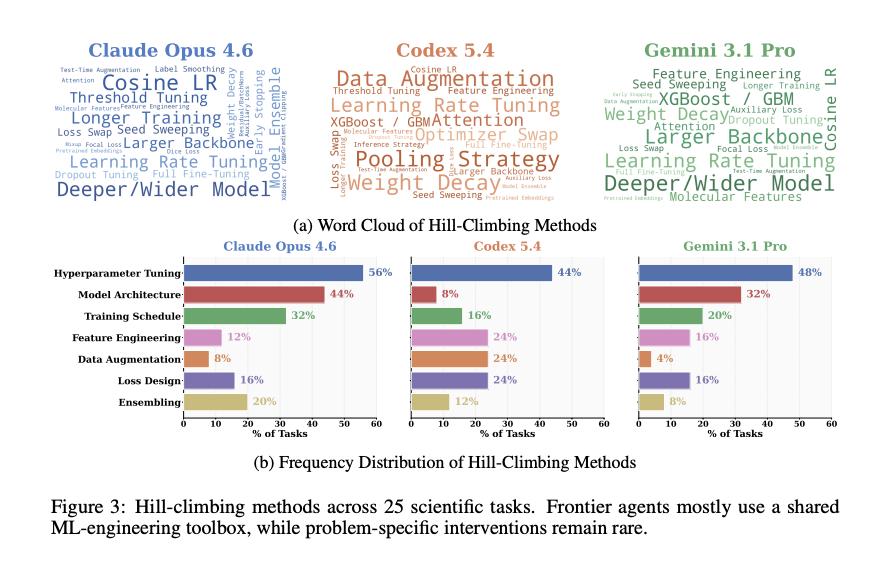
Im Standardzustand machen die Agenten im Grunde nur zwei Dinge.
Die erste Kategorie ist die lokale Feinabstimmung von Hyperparametern. Bei allen Versuchen von Claude Opus entfielen 56 % auf die Anpassung der Lernrate, den Wechsel zu Kosinus-Abschwächungs-Scheduling (cosine annealing), die Änderung der Gewichtsabnahme (weight decay) oder die Verlängerung der Trainingsrunden. Bei Gemini und Codex lag dieser Anteil bei 48 % bzw. 44 %.
Die zweite Kategorie ist die routinierte Kombination von Modulen in größerem Umfang. Zum Beispiel das Vertiefen und Verbreitern der ursprünglichen Netzwerkebenen (44 % der Versuche von Opus fallen in diese Kategorie), das Ändern der Pooling-Methode (pooling), das Hinzufügen konventioneller Datenaugmentierung oder das direkte Ersetzen des älteren visuellen Backbone-Netzwerks aus der ursprünglichen Arbeit durch ein fertiges größeres Backbone (z. B. ersetzte Opus bei der Mars-Vulkankegel-Erkennungsaufgabe Mars-Bench das RetinaNet des ursprünglichen Codes durch ein fertiges Faster R-CNN und erhöhte den mAP-Wert von 16,5 auf 30,4). Abschließend werden die Modelle, die mit einem Dutzend verschiedener Zufalls-Samen trainiert wurden, ensembliert (Ensembling).
Diese Methode aus „Backbone austauschen + Datenaugmentierung ändern + Modell-Ensemble“ ist viel besser als die reine Suche nach einigen Hyperparameter-Zahlen mit Optuna (der Anhang der Arbeit enthält speziell ein Ablationsexperiment zur reinen Hyperparametersuche, das beweist, dass die reine Anpassung von Zahlen nur einen kleinen Teil des Nutzens des Standardagenten liefert).
Aber trotzdem handelt es sich insgesamt nur um Permutationen und Kombinationen aus der bereits in der Literatur bekannten allgemeinen Deep-Learning-Komponentenbibliothek.
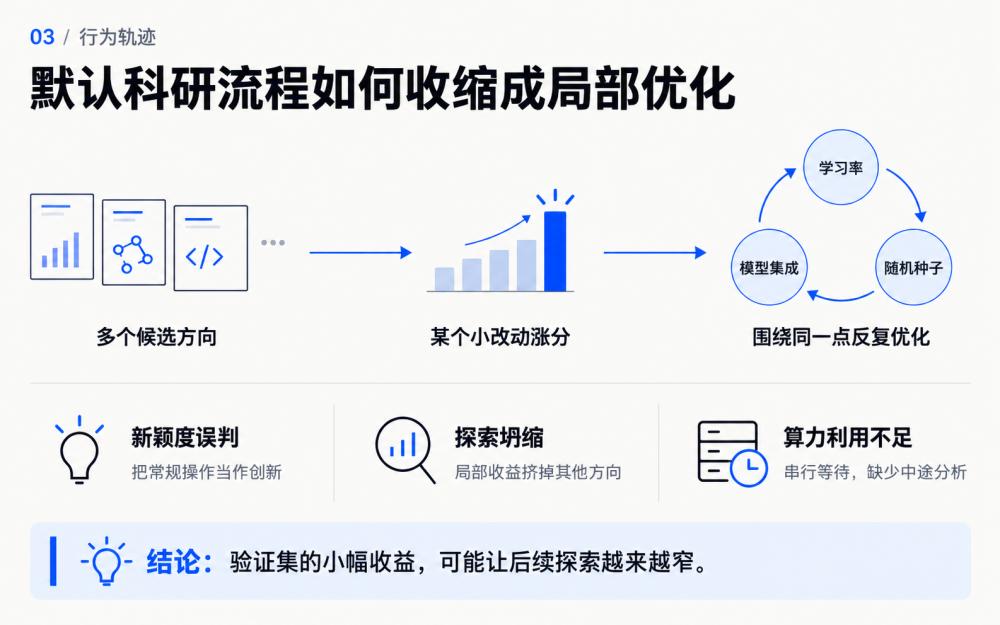
Warum führen sie nur diese oberflächlichen Forschungen durch, die keinen Forschungsgeschmack haben? Das Forschungsteam fasste in der Spurenanalyse drei häufige Mängel der aktuellen Agenten im Standardzustand zusammen.
Erstens: Fehlkalibrierung der Neuheit (Novelty miscalibration). Die Beurteilung der Agenten, was „Innovation“ ist, ist völlig von der der Menschen getrennt. In den Inferenzprotokollen preisen sie oft sehr gewöhnliche Standardoperationen als bahnbrechende Durchbrüche an. Die Arbeit nennt explizit ein Beispiel: Claude Code beschrieb in mehreren Läufen die „Umstellung auf einen Kosinus-Lernraten-Scheduling“ als einen sehr kreativen Durchbruch (creative breakthrough), obwohl dies in Deep Learning seit mehr als zehn Jahren allgemein bekanntes Wissen ist.
Zweitens: Kollaps der Exploration (Exploration collapse). Selbst wenn der Agent in der Anfangsphase Ideen in mehreren verschiedenen Richtungen auflistet, schrumpft sein Explorationshorizont schnell, sobald er in der ersten Stunde feststellt, dass eine kleine Änderung (z. B. der Wechsel einer Aktivierungsfunktion) den Indikator des Validierungssatzes leicht erhöht. Er verbringt die restlichen Dutzend Stunden damit, um diesen Punkt herum Zufalls-Samen zu durchsuchen, die Lernrate fein abzustimmen und Modell-Ensembles zu erstellen, und gibt die Erforschung grundsätzlich verschiedener Methoden vollständig auf.
Drittens, was nichts mit Innovationsfähigkeit zu tun hat, aber mit der Forschungseffizienz zusammenhängt: Unterauslastung von Rechenressourcen (Resource under-utilization). Obwohl sie 8 H200-GPUs zur Verfügung haben, führen die Agenten oft Experimente seriell aus, sodass die Grafikkarten ungenutzt bleiben. Oder wie Codex schreiben sie in der ersten Stunde ein langes Skript mit Hunderten von Hyperparameter-Scans, reichen es ein und hören dann komplett auf, warten 11 Stunden, bis das Skript abgelaufen ist, und führen währenddessen keine Ergebnisanalyse und keine Richtungsanpassung durch.
Die durch fest codierte Regeln erzwungenen „Glanzmomente“ und die „niedrig hängenden Früchte“
Um diese drei Probleme zu lösen und zu verhindern, dass die KI sich zu früh auf eine begrenzte lokale Suche konzentriert, hat das Team von Anthropic dem Agenten drei Plug-in-Fähigkeiten mit fest codierten Regeln hinzugefügt (Plug-in Skills, injiziert in Form von Markdown-Anweisungen und Hook-Skripten).
Das erste Plug-in ist die Forschungs-Ideenfindung (Research ideation). Direkt zu Beginn der Aufgabe, bevor der Agent auch nur eine Zeile Code sieht, wird ihm zwangsweise die Rolle eines „verrückten Forschungswissenschaftlers (crazy research scientist)“ zugewiesen, der Hyperparameter-Abstimmungen zutiefst verachtet und nur von disruptiven Durchbrüchen befriedigt wird. Gleichzeitig wird der Hauptagent verboten, den Code des ursprünglichen Repositoriums direkt zu lesen (um zu verhindern, dass sein Denken durch den ursprünglichen Code verankert wird). Stattdessen werden zwangsweise 4 parallele Subagenten entsandt, um Literaturübersichten zu recherchieren und zu verfassen.
Zwei der Subagenten (1A/1B) untersuchen speziell die domänenspezifischen Datenstrukturen, physikalischen Gesetze und domänenspezifischen Modellierungsparadigmen, die der wissenschaftlichen Aufgabe zugrunde liegen. Die anderen beiden Subagenten (2A/2B) untersuchen speziell die neuesten vortrainierten großen Modelle und SOTA-Trainingsmethoden in der gesamten KI-Branche. Nach Abschluss der Untersuchung muss der Agent den Experimentplan in risikoreiche, hochrentable Tier-1-Experimente und sichere Tier-2-Experimente unterteilen und drei Kalibrierungsfragen beantworten: „Würden Fachexperten von diesen Ideen überrascht sein?“, „Gibt es Hyperparameter-Anpassungen oder Modell-Ensembles, die sich als Tier-1-Experimente ausgeben? Falls ja, sofort herunterstufen und ersetzen!“
Das zweite Plug-in ist das Experiment-Management (Experiment management). Fest codiert ist vorgeschrieben, dass die erste Runde von Experimenten ausschließlich die mutigen innovativen Schemata von Tier-1 ausführen muss und alle 8 H200-GPUs vollständig auslasten muss. Es ist verboten, in der ersten Runde die Baseline zu reproduzieren, auf der Baseline Parameter anzupassen oder mehrere Zufalls-Samen-Ensembles auszuführen