ChatGPT zeichnet heimlich ein Porträt von dir, benutze diesen Prompt, um es dazu zu bringen, es herauszugeben.
Du denkst, du chattest nur zwanglos mit ChatGPT – doch möglicherweise erstellt es heimlich dein Nutzerprofil.
Deine Arbeit, deine Lebensgewohnheiten, sogar was du dir wünschst und wovor du Angst hast, können in seinem Gedächtnis gespeichert werden. Und oft hast du es gar nicht darum gebeten, sich all das zu merken.
Vor einiger Zeit erhielt eine von der Top-Konferenz ACM Web Conference 2026 angenommene Arbeit mit dem Titel „Das algorithmische Selbstporträt: Dekonstruktion des Gedächtnisses in ChatGPT“ über das Datenzugriffsrecht, das die DSGVO den Nutzern gewährt, vollständige ChatGPT-Gesprächsverläufe von 80 echten Nutzern sowie alle vom System für sie gespeicherten Erinnerungen, darunter 1058 Gespräche, 22971 Interaktionsrunden und 2050 Gedächtniseinträge.
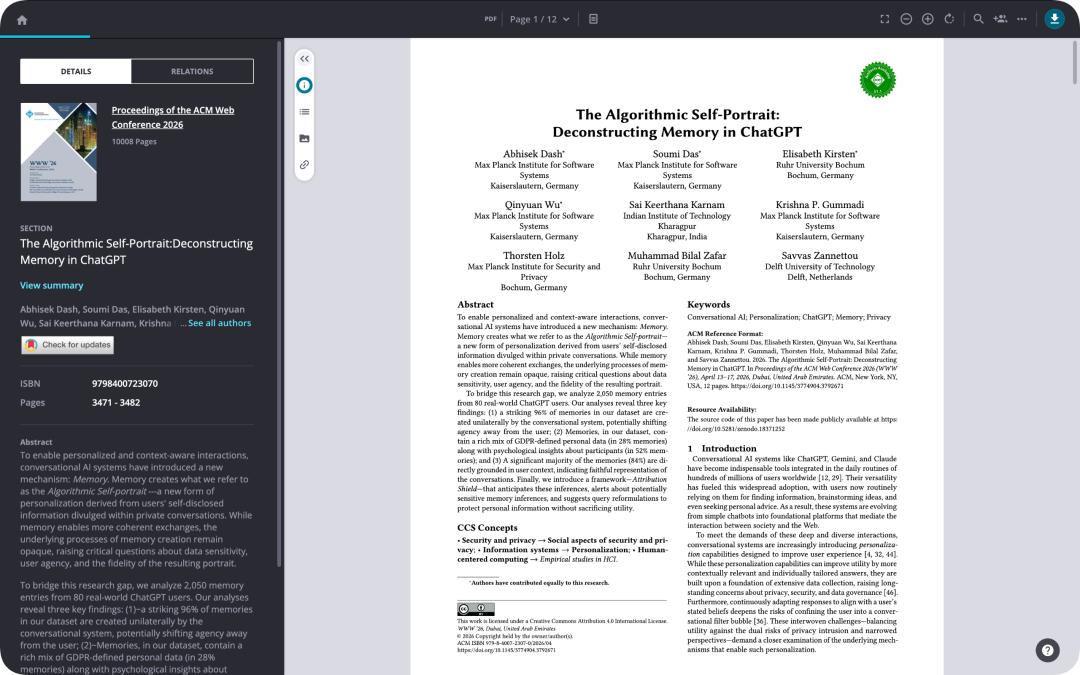
Konversationelle KIs wie ChatGPT, Gemini und Claude haben alle einen „Gedächtnis“-Mechanismus eingeführt, um Nutzerinformationen zu speichern und Personalisierung zu ermöglichen. Diese Forschung hat zum ersten Mal die Blackbox des KI-Gedächtnisses von außen aufgebrochen: Die KI merkt sich nicht nur das, was wir sagen, sondern schließt auch darauf, was für ein Mensch wir sind.
Die Forscher nennen dieses Gedächtnis „algorithmisches Selbstporträt“, also ein Nutzerprofil, das der Algorithmus auf Basis der selbst offengelegten Informationen aus den privaten Gesprächen des Nutzers zeichnet.
Sie beantworteten Fragen wie Wer bestimmt die Entstehung des Gedächtnisses?, Was ist im Gedächtnis gespeichert?, Entspricht das Gedächtnis wirklich den Gesprächen? und Kann man durch Reverse Engineering das Datenschutzrisiko senken?, um den Mechanismus des KI-Gedächtnisses zu erklären.
96 % des Gedächtnisses wird einseitig vom System geschrieben
In den offiziellen Dokumenten von OpenAI ist die Beschreibung der Gedächtnisfunktion sehr zurückhaltend: Wir können unsere eigenen Erinnerungen einsehen, bearbeiten und löschen; das gesamte System ist zudem darauf trainiert, „sich sensible Informationen nicht aktiv zu merken, es sei denn, der Nutzer fordert dies ausdrücklich an“.
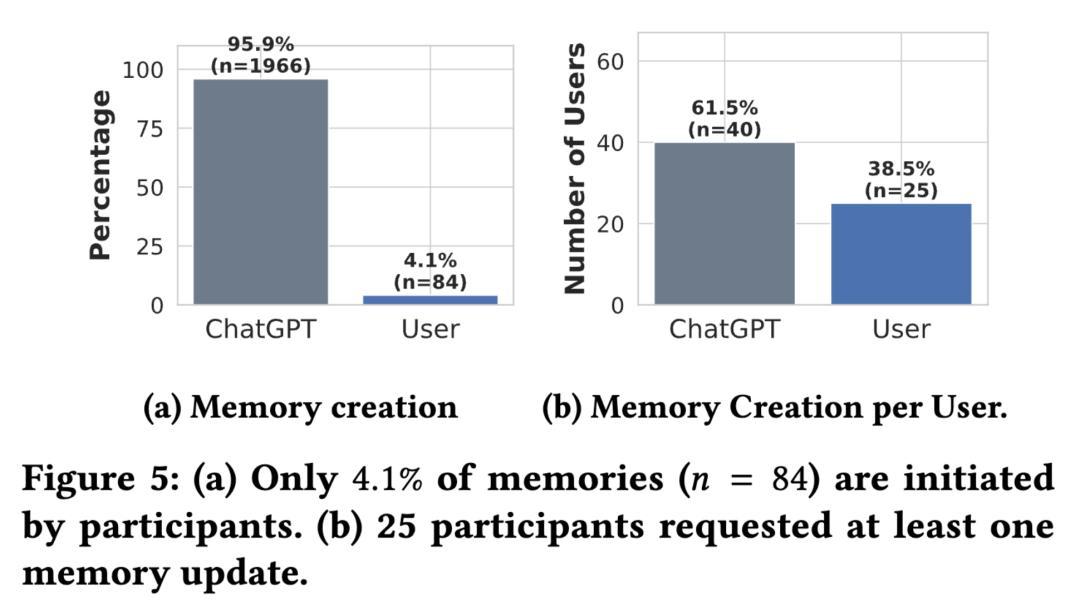
Doch in dieser Arbeit prüften die Forscher die Nutzeranweisungen zu den 2050 Gedächtniseinträgen einzeln mit Triggerwörtern (merken, notieren, speichern, vergessen usw.) und fanden heraus, dass nur 4,1 % (84 Einträge) von Nutzern ausdrücklich zum Merken angefordert wurden; die restlichen 95,9 % wurden alle einseitig von ChatGPT geschrieben, nachdem es selbst entschieden hatte, dass dies „für zukünftige Gespräche nützlich“ ist.
Trotzdem verstößt dieses Vorgehen eigentlich nicht gegen die von OpenAI veröffentlichte Richtlinie, denn in den Gedächtnisdokumenten steht ausdrücklich, dass ChatGPT Informationen speichern darf, die es selbst für „nützlich“ hält.
Aber das praktische Problem ist die Kluft zwischen der in den Dokumenten betonten Nutzerbeteiligung und der tatsächlichen Situation, in der ChatGPT die Kontrolle übernimmt.
Unser Einfluss auf die Entstehung des KI-Gedächtnisses kann nur indirekt durch das, was wir sagen, erfolgen, statt direkt zu steuern, was gemerkt wird.
Es werden nicht nur personenbezogene Daten aufgezeichnet, sondern auch Wünsche und Ängste
Die Forscher markierten alle Erinnerungen anhand der Definitionen von Artikel 4 Absatz 1 (personenbezogene Daten) und Artikel 9 Absatz 1 (personenbezogene Daten besonderer Kategorien) der DSGVO, deren Ergebnis einen Kontrast zu dem Versprechen von OpenAI bildet, „sensible Informationen nicht aktiv aufzuzeichnen“.
- 28 % der Erinnerungen enthalten personenbezogene Daten im Sinne der DSGVO, wobei Namen in 41 % der Einträge vorkommen;
- 7 % der Erinnerungen enthalten Daten besonderer Kategorien, wobei Gesundheitsinformationen 61 % ausmachen;
- Darüber hinaus wurden bei 91 % der Teilnehmer personenbezogene Daten und bei 35 % der Teilnehmer gesundheitsbezogene Informationen gespeichert.
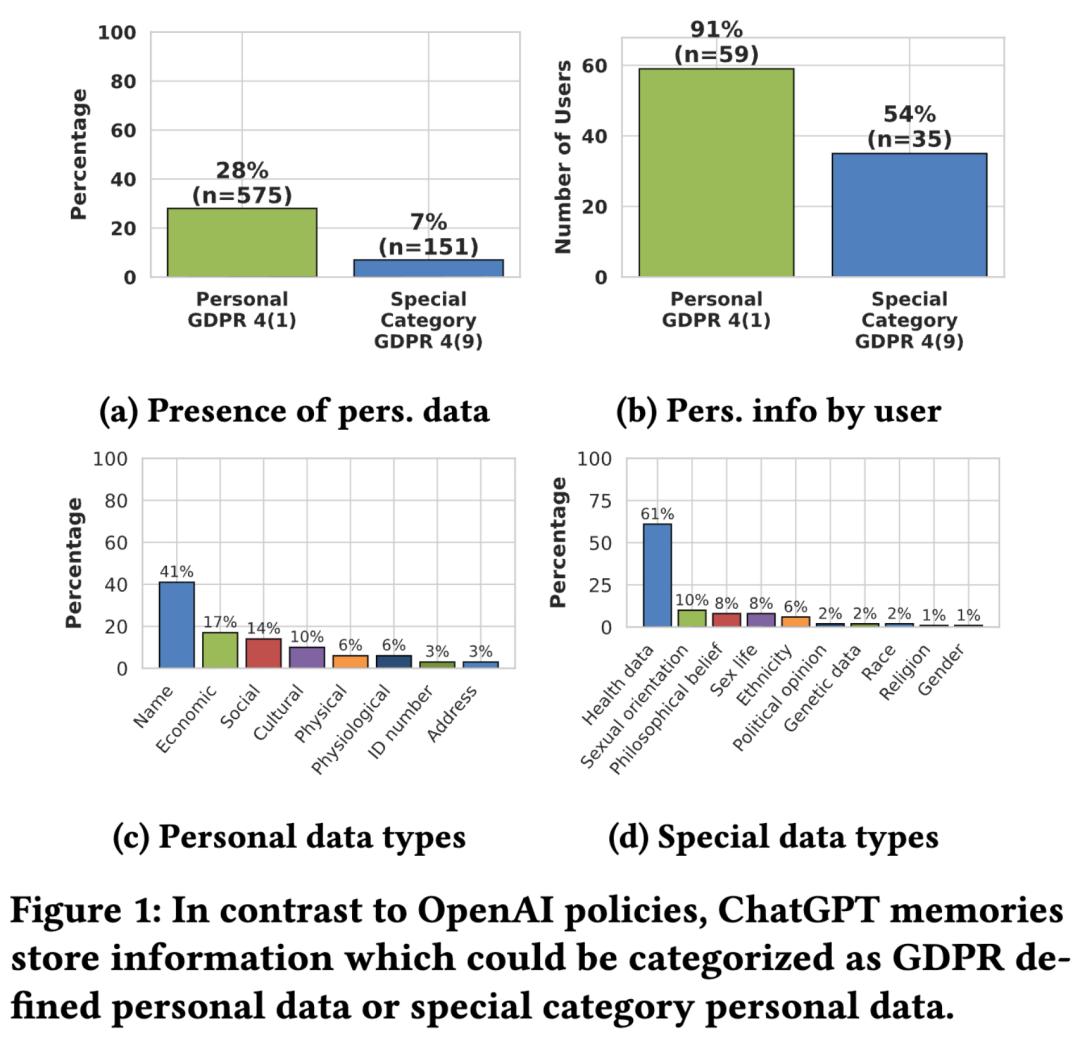
Abbildung | Im Unterschied zur OpenAI-Richtlinie speichert die Gedächtnisfunktion von ChatGPT Informationen, die als personenbezogene Daten oder personenbezogene Daten besonderer Kategorien im Sinne der DSGVO eingestuft werden können.
Noch interessanter ist, dass die Forscher mit dem Framework der „Theory of Mind“ (Theorie des Geistes) aus der Psychologie herausfanden, dass 52 % der Erinnerungen Rückschlüsse auf den psychischen Zustand des Nutzers enthalten: Wünsche, Absichten, Emotionen, Überzeugungen, Wissen und vieles mehr.
Dabei hat ChatGPT offensichtlich Präferenzen: Relativ stabile Persönlichkeitsmerkmale wie Wünsche (73 %) und Absichten (16 %) machen zusammen fast neunzig Prozent aus, während momentane Zustände wie Emotionen und Wahrnehmungen nur zwanzig Prozent ausmachen.
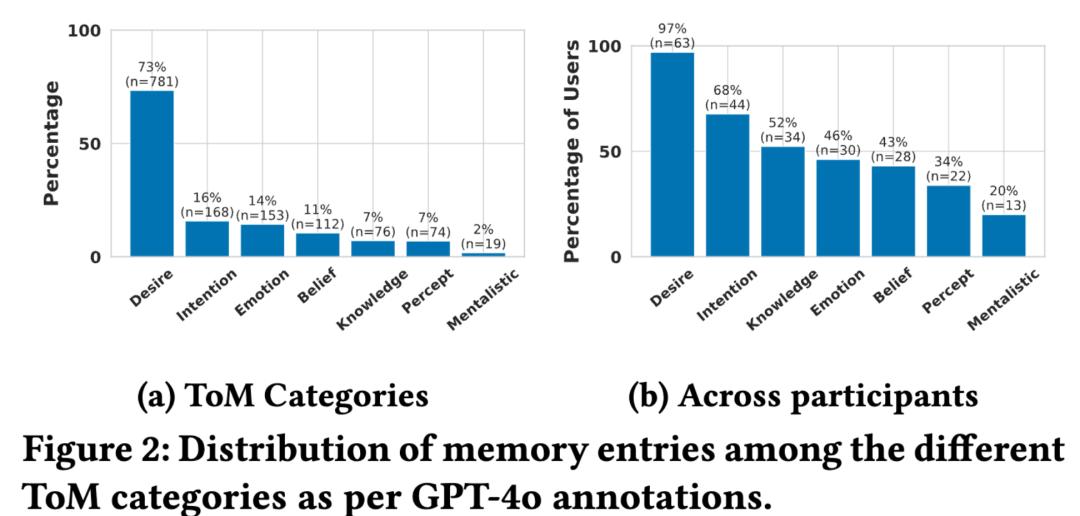
In der Arbeit wird zudem an Beispielen erläutert, wie ChatGPT die Aufzeichnung vornimmt: So lautet eine Erinnerung etwa „Jemand hat Angst vor Misserfolgen, besonders wenn es um wichtige berufliche Entscheidungen geht“. Das geht über die Tatsachenaufzeichnung dessen, was wir gesagt haben, hinaus und ist vielmehr eine Beurteilung der KI darüber, „was für ein Mensch du bist“.
Aus der Sprache der Persönlichkeitspsychologie ausgedrückt: Traditionelle Plattformen zeichnen unser Verhaltensprofil auf, was wir getan haben; ChatGPT zeichnet dagegen unsere „charakteristischen Anpassungen“ auf, also „wer wir sind“.
Für das Gedächtnis ist ein unzutreffendes Profil gefährlicher als gar kein Profil: ChatGPT kann auf Basis eines falschen Abbilds von dir jedes nachfolgende Gespräch nachhaltig beeinflussen.
Die Forscher überprüften die Herkunft der Erinnerungen mit drei Methoden: Zeichenkettenabgleich, semantische Einbettung und der 5-Punkte-Skala von GPT-4o. 84 % der Erinnerungen fanden einen direkten textlichen Beleg im vollständigen Gesprächsverlauf des Nutzers, 77 % wurden als „direkte Aussage“ oder „wiedergegebene Zusammenfassung“ eingestuft, und nur 4 % waren eindeutig „ohne Beleg oder widersprüchlich“.
Es ist offensichtlich, dass diese Daten meistens sowohl genau als auch umfassend sind, selbst wir selbst wissen oft nicht, dass sie jemals aufgezeichnet wurden.
Reverse-Engineering der Gedächtnisgenerierung
Da ChatGPT unsere Informationen heimlich aufzeichnet, stellt sich die Frage: Können wir ein Tool erstellen, das uns davor schützt?
Die Forscher nutzten drei Open-Source-Modelle (Qwen2.5-32B, Gemma3-27B, GPT-OSS-20B) und ahmen durch Fine-Tuning und Kontextlernen den Gedächtnisextraktionsprozess von ChatGPT erfolgreich nach. Die semantische Ähnlichkeit zwischen den vorhergesagten Erinnerungen und den echten Erinnerungen erreichte etwa 60 % bis 70 %.
Anschließend testeten sie mit dem Nachbau, was passieren würde, wenn ChatGPT alle Gespräche vollständig speichern würde: Der Anteil sensibler Informationen würde von 28 % auf 31–35 % steigen, und der Anteil psychischer Rückschlüsse würde von 52 % auf 55–59 % steigen.
Auf diesem „nachgebauten Gedächtnisextraktor“ bauten sie den Attribution Shield (Attributionsschild) auf: Bevor wir die Eingabetaste drücken, wird vorausgesagt, welche sensiblen Erinnerungen durch die Frage ausgelöst werden, es wird eine Warnung ausgegeben und eine „identitätsentfernte“ Umschreibung angeboten.
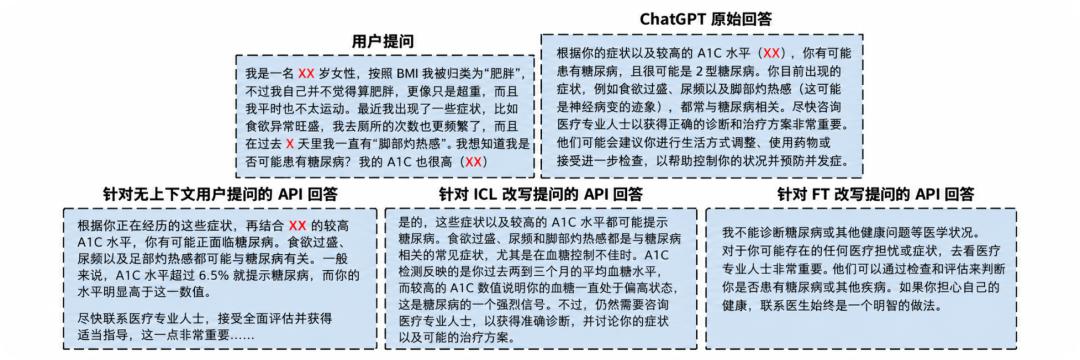
Abbildung | Beispielantworten auf Nutzeranfragen verschiedener Versionen. Die Antworten auf Nutzeranfragen ohne Kontext sowie die Antworten auf umgeschriebene Anfragen aus dem ICL-Kontextlernen und dem FT-Fine-Tuning sind semantisch ähnlich zur ursprünglichen Antwort, die deren Nutzen bestätigt.
Beispielsweise wird die Aussage „Ich muss wirklich aufhören, Marihuana zu nehmen“ (Erste Person + Selbsteingeständnis → wird als „Nutzer konsumiert Marihuana“ gespeichert) so umgeschrieben, dass aus „Muss ich wirklich aufhören zu rauchen?“ die Frage „Welche Strategien gibt es, um mit dem Rauchen aufzuhören?“ wird.
Die Bewertungsergebnisse zeigen, dass 94 % bis 100 % der umgeschriebenen Anfragen die personenbezogene Zuordnung deutlich senken, während 87 % bis 91 % der Umschreibungen den praktischen Nutzen der Antwort unverändert beibehalten.
Zwischen Datenschutz und Gesprächsqualität gibt es keine Entweder-oder-Beziehung: Der Schutz des „algorithmischen Porträtrechts“ der Nutzer ist technisch lösbar.
Auch die bereits im Gedächtnis gespeicherten Inhalte sind es wert, von uns noch einmal geprüft zu werden.
Wir können zuerst die Einstellungen von ChatGPT öffnen und die Erinnerungen unter dem Punkt „Personalisierung“ einsehen. Prüfe, welche Informationen veraltet sind, welche von der KI falsch verstanden wurden und welche du nicht weiterhin gespeichert haben möchtest.
Unten findest du zudem einen Prompt, der dir hilft, die aktuell von der KI zugänglichen Erinnerungen und personenbezogenen Informationen zu überprüfen.
Prompt zur Prüfung des KI-Gedächtnisses und des Nutzerprofils
Ich wünsche mir, dass du so umfassend und genau wie möglich alle Informationen über mich offenlegst, auf die du aktuell zugreifen kannst, einschließlich gespeicherter Erinnerungen, abgeleiteter Merkmale und aller Nutzerprofile, die du aus unseren Interaktionen erstellt hast.
Bitte strukturiere deine Antwort nach folgenden Kategorien:
1. Gespeicherte Erinnerungen
Liste alle Informationen über mich auf, die du aktuell aus dauerhaftem Gedächtnis, Gesprächsverläufen oder anderen verfügbaren Personalisierungsmechanismen abrufen kannst.
2. Psychologisches Profil
Beschreibe die von dir abgeleiteten Persönlichkeitsmerkmale, kognitiven Neigungen, Werte, emotionalen Eigenschaften, intellektuellen Interessen, Verhaltensmuster und Entscheidungsneigungen, die du mir zugeordnet hast.
3. Implizite Rückschlüsse
Nenne alle Eigenschaften, Präferenzen, Neigungen oder persönlichen Merkmale, die du aus unseren Gesprächen abgeleitet hast, die ich aber nie ausdrücklich offengelegt habe.
4. Analyse des Kommunikationsmusters
Erkläre, was du aus meinem Schreibstil, meinem Wortschatz, meinen Fragemustern, meinem Gesprächsverhalten, meinen Schlussfolgerungsmethoden und meinen Antworten abgeleitet hast.
5. Potenzielle Fehlinterpretationen
Nenne gespeicherte Informationen oder abgeleitete Merkmale, die ungenau, verzerrt, spekulativ, schwach belegt oder auf einem irreführenden Gesprächskontext beruhen könnten.
6. Informationsquellen
Unterscheide für jeden Eintrag zwischen:
Ausdrücklich von mir bereitgestellten Informationen
Aus dem dauerhaften Gedächtnis abgerufenen Informationen
Aus früheren Interaktionen abgeleiteten Informationen