Künstliche Intelligenz muss nicht nur sprechen können, sondern darf auch nicht unbefugt dazwischenreden, Omni AI revolutioniert die Echtzeit-Interaktion.
Die KI kann bereits hören, sehen und antworten.
Aber angesichts sich ständig wandelnder Dialoge: Wie kann sie gleichzeitig reagieren und ihr Verständnis sowie ihre Schlussfolgerungsfähigkeit aufrechterhalten?
Wenn Sie die KI bitten, das Diagramm auf dem Bildschirm zu analysieren, und plötzlich ergänzen „Warte mal, sieh dir die Kurve rechts an“, muss das System die alte Antwort stoppen, das Ziel aktualisieren und prüfen, ob die Hintergrundberechnungen noch gültig sind.
Die Schwierigkeit der Echtzeit-Interaktion liegt genau in diesen Momenten.
Forscher von Einrichtungen wie der University of Illinois at Urbana-Champaign, der Carnegie Mellon University und der Columbia University haben in ihrem neuesten Übersichtsbeitrag einen einheitlichen konzeptionellen Rahmen vorgeschlagen, der die allmodale Intelligenz und die Interaktionsfähigkeit verbindet, die technische Kette von der Stream-Repräsentation, der Modellarchitektur, den Trainingsmethoden bis hin zur Echtzeit-Bereitstellung und -Bewertung systematisch aufarbeitet und die zentralen Kompromisse zwischen Intelligenz und Interaktion sowie zukünftige Forschungsrichtungen weiter zusammenfasst.
Paper-Adresse: https://doi.org/10.13140/RG.2.2.20245.69602
Projektadresse: https://github.com/ShenYifanS/Awesome-Interactive-Omni
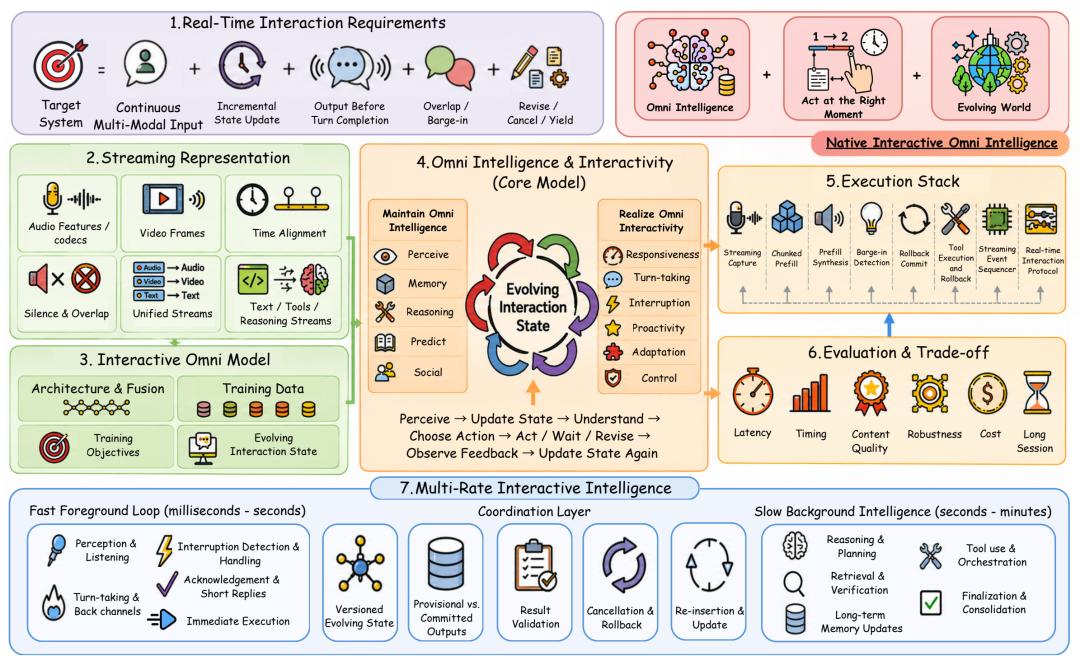
Abbildung 1|Der Übersichtsbeitrag fasst insgesamt 349 Arbeiten zusammen, schlägt einen einheitlichen konzeptionellen Rahmen vor, der allmodale Intelligenz und Interaktionsfähigkeit als zwei miteinander verbundene Komponenten betrachtet und Repräsentation, Architektur, Training, Bereitstellung und Bewertung miteinander verknüpft. Quelle: Abbildung 1 des Papers.
Echtzeit-interaktive allmodale Intelligenz
Omni AI (Allmodale Intelligenz) strebt nach einheitlichem Verständnis, Schlussfolgern und Generieren verschiedener Modalitäten wie Text, Bild, Audio und Video an. Die Fähigkeit zur multimodalen Verarbeitung bedeutet jedoch nicht automatisch die Fähigkeit zur natürlichen Interaktion.
Der Übersichtsbeitrag unterteilt die echtzeit-interaktive allmodale Intelligenz in zwei miteinander verbundene Komponenten:
Omni Intelligence (Allmodale Intelligenz): Konzentriert sich auf das crossmodale Verständnis, Schlussfolgern und Generieren.
Omni Interactivity (Allmodale Interaktivität): Konzentriert sich auf den Zeitpunkt der Antwort, die Verwaltung von Gesprächsrunden, die Verarbeitung von Unterbrechungen und dynamische Anpassungen.
Das Paper fasst weiter drei zentrale Merkmale zusammen: gestreamte Eingaben, sich ständig weiterentwickelnde interne Zustände und die Steuerung von Online-Antworten. Das bedeutet, dass das Modell kontinuierlich Informationen empfangen, Urteile aktualisieren und dynamisch entscheiden muss, wann es antwortet, wartet oder die Ausgabe überarbeitet.
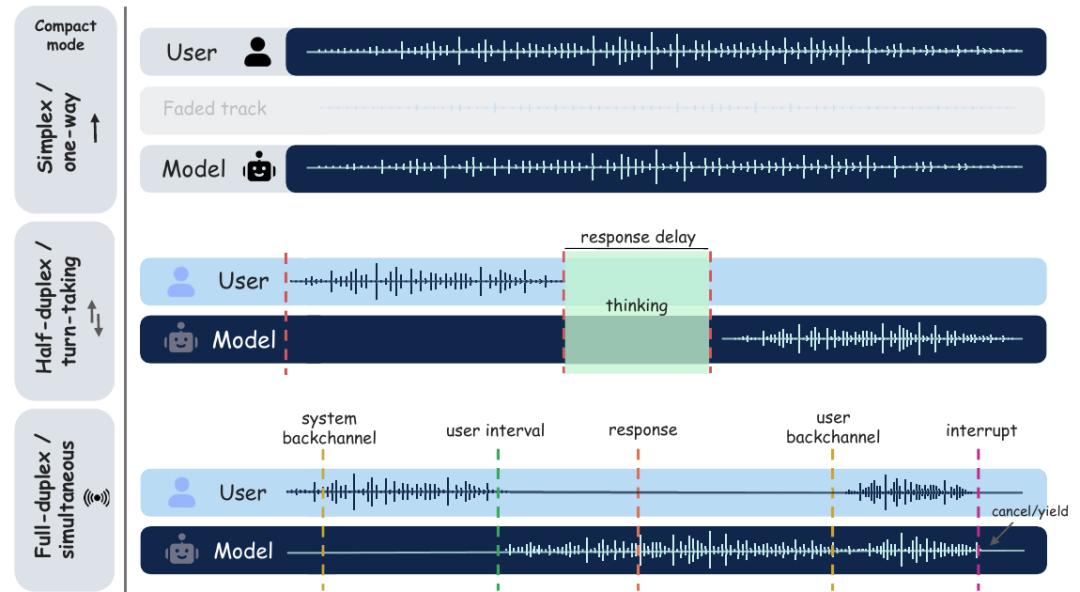
Abbildung 2|Vollduplex-Interaktion ermöglicht gleichzeitiges Sprechen und Zuhören und erfordert die Verarbeitung von Zustimmungsäußerungen, Sprachüberlappungen und Unterbrechungen. „Nativ“ betont weiter, dass Zeitausrichtung, inkrementelle Verarbeitung und Interaktionssteuerung direkt in die Modellarchitektur und das Training integriert werden. Eine bloße Verringerung der Antwortverzögerung reicht nicht aus, um alle diese Anforderungen zu erfüllen. Quelle: Abbildung 2 des Papers.
Zwei technische Routen
Unter dem einheitlichen konzeptionellen Rahmen leitet der Übersichtsbeitrag zwei Haupttechnikpfade ab.
Der erste besteht in der Adaption auf Basis vorhandener Modelle. Durch Stream-Verarbeitung, Modale Module, Nachtraining und externe Orchestrierung werden vortrainierten Sprachmodellen oder allmodalen Modellen Echtzeit-Interaktionsfähigkeiten hinzugefügt. Der Vorteil liegt in der Wiederverwendung vorhandener Fähigkeiten, die Herausforderung besteht in Verzögerung, Zustandssynchronisation und Unterbrechungssteuerung.
Der zweite Pfad besteht im Aufbau nativer Interaktionsmodelle. Kontinuierliche multimodale Verarbeitung, zeitliche Struktur und Interaktionssteuerung werden in die Modellarchitektur und das Training integriert, um eine engere Koordination von Wahrnehmung und Interaktion zu erreichen, was jedoch höhere Anforderungen an Trainingsdaten und die Erhaltung vorhandener Fähigkeiten stellt.
Wann soll man sprechen und wie mit Unterbrechungen umgehen?
Echtzeit-Interaktion erfordert, dass das Modell genau beurteilt, wann es antwortet, wartet und wie es Unterbrechungen mitten im Prozess verarbeitet.
Um diese Probleme zu lösen, arbeitet der Übersichtsbeitrag systematisch die Mechanismen der Antwortzeitsteuerung, der Gesprächsrundenverwaltung und der Wiederherstellung nach Unterbrechungen auf und analysiert, wie vorhandene Methoden Sprache, visuelle Informationen, Semantik und Aufgabenstatus kombinieren, um dynamische Interaktionsentscheidungen zu treffen.
Auf Trainingsebene fasst der Artikel zusammen, wie Interaktionssignale wie Pausen, Zustimmungsäußerungen, Sprachüberlappungen, Korrekturen und Stille genutzt werden können, damit das Modell nicht nur lernt, was es antworten soll, sondern auch wann es antworten soll.
Für die Wiederherstellung der Interaktion nach einer Unterbrechung leitet der Übersichtsbeitrag sechs zentrale Schritte ab:
Detect (Erkennen): Feststellen, ob der Nutzer tatsächlich eine Unterbrechung auslöst, und zwischen gültigen Anweisungen und Hintergrundgeräuschen unterscheiden.
Yield (Sprachgewalt abgeben): Die aktuelle Sprachausgabe rechtzeitig stoppen oder reduzieren.
Rollback (Zurücksetzen): Den Inhalt ausrichten, den der Nutzer tatsächlich gehört hat.
Cancel (Abbrechen): Veraltete Aufgaben beenden.
Revise (Überarbeiten): Absicht und Aufgabe gemäß der neuen Anweisung aktualisieren.
Resume (Fortsetzen): Die Interaktion auf Basis des aktualisierten Zustands fortsetzen.
Intelligenz und Interaktion gleichermaßen berücksichtigen
Angesichts komplexer Schlussfolgerungen und Tool-Aufrufe kann eine zu frühe Antwort des Modells zu unzureichenden Informationen führen, während das Warten auf den Abschluss der Berechnung das Interaktionserlebnis beeinträchtigt.
Der Übersichtsbeitrag fasst dieses Problem als Kompromiss zwischen Intelligenz und Interaktivität (Intelligence–Interactivity Trade-off) zusammen: In der Trainingsphase steht der Einfluss der Interaktionsadaption auf die ursprünglichen Fähigkeiten im Vordergrund, während im Laufzeitbetrieb die Balance zwischen Antwortgeschwindigkeit und Antwortqualität hergestellt werden muss.
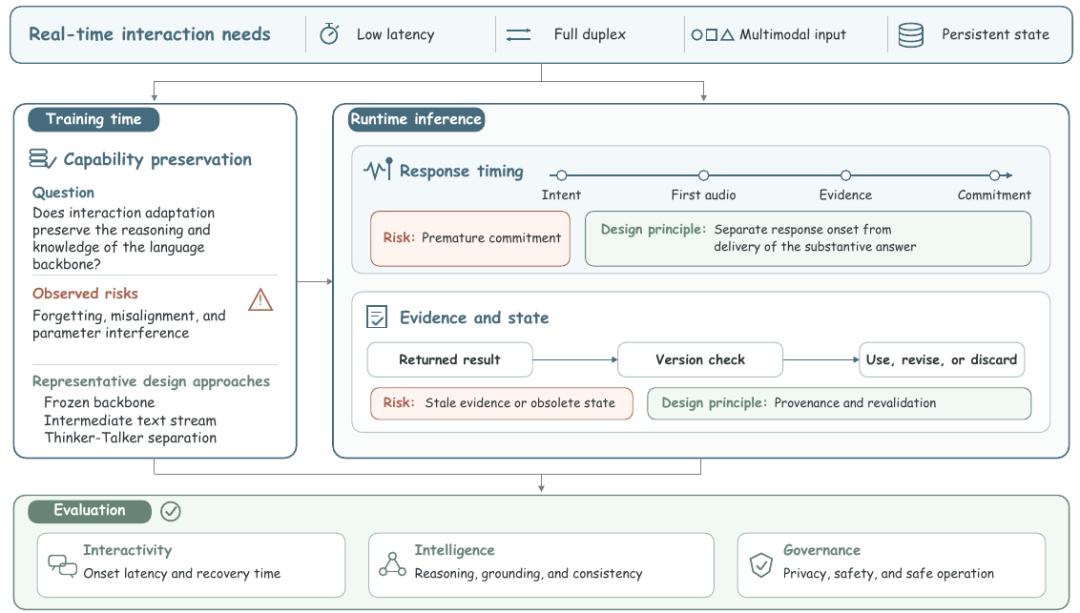
Abbildung 3|Der Kompromiss zwischen Intelligenz und Interaktivität: In der Trainingsphase steht die Erhaltung der Fähigkeiten im Vordergrund, im Laufzeitbetrieb der Antwortzeitpunkt und die Qualität der Aufgabenerfüllung. Quelle: Abbildung 14 des Papers.
Um diesen Kompromiss zu bewältigen, diskutiert der Übersichtsbeitrag weiter über die Multi-Rate Interactive Intelligence (interaktive Intelligenz mit mehreren Zeitskalen), die durch Koordination von schnellen Antworten und langsamerem Schlussfolgern, Abruf und Tool-Aufruf sowohl die Echtzeitfähigkeit der Interaktion als auch die Verarbeitungsfähigkeit für komplexe Aufgaben berücksichtigt.
Ein Umsetzungsgedanke ist die Koordination von Vorder- und Hintergrund: Der Vordergrund übernimmt die kontinuierliche Wahrnehmung und schnelle Antwort, während der Hintergrund komplexe Schlussfolgerungen und Tool-Aufgaben asynchron ausführt und durch Zustandssynchronisation die Verwendung veralteter Berechnungsergebnisse vermeidet.
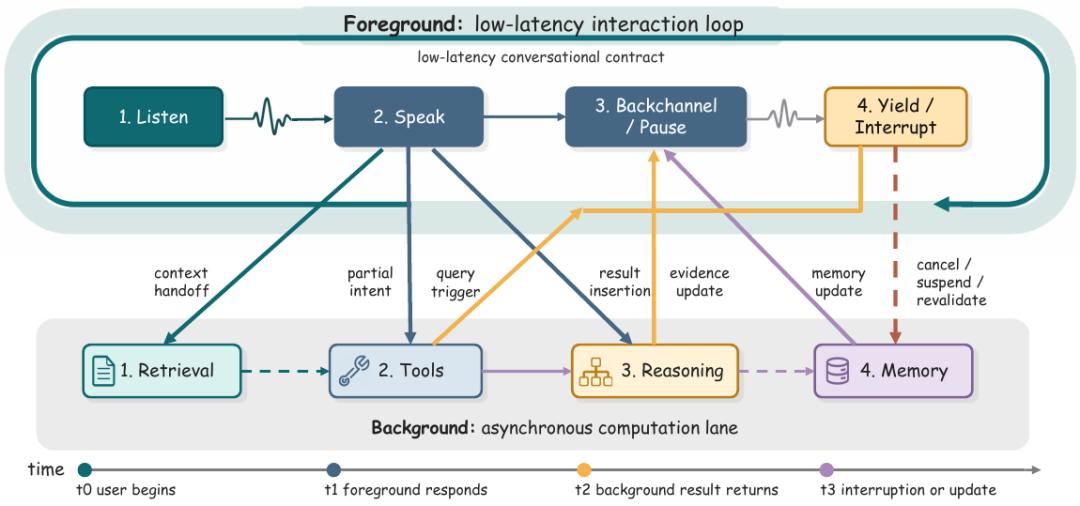
Abbildung 4|Der Vordergrund hält eine Interaktion mit niedriger Latenz aufrecht, der Hintergrund führt asynchron Abruf, Tool-Aufruf, Schlussfolgerung und Gedächtnisoperationen aus. Quelle: Abbildung 6 des Papers.
Bewertung und Ausblick
Angesichts des Problems, dass vorhandene Bewertungsmethoden Antwortqualität und Interaktionsverhalten nicht gleichzeitig messen können, arbeitet der Übersichtsbeitrag vorhandene Bewertungsmethoden systematisch aus sechs Dimensionen auf: Latenz, Zeitpunktqualität, Inhaltsqualität, Robustheit, Qualität langer Gespräche und Wiederherstellungsfähigkeit. Er betont, dass Intelligenzniveau und Interaktionsleistung gleichzeitig in vergleichbaren Interaktionsszenarien und mit gleichem Ressourcenbudget gemessen werden müssen.
Der Übersichtsbeitrag fasst weiter vier vielversprechende zukünftige Richtungen zusammen:
Koordination mehrerer Zeitskalen: Koordination von Wahrnehmung, Schlussfolgern und Interaktion auf verschiedenen Zeitskalen.
Kontinuierlicher Zustand und Langzeitgedächtnis: Aufrechterhaltung des Aufgabenstatus und des Gedächtnisses bei lang andauernden Interaktionen.
Aktive und soziale Interaktion: Beurteilung des Zeitpunkts für aktive Antworten und Verständnis von Rollen und Berechtigungen in Mehrpersonen-Interaktionen.
Sicherheit und Effizienz in offenen Umgebungen: Gleichzeitige Berücksichtigung von Sicherheit, Berechnungskosten und Systemzuverlässigkeit.
Der Weg von „können hören, sehen und sprechen“ hin zu kontinuierlichem Verstehen, rechtzeitigem Antworten und dynamischer Anpassung von Handlungen ist die wichtige Forschungsrichtung der nächsten Stufe der echtzeit-interaktiven allmodalen Intelligenz.
Referenzmaterialien:
https://doi.org/10.13140/RG.2.2.20245.69602
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto AI Era, Autor: LRST, veröffentlicht mit Genehmigung von 36Kr.