EMNLP'26: Selbst GPT kann nicht "die Luft lesen", ein Werwolf-Spiel-Benchmark deckt seine sozialen Blindstellen auf
Wenn ein Mensch sagt „Ich bin kein Wolf“, kann ein multimodales großes Sprachmodell sowohl den Gesichtsausdruck sehen als auch die Stimme hören. Aber weiß es wirklich, ob diese Aussage wahr oder falsch ist?
Kürzlich hat ein Forschungsteam der Universität Tokio den multimodalen interaktiven Täuschungsbewertungs-Benchmark MIDA (Multimodal Interactive Deception Assessment) vorgeschlagen, der die Fähigkeit von quelloffenen und geschlossenen Modellen wie GPT, Gemini, Claude, Qwen und DeepSeek zur Beurteilung von Täuschungen in sozialen Interaktionen mehrerer Personen systematisch testet.
Die Ergebnisse zeigen, dass selbst die derzeit leistungsstärksten multimodalen großen Modelle kaum in der Lage sind, Wahrheiten und Lügen zuverlässig zu unterscheiden. Sie können Bilder, Töne und Texte verstehen, aber es ist nicht unbedingt möglich, herauszufinden, was eine Person zu diesem Zeitpunkt „wusste, glaubte und versuchte, andere glauben zu lassen“.
Die entsprechende Studie wurde von der Hauptkonferenz der EMNLP 2026 angenommen.
Link zum Papier: https://arxiv.org/abs/2511.16221
Projekt-Homepage: https://ut-vision-social.github.io/
Code-Adresse: https://github.com/kkkcx/Can-MLLMs-Read-the-Room
Adresse des Datensatzes: https://huggingface.co/datasets/Ukpkmkkk/MIDA
Die Autoren des Papiers, Kang Caixin, Huang Yifei, Ouyang Liangyang, Zhang Mingfang, Liu Ruicong und Sato Yoichi, stammen alle von der Universität Tokio. Das Team befasst sich mit multimodalem Verständnis, Videoanalyse und sozialer Intelligenz, und diese Studie konzentriert sich hauptsächlich auf die Täuschungsbeurteilung und mentale Schlussfolgerung in komplexen Interaktionen mehrerer Personen.
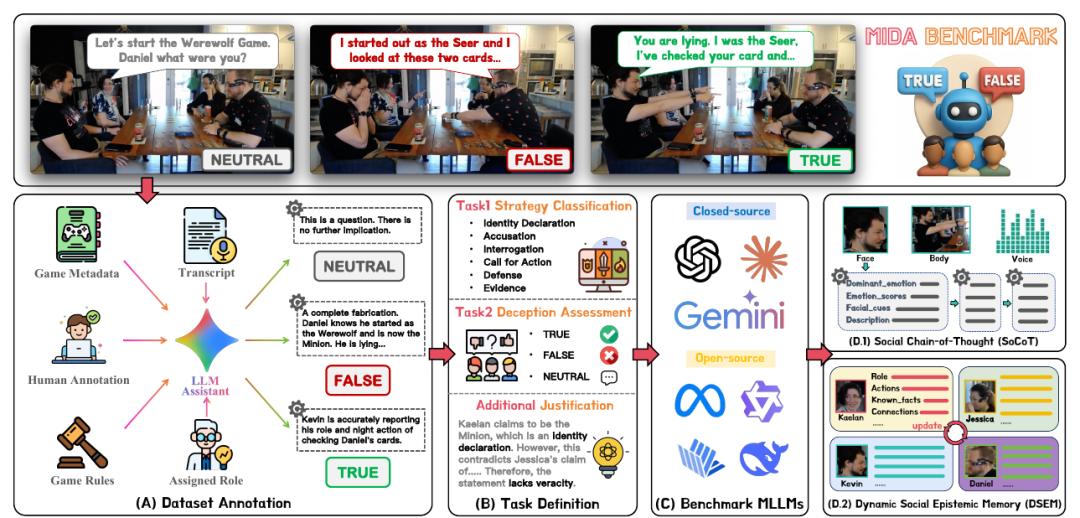
Abbildung 1: Gesamtrahmen von MIDA. Links befindet sich der Konstruktionsprozess von Labels basierend auf Spielaufzeichnungen, Regeln und manuell annotierten Daten; in der Mitte liegen die Strategieklassifizierung und die Täuschungsbeurteilungsaufgabe; rechts befinden sich die Bewertungsmodelle und die beiden Inferenzmodule SoCoT und DSEM.
Mit dem Spiel Werwolf der Nacht eine Standardantwort für „Lügen“ erstellen
Frühere Studien zur Täuschungserkennung konzentrierten sich größtenteils auf einzelne Aussagen oder Gespräche zwischen zwei Personen. Aber Lügen im wirklichen Leben treten normalerweise nicht isoliert auf, sie sind oft in Nachfragen, Stellungnahmen, Verteidigungen und Gruppendruck eingebettet und ändern sich ständig mit neuen Informationen.
Das schwierigere Problem ist, dass es im wirklichen Leben normalerweise keine absolut zuverlässige Standardantwort dafür gibt, ob eine Aussage eine Lüge ist.
Das Forschungsteam hat das Spiel „One Night Ultimate Werewolf“ als Experimentumgebung gewählt, genau weil dieses Spiel beide oben genannten Probleme löst.
Im Spiel hat jeder Spieler eine versteckte Identität, die Aktionen in der Nacht bestimmen, welche Informationen der Spieler kennt, und die Äußerungen am Tag spiegeln sein Urteil und seine Strategie wider. Da Rollen, Aktionen und Spielregeln zurückverfolgt werden können, können die Forscher beurteilen, ob eine bestimmte Aussage den Informationen widerspricht, die der Sprecher zu diesem Zeitpunkt beherrschte.
Daher beurteilt MIDA nicht, ob eine Person „wie ein Lügner aussieht“, sondern was sie trotz ihres Wissens gesagt hat.
MIDA-Benchmark
MIDA umfasst insgesamt 2360 Äußerungen. Davon stammen 819 aus 40 Offline-Spielen in Ego4D und 1541 aus 151 YouTube-Spielvideos.
Die beiden Teilmengen bilden einen natürlichen Schwierigkeitsgrad: Die Teilnehmer in Ego4D sind hauptsächlich Anfänger, während die Spieler in den YouTube-Videos erfahrener sind und besser darin, komplexe Täuschungsstrategien anzuwenden.
Jede Probe enthält Video, Audio, Gesprächsverlauf und Spielregeln und ist als wahr, falsch oder neutral annotiert. „Neutral“ bedeutet hier nicht, dass die Einstellung der Aussage neutral ist, sondern dass sie keine Fakten enthält, die anhand des aktuellen Wissensstands des Sprechers überprüft werden können, wie z. B. Fragen, Vermutungen, Meinungen oder Hypothesen.
Um überprüfbare Labels zu erhalten, zeichnet das Forschungsteam zunächst manuell die nächtlichen Aktionen im Spiel auf, generiert und überprüft dann die Labels jeder Äußerung in Kombination mit Rollen, Regeln und Gesprächsinhalt.
Es ist zu beachten, dass Rollen, nächtliche Aktionen und Abstimmungsergebnisse nur zum Erstellen überprüfbarer Ground-Truth-Labels verwendet werden und den Modellen in der Testphase nicht zur Verfügung gestellt werden. Die Modelle müssen weiterhin anhand von Video, Audio und Gesprächsverlauf selbst ableiten, welche Informationen der Sprecher beherrscht und was seine wahre Absicht ist. Daher bieten die Spielregeln eine kontrollierte und überprüfbare Bewertungsumgebung, keine Abkürzung, die den Modellen hilft, direkt die Antworten zu erhalten.
Neben der Beurteilung von Wahrheit und Falschheit verlangt MIDA von den Modellen auch, die Überzeugungsstrategien zu erkennen, die in den Äußerungen verwendet werden, darunter Identitätserklärung, Anschuldigung, Verteidigung, Beweis, Befragung und Handlungsaufforderung.
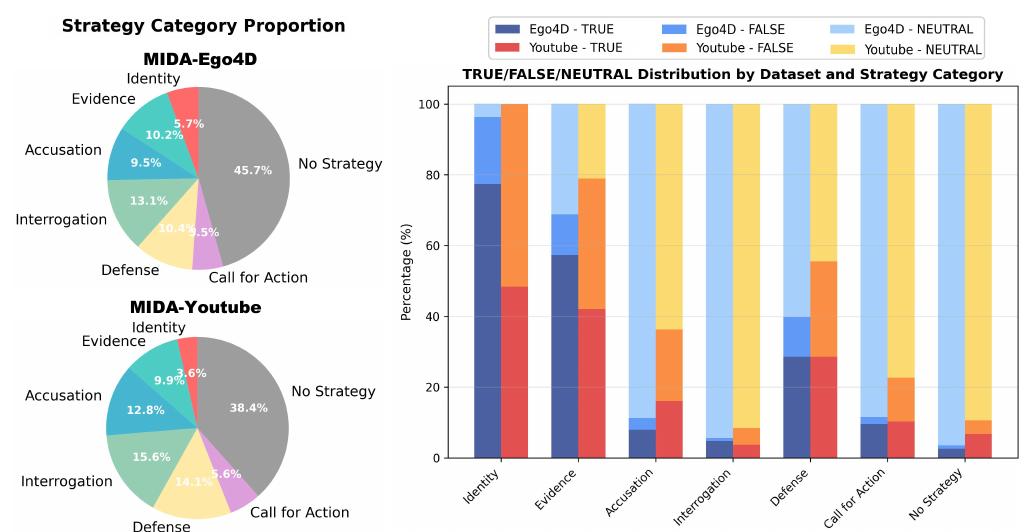
Abbildung 2: Anteil verschiedener Überzeugungsstrategien in den beiden Datenteilmengen und Verteilung der Labels TRUE, FALSE und NEUTRAL. Identitätserklärungen und beweisbasierte Äußerungen enthalten mehr überprüfbare Informationen, während Befragungen und Äußerungen ohne klare Strategie größtenteils zu NEUTRAL gehören.
Experimentelle Ergebnisse: Die Gesamtgenauigkeit kann täuschend sein
Die Studie deckt Modelle wie GPT-4o, GPT-5, Gemini, Claude sowie Llama, InternVL, Qwen und DeepSeek ab.
Aus Sicht der Gesamtgenauigkeit scheinen die Leistungen einiger Modelle nicht schlecht zu sein. Auf der Ego4D-Teilmenge erreicht die Gesamtgenauigkeit von GPT-4o 74,0 %, die von Qwen2.5-VL-7B 76,4 %.
Aber in MIDA gibt es eine große Anzahl neutraler Äußerungen. Solange das Modell häufig „neutral“ wählt, kann es eine scheinbar gute Gesamtpunktzahl erzielen.
Wenn die Forscher nur die Proben behalten, bei denen Wahrheit oder Falschheit beurteilt werden muss, ändern sich die Ergebnisse deutlich: Die binäre Klassifizierungsgenauigkeit von GPT-4o beträgt nur 27,6 %, die von GPT-4o-mini nur 39,4 %. Obwohl Qwen2.5-VL-7B die höchste Gesamtgenauigkeit aufweist, beträgt sein F1-Wert für „falsche Äußerungen“ 0.
Mit anderen Worten: Ein Modell kann die meiste Zeit „nicht beurteilbar“ antworten, wodurch es eine hohe Gesamtgenauigkeit erhält, aber trotzdem keine Lügen wirklich erkennen kann.
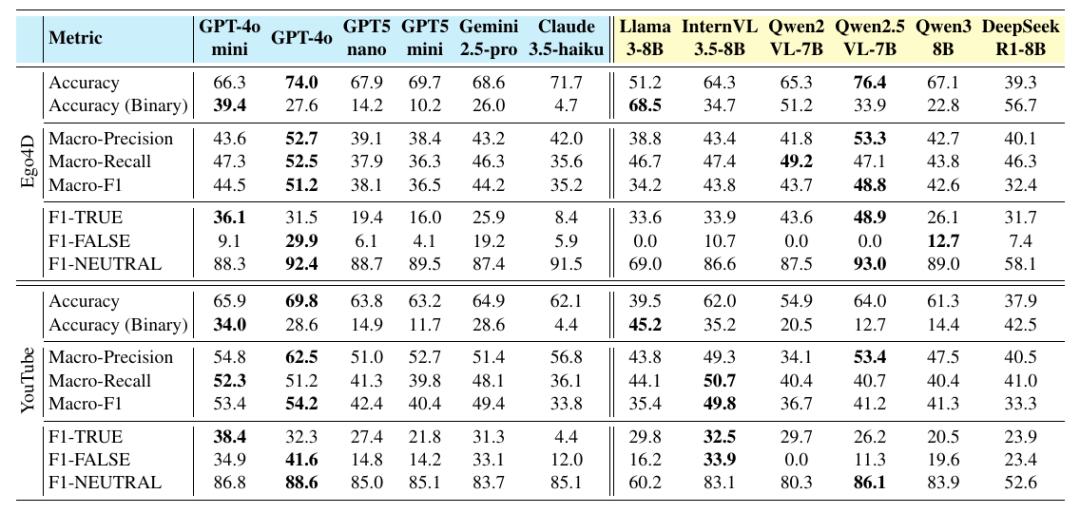
Tabelle 1: Wichtigste Bewertungsergebnisse verschiedener Modelle auf MIDA-Ego4D und MIDA-YouTube. Es gibt einen deutlichen Unterschied zwischen der Gesamtgenauigkeit und der binären Klassifizierungsgenauigkeit, die nur die TRUE- und FALSE-Proben untersucht.
Die Äußerungen, die am meisten soziale Schlussfolgerung erfordern, sind genau die Teile, bei denen die Modelle am schlechtesten abschneiden.
Bei Äußerungen der Kategorie „Identitätserklärung“ liegt die durchschnittliche Genauigkeit aller Modelle auf den beiden Teilmengen nur bei 15,7 % bzw. 25,3 %; bei Äußerungen mit Beweisen liegt die durchschnittliche Genauigkeit jeweils unter 40 %. Die Modelle erkennen vielleicht, dass „diese Aussage jemanden anklagt“, wissen aber nicht unbedingt, ob diese Anschuldigung wahrscheinlich zutrifft.
Erfahrene Spieler erhöhen den Schwierigkeitsgrad weiter. Der Anteil falscher Beweise, der von YouTube-Spielern vorgelegt wird, beträgt 36,8 %, fast das Dreifache des Werts von Anfängerspielern; der Anteil von Identitätslügen beträgt 51,6 %, was ebenfalls weit über dem Wert von 18,9 % bei Anfängern liegt.
Gesprächsverlauf ist wichtiger als „Mikroausdrücke“
Das Forschungsteam hat die Rolle verschiedener Informationen durch Ablationsexperimente analysiert.
Nach dem Entfernen des vorherigen Gesprächsverlaufs sank die Genauigkeit von GPT-4o-mini bei Wahr-Falsch-Proben von 39,4 % abrupt auf 13,4 %.
Dies zeigt, dass das Erkennen, ob eine Aussage eine Frage, eine Verteidigung oder eine Anschuldigung ist, nur die Beobachtung des lokalen Textes erfordern kann; um zu beurteilen, ob diese Aussage wahr oder falsch ist, muss man sich merken, wer was gesagt hat, wer was weiß und ob die Aussagen verschiedener Spieler sich gegenseitig bestätigen können.
Mehr visuelle Informationen sind auch nicht immer besser. Nach dem Hinzufügen eines Bildes stieg der makro-durchschnittliche F1-Wert des Modells um 2,5 Prozentpunkte; nach der Erhöhung auf drei Bilder verkleinerte sich der Gewinn dagegen auf 2,1 Prozentpunkte.
Mehr Bilder bringen mehr Ausdrücke und Handlungen, aber auch mehr Rauschen. Obwohl das Modell diese Hinweise „sieht“, weiß es nicht unbedingt, welche Hinweise wirklich wichtig sind.
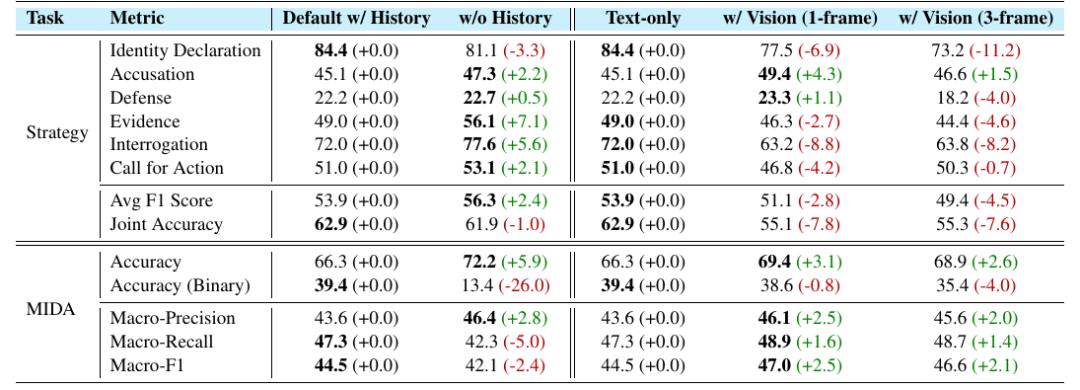
Tabelle 2: Ablationsexperiment zum Gesprächsverlauf und zur Anzahl der visuellen Bilder. Nach dem Entfernen des Gesprächsverlaufs sank die binäre Klassifizierungsgenauigkeit von MIDA von 39,4 % auf 13,4 %; die Erhöhung der Anzahl visueller Bilder brachte keinen anhaltenden Gewinn.
Forschungsmethodik
Um die oben genannten Probleme zu lösen, hat das Forschungsteam zwei Module entworfen: Social Chain of Thought (SoCoT) und Dynamic Social Cognitive Memory (DSEM).
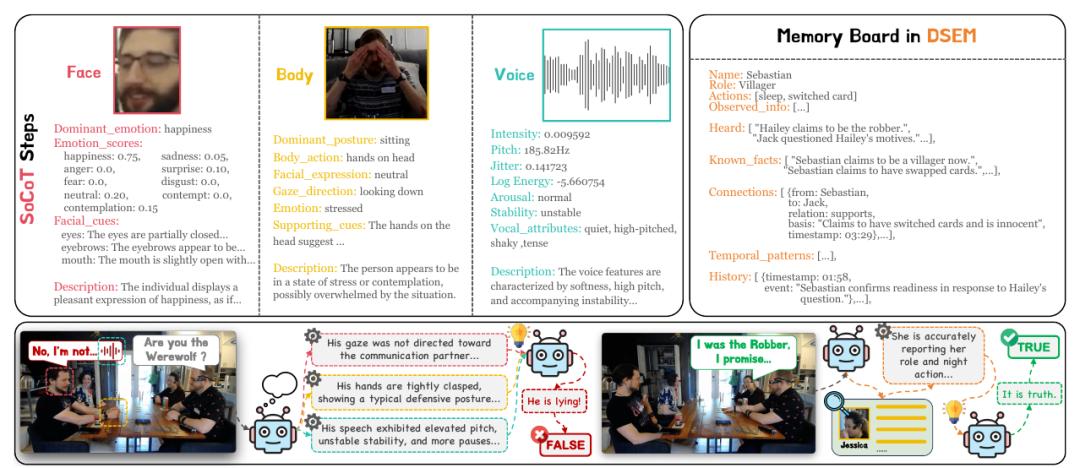
Abbildung 3: SoCoT wandelt Gesicht, Körper und Stimme in strukturierte Hinweise um; DSEM verwaltet den sich im Laufe der Zeit ändernden Wissensstand, die Äußerungen und den Beziehungsstatus jedes Teilnehmers.
SoCoT verlangt von dem Modell, zuerst Gesichtsausdrücke, Körperhaltungen und Stimmmerkmale zu beschreiben, dann die Ziele und den psychischen Zustand des Sprechers zu schließen und schließlich das Wahr-Falsch-Urteil abzugeben.
Dieser Prozess entspricht der Zerlegung von Intuitionen wie „seine Stimme zittert beim Sprechen, also ist wahrscheinlich etwas falsch“ in überprüfbare Inferenzschritte.
Dennoch verbessern nicht-sprachliche Hinweise nicht immer die Beurteilungsfähigkeit. Am Beispiel von GPT-4o-mini: Bei der Analyse nur von Gesichtshinweisen stieg die Gesamtgenauigkeit des Modells um 8 Prozentpunkte, aber die binäre Klassifizierungsgenauigkeit für Wahr und Falsch sank um 7,1 Prozentpunkte.
Verhaltensweisen wie Nervosität und Vermeidung von Augenkontakt, die „verdächtig“ erscheinen, sind nicht gleichbedeutend mit Lügen. Selbst wenn das Modell diese Verhaltensweisen erfolgreich erkennt, kann es sie falsch interpretieren.
DSEM verfolgt einen anderen Ansatz: Für jeden Spieler wird ein ständig aktualisiertes „Gedächtnisbrett“ verwaltet, das seine Rollenerklärung, Aktionen, Beobachtungen, bekannte Fakten, Personenbeziehungen und den Zeitablauf der Ereignisse aufzeichnet.
Bei einer neuen Äußerung analysiert das Modell nicht nur das aktuelle Bild, sondern prüft ständig: Was sollte diese Person zu diesem Zeitpunkt wissen? Steht seine Aussage im Widerspruch zu früheren Informationen? Können die Äußerungen anderer Spieler sie unterstützen?
In den Experimenten war die Verbesserung durch DSEM stabiler. Sie erhöhte die binäre Klassifizierungsgenauigkeit von GPT-4o-mini um 2,3 Prozentpunkte und den makro-durchschnittlichen F1-Wert um 3,3 Prozentpunkte; bei Qwen2.5-VL-7B stieg die makro-durchschnittliche Präzision um 7,6 Prozentpunkte.
Im Vergleich dazu, „Schwachstellen“ in den Ausdrücken eines bestimmten Moments zu suchen, scheint die kontinuierliche Verfolgung des Wissensstands und der Position jeder Person der Art des sozialen Schlussfolgerns näher zu kommen, die Menschen tatsächlich verwenden.