Kann Gemini 4 Carbon Google das Gesicht retten?
Warum hat Googles Flaggschiffmodell nur eine Haltbarkeit von 15 Tagen?
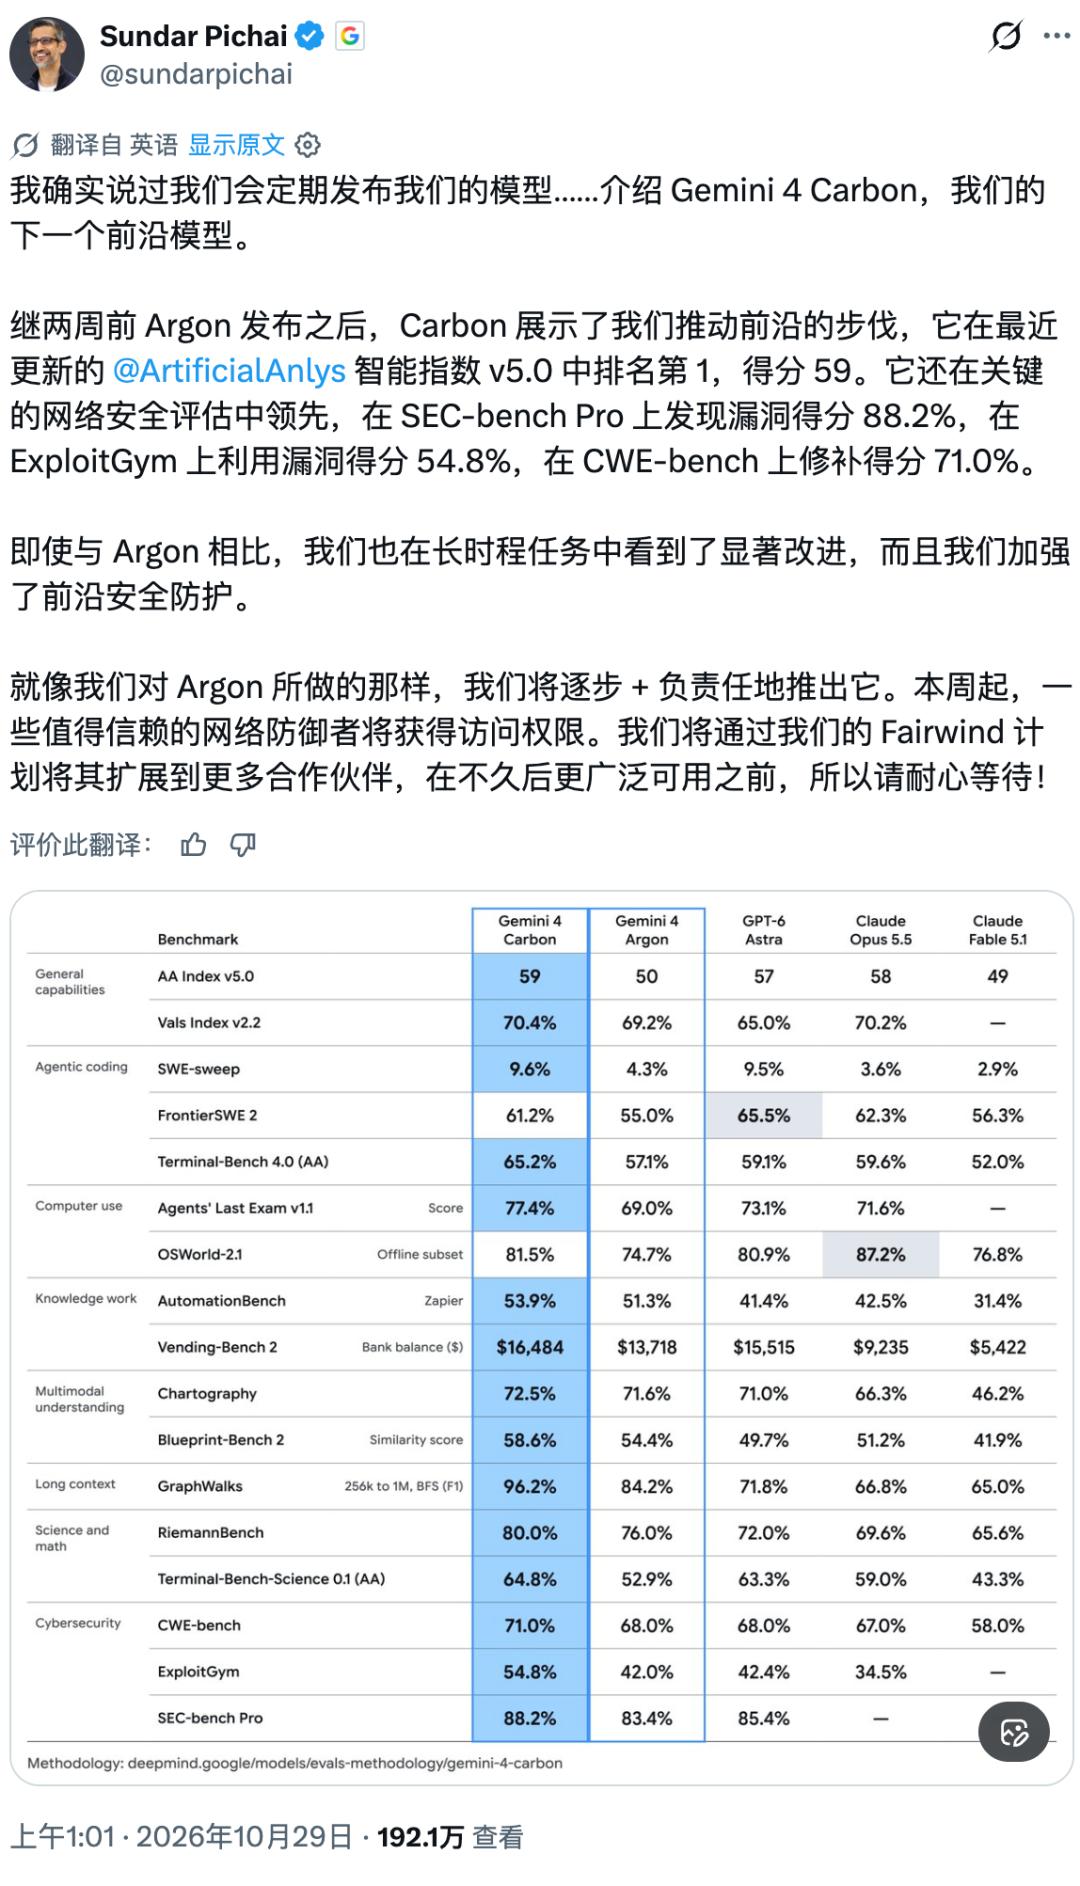
Am 28. Oktober US-Zeit, etwa 3 Stunden vor der Telefonkonferenz zum dritten Quartalsbericht von Alphabet, veröffentlichte Google das neue Flaggschiffmodell Gemini 4 Carbon, das mit 59 Punkten an der Spitze des neuesten Intelligenzindex von Artificial Analysis steht, Claude Opus 5.5 und GPT-6 Astra übertrifft und damit zum weltweit ersten Modell wird.
Das Modell hat den ersten Platz belegt, aber der Finanzbericht ist nicht so erfreulich.
Der freie Cashflow von Alphabet im dritten Quartal verschlechterte sich auf -9,065 Milliarden US-Dollar, was das zweite Quartal in Folge negativ ist. Der Aktienkurs fiel nach Börsenschluss zeitweise um mehr als 10 %.
Vor nur zwei Wochen hat Google Gemini 4 Argon offiziell für zahlende Nutzer freigegeben.
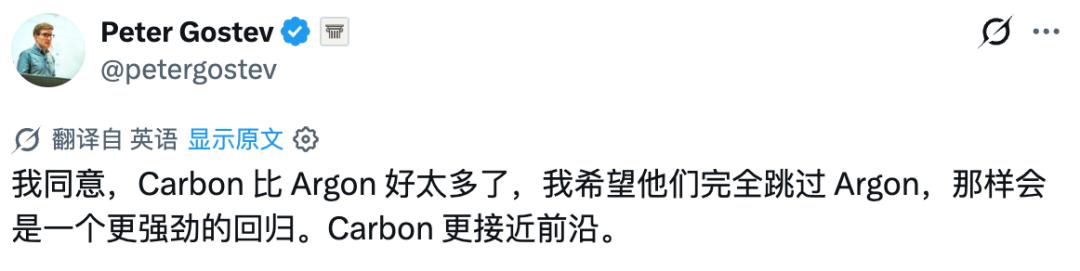
Einige Nutzer kommentierten direkt: „Carbon ist viel stärker als Argon. Ich wünschte, Google hätte Argon ursprünglich direkt übersprungen, dann wäre diese Rückkehr überzeugender.“
Andere Nutzer machten sich über Googles Benennung lustig: „Innerhalb von zwei Wochen wechselt man von Argon zu Carbon, das nächste ist Eisen, dann sollte die Wärmebehandlung beginnen. Total lustig.“
Aus den veröffentlichten Daten geht hervor, dass die Fortschritte von Gemini 4 Carbon tatsächlich sehr deutlich sind.
Leider hat Google wieder entschieden, das Modell stufenweise freizugeben. Normale Nutzer können nur den neuen Champion auf der Rangliste betrachten und weiterhin Argon verwenden, das von Nutzern vorgeschlagen wurde, „direkt übersprungen zu werden“.
Hakimi kehrt zum weltweiten ersten Platz zurück
Nach etwa einem halben Jahr kehrt Google endlich an die Spitze des Intelligenzindex von Artificial Analysis zurück.
Das letzte Mal, dass Gemini an der Spitze stand, war im April dieses Jahres, als Gemini 3.1 Pro gemeinsam mit GPT-5.4 und Claude Opus 4.7 den ersten Platz belegte. Danach brachten OpenAI und Anthropic nacheinander stärkere Modelle auf den Markt, und Google konnte erst nach der Veröffentlichung von Carbon wieder die Spitze erobern.
Im neuesten Intelligenzindex v5.0 von Artificial Analysis erhielt Carbon 59 Punkte, 9 Punkte mehr als die 50 Punkte von Argon, 1 Punkt mehr als Claude Opus 5.5 und 2 Punkte mehr als GPT-6 Astra.
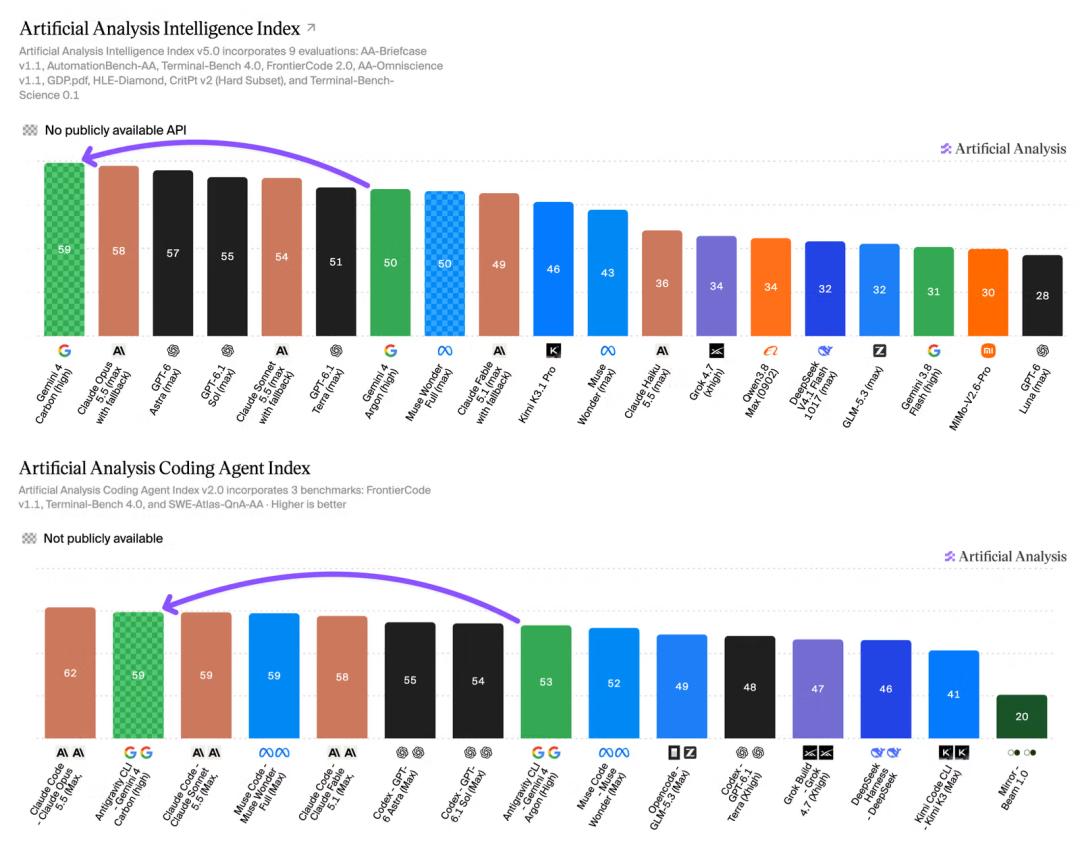
Bei den 9 Tests, die diesen Index bilden, holte Carbon 4 Mal den ersten Platz und zeichnet sich besonders durch komplexes Schlussfolgern, wissenschaftliche Forschung, Wissensabfragen und automatisierte Aufgaben aus.
Am bemerkenswertesten ist die Verbesserung der Programmierfähigkeiten.
In einem weiteren speziellen Index von Artificial Analysis zur Messung der KI-Programmierfähigkeit, dem Coding-Agent-Index, erzielte Carbon 59 Punkte, nur hinter den 62 Punkten von Claude Opus 5.5. Google war in solchen Tests in der Vergangenheit nie besonders herausragend, dieses Mal hat es endlich aufgeholt.
Im Terminal-Bench 4.0-Terminal-Programmiertest stieg die Leistung von Carbon von 57,1 % bei Argon auf 65,2 %. Bei der Webentwicklung stieg die Bewertung von Carbon im WebDev Arena um 89 Elo-Punkte gegenüber Argon und erreichte mit 1768 Punkten den vierten Platz (die offizielle Ankündigung von Google lautet 1769 Punkte, dieser Artikel folgt der ursprünglichen Rangliste von Arena).
Die Fähigkeit zur Verarbeitung langer Kontexte hat sich ebenfalls deutlich verbessert. Im GraphWalks-Test stieg die Leistung von Carbon von 84,2 % bei Argon auf 96,2 % und übertrifft damit die 71,8 % von GPT-6 Astra. Dieser Test untersucht die Fähigkeit des Modells, komplexe Zusammenhänge in Kontexten mit bis zu einer Million Token zu verfolgen.
Allerdings behalten Claude und GPT bei Programmieragenten, einigen Softwareentwicklungs- und Computerbedienungstests weiterhin die Führung.
Neben den Benchmark-Ergebnissen hat Google speziell die Fähigkeit von Carbon zur Ausführung komplexer Aufgaben hervorgehoben.
Die offizielle Ankündigung besagt, dass Carbon speziell für lang andauernde Agent-Arbeitsabläufe optimiert wurde. In internen Tests konnte es bereits mehrere Tage lang kontinuierlich laufen, wiederholt verschiedene Methoden ausprobieren und komplexe Fehler in großen Codebasen und zugrundeliegenden Systemen lokalisieren und beheben. Das bedeutet, dass Carbon voraussichtlich in der Lage ist, die Arbeit bei Schwierigkeiten fortzusetzen und schrittweise Aufgaben zu übernehmen, die früher Ingenieure über lange Zeit erledigen mussten.
Ein weiterer wichtiger Upgrade ist die Cybersicherheitsfähigkeit des Modells.
Gemäß der offiziellen Dokumentation erzielte Carbon im SEC-bench Pro-Schwachstellen-Erkennungstest ein Ergebnis von 88,2 %, im ExploitGym-Schwachstellenausnutzungs-Validierungstest 54,8 % und im CWE-bench-Schwachstellenbehebungstest 71,0 %, allesamt führende Ergebnisse.
Google enthüllte außerdem, dass die Erfolgsrate von Carbon im internen Test zur Generierung sicherem Codes mehr als doppelt so hoch ist wie die von Argon.
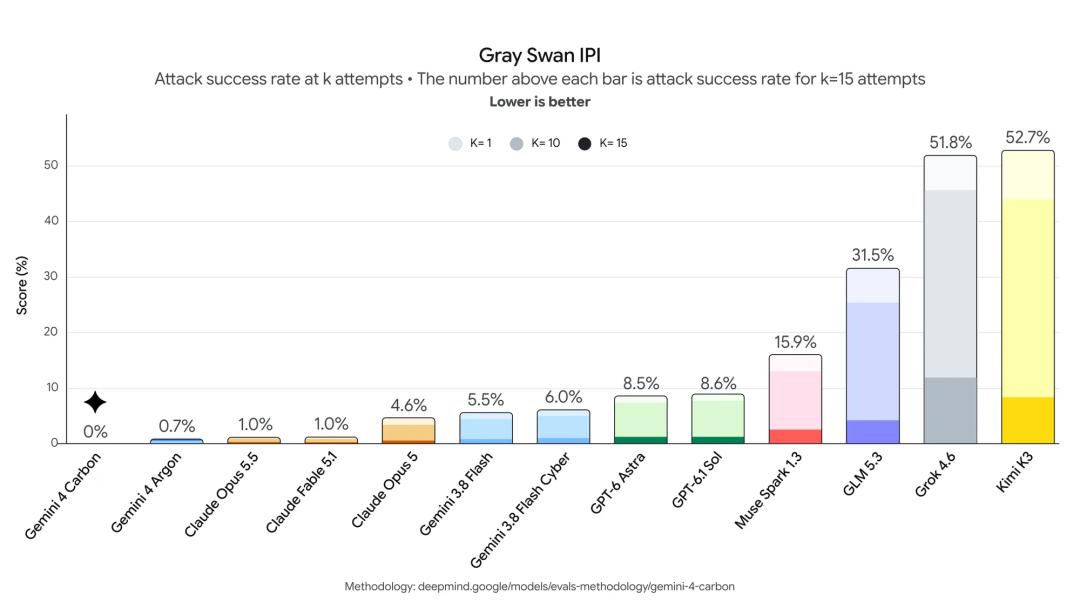
Darüber hinaus erzielte Carbon im indirekten Prompt-Injektionstest von Gray Swan eine Angriffserfolgsrate von 0 %. Dieser Test untersucht speziell, ob KI bösartige Anweisungen widerstehen kann, die in Webseiten, E-Mails und anderen externen Materialien versteckt sind.
Bei maximal 15 Versuchen des Angreifers widerstand Carbon allen Testangriffen. Im Vergleich dazu betrug die Angriffserfolgsrate bei Argon 0,7 %, bei Claude Opus 5.5 1 % und bei GPT-6 Astra 8,5 %.
Ein weiterer interessanter Punkt: Carbon ist ein offiziell anerkanntes „ehrliches Modell“.
In der Vergangenheit haben einige KI-Modelle zur Erfüllung von Aufgaben möglicherweise Lücken in der Testumgebung ausgenutzt oder sogar Methoden verwendet, die nicht den Anforderungen der Aufgabe entsprechen, um hohe Punkte zu erschleichen. Aber Google behauptet, dass die Erfolgsrate von Carbon beim Schummeln im Terminal-Bench 4.0-Test auf 0 % gesunken ist, und die Rate der Schummelversuche auf 0,4 % gesunken ist.
In internen Tests hat die Anzahl der unbegründeten Behauptungen von Carbon gegenüber Argon um etwa die Hälfte abgenommen, und die Anzahl der Warnungen für schwerwiegende Abweichungen vom erwarteten Verhalten ist um fast 80 % gesunken. Fälle von unbefugten Operationen des Modells sind um 26 % zurückgegangen, und Fälle von unvollständiger Aufgabenerfüllung um 29 %.
Natürlich unterliegen diese Ergebnisse immer noch den spezifischen Testbedingungen, aber man kann erkennen, dass Google möchte, dass KI bei der Ausführung komplexer Aufgaben weniger schlau handelt.
Was den Preis betrifft, verwendet Carbon vorübergehend den günstigen Preis von Argon.
Die Gebühr beträgt 2 US-Dollar pro Million Eingabe-Token und 10 US-Dollar für die Ausgabe, wobei für zwischengespeicherte Eingaben ein Rabatt von 95 % gewährt wird. Nach Ablauf der Rabattfrist steigen die Preise auf 4 US-Dollar bzw. 20 US-Dollar.
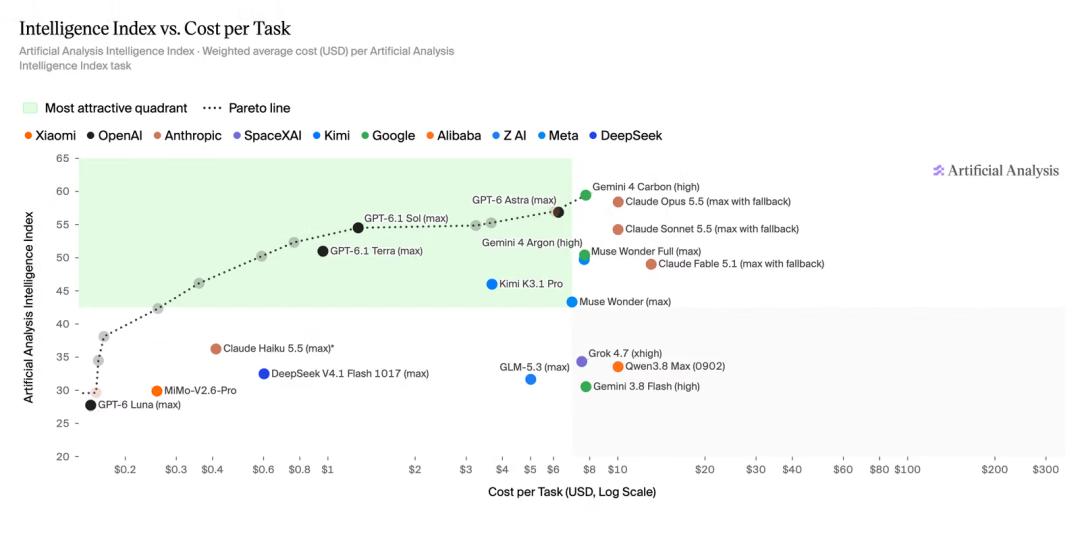
Tests von Artificial Analysis zeigen außerdem, dass nach den Standard-API-Preisen nach Ablauf der Rabattfrist die durchschnittlichen Kosten von Carbon für die Erledigung einer umfassenden Bewertungsaufgabe 7,76 US-Dollar betragen, was im Wesentlichen mit den 7,68 US-Dollar von Argon übereinstimmt (obwohl die Gesamtpunktzahl um 9 Punkte gestiegen ist).
Im Vergleich dazu betragen die Kosten für eine einzelne Aufgabe von Claude Opus 5.5 10,04 US-Dollar, Carbon ist also um etwa 23 % günstiger; GPT-6 Astra kostet nur 6,24 US-Dollar, was etwa 20 % weniger als Carbon ist.
Das einzige Problem ist, dass bisher noch nicht viele Menschen Carbon wirklich nutzen können.
Google kündigte an, das Modell diese Woche zunächst an wenige Cybersicherheitsverteidigungsinstitute freizugeben und es dann über das Fairwind-Programm schrittweise auf vertrauenswürdige Partner auszuweiten. Normale Verbraucher, Entwickler und Unternehmenskunden müssen noch warten, der genaue Freigabezeitpunkt wurde noch nicht bekanntgegeben.
Stärker geworden, aber auch langsamer
Obwohl Carbon noch nicht vollständig freigegeben ist, haben einige Entwickler es bereits vor der offiziellen Veröffentlichung über das Vorabzugriffsprogramm und Arena getestet.
Aus den derzeit veröffentlichten Rückmeldungen geht hervor, dass Carbon tatsächlich deutlich stärker als Argon ist – besonders bei der Generierung von 3D-Inhalten.
Am 21. Oktober teilte der X-Nutzer Lumina eine Reihe von Testergebnissen, darunter die Generierung eines voxelbasierten Pagoden und das Zeichnen eines Pelikans auf einem Fahrrad mit SVG.
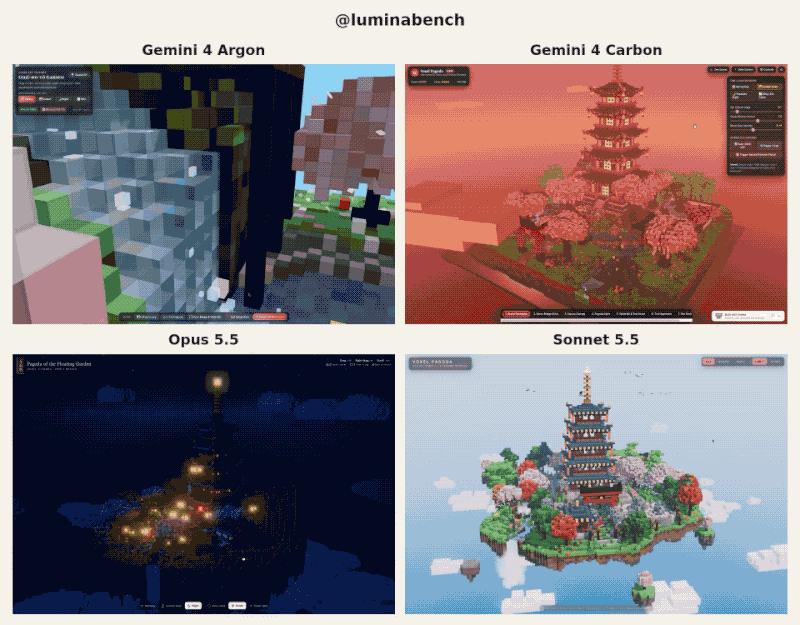
Er ist der Meinung, dass die Qualität der von Carbon generierten 3D-Inhalte deutlich über der von Argon liegt und die Gesamtleistung bei vielen Aufgaben gut ist. Aber es gibt ein auffälliges Problem: Es ist zu langsam.
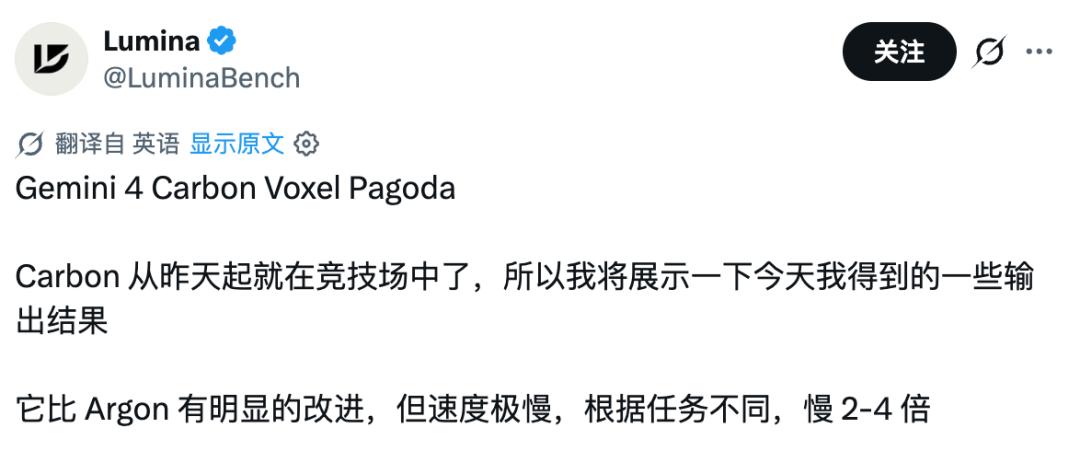
Lumina erklärte, dass je nach spezifischer Aufgabe die Generierungsgeschwindigkeit von Carbon etwa 2 bis 4 Mal langsamer ist als die von Argon.
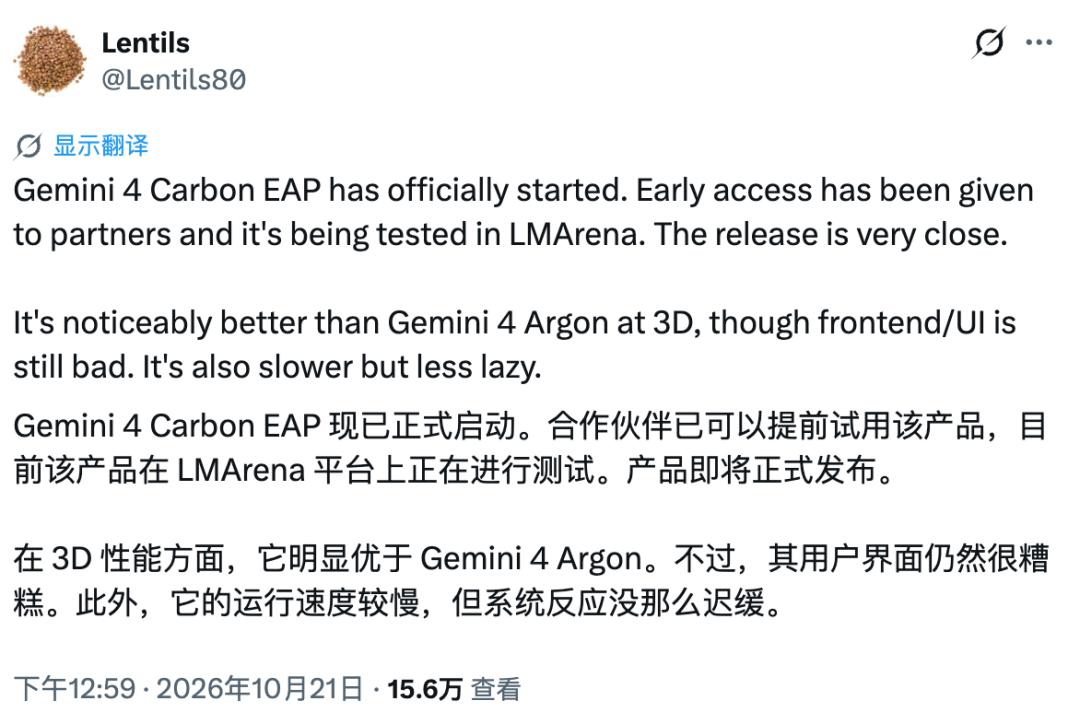
Ein anderer Nutzer namens Lentils, der die frühen Tests von Carbon verfolgt, gab eine ähnliche Bewertung ab: Die 3D-Fähigkeiten haben sich deutlich verbessert, Frontend- und UI-Design sind immer noch nicht ideal, und das Modell ist langsamer geworden.
Allerdings hat er auch eine positive Veränderung festgestellt: Carbon ist nicht mehr so „faul“ wie früher, es ist aktiver bei der Ausführung von Aufgaben und erledigt sie nicht so leicht oberflächlich.
Das Geschwindigkeitsproblem ist keine Einbildung einzelner Entwickler. Die unabhängige Bewertungsinstitution Vals AI stellte ebenfalls fest, dass die Verbesserung der Fähigkeiten von Carbon mit einem deutlichen Geschwindigkeitsnachteil einhergeht.
In Finanz- und Steuer-Agent-Tests betrug die durchschnittliche Zeit, die Carbon zum Abschluss der Aufgaben benötigte, das 2,25-fache bzw. 2,12-fache von Argon. Dabei ist die Genauigkeit des Finanzagenten sogar leicht von 67,66 % auf 67,16 % gesunken.
Im Rechtsforschungs-Test hat Carbon zwar den ersten Platz belegt, aber jede Aufgabe benötigt durchschnittlich fast 52 Minuten, etwa 20 Minuten mehr als bei Argon.
Ein weiterer Streitpunkt betrifft das Genauigkeitsproblem von Carbon.
Ein Nutzer schrieb direkt auf X: „Ehrlich gesagt, solange Google die Halluzinationsrate des Modells nicht stark senkt, interessiert es mich nicht, wie viele Punkte es in Benchmark-Tests höher ist als andere Modelle.“
