Neue Forschung von Apple zum Personal Agent: Dass es Ihnen bei der Erledigung von Aufgaben helfen kann, bedeutet nicht, dass es Sie wirklich versteht.
Der Personal Agent ist inzwischen in der Lage, viele komplexe Vorgänge selbstständig durchzuführen, steht aber bei Entscheidungen vor einem Problem: Wann soll er direkt schlussfolgern, wann muss er den Nutzer nachfragen.
Wenn der Nutzer beispielsweise verlangt, ein Restaurant zu buchen, das er regelmäßig besucht, kann der Agent anhand der historischen Aufzeichnungen erkennen, um welches Restaurant es sich handelt, und auch die Zeit und die Anzahl der Personen für das gemeinsame Essen identifizieren, die bestätigt werden müssen. Wenn er willkürlich rät, kann dies von der tatsächlichen Absicht des Nutzers abweichen; wenn er selbst eindeutige Informationen aus historischen Aufzeichnungen wiederholt abfragt, wird der automatisierte Prozess langwierig und die Nutzungseffizienz sinkt.
In dieser Arbeit hat das Apple-Team iPrefBench vorgeschlagen, das speziell dazu dient, die Fähigkeit mobiler Agenten zum „Schlussfolgern und Nachfragen“ bei solchen unscharfen Anfragen zu bewerten. Dieser Benchmark läuft in einer ausführbaren iOS-Umgebung und umfasst 26 Anwendungen, 130 nicht vollständig spezifizierte Aufgaben sowie 3051 Aktivitätsaufzeichnungen, die um denselben Nutzer herum erstellt wurden. Der Agent kann nur vorhandene Informationen aus der Nutzerhistorie erhalten und den simulierten Nutzer über die Aktion ask_user Fragen stellen.
Link zum Papier: https://arxiv.org/abs/2610.34735
Das Kerndesign von iPrefBench besteht darin, für jede weggelassene nutzerbezogene Information eine eindeutige Quelle zu markieren. Eine Kategorie von Informationen kann aus historischen Aktivitäten wiederhergestellt werden, beispielsweise das vom Nutzer üblicherweise gewählte Restaurant, der Sitzplatz oder die Fortbewegungsart; die andere Kategorie von Informationen kann nur vom Nutzer im aktuellen Kontext bereitgestellt werden, beispielsweise die Zeit und die Anzahl der Personen für dieses gemeinsame Essen. Der Agent muss zunächst erkennen, welche Entscheidungen in der Aufgabe noch unbestimmt sind, und dann beurteilen, ob diese Entscheidungen aus der Historie abgeleitet oder durch Fragen ermittelt werden sollen.
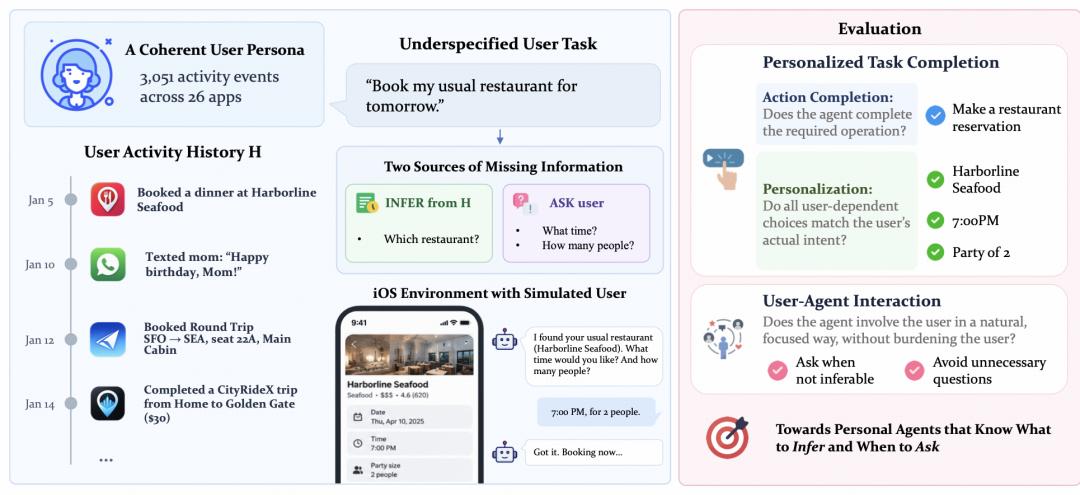
Abbildung | iPrefBench bewertet gleichzeitig die Fähigkeit zur Schlussfolgerung von Präferenzen und die Fähigkeit zur aktiven Nachfrage
Diese Unterscheidung schließt eine Lücke in der traditionellen Bewertung von Agenten zur Computernutzung. Viele Bewertungen verwenden Aufgaben mit vollständigen Informationen, bei denen der Agent keine Schlussfolgerungen ziehen und keine Fragen stellen muss. Andere personalisierte Bewertungen stellen die Nutzerhistorie zur Verfügung, erlauben aber keine Interaktion des Agenten mit dem Nutzer; interaktive Bewertungen erlauben zwar Fragen, verfügen aber nicht über ausreichende Nutzerhistorie, um zu beurteilen, ob eine bestimmte Frage überflüssig ist. iPrefBench platziert beide Informationsquellen in derselben Umgebung und misst getrennt, ob die Aufgabe abgeschlossen ist, ob sie dem spezifischen Nutzer entspricht und ob der Agent den Nutzer nur bei Bedarf stört.
Das Forschungsteam hat 7 hochmoderne Modelle mit demselben mobilen Agenten-Harness bewertet. Die Ergebnisse zeigen, dass es eine deutliche Lücke zwischen der Ausführungsfähigkeit und der Personalisierungsfähigkeit des Agenten gibt. Das leistungsstärkste Modell Claude Opus 5 erreicht eine Aktionsabschlussrate von 91,6 %, aber die Erfolgsrate für vollständige Aufgaben liegt nur bei 47,7 %. Der Agent kann oft Vorgänge wie Buchungen, Käufe oder Ausfüllungen abschließen, trifft aber nicht unbedingt Entscheidungen, die der Absicht des jeweiligen Nutzers entsprechen.
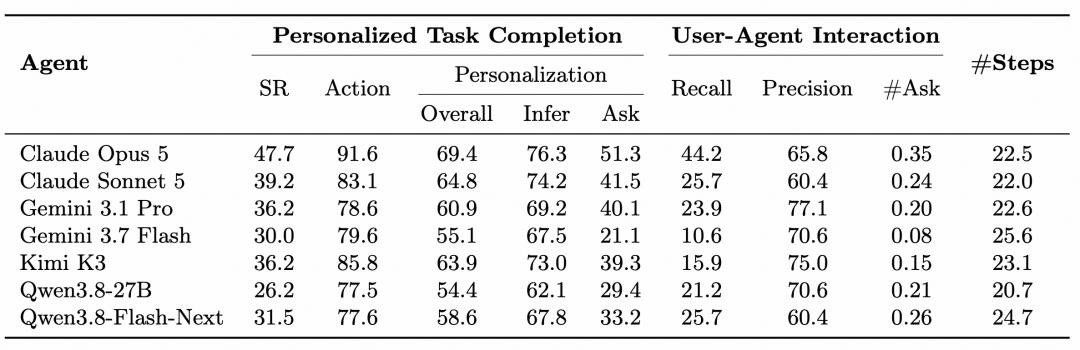
Abbildung | Hauptergebnisse auf dem iPrefBench-Benchmark
Alle getesteten Agenten zeigen deutlich schwächere Leistungen bei der Verarbeitung von Informationen, die nur durch Nachfrage beim Nutzer erhalten werden können. Am Beispiel von Claude Opus 5 liegt die Aufgabenabschlussrate bei Informationen, die aus historischen Aufzeichnungen abgeleitet werden können, bei 76,3 %; bei Informationen, die nur durch Nachfrage beim Nutzer erhalten werden können, sinkt die Abschlussrate auf 51,3 %.
Insgesamt initiiert jeder Agent durchschnittlich nur 0,08 bis 0,35 Abfragen pro Aufgabe, während jede Aufgabe durchschnittlich 0,89 Informationen enthält, die beim Nutzer bestätigt werden müssen. Bei diesen Informationen liegt die höchste Abrufquote der Abfragen nur bei 44,3 %. Dies zeigt, dass der Agent oft direkt Entscheidungen trifft, wenn er den Nutzer eigentlich bestätigen muss.
Allerdings ist die geringe Anzahl an Abfragen nur ein Teil des Problems. Die Präzisionsrate der Abfragen aller Modelle liegt zwischen 60,4 % und 77,1 %, was darauf hindeutet, dass ein erheblicher Teil der von ihnen gestellten Fragen unnötig ist, beispielsweise wenn die entsprechende Antwort bereits in den historischen Aufzeichnungen vorhanden ist, der Inhalt der Abfrage nichts mit der aktuellen Aufgabe zu tun hat oder bereits vorhandene Informationen wiederholt abgefragt werden. Daher ist die Schlüsselfähigkeit, die der Agent besitzen muss, genau zu beurteilen, welche Informationen aus vorhandenen Aufzeichnungen abgeleitet werden können und welche Informationen tatsächlich vom Nutzer bestätigt werden müssen.
Das Forschungsteam hat außerdem drei Arten von Störungsaufgaben entworfen, um zu testen, ob der Agent historische Präferenzen blind übernimmt. Die erste Art ist, dass die aktuelle Anweisung mit langjährigen Gewohnheiten in Konflikt steht; die zweite Art ist, dass jüngste Verhaltensweisen zeigen, dass sich die Präferenz geändert hat; die dritte Art ist, dass die ursprünglich bevorzugte Option in der aktuellen Umgebung nicht verfügbar ist. Die Bewertungsergebnisse zeigen, dass der Personalisierungswert des Agenten bei den ersten beiden Arten von Aufgaben unter dem Gesamtniveau liegt, während Umgebungsstörungen ihn dazu veranlassen, die Anzahl der Fragen deutlich zu erhöhen. Wenn die bevorzugte Option nicht verwendet werden kann, erreicht die durchschnittliche Anzahl der vom Agenten gestellten Fragen das 2,3-fache des ursprünglichen Werts, und die Verarbeitung von Informationen, die nur abgefragt werden können, wird ebenfalls verbessert.
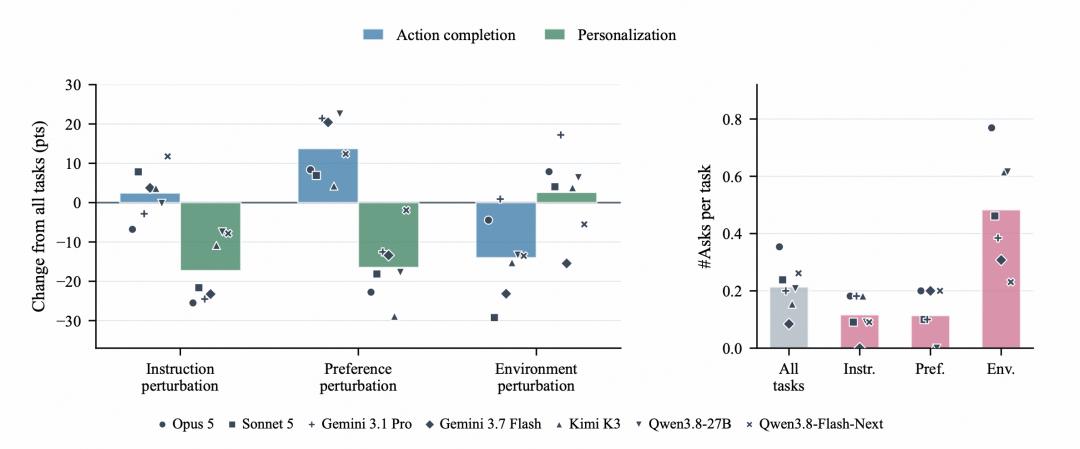
Abbildung | Leistung auf der Teilmenge der drei Arten von Störungsaufgaben von iPrefBench
Die Fehleranalyse zeigt weiter vier typische Fehlschläge. Bei Informationen, die nur abgefragt werden können, erkennt der Agent manchmal, dass Informationen fehlen, rät aber trotzdem selbst, manchmal identifiziert er die fehlenden Informationen nicht einmal als zu entscheidende Angelegenheit und verwendet direkt die Standardwerte der Anwendung. Bei Informationen, die aus der Historie abgeleitet werden können, kann der Agent die relevante Präferenz möglicherweise überhaupt nicht entdecken oder nach der Entdeckung einen falschen Schluss aus der Historie ziehen. Das Forschungsteam ist der Ansicht, dass aktuelle Agenten zwei miteinander verbundene Probleme haben: Zuerst alle ungelösten nutzerbezogenen Auswahlmöglichkeiten zu finden und dann für jede Auswahl zu entscheiden, ob sie abgeleitet oder abgefragt werden soll.
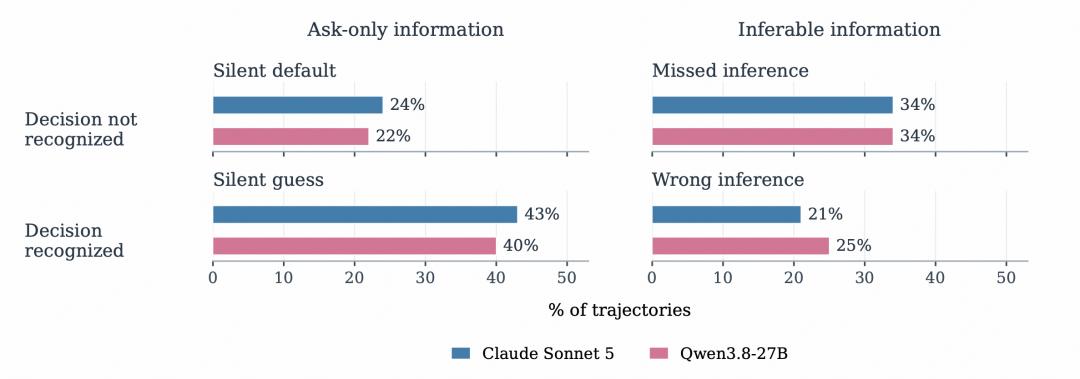
Abbildung | Verteilung von Personalisierungsfehlern in zwei Dimensionen
Das Forschungsteam hat auch eine Klärungsphase vor der Ausführung getestet, bei der der Agent vor Beginn der Operationen konsequent unklare Punkte identifizieren und Fragen stellen kann. Die experimentellen Ergebnisse zeigen, dass nach Hinzufügen dieser Phase bei Claude Sonnet 5 die Erfolgsrate für vollständige Aufgaben von 39,2 % auf 53,8 % gestiegen ist und der Verarbeitungswert für Informationen, die nur abgefragt werden können, von 25,7 % auf 85,0 % gestiegen ist; allerdings ist die Präzisionsrate der Abfragen von 60,4 % auf 42,5 % gesunken und die durchschnittliche Anzahl der Fragen pro Aufgabe von 0,24 auf 1,37 gestiegen. Bei Qwen3.8-27B treten ähnliche Veränderungen auf. Vorzeitige Klärung kann fehlende Abfragen reduzieren, erhöht aber gleichzeitig unnötige Fragen.
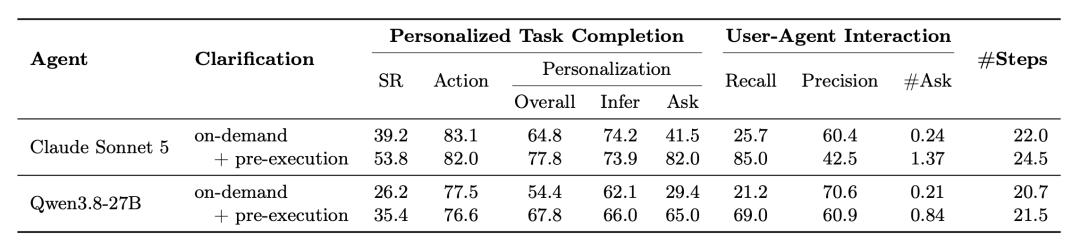
Abbildung | Auswirkung des Hinzufügens einer expliziten Klärungsphase vor der Ausführung auf Claude Sonnet 5 und Qwen3.8-27B
Die Menge der Nutzerhistorie ist nicht immer umso besser, je größer sie ist, die Experimente zeigen, dass die Bereitstellung einer kleinen Anzahl aufgabenbezogener historischer Ereignisse die Verarbeitung ableitbarer Präferenzen deutlich verbessern kann; das weitere Hinzufügen der vollständigen Historie bringt keinen gleich großen Nutzen. Mehr Historie hilft dem Agenten, Abfragen von Informationen zu vermeiden, die bereits abgeleitet werden können, hilft ihm aber nicht zu erkennen, welche Informationen immer noch nur vom Nutzer bereitgestellt werden können, und kann sogar die Abrufquote der Abfragen für solche Informationen senken.
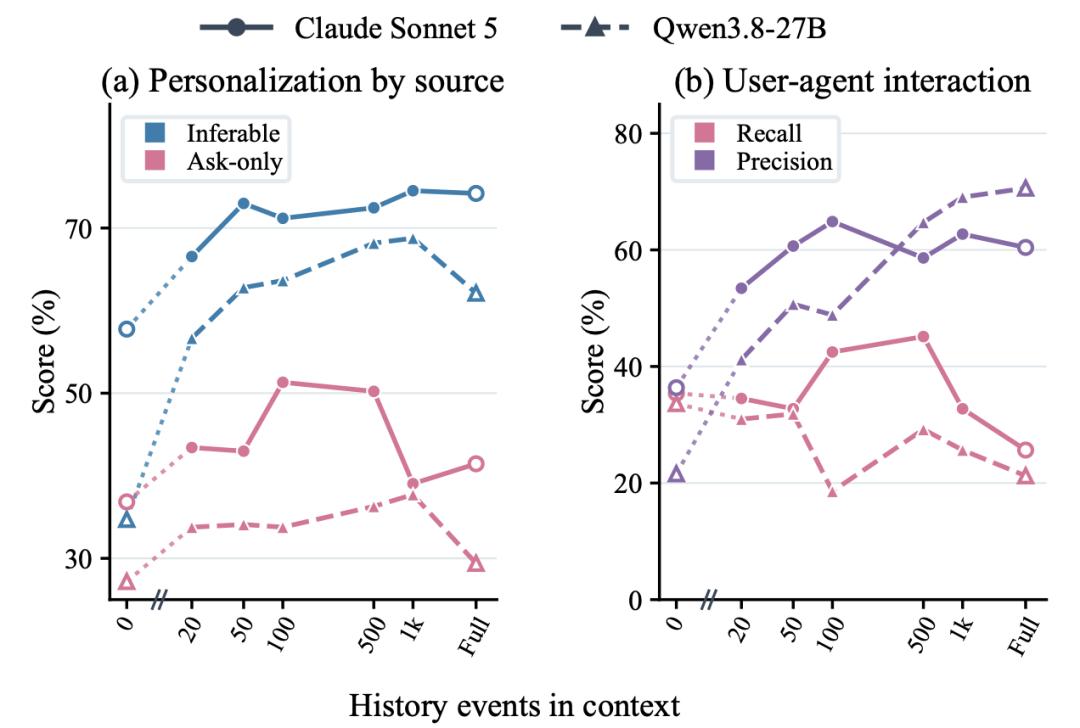
Abbildung | Auswirkung der Bereitstellung unterschiedlicher Mengen an Nutzerhistorien im Agentenkontext
iPrefBench zeigt eine allgemeine Herausforderung, vor der aktuelle mobile Agenten stehen: Sie sind bereits in der Lage, Oberflächenvorgänge gut auszuführen, sind aber immer noch schlecht darin, unbekannte Informationen in der Nutzerabsicht zu verarbeiten. Ein wirklich personalisierter Agent muss historische Aufzeichnungen und den aktuellen Kontext kombinieren, um die Nutzeranforderungen zu verstehen, er muss sowohl das mechanische Übernehmen vergangener Gewohnheiten vermeiden als auch unnötige Nachfragen reduzieren. Wie man genaue Urteile zwischen unabhängiger Ausführung und aktiver Bestätigung trifft, ist der Schlüssel zur Verbesserung der Personalisierungsfähigkeit des Agenten.
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „Academic Headline“ (ID: SciTouTiao), Autor: Academic Headline, veröffentlicht mit Genehmigung von 36Kr.