"72 % des Token-Verbrauchs entsprechen aber nur 27 % der Ausgaben": Das Kernthema des Streits zwischen Bullen und Bären im KI-Bereich
Die Nachfrage nach KI-Daten erzeugt eine seltene Marktdiskrepanz: Aus derselben Zahlenreihe ziehen Bullen und Bären jeweils den für sie passenden Nutzen, und beide Seiten erklären sich zum Sieger. Im Kern dieser Debatte steht ein beunruhigender struktureller Widerspruch – Der Verbrauch von Tokens steigt explosionsartig an, aber die überwiegende Mehrheit des Zuwachses fließt zu den Modellen mit den niedrigsten Gebühren, während die GPU-Kosten für die Bereitstellung dieser Tokens gleichzeitig steigen.
Laut Angaben von Bobby Molavi von Goldman Sachs in seinem neuesten Bericht zeigen Daten von OpenRouter, dass Open-Weight-Modelle in der zweiten Septemberwoche 72 % des Token-Verkehrs verarbeiteten, aber nur 27 % der gesamten Plattformausgaben erzielten; gleichzeitig hielten Closed-Source-Modelle, obwohl ihr Anteil von 89 % Anfang Januar auf 73 % gesunken ist, weiterhin den überwiegenden Teil der Monetarisierungserträge fest in der Hand.
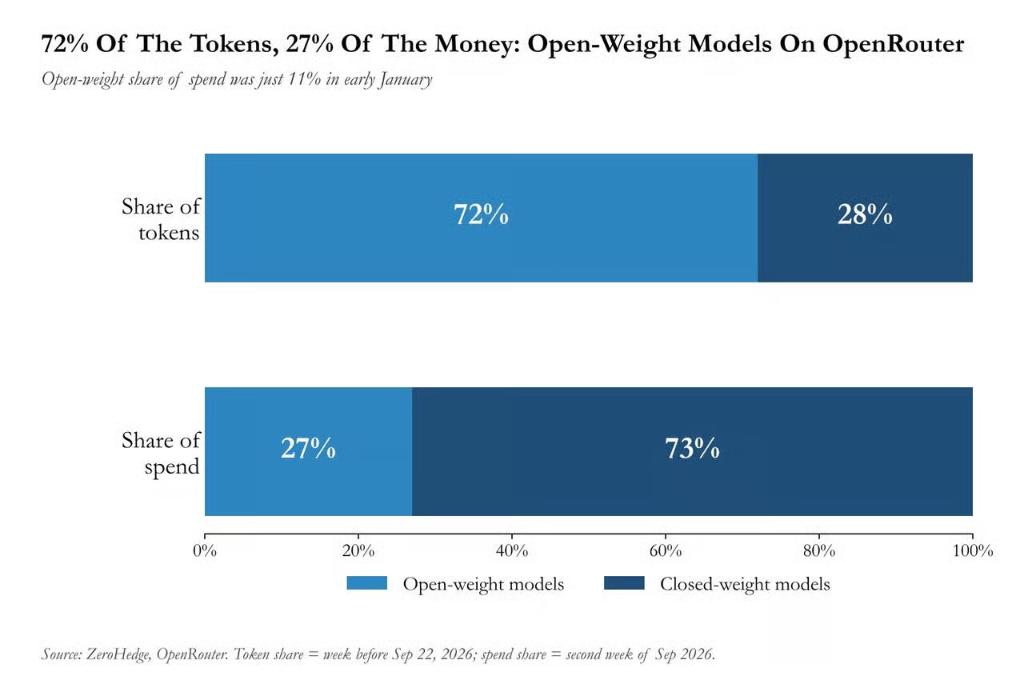
Besonders bemerkenswert ist, dass rund 69 % der Tokens auf der OpenRouter-Plattform Mitte September von chinesischen KI-Labors stammen. Molavi bezeichnet den aktuellen Markt als „nicht spielbar“ (unplayable) und weist darauf hin, dass die Produktivitätsdividende der KI bisher keine quantifizierbaren Spuren außerhalb der Technologiebranche hinterlassen hat.
Dieser strukturelle Widerspruch verändert die Markterwartungen hinsichtlich der Kapitalrendite von KI-Investitionen. Die Mietpreise für GPUs steigen stetig, während die Verkaufspreise für Tokens stetig fallen – der Druck an beiden Enden bedeutet, dass die Rechenleistungsanbieter von den Mietdividenden profitieren, während die Unternehmenskunden und letztlich die Aktionäre, die dafür zahlen, vor dem Dilemma stehen, dass die Kapitalrendite kaum realisiert werden kann. Meta hat kürzlich bei Aktionären um bis zu 95 Milliarden US-Dollar für KI-Investitionsausgaben geworben, und seine Chiphersteller beteiligen sich gleichzeitig an der Kapitalaufnahme – dies markiert, dass sich die „Lieferantenfinanzierung“ von der Fremdkapitalform zur Eigenkapitalform entwickelt hat, die Frage nach der Nachhaltigkeit des Kapitalzyklus wird immer dringender.
01 Explosive Token-Nachfrage: Das wahre Bild hinter dem 250-fachen Wachstum
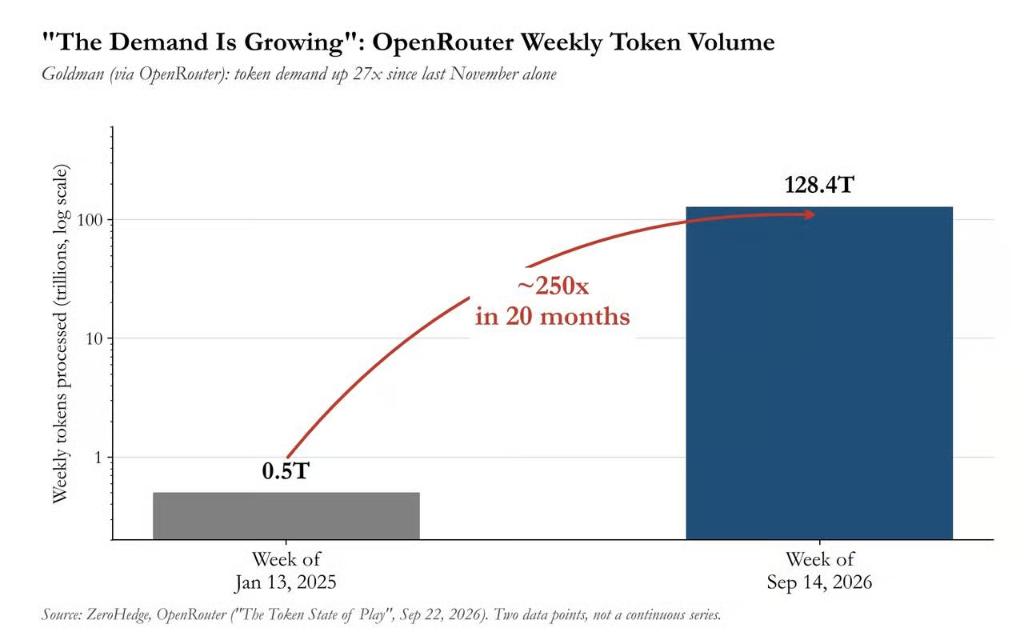
Das Wachstum der Nachfrage selbst ist unbestreitbar. Molavi verweist auf Daten von OpenRouter und weist darauf hin, dass die Token-Nachfrage seit November letzten Jahres um das 27-fache gestiegen ist und Open-Weight-Modelle derzeit 72 % des Token-Anteils einnehmen. Aus einer längeren Perspektive betrachtet ist die wöchentliche Token-Verarbeitungsmenge auf der OpenRouter-Plattform von 0,5 Billionen Mitte Januar 2025 auf 128,4 Billionen in der Woche zum 14. September sprunghaft angestiegen, was einem Wachstum von etwa 250-fachen innerhalb von 20 Monaten entspricht.
Die GPU-Preisgestaltung bestätigt ebenfalls die Echtheit der Nachfrage. Die Mietpreise für H200 sind im laufenden Jahr um 160 % gestiegen, für B200 um 120 % und für H100 um 35 %. Noch überzeugender ist, dass der aktuelle Mietpreis der im Jahr 2020 hergestellten A100-Chips bereits über dem Niveau zu Jahresbeginn liegt – dies untergräbt direkt die bisherige Kernannahme über den Abschreibungszyklus von GPUs: Wenn ein Chip nach sechs Jahren noch höhere Erträge erzielen kann, ist die pessimistische Abschreibungsprognose mit einem Zeitraum von drei Jahren nicht haltbar, und das langfristige Gewinnpotenzial von Hyperscalern muss daher neu bewertet werden.
Für die Bullen ist dies das stärkste Argument: Die Nachfrage ist real, die wirtschaftliche Lebensdauer von Rechenleistungsvermögen ist länger als von den Bären erwartet.
02 Freier Fall der Token-Preise: Die schnellste Deflation in der Geschichte
Auf der anderen Seite des explosiven Nachfragewachstums stürzen die Token-Preise mit einer noch nie dagewesenen Geschwindigkeit ab. Laut dem am 22. September von Epoch AI veröffentlichten Forschungsbericht „Der sturzende Preis des Denkens“ (The Plunging Price of Thought) sinken die Kosten für das Erreichen des gleichen KI-Leistungsniveaus seit 2023 pro Quartal um etwa 47 %, was einem jährlichen Rückgang von etwa 13-fachen entspricht; im Bereich der Spitzenmodelle ist diese Geschwindigkeit noch höher, mit einem durchschnittlichen Rückgang von 66 % pro Quartal, also etwa 75-fachen pro Jahr.
Das anschaulichste Beispiel von Epoch AI:
Im Januar 2025 erzielte das o3-Modell von OpenAI 75 % richtige Antworten im GPQA-Diamond-Test für wissenschaftliche Fragen auf Doktorandenebene, wobei die Kosten pro Frage etwa 0,30 US-Dollar betrugen; heute erreicht GPT-5.6 Luna die gleiche Punktzahl, die Kosten pro Frage betragen nur 0,0004 US-Dollar – der Preis ist innerhalb von 18 Monaten um das 725-fache gesunken, was dem Preisverfall eines Autos mit einem Nennwert von 50.000 US-Dollar auf 69 US-Dollar entspricht.
Im historischen Vergleich ist die Rückgangsgeschwindigkeit der Inferenzpreise von großen Sprachmodellen viermal so hoch wie die der DNA-Sequenzierung, sechsmal so hoch wie die Steigerungsgeschwindigkeit der Rechenleistung zwischen 1940 und 2001, 18-mal so hoch wie die der Lithium-Ionen-Batterien und 54-mal so hoch wie die der Elektrizität.
Allerdings sinken die von den Kunden tatsächlich gezahlten Preise deutlich langsamer als die Nennpreise. Die von YipitData verfolgten jährlichen Token-Daten von fast 2 Billiarden zeigen, dass der effektive Token-Preis für API-Dienste im zweiten Halbjahr 2025 um 39 % gesunken ist (auf OpenRouter um 44 %), aber seit Jahresbeginn bis Mai 2026 nur um 6 %.
Der Grund dafür ist: Entwickler streben ständig nach günstigeren Modellen, während Unternehmenskunden den Nutzungsanteil von Premium-Modellen erhöhen. Spitzenlabore stützen die Einnahmenseite vorübergehend durch die Prämienfähigkeit ihrer neuesten Modelle – aber Daten von Epoch zeigen, dass die Halbwertszeit dieser Prämien in Quartalen gemessen wird, da Open-Source-Klonversionen sehr schnell die gleichen Aufgaben zu extrem niedrigen Kosten erledigen können.
03 Kern der Meinungsverschiedenheit zwischen Bullen und Bären: Wer verdient Geld, wer zahlt?
Das ist genau der Kern des von Molavi beschriebenen Dilemmas „dieselben Daten, zwei Interpretationen“.
Die Logik der Bullen lautet: Die Nachfrage wächst stetig, der adressierbare Gesamtmarkt (TAM) wächst weiter, und das explosionsartige Wachstum des Token-Verbrauchs beweist, dass KI weit verbreitet eingesetzt wird.
Die Logik der Bären lautet dagegen: Die Kosten pro Token steigen, die Einnahmen pro Token sinken, und der Großteil des zusätzlichen Verkehrs stammt von den Open-Source-Modellen mit den niedrigsten Gebühren. Die Daten von OpenRouter zeigen dieses Bild klar: Open-Weight-Modelle verarbeiten 72 % der Tokens, nehmen aber nur 27 % der Ausgaben ein; chinesische KI-Labors tragen fast 70 % des Token-Verkehrs der Plattform bei. Der Goldman Sachs Momo Basket erreichte Ende Juni genau seinen Höhepunkt, ein Zeitpunkt, der stark mit dem massiven Eintritt chinesischer Open-Weight-Modelle in den KI-Markt übereinstimmt.
Molavi fasst diesen Widerspruch zusammen: Der Anstieg der GPU-Mietpreise und der Rückgang der Token-Verkaufspreise sind das Ergebnis desselben Drucks, der von beiden Seiten ausgeübt wird. Für GPU-Besitzer ist dies vorteilhaft; für Unternehmen, die die Miete zahlen, stellt sich die Situation ganz anders dar.
04 Fehlende Produktivitätsdividende: Das Schweigen des S&P 493
Die ultimative Logik der KI-Investitionsausgaben besteht darin, durch Produktivitätssteigerungen gesamtgesellschaftliche Vorteile zu erzielen. Bislang wurde diese Logik jedoch noch nicht durch Daten außerhalb der Technologiebranche bestätigt.
Molavi verweist auf einen Strategiebericht und weist darauf hin, dass die KI „noch keine quantifizierbare Produktivitätssteigerung in wichtigen Daten außerhalb des Technologie-Universums zeigt“: Der Umsatz pro Kopf und die Gewinnmarge der Mag 7 (sieben großen Technologiegiganten) haben sich verbessert, während die entsprechenden Indikatoren des S&P 493 (die restlichen 493 Unternehmen des S&P 500) nahezu unverändert geblieben sind.
Diese Realität verändert die Logik der KI-Entscheidungen in der Unternehmenswelt. Molavi beobachtet, dass eine große Anzahl von Unternehmen von der Betrachtung „Korrelation zwischen Token-Ausgaben und Wachstum sowie Produktivität“ zu einem Rahmen übergeht, der die Auswirkungen der Token-Ausgaben auf Kosten und Gewinnmarge prüft. Die CFOs haben diese KI-Budgetlinie identifiziert, und sie wollen wissen, wofür das ausgegebene Geld verwendet wurde.
05 Der „Boom-Zyklus“ und die Frage nach der Nachhaltigkeit des Kapitals
Die aktuelle Welle der KI-Investitionsausgaben wird von einem von Molavi beschriebenen „Boom-Zyklus“ gestützt: Je höher die Investitionsausgaben der Hyperscaler sind, desto mehr Einnahmen fließen in das KI-Ökosystem, was wiederum Risikokapital und Wachstumskapital anzieht und einen zweiseitigen Kapitalstrom bildet – und der Anker für all das sind die ursprünglichen KI-Investitionsausgaben selbst.
Die tödliche Schwäche dieses Zyklus liegt in seiner Nachhaltigkeit: Sobald die Investitionsausgaben nachlassen, können die Einnahmen des gesamten Ökosystems sich selbst erhalten?
Auch der private Markt ist nicht immun. Molavi weist darauf hin, dass die aktuellen Exit-Fälle „zahlreich, aber extrem konzentriert“ sind (SpaceX, Cerebras, Cursor, Hugging Face), und die Neubewertung der Bewertungen einiger Projekte „keinen anderen Katalysator als eine Absichtserklärung für Investitionen hat“, während die Transaktionslogik des gesamten privaten Marktes „so aussieht, als würde das Token-Zeitalter niemals enden und alles umgestoßen werden“.
Auf der Finanzierungsseite hat Meta kürzlich angekündigt, bei Aktionären um bis zu 95 Milliarden US-Dollar für KI-Investitionsausgaben zu werben, und seine Chiphersteller beteiligen sich gleichzeitig an der Kapitalaufnahme, da sich das Fremdkapitalfenster verengt. Die Lieferantenfinanzierung hat sich von der Fremdkapitalform zur Eigenkapitalform entwickelt, und die Grenzen zwischen Einnahmen und Finanzierung zwischen Anbietern und Nutzern werden immer unschärfer.
Molavi fasst das Wesen der gesamten Debatte in vier Fragen zusammen: Wie hoch sind die Baukosten, wer zahlt, lohnt sich der Aufwand und wie lange muss man warten, bis die Einnahmen erzielt werden?
Das aktuelle Datenbild lautet: Die Token-Nachfrage ist um das 250-fache gestiegen, aber die zusätzlichen Erträge fließen zu den Modellen mit den niedrigsten Gebühren; die GPU-Mieten steigen, aber die Rechnung wird letztendlich an die Aktionäre weitergegeben; die Produktivitätsdividende ist außerhalb der Technologiebranche noch nirgendwo zu sehen.
Molavis Schlussfolgerung lautet, dass die Echtheit der Nachfrage unbestreitbar ist, aber „ein 250-faches Nachfragewachstum, bei dem das Kapital zu den günstigsten Modellen fließt, die Mieten zu den GPU-Besitzern gehen und die Rechnung an die Aktionäre weitergegeben wird“ entspricht nicht der ROI-Geschichte, die ursprünglich von den Investitionsausgaben versprochen wurde. In diesem Tauziehen zwischen Bullen und Bären halten die Bären möglicherweise das stärkere Seil in der Hand.
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „Hard AI“, Autor: Spezialist für Technologie-Forschung und -Entwicklung, veröffentlicht mit Genehmigung von 36Kr.