Gerade hat das Diffusionsmodell den Hauptbereich der Agenten erobert: Es verfügt über 35 Milliarden Parameter und ist doppelt so schnell wie Jev.
Ich bin total erstaunt! Obwohl ich täglich an der Spitze der KI-Entwicklung unterwegs bin, habe ich es doch geschafft, mit den neuen Versionen nicht Schritt zu halten.
Wer hätte gedacht, dass das „Diffusionsmodell“, das man bisher nur zur Erzeugung von Bildern und Videos kannte, auch Code schreiben, Webseiten generieren, Tools aufrufen und als Agent fungieren kann!
Gerade eben hat Diffusion Intelligence das brandneue Diffusions-Sprachmodell vorgestellt —
Clover-35B-A3B-Preview.
Obwohl der Name das Wort „Diffusion“ enthält, zeigt sich in der Praxis, dass seine Verwendung beim Schreiben von Code, Bedienen von Webseiten, Aufrufen von Tools und Generieren von HTML fast genauso funktioniert wie bei den großen Sprachmodellen, die wir bereits kennen.
Mein erster persönlicher Eindruck nach der Nutzung lässt sich in einem Wort zusammenfassen: „Schnell“.
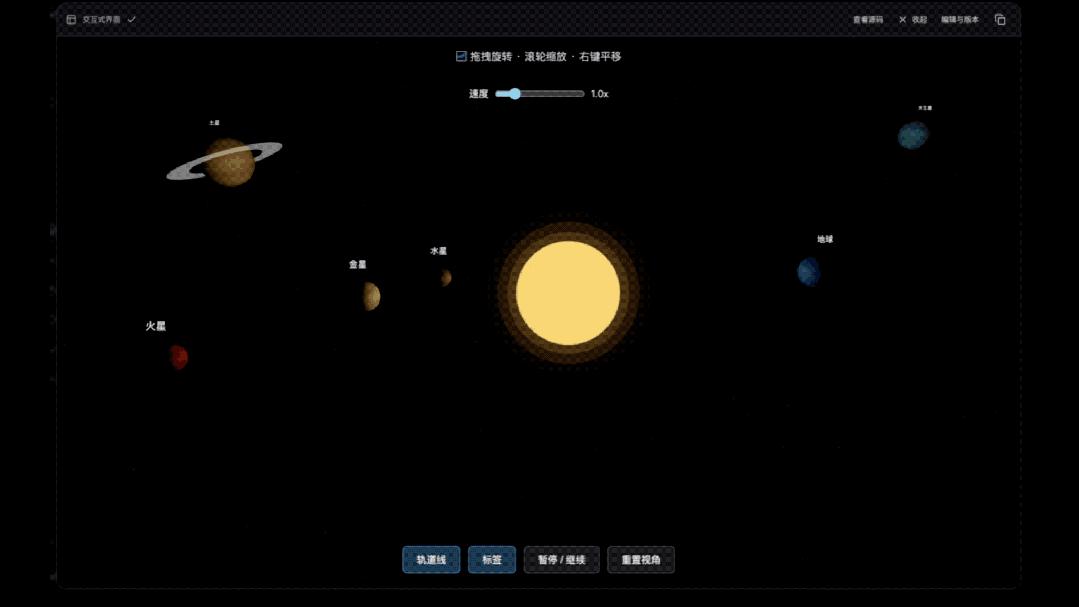
Wenn man es beispielsweise bittet, einen Sonnensystem-Simulator zu erstellen, denkt Clover etwa 1 Sekunde nach, und nach weiteren 4 bis 5 Sekunden ist ein interaktiver Sonnensystem-Simulator fertig.
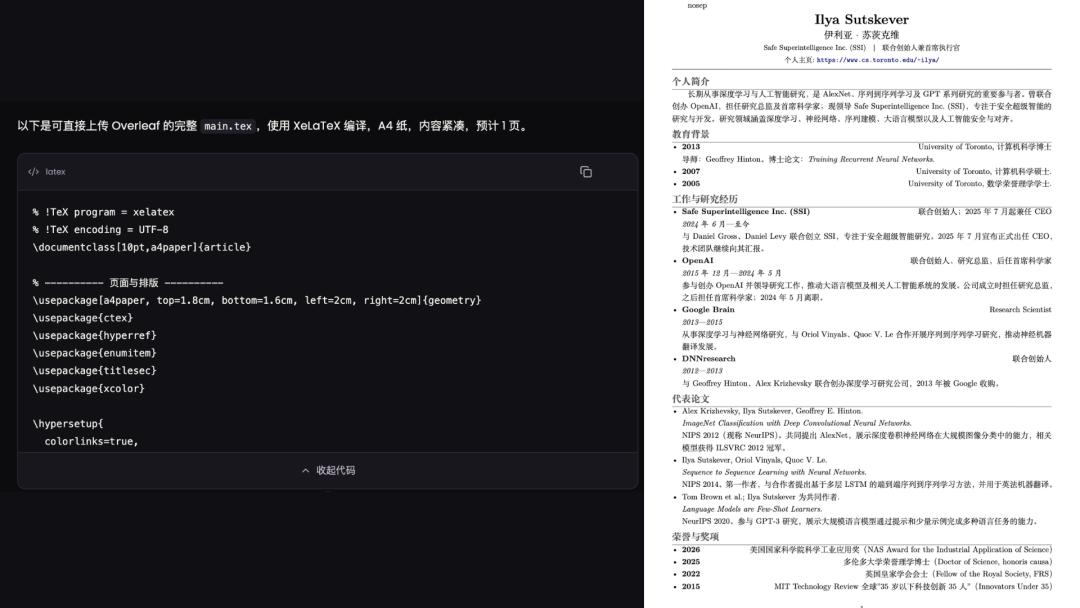
Ein weiteres Beispiel: Ich habe ihm eine Menge Lebenslaufdaten übergeben und es gebeten, daraus Lebenslauf-Code im LaTeX-Format zu erstellen — das war in etwa zehn Sekunden erledigt~
Ehrlich gesagt: Jeder, der schon GPT genutzt hat, weiß, wie es sich anfühlt, ewig auf die Anzeige „Denke nach“ zu warten — sonst wäre vor kurzem auch kein Produkt wie Jev entstanden, das auf schnelle Entscheidungsfindung setzt~
Und wenn wir schon von Jev sprechen: Clover hat diesmal direkt einen Geschwindigkeitsvergleich damit durchgeführt.
Bei 49 Aufgaben des Web-Agent-Benchmarks WindTunnel, wobei jede Aufgabe 3 Mal ausprobiert wurde, betrug die mediane Ausführungszeit von Clover 1,52 Sekunden, während die Kombination aus Jev + Mercury 2.5 auf 3,21 Sekunden kam — Clover brauchte also mehr als halb so viel Zeit.
Die Erfolgsrate bei den Versuchen war ebenfalls etwas höher, sie betrug 98,6 % gegenüber 95,9 %.
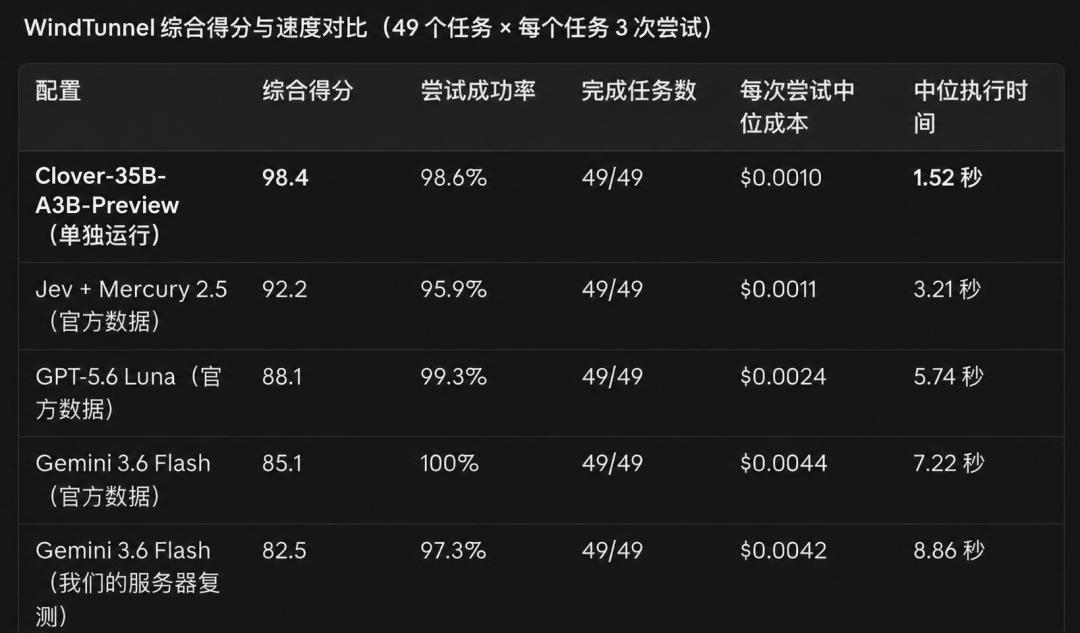
Verglichen mit Gemini in derselben Tabelle ist die Geschwindigkeit sogar um ein Mehrfaches höher!
Gut, gut, du Diffusionsmodell, willst du die autoregressiven Modelle in den Wahnsinn treiben? (doge)
Diffusionsmodell, das Agent-Aufgaben erledigen kann
Zurück zum Modell: Clover-35B-A3B-Preview verwendet diesmal eine MoE-Architektur mit insgesamt 35 Milliarden Parametern, wobei pro Token etwa 3 Milliarden Parameter aktiviert werden, und unterstützt den Denkmodus.
Damit hat das Team sein Diffusions-Sprachmodell von den zuvor 7 Milliarden Parametern des Dream 7B auf eine Gesamtgröße von 35 Milliarden Parametern weiterentwickelt.
Entscheidender ist: Trotz der gestiegenen Parameterzahl wurde die Geschwindigkeit von Clover nicht verringert, es übertrifft autoregressive Modelle vergleichbarer Größe.
Neben der bereits gezeigten Erstellung interaktiver Seiten und Code hat Clover in der offiziellen Demonstration weitere Agent-Fähigkeiten wie komplexe Aufgaben und WebUI-Generierung vorgestellt.
Clover kann über WebMCP sechs aufeinanderfolgende Aufgaben verarbeiten: Rechnungsstellung, Kursanmeldung, Summierung von Beträgen, Abfrage des Aktivitätsstatus, Abfrage von Kundendaten und Abfrage von Rechnungsinformationen.
Aus dem unten stehenden Vergleichsvideo geht hervor, dass Clover nicht nur die Aufgaben erfolgreich abschließt, sondern in der Ausführungsgeschwindigkeit Gemini 3.6 Flash deutlich hinter sich lässt.
Im Szenario des Online-Shoppings kann Clover zudem wie gewünscht ein T-Shirt in der angegebenen Ausführung, schwarz, Größe L finden, es zum Warenkorb hinzufügen, Besucherinformationen ausfüllen und den Test-Kassiervorgang durchlaufen.
Ehrlich gesagt ist die Verarbeitung solcher aufeinanderfolgender Aufgaben der bemerkenswerteste Teil dieser Demonstration.
Man muss wissen: Obwohl Diffusions-Sprachmodelle das Potenzial für parallele Generierung und hohe Geschwindigkeit haben, waren ihre bisherigen Leistungen bei Agent-Aufgaben noch nicht stabil genug:
Das Format für Tool-Aufrufe konnte fehlerhaft sein, das Modell konnte wiederholt denselben Schritt versuchen, ohne die Aktionen an die zurückgegebenen Ergebnisse anzupassen.
Die Fortschritte von Clover zeigen sich genau in diesen aufeinanderfolgenden Abläufen: Tools aufrufen, Rückmeldungen auswerten, die Ausführung fortsetzen, bis die Aufgabe abgeschlossen ist.
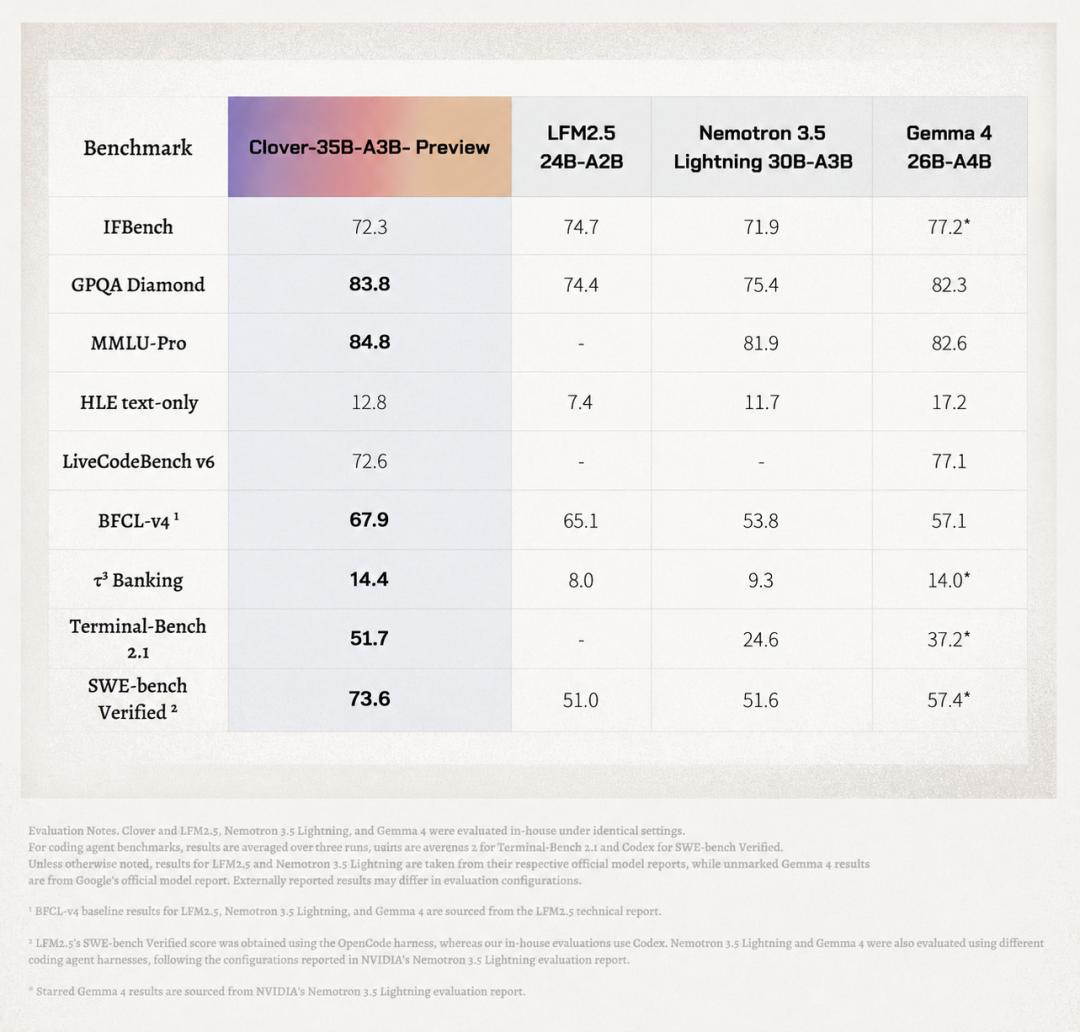
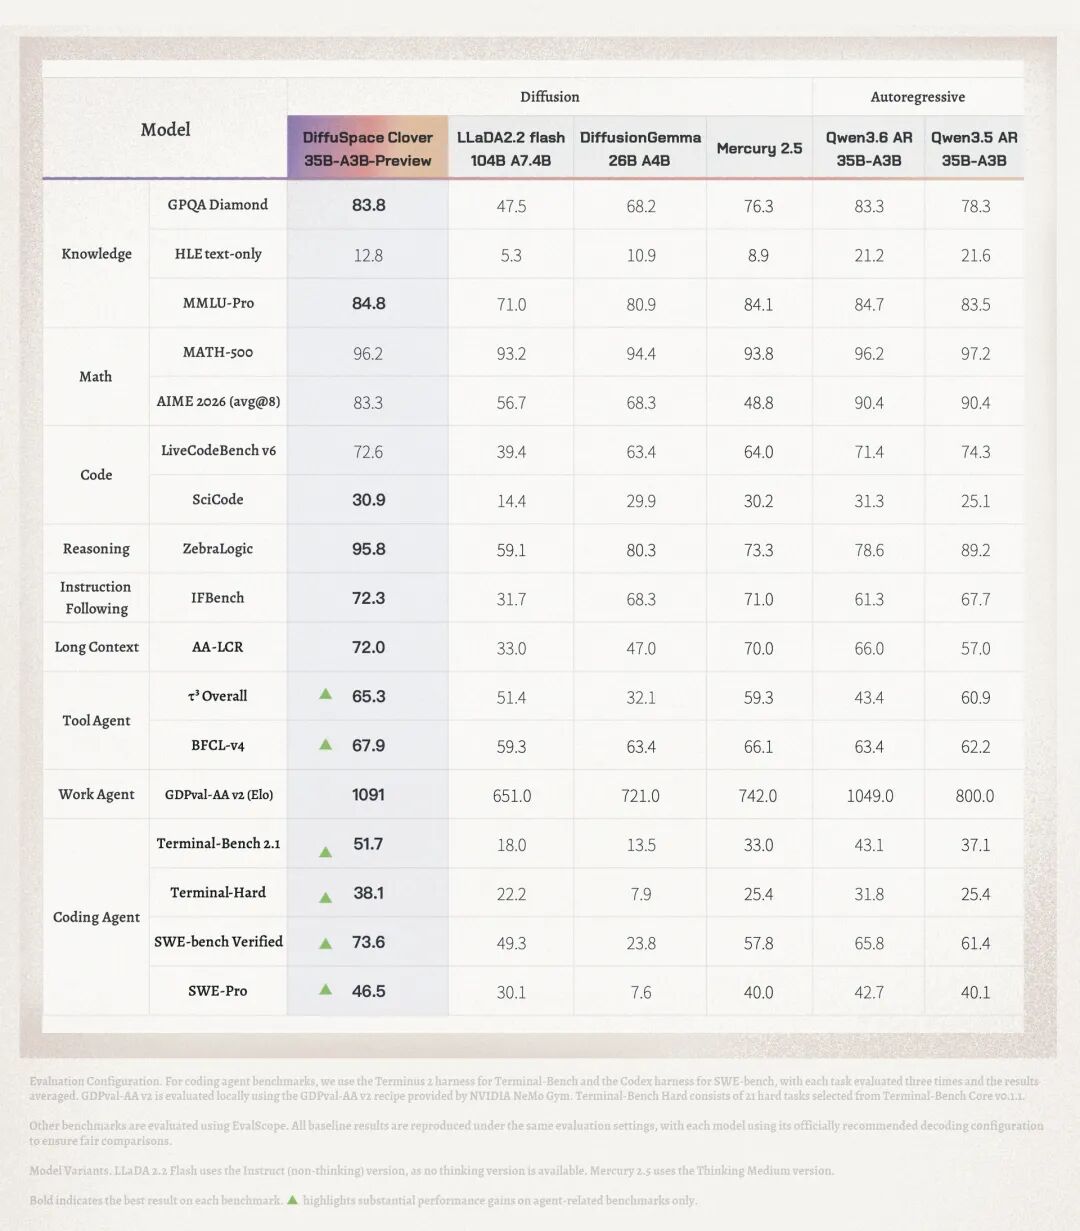
Bei den Benchmarks hat Clover laut den vom Team veröffentlichten Werten in den Tool-Nutzungs-Bewertungen τ³ Overall und BFCL-v4 die Werte 65,3 und 67,9 erreicht und gehört damit zu den Spitzenmodellen.
△
Nach den Agent-Aufgaben werfen wir einen Blick auf den Code.
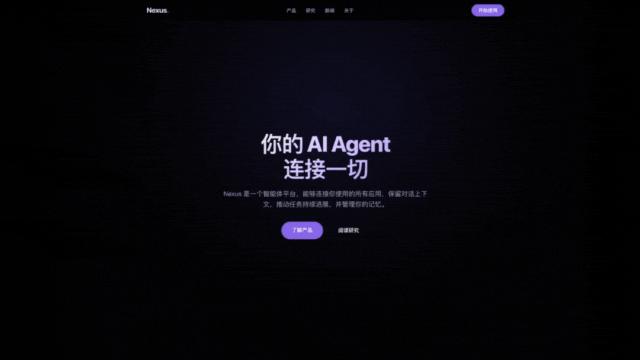
Ich habe Clover gebeten, eine Web-Oberfläche für einen persönlichen Agenten zu erstellen. Das Ergebnis sieht sehr überzeugend aus, der gesamte Generierungsprozess dauerte nur etwa zehn Sekunden.
Auch bei Code-Benchmarks hat Clover sehr gute Ergebnisse erzielt.
Auf SWE-bench Verified, das die Fähigkeit zur Lösung von Problemen in echten Code-Repositories prüft, erreichte es einen Wert von 73,6; auf Terminal-Bench 2.1, das die Fähigkeit zur Ausführung von Aufgaben im Terminal prüft, erreichte es 51,7.
△
Man kann sagen: Von der Generierung interaktiver Seiten über den Aufruf von Tools und das Durchlaufen von Geschäftsprozessen bis hin zu Code-Benchmarks hat Clover als Diffusions-Sprachmodell diesmal tatsächlich eine ganze Reihe von Agent-Aufgaben übernommen.
Das ist interessant. Wie funktioniert der Diffusionsgedanke, der ursprünglich für die Rauschreduzierung bei der Bildgenerierung gedacht war, in Sprachmodellen, sodass er Text erzeugen und Code schreiben kann?
Wird die oben gezeigte Demo tatsächlich vollständig per AIGC erstellt?
Woher stammt das Diffusions-Sprachmodell?
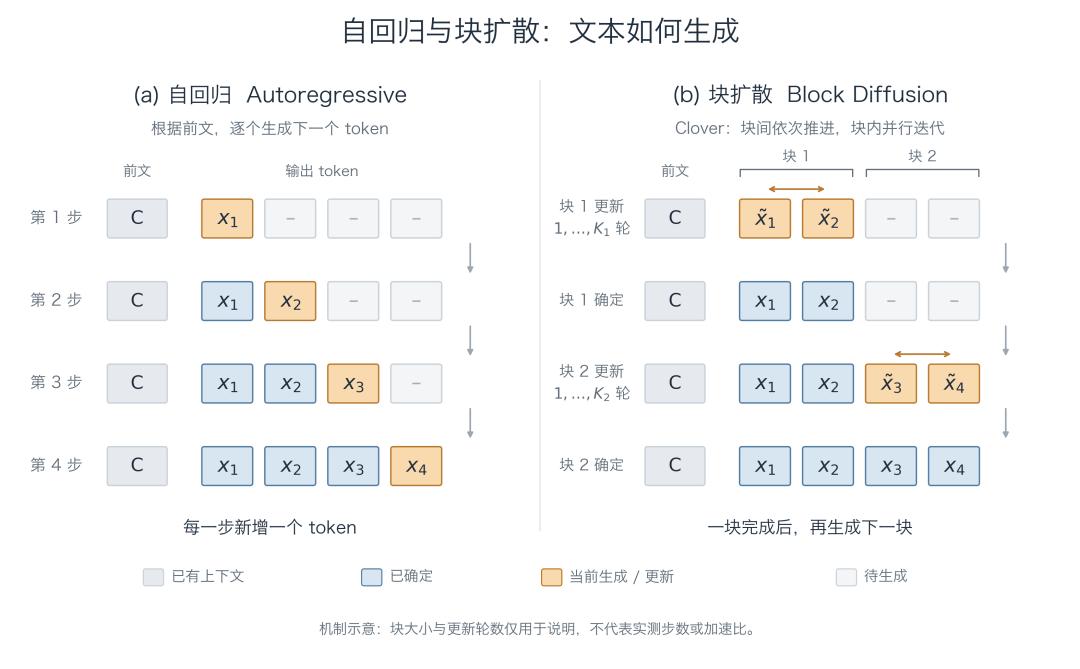
Im Allgemeinen arbeiten die uns bekannten autoregressiven (AR) Sprachmodelle so, dass sie das nächste Token anhand des vorherigen Textes vorhersagen, ein Token nach dem anderen generieren — das ist das, was man gemeinhin als „Wortweiterspielen“ bezeichnet.
Ein Token kann man sich vereinfacht als Textstück vorstellen, das das Modell verarbeitet.
Im Gegensatz zur seriellen Vorhersage und Generierung von autoregressiven Modellen arbeitet das Diffusions-Sprachmodell nach einem anderen Prinzip: Es erlaubt die gleichzeitige Aktualisierung mehrerer Positionen, und nach mehreren Verbesserungsrunden wird schrittweise das Endergebnis erzielt.
△
Die Diffusions-Rauschreduzierung hier kann man sich so vorstellen: Man stellt Inhalte, die verdeckt oder gestört sind, schrittweise wieder zu Text her, der zum Kontext passt.
Genauer gesagt verwendet Clover Blockdiffusion: Der zu generierende Inhalt wird in mehrere Blöcke unterteilt, die Blöcke werden nacheinander verarbeitet, innerhalb eines Blocks werden mehrere Positionen parallel aktualisiert und beziehen sich gegenseitig aufeinander.
Auf diese Weise kann eine einzelne Berechnungsrunde die Generierung mehrerer Positionen vorantreiben, was die Wartezeit bei der sequenziellen Generierung einzelner Token verringert.
Aber das Problem ist: Dass mehrere Inhalte gleichzeitig generiert werden können, heißt nicht, dass sie in einer einzigen Runde perfekt geschrieben sind.
Denn Diffusionsmodelle brauchen oft mehrere Runden der Rauschreduzierung, um das Ergebnis schrittweise zu festigen. Bei zu wenigen Runden ist der Inhalt möglicherweise noch nicht ausreichend angepasst; bei zu vielen Runden steigt der Rechenaufwand stark an.
Bei Code- und Agent-Aufgaben wird der Kontext zudem ständig länger. Frühere Anforderungen, bereits ausgeführte Aktionen und Ergebnisse von Tool-Aufrufen können den nächsten Schritt beeinflussen, sodass die Speicherung und der Abruf von historischen Informationen zu einem Effizienzproblem werden.
Der Verbesserungsansatz von Clover besteht darin, dass historische Erinnerungen und aktuelle Generierung jeweils ihre eigene Aufgabe erfüllen.
Es hat das gated Delta Network (GDN) um die Blockdiffusion herum neu aufgebaut: Der bereits generierte Kontext wird in einen ständig aktualisierten Zustand komprimiert, der von nachfolgenden Schritten abgerufen werden kann; der aktuell generierte Block verwendet bidirektionale Aufmerksamkeit, sodass die Token innerhalb des Blocks sich gegenseitig referenzieren.
Gleichzeitig wird der Abruf der historischen Erinnerung als eigenständige Informationseinheit behandelt, die zusammen mit dem aktuellen Token an der Aufmerksamkeitsberechnung teilnimmt. Das Modell lernt selbst, wie es die Gewichtung zwischen vorherigem Text und aktuellem Inhalt ausbalanciert. Durch eine lernbare Größenkalibrierung der Blöcke wird das Problem verringert, dass historische Informationen bei größer werdenden Blöcken verwässert werden.
Mit anderen Worten: Das Ziel dieser Anpassungen ist es, parallele Generierung, Nutzung historischer Informationen und Recheneffizienz besser aufeinander abzustimmen. Das ist der Schlüssel, mit dem Clover das Diffusions-Sprachmodell erfolgreich für Code- und Agent-Aufgaben einsetzt.
Abgesehen von Clover ist das Diffusions-Sprachmodell in den letzten zwei Jahren vor allem wegen seiner zwei Vorteile gegenüber autoregressiven Modellen in den Fokus gerückt:
Einerseits erlaubt das Diffusions-Sprachmodell die gleichzeitige Generierung mehrerer Positionen, sodass die serielle Wartezeit bei der Generierung einzelner Token verringert werden kann. Für Agenten, die wiederholt Code generieren und Tools aufrufen müssen, ist dieses Potenzial besonders wertvoll.
Andererseits können sich Inhalte vor und nach der Generierung gegenseitig referenzieren. Mit dem bidirektionalen Modellierungsansatz können mehrere Positionen im Iterationsprozess gemeinsam angepasst werden, was eine weitere Möglichkeit zur Verarbeitung von Abhängigkeiten zwischen Inhalten bietet. Die Interaktion innerhalb des aktuellen Blocks von Clover ist eine dieser Implementierungen.
Auf der Grundlage dieser Möglichkeiten haben Wissenschaft und Industrie bereits verschiedene Ansätze ausprobiert.
ELF, an dem He Kaiming dieses Jahr beteiligt war, versucht, Sprache in einem kontinuierlichen Einbettungsraum zu generieren; Google hat DiffusionGemma vorgestellt, das die parallele Textgenerierung erforscht; große chinesische Technologieunternehmen arbeiten ebenfalls an Diffusions-Sprachmodellen für Code-Aufgaben.
Die genauen Methoden sind unterschiedlich, alle versuchen, diese alternative Generierungsart zu nutzbarer Fähigkeit und höherer Effizienz zu machen.
Clover hat seine Fortschritte in Code, Tool-Aufrufen und aufeinanderfolgenden Aufgaben umgesetzt und lässt die Nutzer es selbst testen.
Von DiffuSeq zu Clover: Der nächste Schritt von Diffusion Intelligence
Abschließend kommen wir zurück zum Team hinter Clover —
Diffusion Intelligence.
Wie berichtet wurde, wurde Diffusion Intelligence von Professor Kong Lingpeng von der Universität Hongkong zusammen mit seinen Doktoranden Gong Shansan und Ye Jiacheng gegründet. Die Erforschung von Diffusions-Sprachmodellen durch das Team reicht bis ins Jahr 2022 zurück.
In diesem Jahr haben sie DiffuSeq vorgestellt, das erforscht, wie Diffusionsmodelle für sequenz-zu-sequenz Textgenerierung verwendet werden: Man gibt einen Text ein und generiert dann einen weiteren Text gemäß festgelegten Bedingungen.
