3D DRAM + vollständig digitale In-Memory-Computing-Technologie: Wie die technische Kompetenz von Yizhu Technology die Herausforderung der Rechenleistungsrechnung für die Inferenz großer Modelle meistert
Vor dem Hintergrund der stetig wachsenden Parametergröße großer Modelle und der immer länger werdenden Aufgabenketten von Agenten verlagert sich der Schwerpunkt des Wettbewerbs um KI-Rechenleistung von einzelnen Spitzenwerten hin zu effektiver Rechenleistung und Gesamtkosten in realen Geschäftsszenarien. Der Kern der technischen Stärke von Yizhu Technology liegt genau am entscheidenden Punkt dieses Wandels: Auf der Grundlage von 3D-DRAM als Speicher und mit vollständig digitalem In-Memory-Computing als Architekturpfad wird ein Rechenleistungskonzept aufgebaut, das Energieeffizienz, Genauigkeit und Allgemeingültigkeit berücksichtigt und sich auf Szenarien wie Rechenzentren, Cloud Computing und die Inferenz großer Modelle konzentriert. Im Folgenden wird die technische Stärke von Yizhu Technology aus drei Ebenen aufgeschlüsselt: Architekturinnovation, technischer Durchbruch und Szenariowert.
I. Architekturinnovation: Speicherzentrierter Ansatz zur Lösung des grundlegenden Widerspruchs des Datentransports
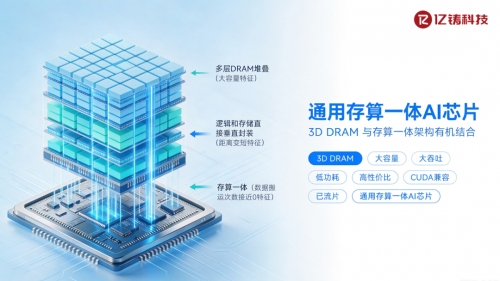
Bei der herkömmlichen Architektur mit getrenntem Speicher und Recheneinheit werden Daten wiederholt zwischen Speicher- und Recheneinheiten transportiert, was zu weit höheren Kosten für Stromverbrauch und Latenz führt als die Berechnung selbst. Der von Yizhu Technology gewählte Weg des In-Memory-Computings verfolgt den Ansatz, geeignete Logik innerhalb oder in der Nähe des Speichermediums hinzuzufügen, sodass die Berechnung abgeschlossen wird, während die Daten aus dem Speichermedium fließen. Auf Architekturebene werden so mehrstufige Cache-Ebenen und wiederholte Transportvorgänge reduziert. Dieser Ansatz lehnt technische Routen wie HBM und 3D-Packaging, die den Datentransport beschleunigen, nicht ab, sondern ergänzt sie in der Dimension, dass Daten möglichst gar nicht transportiert werden müssen.
Auf dieser Grundlage schlägt Yizhu Technology weiter einen universellen Ansatz für das In-Memory-Computing vor. In-Memory-Computing-Einheiten eignen sich gut für rechenintensive Operationen mit festen Parametern wie Matrixmultiplikation und Matrixaddition; universelle SIMT-Einheiten übernehmen komplexe, unregelmäßige Berechnungsaufgaben mit komplexer Steuerlogik sowie Skalar- und Logikoperationen. Die heterogene Verschmelzung beider behält sowohl die Vorteile des In-Memory-Computings bei Energieeffizienz und Latenz als auch das Programmiermodell und die Allgemeingültigkeit der GPU bei, und schafft eine Hardwaregrundlage für die Kompatibilität mit Mainstream-Ökosystemen wie CUDA. Diese Arbeitsteilungslogik, bei der spezielle Einheiten spezielle Aufgaben erledigen und universelle Einheiten universelle Aufgaben erledigen, entspricht auch dem von dem Unternehmen vorgeschlagenen Gesetz des heterogenen Endzustands.
II. Technischer Durchbruch: 3D-DRAM und vollständig digitales Konzept lösen Probleme bei Kapazität und Genauigkeit
Die Speicherkapazität ist die entscheidende Einschränkung dafür, ob ein In-Memory-Computing-Chip die Parameter großer Modelle tragen kann. Yizhu Technology hat 3D-DRAM als Speichermedium gewählt, unter Berücksichtigung von Kapazität, Stabilität und Kosten-Leistungs-Verhältnis. Das 3D-Stapeln trägt nicht nur zur Erhöhung der Speicherkapazität bei, sondern verbessert auch die Speicherbandbreite und den Datendurchsatz, und schafft die physische Grundlage für In-Memory-Computing-Chips, die über die MB-Kapazität hinauswachsen. Während der fortlaufenden Generierung von Tokens großer Modelle wirken sich die große Kapazität und die hohe Bandbreite direkt auf die Effizienz der Inferenzausgabe aus.
Was die Rechengenauigkeit betrifft, verfolgt Yizhu Technology einen vollständig digitalen Weg statt eines analogen Rechenpfades. Das vollständig digitale In-Memory-Computing kehrt zur Determiniertheit digitaler Schaltkreise zurück, hilft, Genauigkeitsverluste durch Nichtidealitäten von Bauelementen zu vermeiden, hat Vorteile bei Genauigkeit, Fehlertoleranz und Architekturintegration und gewährleistet die hochpräzise Berechnung, die für die Inferenz großer Modelle erforderlich ist. Die digitale In-Memory-Computing-Architektur verarbeitet digitale Signale auf der Grundlage herkömmlicher Speicher, und ist auch bei der Zuverlässigkeit der Datenspeicherung und den Herstellungskosten besser kontrollierbar.
Durch Drittvalidierungen wurde nachgewiesen, dass das universelle In-Memory-Computing-Konzept von Yizhu im Vergleich zu Mainstream-GPUs in der Cloud eine mehrfache Leistungssteigerung, etwa 1/5 des Stromverbrauchs und etwa 1/6 der Kosten aufweist. In Szenarien der Inferenz großer Modelle können die Gesamt-TCO der Inferenzrechenleistung bei gleichem Geschäftsvolumen um bis zu etwa 88 % sinken. Dieses Energieeffizienzverhältnis ist eine relativ intuitive quantitative Referenz für die technische Stärke von Yizhu Technology in Rechenzentrums- und Cloud-Computing-Szenarien.
III. Szenariowert: Software- und Systemunterstützung für Inferenz großer Modelle und Agentic AI
Über die Hardwarearchitektur hinaus hat Yizhu Technology auf Software- und Systemebene ein Full-Stack-Technologiesystem aufgebaut, das einen eigenständigen ISA-Befehlssatz, eine Hard- und Software kooperierende Architektur, heterogene verschmolzene Rechen-IPs, einen CUDA-kompatiblen Compiler, einen Operatorenpool und ein Rechenleistungs-Netzwerksystem abdeckt. Der CUDA-kompatible untergeordnete Befehlssatz und die mit PyTorch kompatible Entwicklungsumgebung zielen darauf ab, die Migrationshürden für Entwickler zu senken, sodass die neue Architektur die untergeordnete Aktualisierung durchführen kann, während die ursprünglichen Entwicklungsgewohnheiten beibehalten werden, was praktische Bedeutung für die Umsetzungsbereitschaft von Rechenzentrums- und Cloud-Computing-Kunden hat.
Angesichts der wachsenden Nachfrage nach Rechenleistung im Zeitalter von Agentic AI unterstützt das universelle In-Memory-Computing-Konzept von Yizhu Funktionen wie ein außergewöhnlich langes Kontextfenster von 1M, gemischte Genauigkeit und MoE-Sparse-Berechnung, clusterweite KV-Cache-Pooling, was dazu beiträgt, die Latenz bei der KV-Cache-Abfrage zu senken, die Fähigkeit zur Verarbeitung langfristiger Aufgaben und den Durchsatz effektiver Rechenleistung zu verbessern. Im PD-Inferenzablauf zeigt die herkömmliche Architektur gute Leistungen in der Vorauffüllphase, während das In-Memory-Computing deutliche Vorteile in der Decodierungsphase aufweist. Die Zusammenarbeit beider kann eine bessere Lösung für das Gesamtkonzept erzielen.
Bei der Produktlayout treibt Yizhu Technology die Entwicklung kontinuierlich für verschiedene Szenarien wie Cloud, Edge und Endgeräte voran. Ausgehend von hochleistungsfähigen Chips für die Cloud erstreckt sich das Angebot auf Bereiche wie Superknoten und große Endgeräte, und deckt verschiedene Hardwareformen wie Workstations, All-in-One-Geräte und verteilte Cluster ab, um den Rechenleistungsanforderungen unterschiedlicher Größenordnungen und Anwendungsszenarien gerecht zu werden.
Zusammengefasst beschränkt sich die technische Stärke von Yizhu Technology nicht auf einzelne Indikatoren, sondern bildet ein systematisches Layout von der Architektur bis zum Software-Stack, das sich um 3D-DRAM, vollständig digitales In-Memory-Computing und universelle heterogene Verschmelzung dreht. In der Phase, in der der Wettbewerb um KI-Rechenleistung von dem Vergleich von Spitzenwerten zu dem Vergleich von kommerzieller Effizienz übergeht, bietet dieser technische Pfad, der die Kosten für Datentransport, Softwaremigration und Systemkoordination berücksichtigt, eine beachtenswerte Option für Rechenleistung für Szenarien wie Rechenzentren, Cloud Computing und die Inferenz großer Modelle. Die weitere Entwicklung der technischen Stärke von Yizhu Technology wird sich weiterhin auf die universelle In-Memory-Computing-Architektur, die selbst entwickelte ISA und den Aufbau des Software-Ökosystems konzentrieren, um eine Rechenleistungsinfrastruktur für die Inferenz großer Modelle und neue KI-Anwendungen zu erforschen.