Der größte Börsengang der Geschichte steht unmittelbar bevor, Tencent, Alibaba und ByteDance wetteifern um KI-Grafikkarten: Anthropic und große chinesische Technologiekonzerne sind gemeinsam völlig besessen von Rechenleistung.
Anthropic strebt den größten Börsengang seiner Geschichte an, in seinem Prospekt werden die Investitionen in Rechenleistung und die Risiken der Versorgung auf den Tisch gebracht; Tencent, Alibaba und ByteDance haben 35 Milliarden US-Dollar ausgegeben, um Grafikkarten zu ergattern, und Kimi entschuldigt sich bei Nutzern für den zu schnellen Verbrauch von Guthaben … Wenn AI-Agenten zunehmend komplexere Aufgaben übernehmen, werden Inferenzanforderungen, Rechenkosten und kommerzielle Rendite zu ein und derselben Prüfungsaufgabe.
Je leistungsfähiger der AI-Agent ist, desto schneller kann das Guthaben der Nutzer verbraucht werden.
Am 24. Oktober veröffentlichte Moonshot AI Kimi K3.1 Pro. Dies ist das erste Modell der K3.1-Serie mit einem Parameterumfang von 3 Billionen, der einen Kontext von 1 Million Token unterstützt. Die offizielle Seite betonte vor allem die Fähigkeiten des Modells bei der Programmierung, der 3D-Erstellung und langfristigen Agentenaufgaben. Aber nach der Einführung des neuen Modells stellten einige zahlende Nutzer fest, dass das Guthaben fast aufgebraucht war, bevor die Aufgabe abgeschlossen war.
Am 26. Oktober entschuldigte sich Moonshot AI öffentlich, räumte ein, dass bei Kimi-Mitgliedern bei der Nutzung von K3.1 Pro eine Drosselung und ein „unnötiger Guthabenverbrauch“ aufgetreten seien, und entschädigte abonnierte Mitglieder mit gültiger Laufzeit mit einem Guthaben, das 25 % des monatlichen Gesamtbetrags entspricht.
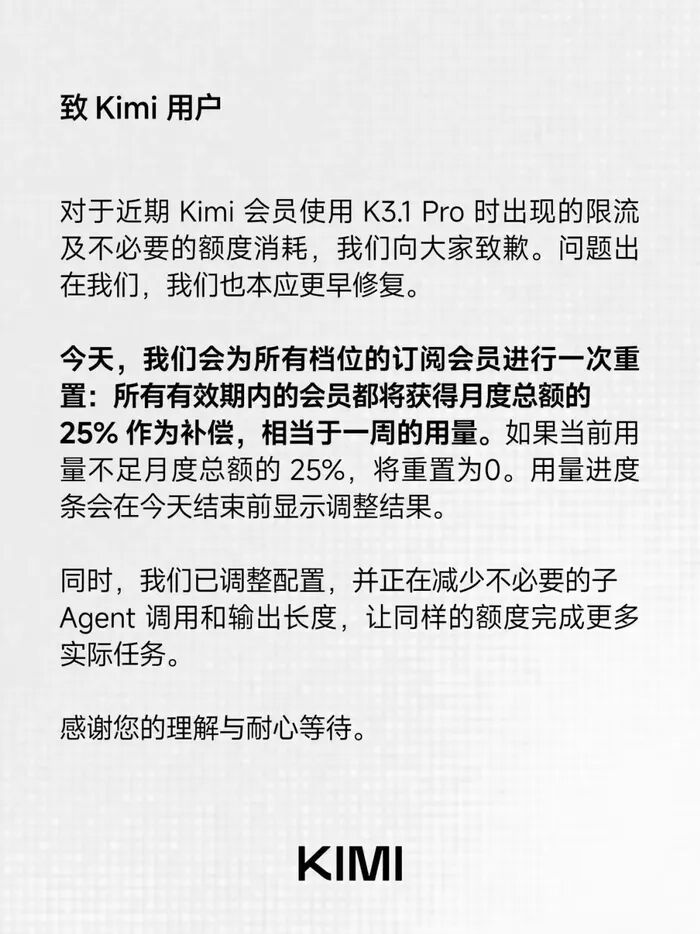
Wo liegt das Problem? Wenn ein Nutzer eine Anweisung sendet, kann das Backend bereits mehrere Unteragenten gestartet haben, die jeweils für die Zerlegung von Aufgaben, die parallele Abfrage, die Analyse von Materialien, die Überprüfung von Ergebnissen und die Zusammenfassung der Ausgabe zuständig sind. Was der Nutzer sieht, ist eine einzelne Aufgabe, aber was das Modell tatsächlich ausführt, kann eine Kette von Aufrufen sein. Je komplexer die Aufgabe ist, desto mehr Token und Rechenressourcen werden im Backend verbraucht.
Ähnliche Beschwerden tauchen auch in der Nutzer-Community von Claude auf.
Ein Nutzer postete auf Reddit, dass Claude Opus 5.5 beim Organisieren von 87 Textdokumenten automatisch 12 gleichrangige Unteragenten gestartet habe und das gesamte 5-stündige Nutzungsguthaben in 5 Minuten erschöpft habe; ein anderer Nutzer berichtete, dass bei der Bearbeitung von Code-Aufgaben mit Opus 5.5 in weniger als 30 Minuten die 5-Stunden-Grenze des Guthabens ausgelöst wurde.
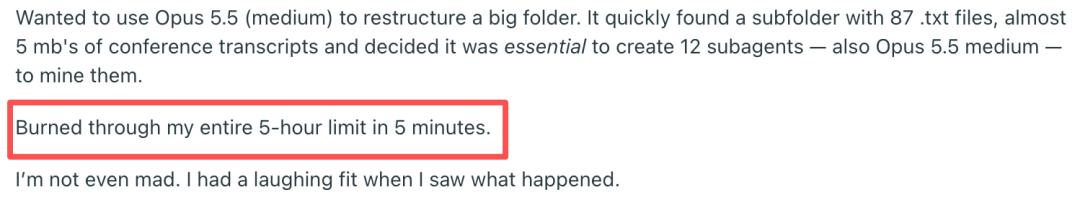
Diese Einzelfälle sind nicht unbedingt allgemeingültig, aber die Beschwerden über den zu schnellen Verbrauch von Guthaben haben ein praktisches Problem von Agentenprodukten auf den Tisch gebracht: Wie viel zusätzliche Rechenkosten verursachen Backend-Aufrufe und welchen tatsächlichen Nutzen bringen sie den Nutzern?
Gestern reichte Anthropic seinen Börsengangsantrag bei der U.S. Securities and Exchange Commission ein. In seinem Prospekt wurden die Sicherstellung ausreichender Rechenressourcen und die kontinuierliche Investition in die Infrastruktur für Rechenleistung in den Rahmen für Betriebs- und Risikofaktoren des Unternehmens aufgenommen, und das Unternehmen legte seine Nutzungsvereinbarungen für verschiedene Rechenressourcen wie AWS Trainium, Google TPU, Nvidia-GPUs und AMD-GPUs offen.
Nutzer kümmern sich darum, ob das Guthaben ausreicht, und Modellanbieter müssen überlegen, wie viel Rechenleistung sie für die Unterstützung dieser komplexen Aufgaben investieren müssen und ob sie daraus ausreichende kommerzielle Renditen erzielen können.
Ein potenzieller Einkaufsauftrag, der kürzlich von Reuters aufgedeckt wurde, hat diesen Druck von Angebot und Nachfrage auf eine größere industrielle Ebene gehoben.
Laut Reuters, das auf informierte Personen verweist, übersteigt die Gesamtnachfrage von ByteDance, Alibaba und Tencent nach Nvidia RTX PRO 5500 3 Millionen Einheiten. Nach Schätzungen mit einem Preis von etwa 11.400 US-Dollar pro Einheit übersteigt das potenzielle Auftragsvolumen 35 Milliarden US-Dollar. Gleichzeitig kann Nvidia nicht garantieren, die gesamte Nachfrage zu decken, und die tatsächliche Liefermenge könnte weit unter der beabsichtigten Bestellmenge liegen.
Der potenzielle Auftrag im Wert von 35 Milliarden US-Dollar und die Beschwerden der Nutzer über den zu schnellen Verbrauch des Guthabens scheinen zwei verschiedene Probleme zu sein, beide hängen jedoch mit dem Wachstum der Inferenzanforderungen zusammen. Wenn die KI von der Beantwortung von Fragen zur Ausführung komplexer Aufgaben übergeht, steigt der Verbrauch von Rechenressourcen, und der Druck erstreckt sich von der Nutzerseite auf Modellanbieter und die Chip-Lieferkette.
Wie stark ist die Nachfrage nach Inferenz-Rechenleistung tatsächlich gestiegen? Warum kaufen große chinesische Internetunternehmen gebündelt Nvidia-Grafikkarten, deren Leistung unter der von Top-Rechenzentrumschips liegt? Wie wird dieser Run auf Grafikkarten den Kommerzialisierungsprozess von inländischen Chips beeinflussen?
Sogar Workstation-Grafikkarten werden knapp: Wovon sind große Unternehmen besorgt?
Wenn man die Zeit ein Jahr zurückdreht, hätte die von der RTX PRO 5500 vertretene Produktlinie nicht unbedingt so viel Aufmerksamkeit erregt.
Laut früheren Berichten von Reuters hatten einige große Technologieunternehmen kein großes Interesse, als Nvidia eingeschränkte Produkte wie die RTX 6000D für den chinesischen Markt auf den Markt brachte. Sie waren der Meinung, dass der Preis und die Leistung solcher Chips nicht übereinstimmten, und erwarteten, dass die US-Regierung die Rückkehr leistungsstärkerer Produkte auf den chinesischen Markt erlauben würde.
Dieses Warten hat keine sicheren Ergebnisse gebracht. Die US-Exportbeschränkungen für Chips nach China bestehen fort, der Export von Produkten wie der H200 erfordert die Erfüllung spezifischer Lizenzbedingungen, und die leistungsstärkere B300 kann nach den geltenden Beschränkungen nicht nach China verkauft werden. Gleichzeitig expandieren KI-Modelle und -Anwendungen weiter, Unternehmen müssen kontinuierlich neue Modelle bereitstellen und den Dienstumfang erweitern, aber die Versorgung mit Rechenleistung kann nicht unbedingt mit dem Geschäftstempo Schritt halten.
In einem solchen Umfeld von Angebot und Nachfrage ist die verfügbare und bereitstellbare Rechenleistung wichtiger als die ideale Chipspezifikation.
Was genau kann die RTX PRO 5500 leisten? Aus der Produktpositionierung gehört die RTX PRO 5500 zu den professionellen Workstation-GPUs von Nvidias Blackwell-Architektur: 84 GB GDDR7-Videospeicher, eine Videospeicherbandbreite von etwa 1398 GB/s und eine maximale Leistungsaufnahme von 600 W. Nvidia weist ihr Einsatzbereiche wie agentische KI, physische KI, Simulation und Grafikverarbeitung zu.
Der 84 GB große Videospeicher und die entsprechende Rechenleistung machen sie geeignet, einen Teil der KI-Inferenzaufgaben zu übernehmen. Im Vergleich zu Verbrauchergrafikkarten verfügen professionelle Workstation-GPUs zudem über Designs und Unterstützungsfunktionen für professionelle Szenarien.
Aber verwechseln Sie sie nicht mit H200 und B300: Die beiden letzteren sind für große Rechenzentrumscluster konzipiert, unterstützen hochintensives KI-Training und -Inferenz und übernehmen schwerere Modelllasten durch großangelegte Vernetzung. Die RTX PRO 5500 ist eher eine Workstation-GPU, die professionelle Berechnungen und einen Teil der KI-Inferenz übernehmen kann.
Ob ein bestimmtes Modell effizient ausgeführt werden kann, hängt von der Modellgröße, der Quantisierungsmethode, der parallelen Bereitstellung, der Softwareanpassung und dem tatsächlichen Durchsatz ab.
Sie kann einen Teil des Rechenbedarfs decken, aber sie kann nicht allein aufgrund von 84 GB Videospeicher als Ersatz für High-End-Rechenzentrum-GPUs eingestuft werden. Reuters berief sich auf informierte Quellen und sagte, dass chinesische Unternehmen diese Charge von Grafikkarten hauptsächlich für die KI-Inferenz beschaffen.
Inferenz findet statt, nachdem das Modell trainiert wurde: Eine Nutzerfrage, eine Code-Generierung, eine Abfrage des unternehmensweiten Wissensspeichers oder sogar die aufeinanderfolgende Aufrufung mehrerer Modelle durch einen Agenten bei der Ausführung von Aufgaben erzeugen einen Inferenzrechenbedarf.
Training gleicht einem zentralen Bauprozess, Inferenz gleicht der täglichen Wasserversorgung: Beim Modelltraining wird normalerweise eine große Menge an Rechenleistung konzentriert, um Parameteraktualisierungen in einem relativ kurzen Zeitraum abzuschließen; Inferenz folgt der Nutzung des Produkts: Je mehr Nutzer es gibt, je häufiger Aufrufe stattfinden und je komplexer die Aufgaben sind, desto kontinuierlicher muss das Modell den Rechenbetrieb aufrechterhalten.
Nachdem der Agent von der „Beantwortung von Fragen“ zur „Ausführung von Aufgaben“ übergeht, wird das Inferenzvolumen noch mehrfach vergrößert. Eine einzelne Nutzeranfrage kann in mehrere Schritte unterteilt werden: Material abfragen, Aufgabe zerlegen, Tools aufrufen, Ergebnis generieren und Ergebnis überprüfen. Die Sorge der Unternehmen hat sich von „Habe ich genug Grafikkarten, um das Modell zu trainieren?“ zu „Kann ich das Modell kontinuierlich, stabil und kostengünstig betreiben?“ gewandelt.
Dies erklärt, warum ein Produkt, dessen Leistung unter der von Top-Rechenzentrumschips liegt, immer noch von großen Unternehmen eifrig gekauft wird.
Wofür werden diese Grafikkarten konkret verwendet? Wir haben Tencent und ByteDance nach der Einkaufsmenge, den Bereitstellungsszenarien und Alternativlösungen gefragt. Tencent gab an, keine Informationen zu haben, ByteDance und Alibaba haben bis zum Redaktionsschluss nicht geantwortet.
Die verfügbaren Informationen reichen nicht aus, um diesen Auftrag in die spezifischen Geschäftspläne der drei Unternehmen aufzuteilen: Es kann nicht festgestellt werden, dass ByteDance ihn unbedingt für Doubao verwendet, Alibaba ihn unbedingt für Qwen einsetzt, wie viel jeder bestellt hat, wo es bereitgestellt wird und ob es bereits in Kombination mit inländischen Chips verwendet werden soll, muss noch bestätigt werden.
Was bestätigt werden kann, ist die industrielle Anwendungsrichtung. Theoretisch können solche Grafikkarten Online-Dienste für mittelgroße und kleine Modelle, einige interne KI-Anwendungen von Unternehmen, die Ausführung von Agentenaufgaben und professionelle Rechenlasten mit bestimmten Anforderungen an den Videospeicher übernehmen. Bei konkreten Aufgaben müssen Parameterumfang, Quantisierungslösung, gleichzeitige Anfragen und Latenzanforderungen noch bewertet werden. Einige Geschäftsbereiche können auch Multi-GPU-Bereitstellungen einsetzen, aber die Effizienz und die Kosten mehrerer GPUs lassen sich nicht direkt aus den Spezifikationen einer einzelnen GPU ableiten.
Inferenz schließt Training nicht vollständig aus. Workstation-GPUs können für Entwicklung, Test und leichtes Fine-Tuning verwendet werden; aber in diesem Einkauf verweist Reuters auf die Hauptverwendung für die KI-Inferenz. Ohne weitere Beweise sollte man nicht davon ausgehen, dass große Unternehmen nach Top-Pretraining-Rechenleistung suchen.
Was den Grund betrifft, warum man nicht vollständig auf inländische Chips umsteigt, so muss die Antwort im Kontext des Software-Ökosystems, der vorhandenen Cluster, der Migrationskosten und der Bereitstellungseffizienz betrachtet werden. Der Kauf von Nvidia-Produkten bedeutet nicht, dass die drei Unternehmen keine inländischen Chips verwenden; es kann sich auch nur um eine Ergänzung des vorhandenen Rechenleistungssystems handeln. Es lohnt sich mehr zu fragen, wie viel Unternehmen für verfügbare Inferenz-Rechenleistung zu zahlen bereit sind und wie groß sie die zukünftige Nachfrage einschätzen.
Außerdem müssen wir klarstellen: Ein Auftragsvolumen von 35 Milliarden US-Dollar bedeutet nicht, dass Nvidia bereits sichere Einnahmen in gleicher Höhe erzielt hat.
Laut Reuters übersteigt die entsprechende Nachfrage chinesischer Kunden 6 Millionen Einheiten; Nvidia erwartet, dass die weltweite Produktion der RTX PRO 5500 im Jahr 2027 3 Millionen Einheiten nicht übersteigen wird. Das Unternehmen muss zudem verschiedene Produktlinien ausbalancieren und mehr Produktionskapazität für die nächste Generation der Rubin-Plattform bereitstellen.
Selbst wenn alle Einkaufsabsichten umgesetzt werden, wird die Lieferung durch die Produktionskapazität eingeschränkt. Für Käufer geht es darum, die Versorgung im Voraus zu sichern und zukünftige Ressourcen zu ergattern. Selbst wenn die endgültige Liefermenge weit von der ursprünglichen Nachfrage abweicht, kann der Erhalt eines Teils der Lieferung die Rechenleistung ergänzen, die Erweiterung unterstützen oder die Last vorhandener Cluster anpassen.
Wie viel die Sicherung der Versorgung wert ist, hängt von den Vertragsbedingungen, dem endgültigen Transaktionspreis, der konkreten Liefermenge und davon ab, ob das Produkt wie geplant bereitgestellt werden kann. Für den Kapitalmarkt sind dies die Informationen, die weiterverfolgt werden müssen, um den Wert des Auftrags zu beurteilen.
Für Nvidia zeigt dieser Auftrag, dass selbst wenn einige High-End-Produkte von Exportbeschränkungen betroffen sind, der chinesische Markt weiterhin sein Produktökosystem und seine Rechenkapazität benötigt. Wie viel von dieser Nachfrage zu tatsächlichen Einnahmen wird, hängt auch von der späteren Lieferung ab.
Für die gesamte Industrie beeinflusst die Lieferfähigkeit zunehmend die Geschwindigkeit, mit der Unternehmen KI-Dienste bereitstellen. Die Leistung von Chips ist nach wie vor wichtig, aber die Unsicherheiten bei Einkauf und Lieferung werden zu realen Variablen im Wettbewerb um Rechenleistung.
Der Kauf von Grafikkarten ist nur der Anfang: Die kommerzielle Bilanz der KI-Inferenz ist das Wichtigste
Die Einkaufsabsicht im Wert von 35 Milliarden US-Dollar reicht aus, um die Erwartungen großer Unternehmen an den zukünftigen Bedarf an Rechenleistung widerzuspiegeln, aber sie beweist nicht direkt, dass die chinesische KI-Inferenz bereits vollständig unter Angebotsmangel leidet.
Daten von IDC zeigen, dass im ersten Halbjahr 2026 die Liefermenge von KI-Beschleunigern in China etwa 2,008 Millionen Einheiten betrug. Davon entfielen etwa 678.000 Einheiten auf Nvidia, was 34 % des Marktes entspricht; Huawei lieferte etwa 572.000 Einheiten aus, was 28 % entspricht. T-Head unter Alibaba hält 7 %, Cambricon 5 %, Kunlunxin von Baidu 4 % und Haiguang 3 %.