"Viele Forschungsarbeiten sind bereits sinnlos": Im Wissenschaftsumfeld der Tsinghua-Universität wird darüber diskutiert, wie wissenschaftliche Forschung mit KI betrieben werden kann.
Nobelpreisträger Feynman: „Täusche dich nicht selbst – und du bist der Mensch, der sich am leichtesten selbst täuscht.“

Text | Li Jiaxing
Was ist es wert, ausgewählt zu werden?
„Wenn ich mich irre, müsst ihr auch euren Rektor verstehen: Viele Forschungsarbeiten haben bereits keinen Sinn mehr. Ihr müsst euch das klar bewusst machen, wirklich sinnvolle Forschung betreiben und eure Zeit nicht mehr verschwenden.“
Als es um die wissenschaftliche Forschung ging, legte Rektor Li Luming die höflichen Worte der Eröffnungsrede ab und zeigte die Geradlinigkeit eines Gelehrten.
Am 9. Oktober begrüßte ein von der studentischen Vereinigung AI4S initiierter Forum an der Tsinghua-Universität Nobelpreisträger, Akademiemitglieder und Professoren mehrerer Disziplinen, um gemeinsam die Forschungsfortschritte von AI4S zu erörtern.
Hier gibt es keinen Börsengang, keine Bewertung und keine Exit-Zyklen. Nur wissenschaftliche Berichte, seitenweise Experimentaldaten und ungelöste wissenschaftliche Probleme.
Seiner Ansicht nach werden zukünftige Wissenschaftler nicht nur Menschen sein, die Geräte bedienen oder Synthesen durchführen. Sie werden zunehmend Menschen sein, die „wichtige Fragen stellen, Ziele definieren, Beweise bewerten, zufällige Entdeckungen erkennen, Wissen aus verschiedenen Bereichen verbinden und entscheiden, welche Richtung es wert ist, erforscht zu werden.“
Vor dem Nobelpreisträger Professor Omar Yaghi liegt eine Materialwelt, die fast unerschöpflich ist.
Das Forschungsgebiet von Professor Yaghi ist die Netzwerkchemie, bei der verschiedene netzwerkartige Materialien durch die Steuerung der Zusammensetzung und Geometrie der Baueinheiten konstruiert werden. Professor Yaghi schätzt, dass der chemische Raum der von ihm diskutierten netzwerkartigen Materialien bis zu 10 hoch 3000 erreichen kann.
„Wir werden sie niemals alle herstellen können, nicht einmal alle berechnen.“
Professor Yaghi stellt die Frage an die jungen Leute im Publikum und auch an sich selbst: Was ist es wert, ausgewählt zu werden?
„Wir treffen ständig Entscheidungen: Welches Problem wir erforschen, welches Experiment wir durchführen und welche zufällige Beobachtung wir verfolgen. Aber diese Entscheidungen hängen stark von der Intuition ab. Die Intuition kann sehr mächtig sein, aber sie kann auch voreingenommen, unvollständig oder falsch sein.
Wenn du vor zehn Möglichkeiten stehst, kann dir die Intuition vielleicht weit helfen; aber wenn du vor 10 hoch 3000 Möglichkeiten stehst, reicht die Intuition nicht mehr aus.“
Aus diesem Grund schlägt er „Selection Science“ vor, die untersucht, was es wert ist, verfolgt zu werden, und was als Nächstes getan werden soll, wenn die Möglichkeiten die Explorationsfähigkeit bei weitem übersteigen.
Professor Yaghi beschrieb auch, wie diese Auswahl in das Labor Einzug halten wird. In der an der Tsinghua-Universität gegründeten Forschungseinrichtung baut sein Team ein selbstständig betriebenes Labor: Künstliche Intelligenz schlägt Materialkonzepte vor, Robotersysteme synthetisieren und charakterisieren diese Materialien, die Experimente erzeugen zuverlässige Daten, die Ergebnisse werden in das Modell zurückgespeist, und das System entscheidet dann, welches Experiment als Nächstes durchgeführt werden soll.
Das unterscheidet sich stark von den Laboren, die viele Menschen aus ihrer Ausbildungszeit kennen.
Solche Systeme werden in Ländern und Regionen mit starker wissenschaftlicher Forschung verteilt sein, wie Italien, Spanien, Großbritannien, Nordamerika und Singapur.
An dieser Stelle schilderte Professor Yaghi seine Vorstellung weiter: „Stell dir vor, dreißig solcher Forschungseinrichtungen sind miteinander verbunden, sammeln ständig zuverlässige Daten und speisen diese in unser KI-Modell ein. Ein solches Modell wird voraussichtlich das beste der Welt werden und den wissenschaftlichen Fortschritt vorantreiben.“
In seiner Vorstellung muss sich das Labor nicht mehr nur darum kümmern, wie viele Experimente durchgeführt wurden. Er stellte eine viel wichtigere Frage: „Hat dieses Experiment das nächste Experiment besser gemacht?“
Daten müssen praktikabel und vor allem vertrauenswürdig sein
Nachdem ich die Berichte mehrerer Teams angehört habe, ist mir aufgefallen, dass sie alle viel Platz der grundlegenden Datenbank gewidmet haben.
Professor Gao Xiangyu ist stellvertretender Chefarzt am Tumorkrankenhaus der Peking-Universität und forscht seit langem an Magenkrebs.
Professor Gao sagte offen: Alle meine Studenten und auch unsere Kollegen, die heute an Tumoren forschen, nutzen eine sehr wichtige Datenbank – das amerikanische TCGA. Diese Datenbank wird seit ihrem Aufbau in den 1990er Jahren bis heute täglich genutzt.
Nach seinen Angaben im Bericht gibt es weltweit jährlich etwa 1 Million neue Fälle von Magenkrebs, davon etwa 400.000 in China.
„Das ist unser eigener Krebs in China, den wir selbst erforschen müssen.“
Seiner Ansicht nach können ausländische Datenbanken den Zustand chinesischer Patienten jedoch nicht vollständig widerspiegeln. Er nahm die 2014 in Nature veröffentlichte Studie zur molekularen Subtypisierung von Magenkrebs von TCGA als Beispiel: Die Studie unterteilte Magenkrebs in vier molekulare Subtypen, aber nur der Teil der MSI-H-Patienten kann die Behandlung wirklich leiten.
Nicht nur im medizinischen Bereich versuchen auch inländische Forschungsteams in Bereichen wie Mechanik, Energie und Geologie, ihre eigenen grundlegenden Datenbanken aufzubauen.
In den wissenschaftlichen Berichten habe ich einen interessanten Punkt entdeckt: Die Methoden zum Aufbau der Datenbanken sind unterschiedlich.
Professor Gao erklärte die bestehenden Dateneinschränkungen anhand von Fotos: „Die meisten heutigen Datenbanken sind Einzelpunkte, die ich als Snapshot bezeichne. Zum Beispiel mache ich heute ein Foto, es sieht zu diesem Zeitpunkt so aus, aber dieser Zeitpunkt heute und der Zeitpunkt morgen können schon unterschiedlich sein.“
Der tatsächliche Prozess ist genauso: Der Patient erhält eine Behandlung, sein Zustand ändert sich entsprechend, danach kann es zu einem Rezidiv und einer erneuten Behandlung kommen. Wenn nur die Daten einer einzigen Untersuchung gespeichert werden, können Forscher diesen Prozess kaum klar erkennen.
„Wir legen jetzt mehr Wert auf die mehrpunktige Probenahme über den gesamten Verlauf.“
Als es um die Nachsorge ging, erzählte Professor Gao Xiangyu von den Patienten in seiner Ambulanz, von denen viele langfristig mit ihm in Kontakt bleiben. In seinem Bericht betonte er die Vorteile seines Teams beim Aufbau der Datenbank: Die Patienten werden während der langfristigen Diagnose und Behandlung kontinuierlich verfolgt, um Behandlungs- und Nachsorgeaufzeichnungen zu sammeln.
Diese Aufzeichnungen müssen schließlich derselben Person zugeordnet werden. Er schlug das Konzept „eine Person, eine Akte“ vor, das klinische Informationen, Bilder und Texte, Multi-Omics-Daten sowie Nachsorgeaufzeichnungen verknüpft. Nur so können Forscher vergleichen, welche Veränderungen bei den Patienten vor und nach der Behandlung aufgetreten sind, und die Beziehung zwischen diesen Veränderungen sowie der Wirksamkeit der Behandlung und der Prognose suchen.
Professor Xu Zhiping hat die gleiche Erkenntnis über die Dynamik von Daten.
Professor Xu Zhiping ist Professor an der Fakultät für Ingenieurmechanik der Tsinghua-Universität und Direktor des Instituts für Festkörpermechanik, er befasst sich hauptsächlich mit theoretischer Forschung.
Bei der Erforschung mechanischer Materialien stellte er fest, dass es am Anfang sehr einfach ist, zu beurteilen, ob ein Material gut ist – es kann schnell durch Experimente gefiltert werden. Aber im praktischen Einsatz beeinflussen Faktoren wie Temperatur und Belastung die Eigenschaften des Materials, und im Inneren können allmählich Schäden entstehen.
Dieser theoretisch arbeitende Professor nannte gleich zu Beginn sein Anliegen: „Das eine ist Praktikabilität, das andere ist Vertrauenswürdigkeit.“
Er führte das Beispiel des Kriechversuchs an: Das Langzeitverhalten von Materialien bei hohen Temperaturen kann nur nach Jahren oder sogar Jahrzehnten beobachtet werden. Wenn man beurteilen will, ob die Lebensdauer eines Kernkraftwerks verlängert werden kann, können Forscher nicht Jahrzehnte warten, bevor sie eine Antwort geben.
„Aber wie soll man wissen, was mit dem Kernkraftwerk nach 100 Jahren passiert?“
Professor Xu Zhiping erklärte, ein Ansatz bestehe darin, die Experimenttemperatur zu erhöhen, damit die Veränderung schneller abläuft, dann die physikalische Entsprechungsbeziehung zwischen verschiedenen Temperaturen zu suchen und Kurzzeitexperimente zu nutzen, um das Langzeitverhalten bei niedrigeren Temperaturen zu verstehen.
„Man kann ein sehr kurzes Hochtemperaturexperiment durchführen und die Daten auf den langen Zeitraum bei niedriger Temperatur anwenden.“
Derselbe Gedanke wird auch verwendet, um einfache Systeme mit komplexen Systemen zu verbinden. Professor Xu Zhiping erläuterte, dass sie zuerst eine große Menge physikalisch plausibler Daten in einfachen Systemen erzeugen, damit das Modell die Beziehungen darin lernen kann, und dann auf komplexere Strukturen anwenden. Mit der schrittweisen Erweiterung des Systems wird eine Kette der „physikalischen Übertragung“ aufgebaut.
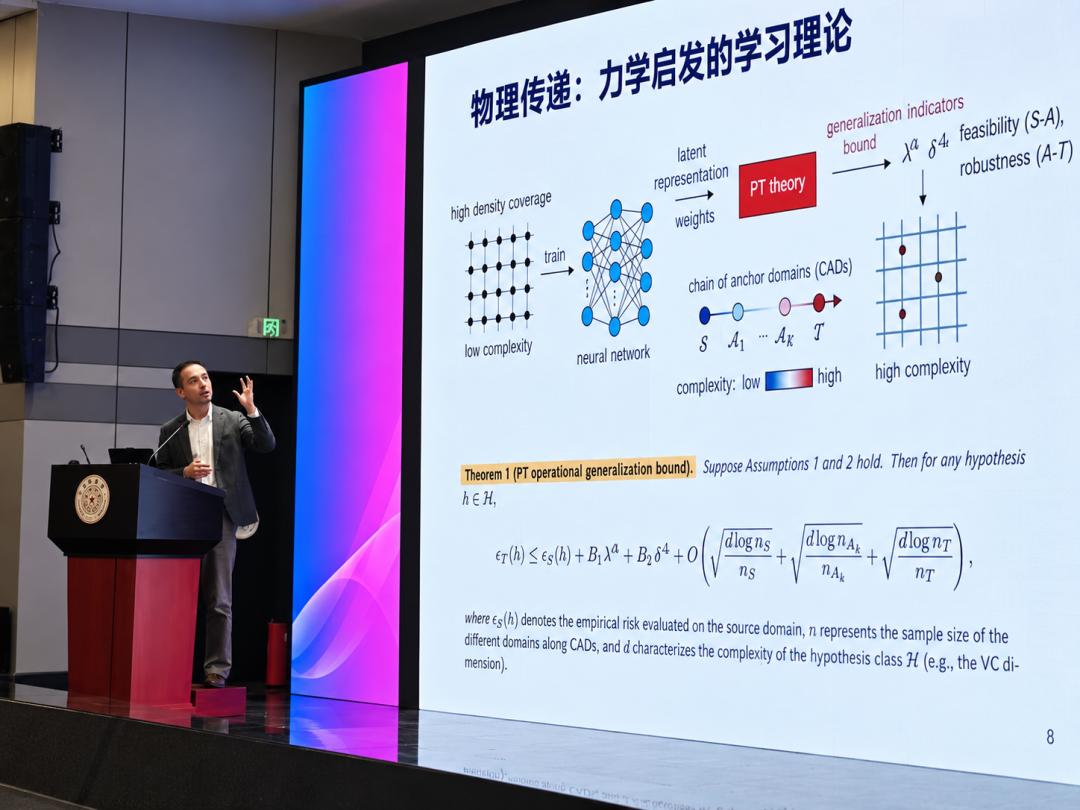
Die Theorie der physikalischen Übertragung von Professor Xu
Was hier übertragen werden soll, sind die physikalischen Beziehungen in den Daten. In einfachen Systemen lassen sich Daten leichter gewinnen. Mithilfe von Modellen wenden Forscher diese Beziehungen auf komplexe Probleme an, die nicht vollständig beobachtet werden können, und bewerten dann den Umfang und den Fehler dieser Schlussfolgerungen.
Zu den von maschinellem Lernen erzeugten Daten erinnert Professor Xu Zhiping daran, dass die visuelle Ähnlichkeit erzeugter Daten keine physikalische Plausibilität garantiert.
Professor Xu Zhiping zeigte in seinem Bericht zwei Zellbilder: eines aus dem Experiment, das andere von einem Modell erzeugt. Das erzeugte Bild versucht, dem Aussehen im Experiment nahe zu kommen.
„Die erzeugten Daten scheinen dem Original ähneln zu wollen, aber sie sind doch nicht ganz gleich.“
Professor Xu Zhiping erklärte, um die physikalischen Gesetze hinter den Bildern zu verstehen, muss man nicht unbedingt die Position jedes Pixels verfolgen. Wichtiger ist es, die Schlüsselstrukturen und ihre zeitlichen Veränderungsmerkmale zu erkennen. Zum Beispiel muss nach der Datenreduktion überprüft werden, ob die erforderlichen Informationen erhalten geblieben sind.
Professor Xu Zhiping unterteilte die Bewertung in zwei Teile: Wie weit die Schlussfolgerungen aus einfachen Systemen reichen und ob die Daten ausreichend sind, ist die Praktikabilität. Wie weit die abgeleiteten Ergebnisse von den endgültigen Ergebnissen abweichen, ist die Vertrauenswürdigkeit. Sowohl die Datenmenge als auch die Modellkomplexität müssen in diese Beurteilung einbezogen werden.
Anomaliedaten, die frühzeitig erkannt werden müssen, lassen sich gerade nicht direkt erfassen
Nachdem mehr Daten berechnet wurden, gibt es noch eine Aufgabe: Zu beurteilen, ob diese Daten verwendet werden können. Vor allem im industriellen Bereich kann dieser Schritt nicht übersprungen werden.
Akademiemitglied Sun Lili von Sinopec erinnerte bei der Besprechung der Datenbank: „Datenfehler werden entlang der Kette schrittweise verstärkt. Je weiter stromabwärts man kommt, desto schwerwiegender kann das Problem werden.“
Sie sprach über die Verwendung von Daten nach deren Eingang in den Ingenieurbereich. Abweichungen in den Daten, auf denen die Prozessauslegung basiert, können Berechnungen von Vorgängen wie der Wärmeübertragung beeinträchtigen, was zu höheren Investitionen, Energieverbrauch und Emissionen führt. Bei petrochemischen Anlagen mit hoher Temperatur, hohem Druck und brisanten Stoffen können Abweichungen schließlich Unfallrisiken verursachen.
Als ich das las, erinnerte ich mich an einen Satz aus der Vorstellung der Antikörperforschung von Amazon: „Ein Modell, das an Daten eines Labors feinabgestimmt wurde, erbt stillschweigend die Messabweichungen dieses Labors.“
Das Forschungsteam von Amazon versuchte, die Eigenschaften von Antikörpern mit KI vorherzusagen, um Forschern zu helfen, zu beurteilen, welche Kandidaten für die weitere Entwicklung geeignet sind. Das Problem, auf das sie stießen, ist, dass es Unterschiede