Chaoyan Intelligence veröffentlicht 36 unabhängige KI-Forschungsergebnisse: Code, Experimente und Generierungsspuren sind vollständig öffentlich zugänglich | Xinglian Portfolio Update
Heute veröffentlicht Apex Intelligence offiziell 36 Forschungsergebnisse, die von unserem KI-System erzeugt wurden und die beiden Bereiche KI-Forschung sowie Robotik und Embodied Intelligence abdecken.
01
Was wir aufgebaut haben
Das Team von Apex Intelligence hat ein autonomes System entwickelt, das wissenschaftliche Forschung mit minimalem menschlichem Eingreifen end-to-end unabhängig durchführen kann. In den vergangenen Monaten hat unser autonomes KI-Forschungssystem den gesamten Prozess unabhängig abgeschlossen – von der Literaturrecherche, Methodenentwicklung, Code-Implementierung, experimentellen Analyse, Diagrammerstellung, LaTeX-Papierverfassung bis hin zur Selbstprüfung und iterativen Optimierung.
Die 36 in dieser Veröffentlichung vorgestellten Forschungsergebnisse wurden fast ausschließlich von KI generiert, mit nur geringfügigem menschlichem Eingreifen durch Nicht-Experten. Dies beweist, dass das KI-System von Apex Intelligence wirklich in der Lage ist, wissenschaftliche Fragen unabhängig zu stellen, strenge Experimente zu entwerfen und aufschlussreiche Schlussfolgerungen zu ziehen.
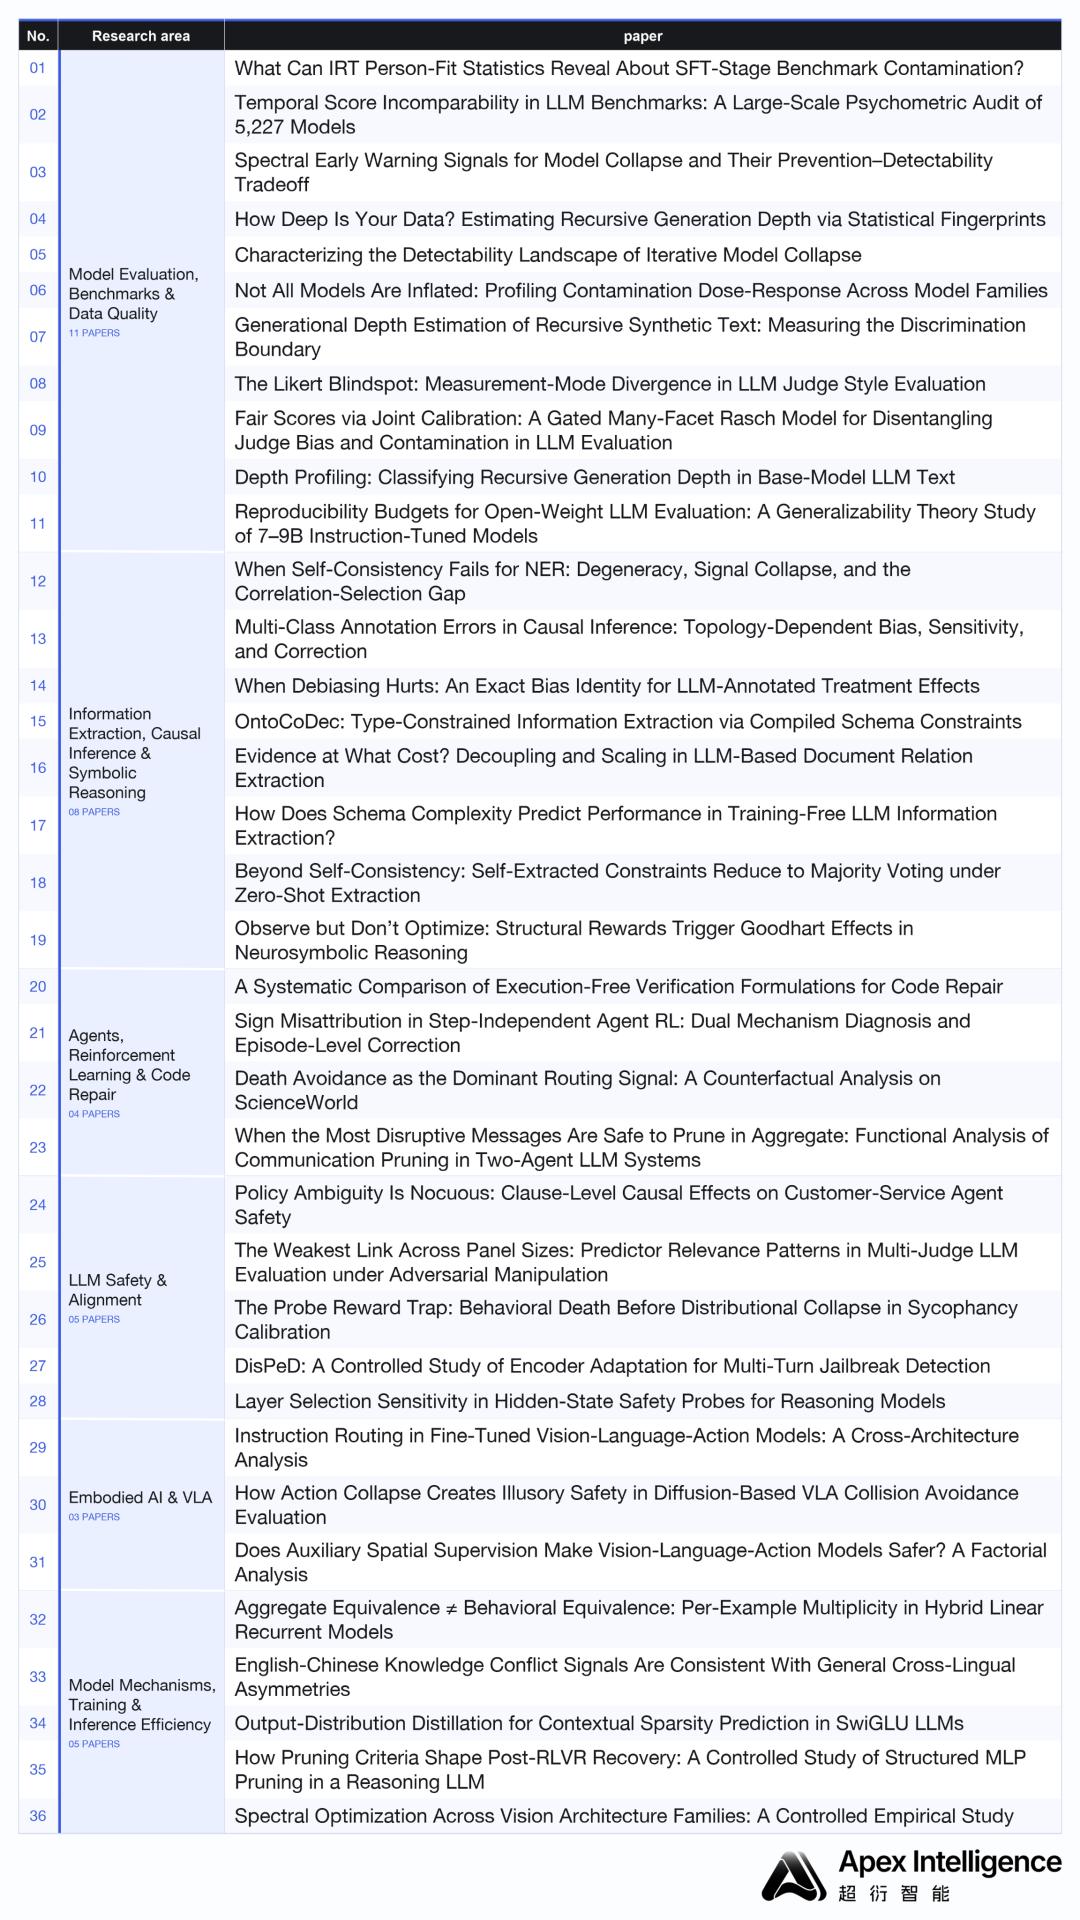
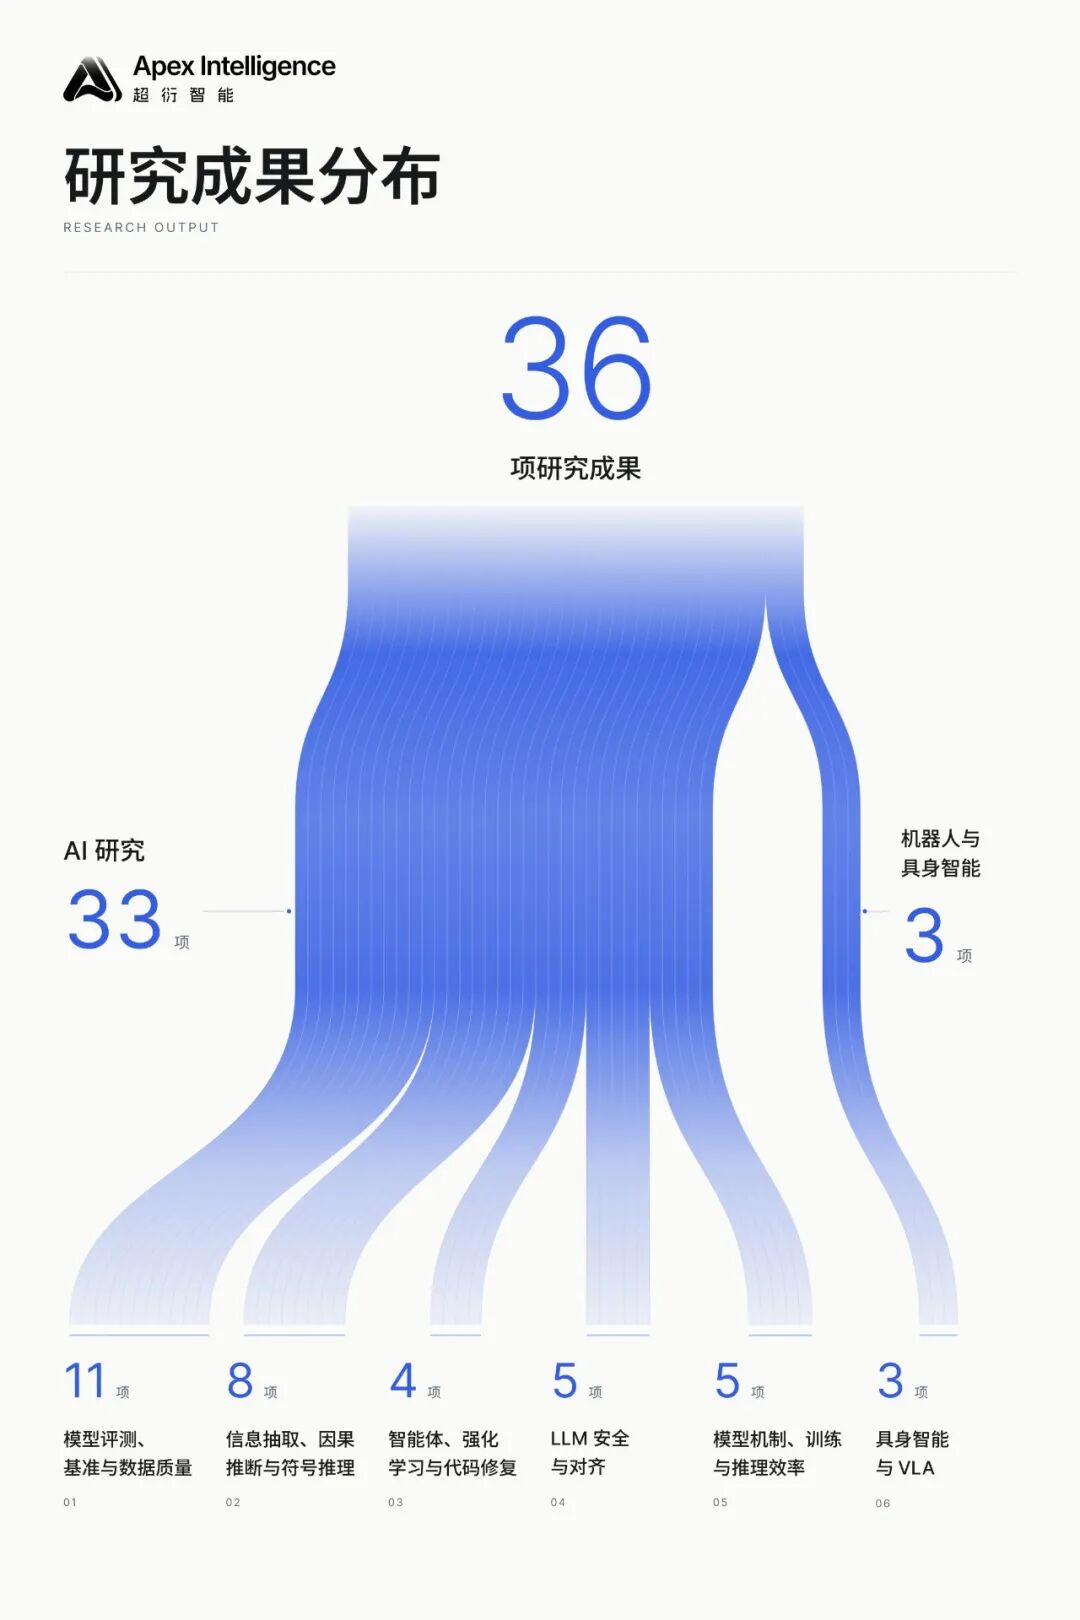
Die vorliegende Forschung deckt zwei Bereiche ab: KI-Forschung und Robotik-Embodied Intelligence. Im Bereich der KI-Forschung konzentrieren wir uns auf die folgenden fünf Fragestellungen:
Modellbewertung, Benchmarks und Datenqualität
Informationsextraktion, kausale Inferenz und symbolisches Schließen
Agenten, verstärktes Lernen und Codereparatur
LLM-Sicherheit und Alignment
Modellmechanismen, Trainings- und Inferenzeffizienz
Der Bereich Robotik-Embodied Intelligence konzentriert sich auf Embodied Control und Vision-Language-Action-Modelle (VLA).
02
Fünf repräsentative Forschungsergebnisse
Wir haben die folgenden fünf repräsentativen Forschungsergebnisse zur Erläuterung ausgewählt.
01|Rückverfolgung KI-generierter Inhalte: Entdeckung differenzierter statistischer Reaktionen im rekursiven Generierungsprozess
Depth Profiling: Classifying Recursive Generation Depth in Base-Model LLM Text
Da KI-generierte Texte zunehmend in das Internet und die Trainingskorpora von Modellen gelangen, stellt sich eine wichtige, aber noch nicht ausreichend untersuchte Frage: Wie entwickelt sich die statistische Verteilung von Texten, nachdem sie mehrere Runden von Sprachmodellgenerierung durchlaufen haben? Können diese Veränderungen genutzt werden, um zu erkennen, wie viele Runden KI-Generierung ein Text durchlaufen hat?
Herkömmliche KI-Texterkennung konzentriert sich hauptsächlich auf die binäre Klassifizierung von Mensch vs. KI, während vorhandene Forschungen zur rekursiven Generierung sich eher mit der Konvergenz von Textverteilungen oder dem Modellkollaps befassen. Das Apex AI System stellt die Aufgabe des Generation Depth Profiling (Generierungstiefenanalyse) vor und erweitert das Forschungsziel von der Beurteilung, ob ein Text von KI generiert wurde, hin zur Erkennung seiner rekursiven Generationsgeneration.
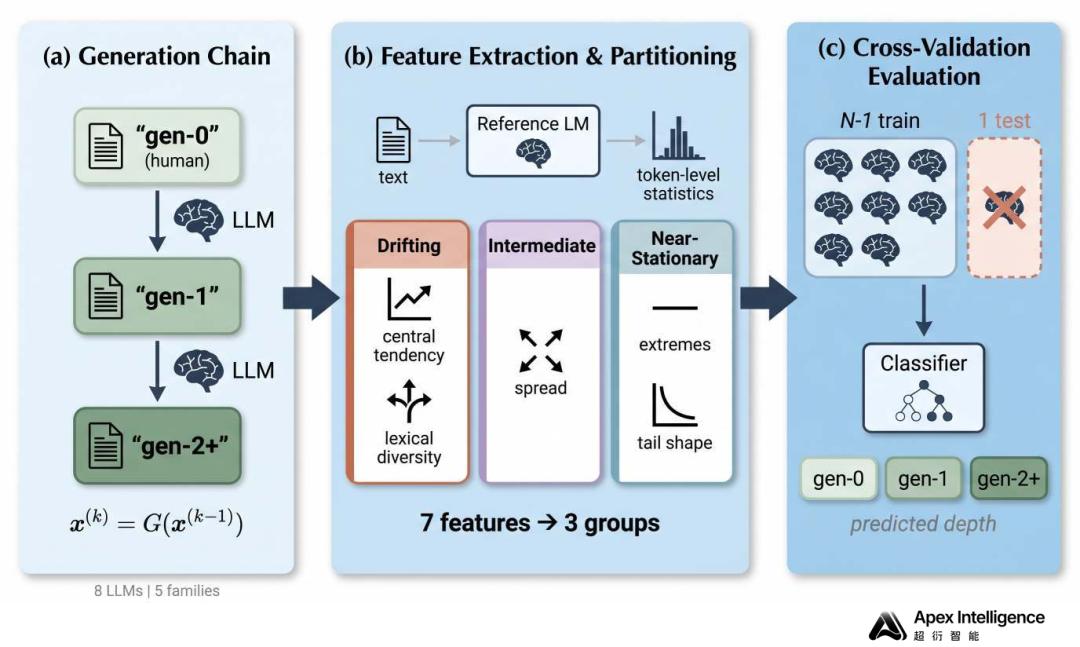
Die Forschung baut auf 8 grundlegenden Sprachmodellen aus 5 Modellfamilien auf, erstellt etwa 37.000 mehrrundig generierte Texte und berechnet die Token-Ebene negative Log-Likelihood (NLL)-Verteilung mit einem festen Referenzmodell. In Kombination mit statistischen Merkmalen wie der Wortvielfalt wird das Änderungsmuster verschiedener Merkmale mit der Generierungstiefe systematisch analysiert.
Die Forschung entdeckt ein konsistentes statistisches Phänomen: Die Positionsmerkmale der NLL-Verteilung driften kontinuierlich mit der Anzahl der Generierungsrunden, während einige Merkmale der Verteilungsform annähernd stabil bleiben. Unter ihnen zeigen Merkmale wie die durchschnittliche NLL und die Wortvielfalt deutliche Veränderungen mit einer Effektgröße von etwa d=0,74–1,05; die Effektgröße einiger verteilungsbezogener Merkmale im Tail-Bereich und Extremwert-Merkmale liegt unter 0,10.
Die Forschung definiert diese Asymmetrie als Differential Depth Response (DDR, differenzielle Tieferantwort).
Auf Basis von DDR erstellt die Arbeit einen leichtgewichtigen Merkmalsklassifikator, der Texte in Gen-0 (Originaltext), Gen-1 (einmalige Generierung) und Gen-2+ (zwei oder mehr Generierungen) einteilt, und prüft seine Fähigkeit zur Modellübertragung mittels Leave-One-Generator-Out-Bewertung. In der Leave-One-Test-Einstellung mit 8 Generierungsmodellen erreicht der binäre Klassifizierungs-F1-Wert 0,694; in spezifischen modellenübergreifenden Generierungskettenexperimenten erreicht er 0,830.
Die Kernneuheit dieser Arbeit liegt darin, die Verteilungsänderungen in der rekursiven Generierung in zwei Arten von Reaktionen – „kontinuierliches Driften“ und „relative Stabilität“ – aufzuteilen und diese strukturelle Differenz zu nutzen, um eine Methode zur Erkennung der Generierungstiefe zu etablieren. Im Gegensatz zu herkömmlichen Erkennungsmethoden, die nur die Herkunft des Textes identifizieren, erforscht diese Studie die Möglichkeit, die Generierungsgeschichte aus der statistischen Verteilung des Textes abzuleiten, und bietet neue Methoden für die Rückverfolgung von synthetischen Daten, die Prüfung von Trainingskorpora und die Erforschung von Gesetzmäßigkeiten der mehrrundigen Generierung.
Derzeit wurde dieses Muster hauptsächlich in grundlegenden vortrainierten Modellen bestätigt, während instruktionsfeinabgestimmte und komplexere reale Generierungsumgebungen noch weiter untersucht werden müssen.
02|Sicherheitsüberwachung von Inferenzmodellen: Entdeckung des Layer-Auswahl-Bias in Hidden-State-Probes
Layer Selection Sensitivity in Hidden-State Safety Probes for Reasoning Models
Inferenzmodelle können im Verlauf des fortlaufenden Inferenzprozesses allmählich von der Einhaltung von Sicherheitsbeschränkungen zur Generierung schädlicher Inhalte übergehen. Diese intern stattfindende Umwandlung des Sicherheitszustands führt dazu, dass Erkennungsmethoden, die nur auf Eingaben oder endgültige Textausgaben angewiesen sind, an Grenzen stoßen. In den letzten Jahren haben Forscher begonnen, Sicherheits-Probes mit internen Hidden States (versteckten Zuständen) des Modells zu trainieren, um die im Inferenzprozess stattfindenden Veränderungen präziser zu erkennen.
Allerdings müssen Hidden-State-Probes bestimmte Transformer-Layer als Überwachungsobjekte auswählen. Die Auswahl der Netzwerklayer wird normalerweise als technisches Implementierungsdetail betrachtet, und ihr Einfluss auf die endgültigen Sicherheitserkennungsergebnisse fehlt noch an systematischer Untersuchung.
Das Apex AI System stellt zu diesem Problem ein Analyseframework über Layer und Metriken hinweg für Hidden-State-Sicherheits-Probes vor.
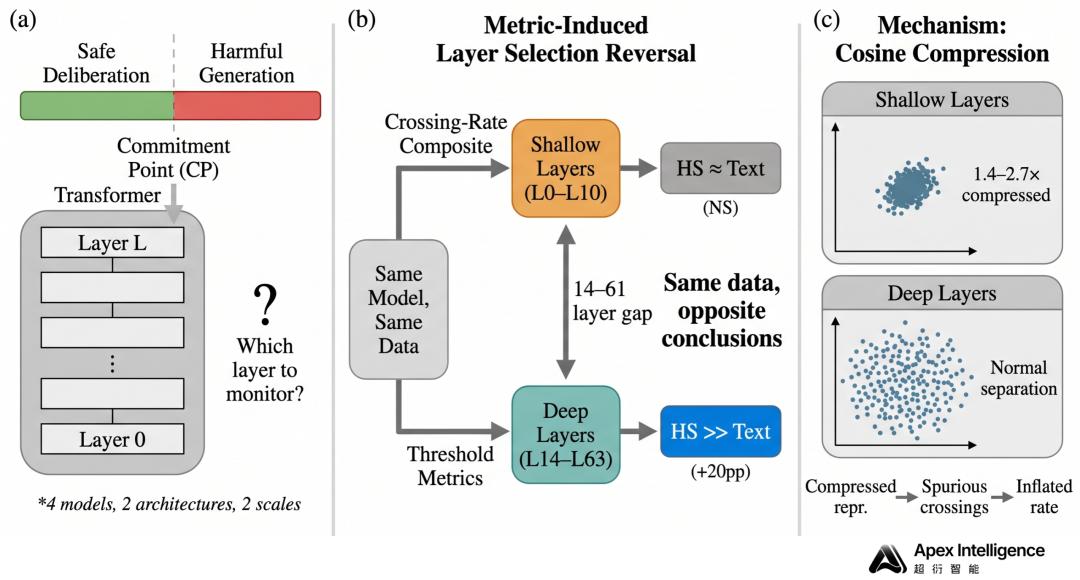
Die Forschung vergleicht die Darstellungen des Sicherheitszustands verschiedener Transformer-Layer auf 4 Inferenzmodellen und bewertet die Leistung der Probes bei der Erkennung von Sicherheitszustandsumwandlungen mit verschiedenen Metriken, einschließlich Schwellenwert-Überschreitungsfrequenz, Präzisionsrate, balancierter Genauigkeit und Falschalarmrate.
Die Experimente zeigen, dass es systematische Abweichungen zwischen verschiedenen Metriken zur Layer-Auswahl gibt: Metriken, die auf der Schwellenwert-Überschreitungsfrequenz basieren, neigen zur Auswahl von flachen Layern (L0–L10), während Metriken, die auf der Schwellenwerterkennungsleistung basieren, eher zur Auswahl von tiefen Layern (L14–L63) neigen. In verschiedenen Modellen unterscheiden sich die von den beiden Methoden ausgewählten Layer um 14–61 Layer.
Diese Differenz beeinflusst nicht nur die Position der Modellüberwachung, sondern verändert auch direkt die Beurteilung der Erkennungsfähigkeit von Hidden States.
In einigen flachen Layern erreichen Hidden-State-Probes eine Leistung, die der von Text-Probes nahekommt; in angemessen ausgewählten tiefen Layern erzielen Hidden-State-Probes in 7B–8B-Modellen eine Präzisionssteigerung von etwa 20–22 Prozentpunkten im Vergleich zu Text-Probes, was durch Kreuzvalidierung bestätigt wird.
Um dieses Phänomen weiter zu erklären, analysiert die Forschung die geometrischen Eigenschaften der versteckten Darstellungen verschiedener Netzwerklayer und entdeckt eine Cosine Compression (Kosinusdistanzkompression) in flachen Layern: Die Unterschiede in den Darstellungsrichtungen zwischen benachbarten Inferenzschritten werden um etwa das 1,4- bis 2,7-fache komprimiert, was einige frequenzbasierte Metriken anfälliger für Rauschen macht und dadurch zu falschen Präferenzen bei der Layer-Auswahl führt.
Dieser Bias wurde in Experimenten mit modellenübergreifenden Modellen und dem AdvBench-Datensatz weiter bestätigt.
Die Kerninnovation dieser Studie liegt in der Entdeckung und Erklärung des metrikinduzierten Layer-Auswahl-Bias (Metric-Induced Layer Selection Bias) in Hidden-State-Sicherheits-Probes. Im Gegensatz zu vorhandenen Arbeiten, die Sicherheitsklassifikatoren nur in festen Netzwerklayern trainieren, beweist die Arbeit, dass die Layer-Auswahlstrategie selbst eine wichtige methodische Variable ist, die das Ergebnis der Sicherheitsüberwachung beeinflusst.
Die Forschung vergleicht auch mehrere alternative Erkennungsmethoden und diskutiert die Möglichkeiten von mehrschichtigen integrierten Probes, was eine experimentelle Grundlage für die zukünftige Etablierung zuverlässigerer und reproduzierbarer Methoden zur internen Sicherheitsüberwachung von Inferenzmodellen bietet.
Es ist zu beachten, dass die Ergebnisse auf dem 32B-Modell noch durch die Größe der Teststichprobe beschränkt sind, und der Vorteil von Hidden States gegenüber Text hängt auch von der spezifischen Konfiguration des Modells und des Text-Encoders ab.
03|Interner Mechanismus von Embodied Intelligence: Unterscheidung der durch Aktionstraining verursachten Darstellungsänderungen von vortrainierten Prioren
Instruction Routing in Fine-Tuned Vision-Language-Action Models: A Cross-Architecture Analysis
Vision-Language-Action-Modelle (VLA) realisieren die Abbildung von Bildern und natürlichsprachlichen Anweisungen auf Roboteraktionen, indem sie auf vortrainierten Vision-Language-Modellen (VLM) mit Roboteraktionsdaten feinabgestimmt werden.
Allerdings gibt es derzeit ein zentrales Problem bezüglich des internen Informationsverarbeitungsmechanismus von VLA: Kommt die Fähigkeit des Modells zur Verarbeitung von Anweisungen, die es nach dem Aktionstraining zeigt, tatsächlich aus dem neu hinzugefügten Aktionstraining oder wird sie vom vortrainierten Vision-Language-Modell geerbt?
Vorhandene Forschungen konzentrieren sich mehr auf die Aufgaben-Erfolgsrate von VLA, die Leistung bei der Befolgung von natürlichsprachlichen Anweisungen und die internen Darstellungen einzelner Modelle, fehlen aber an systematischer Analyse mit Architekturvergleich und Vorher-Nachher-Vergleich des Trainings.
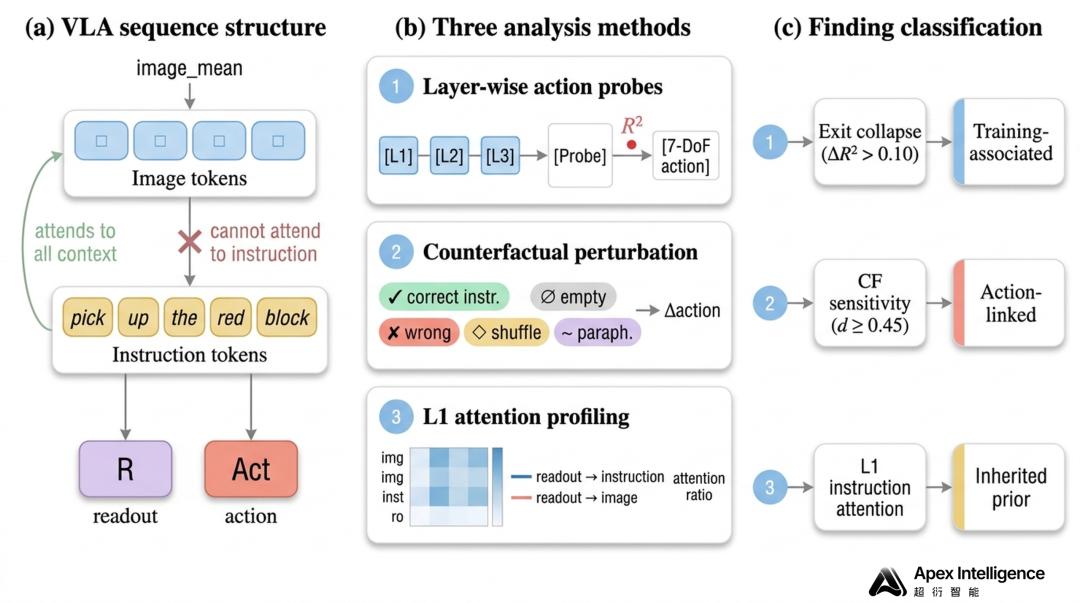
Zu diesem Problem führt das Apex AI System eine Studie zum Architekturübergreifenden VLA-Instruction-Routing durch.
Die Forschung wählt drei verschiedene Backbone-Architekturen – OpenVLA, TraceVLA und NORA – aus und vergleicht trainierten Modelle mit Referenz-Checkpoints in vier Arten von Aufgaben in LIBERO. Unter ihnen werden TraceVLA und NORA verwendet, um den Trainingsübergang von VLM zu VLA zu analysieren, während OpenVLA zur Analyse der weiteren Feinabstimmung auf der Grundlage vorhandener VLA verwendet wird.
Methodisch kombiniert die Forschung drei komplementäre Analysen: Erstens wird Layer-wise Probing (schichtweises Sondieren) verwendet, um die Dekodierbarkeit aktionsbezogener Informationen in verschiedenen Transformer-Layern zu messen; zweitens wird Counterfactual Instruction Perturbation (kontrafaktische Anweisungsstörung) verwendet, um den Einfluss von Änderungen des Anweisungsinhalts auf die internen Darstellungen des Modells zu analysieren; drittens wird Attention Profiling (Aufmerksamkeitsprofilierung) verwendet, um die Muster der Aufmerksamkeit verschiedener Netzwerklayer auf Informationen der natürlichsprachlichen Anweisungen zu untersuchen.
Die Forschung erzielt drei Hauptergebnisse.
Erstens geht das Aktionstraining von VLM zu VLA mit spezifischen Darstellungsänderungen in den Output-Layern einher. Bei den beiden getesteten Umwandlungen von VLM zu VLA sinkt die Dekodierbarkeit von Aktionsinformationen in der Nähe der Output-Layer deutlich im Vergleich zu den mittleren Layern, ΔR² erreicht 0,16–0,46; die entsprechende Änderung bei der Feinabstimmung von VLA zu VLA liegt unter 0,10, während bei der normalen Feinabstimmung von