Tsinghua, NVIDIA und weitere Institutionen haben eine neue Rangliste veröffentlicht, bei der 38 KI-Echtzeit-Videomodelle ihre Schwachstellen offenbaren.
KI-Echtzeit-Interaktionsvideo ist eine der heißesten technologischen Richtungen in diesem Jahr.
In den vergangenen mehr als sechs Monaten haben verwandte Modelle aufeinanderfolgend breite Aufmerksamkeit erlangt. Alibaba hat HappyOyster auf den Markt gebracht, Kunlun Wanwei hat Matrix-Game 4.0 veröffentlicht, Aishi Technology hat PixVerse R2 vorgestellt, Shengshu Technology hat im Juli Vidu S1 herausgebracht und im September unmittelbar darauf Vidu S2 veröffentlicht...
Auch das Kapital drängt massiv in diesen Bereich: Zahlreiche Unternehmen haben neue Finanzierungsrunden abgeschlossen, von Weltmodellen, digitalen Avataren bis hin zur Echtzeitbearbeitung – Akteure aus allen Richtungen strömen in dieses Feld.
Doch hinter dem Hype befindet sich dieser Sektor derzeit in einem Zustand der Unordnung.
Die Unordnung ergibt sich zunächst aus der Definition. Obwohl alle an Echtzeit-Interaktionsvideos arbeiten, nennen einige es „interaktives Weltmodell“, andere „Echtzeit-Interaktions-Multimodal-Modell“, und wieder andere verstehen es als einen dritten Weg, der unabhängig von Videogenerierung und Weltmodell ist. Da es noch keinen Konsens über die Bezeichnung des Sektors gibt, fehlen natürlich auch einheitliche Bewertungsstandards.
Die vorhandenen Bewertungstools verwenden noch alte Rahmenwerke: Sie geben einem Modell einen Prompt, generieren ein Video und prüfen, ob das Bild klar ist, die Bewegungen plausibel sind und der Stil der Beschreibung entspricht. Mainstream-Benchmarks wie VBench und EvalCrafter folgen dieser Logik. Für Echtzeit-Interaktionsvideosysteme misst diese Methode jedoch nicht den schwierigsten Teil.
Die zentrale Herausforderung von Echtzeit-Interaktionsvideos liegt darin, dass die Anweisungen der Nutzer kontinuierlich sind. Das Modell muss auf neue Anweisungen rechtzeitig reagieren, ohne die Generierung zu unterbrechen, und gleichzeitig die Identität der Charaktere, die vorhandene Szene und alle vorherigen gültigen Änderungen beibehalten. All dies wird von den vorhandenen Bewertungstools kaum berücksichtigt.
Kürzlich haben Universitäten und Institutionen im In- und Ausland wie Tsinghua-Universität, NVIDIA, CMU, UC Berkeley, Princeton und NUS gemeinsam einen neuen Bewertungsbenchmark initiiert – StreamEval.
Leaderboard: https://streameval.ai
Paper: https://arxiv.org/pdf/2610.28402
Github Code: https://github.com/StreamEval/StreamEval
Benchmark Data on Huggingface: https://huggingface.co/datasets/StreamEval/StreamEval
Benchmark Data on ModelScope: https://www.modelscope.ai/datasets/StreamEval/StreamEval
Dies ist das weltweit erste öffentliche Bewertungsranking für strombasierte interaktive Videogenerierung der Branche, das fünf Aufgabentypen abdeckt: Gespräche mit digitalen Avataren, Auftritte virtueller Charaktere, Weltgenerierung, Anweisungsbearbeitung und Referenzbearbeitung, mit insgesamt 300 Testfällen und 38 einbezogenen Modellen.
Im Vergleich zu vorhandenen Benchmarks misst StreamEval nicht nur die „Generierungsqualität“, sondern vor allem die „Interaktionsfähigkeit“. Es integriert Anweisungsausführung, Zustandskonsistenz, visuelle Qualität und Ton-Bild-Synchronisation in ein quantifizierbares Bewertungssystem, sodass Modelle verschiedener technologischer Richtungen unter einheitlichen Bedingungen getestet werden können.
Derzeit sind Code, Datensatz und Bewertungsregeln vollständig Open Source. Entwickler können den Bewertungsprozess nach den öffentlichen Verfahren unabhängig wiederholen und überprüfen. Das Ranking wird ständig aktualisiert, jeder Entwickler kann sein eigenes Modell für den Test einbinden.
Was misst StreamEval genau? Wie funktioniert die Bewertung?
Um ein Echtzeit-Interaktionssystem zu bewerten, muss es unter realitätsnahen Bedingungen betrieben werden: Anweisungen treffen stapelweise ein, die Szene entwickelt sich kontinuierlich und das Modell reagiert fortlaufend im Fluss der Zeit.
StreamEval wurde genau nach dieser Logik konzipiert. Es deckt die fünf Aufgabentypen Gespräche mit digitalen Avataren, Auftritte virtueller Charaktere, Weltgenerierung, Anweisungsbearbeitung und Referenzbearbeitung ab, jeder Typ umfasst 60 Testfälle mit Laufzeiten von 15 Sekunden, 30 Sekunden, 60 Sekunden, 120 Sekunden und 300 Sekunden, sodass die Bewertungsdimensionen sehr umfassend sind. Jeder Testfall wird dreimal unabhängig mit demselben Modell ausgeführt, um den Einfluss zufälliger Faktoren auf die Ergebnisse zu reduzieren.
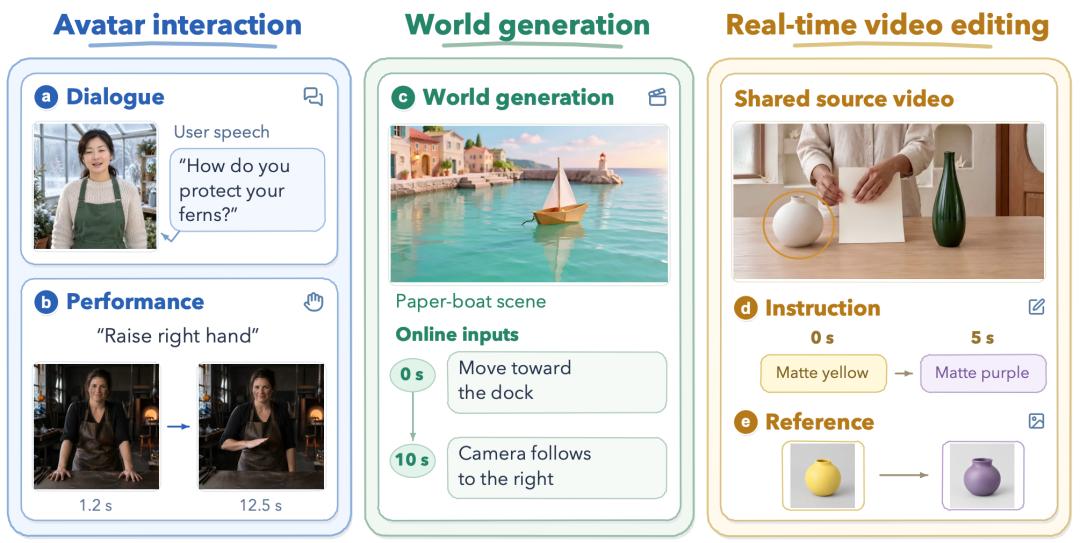
Gesamtrahmen von StreamEval. Dieser Benchmark umfasst fünf Aufgabentypen, die Interaktion mit digitalen Avataren, Weltgenerierung und Echtzeit-Videobearbeitung beinhalten.
Der gesamte Datensatz enthält 1347 Online-Ereignisse. Sprachanweisungen, Textanweisungen, Referenzbilder und Quellvideobilder werden schrittweise entlang der Zeitachse freigegeben. Das Modell kann nur die aktuell freigegebenen Eingaben sehen, erfährt die nachfolgenden Anforderungen nicht im Voraus und hat keinen Zugriff auf die erwarteten Antworten zur Bewertung.
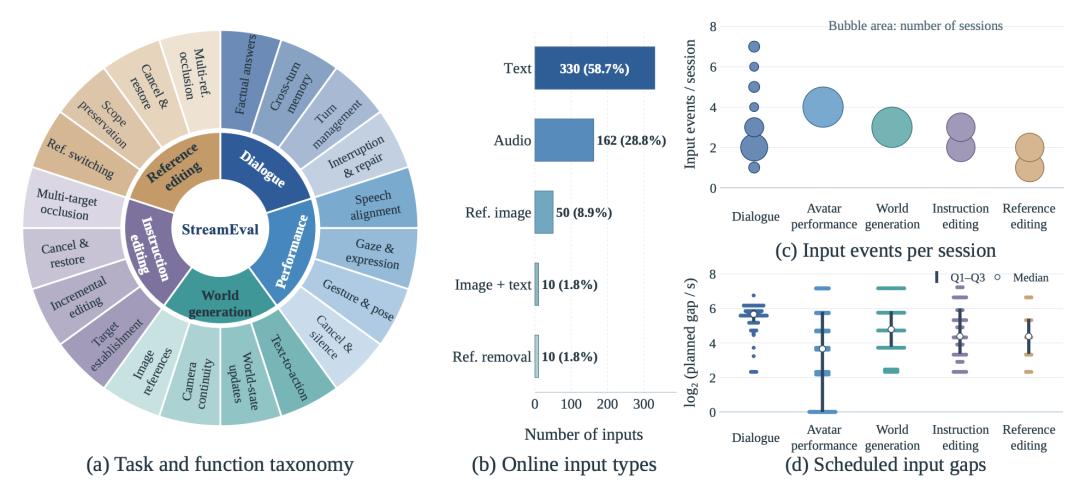
Aufbau des Benchmark-Datensatzes. (a) Verteilung von Aufgaben und Funktionen; (b) voreingestellte Eingabetypen; (c) Anzahl der Eingabeereignisse in jeder Testsitzung; (d) Zeitintervall zwischen benachbarten voreingestellten Eingabeereignissen. Die Abbildung zeigt 200 Testfälle mit insgesamt 562 Online-Eingabeereignissen, ohne Initialisierungseingaben und fortlaufend eingegebene Quellvideobilder. Bei der Statistik der Eingabeintervalle werden Ereignispaare, die Triggerereignisse betreffen, ausgeschlossen.
Jeder der fünf Aufgabentypen hat eigene Schwerpunkte:
Die Aufgabe „Gespräche mit digitalen Avataren“ prüft, ob das Modell die Sprache des Nutzers verstehen und kontextgerechte Antworten geben kann, während es die Identität des Charakters und den Gesprächszustand beibehält;
Die Aufgabe „Auftritte virtueller Charaktere“ verlangt, dass die Rolle nach Echtzeitanweisungen Aktionen wie Blickrichtung, Ausdruck, Haltung und Gestik ausführt;
Die Aufgabe „Weltgenerierung“ konzentriert sich auf Szenenänderungen, Kamerabewegungen und räumliche Kontinuität unter kontinuierlicher Steuerung;
Die Aufgaben „Anweisungsbearbeitung“ und „Referenzbearbeitung“ verlangen, dass das Modell Änderungen nach Text- oder Referenzbildern durchführt, während das Quellvideo kontinuierlich abgespielt wird, und die nicht spezifizierten Inhalte beibehält.
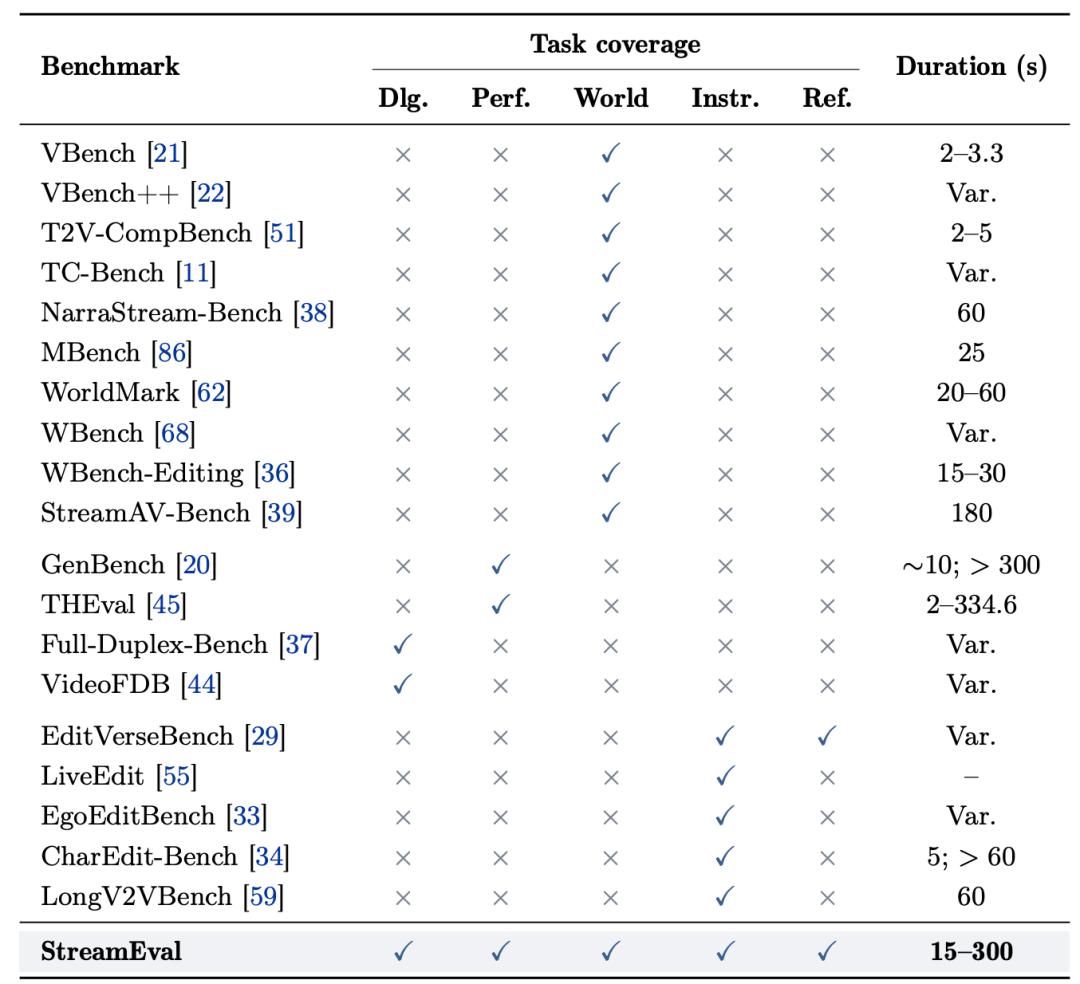
Abdeckungsbereich und Bewertungsdauer der fünf Aufgabentypen. Dlg. steht für Gespräche mit digitalen Avataren, Perf. für Auftritte virtueller Charaktere, World für Weltgenerierung, Instr./Ref. für Echtzeit-Videobearbeitung basierend auf Textanweisungen bzw. Referenzbildern. ✓ bedeutet, dass die Aufgabe enthalten ist, × bedeutet, dass die Aufgabe nicht enthalten ist.
StreamEval unterteilt die Leistung in vier Dimensionen mit insgesamt zehn Indikatoren.
Die Aufgabendurchführung umfasst Gesprächsleistung, Anweisungsbefolgung und vollständige Bearbeitung; die Zustandskonsistenz prüft Bildstabilität, zeitliche Kontinuität und Erhaltung nicht zielgerichteter Inhalte; die visuelle Wiedergabetreue deckt Bildqualität, Charakteridentität und Übereinstimmung mit Referenzbildern ab; die Ton-Bild-Koordination bewertet hauptsächlich die Ton-Bild-Synchronisation.
Jeder Indikator wird mit 0–100 Punkten bewertet. Für jede Aufgabe werden nur die anwendbaren Indikatoren berechnet, um dann gleichgewichtet einen Gesamtscore für die Aufgabe zu ermitteln. Bei der Aufgabe für digitale Avatare erhalten Systeme, die benutzerdefinierte Charaktere unterstützen, zusätzlich 5 Punkte. Die fünf Aufgabentypen werden separat gerankt und nicht zu einem gesamtübergreifenden Ranking zusammengefasst.
38 Modelle haben die Bewertung abgeschlossen: Kontinuierliche Anweisungen sind am schwierigsten zu erfüllen
In der Arbeit wurden insgesamt 38 Modelle bewertet, was 49 Modell-Aufgaben-Konfigurationen ergab. Die Ergebnisse zeigen, dass Bildqualität, Erhaltung der Charakteridentität und Echtzeitsteuerung relativ unabhängige Fähigkeiten sind. Dass ein Modell Videos stabil generieren kann, bedeutet nicht, dass es zuverlässig auf sich ständig ändernde Anweisungen reagieren kann.
Bei der Aufgabe „Gespräche mit digitalen Avataren“ erzielte Vidu S2-Avatar einen grundlegenden Gesamtscore (Q-Overall) von 88,98. Mit zusätzlichen 5 Punkten für die Fähigkeit zur Unterstützung benutzerdefinierter Charaktere erreichte der Gesamtscore (Overall) 93,98 und erzielte damit das höchste Ergebnis unter den teilnehmenden Modellen, die benutzerdefinierte Charaktere unterstützen.
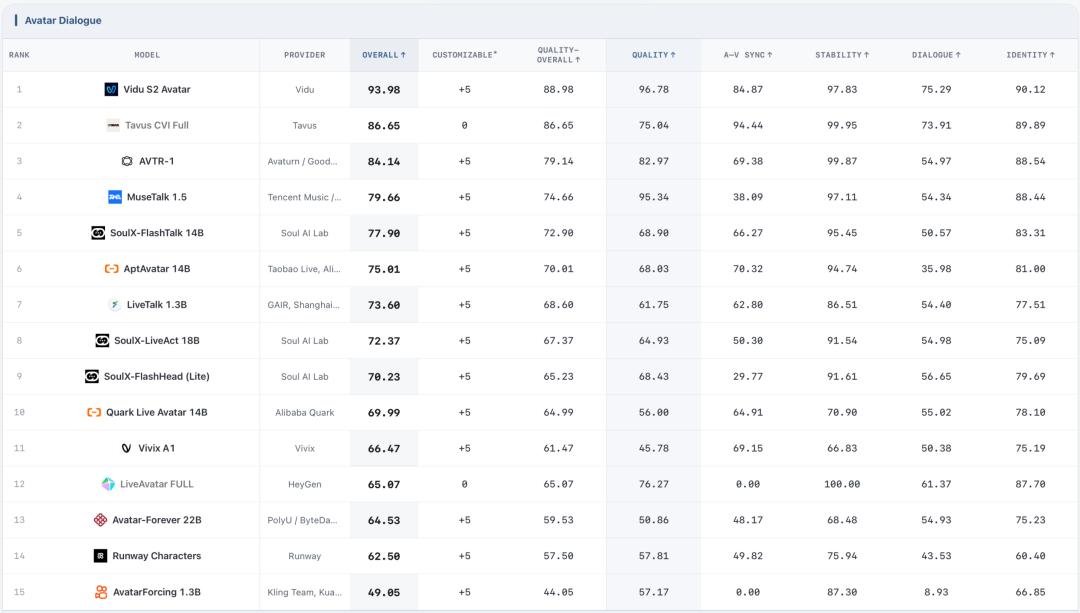
Bewertungsergebnisse der Aufgabe „Gespräche mit digitalen Avataren“.
Bei der Aufgabe „Auftritte virtueller Charaktere“ erzielte Vidu S2-Avatar ebenfalls den höchsten Gesamtscore von 81,71. Seine Ton-Bild-Synchronisation, Stabilität und Identitätskonsistenz erreichten 99,60, 97,25 bzw. 86,12. Allerdings liegt sein Wert für die Anweisungsbefolgung (Following) nur bei 36,90 – dieser Wert ist bereits der Höchstwert unter den sieben teilnehmenden Modellen.
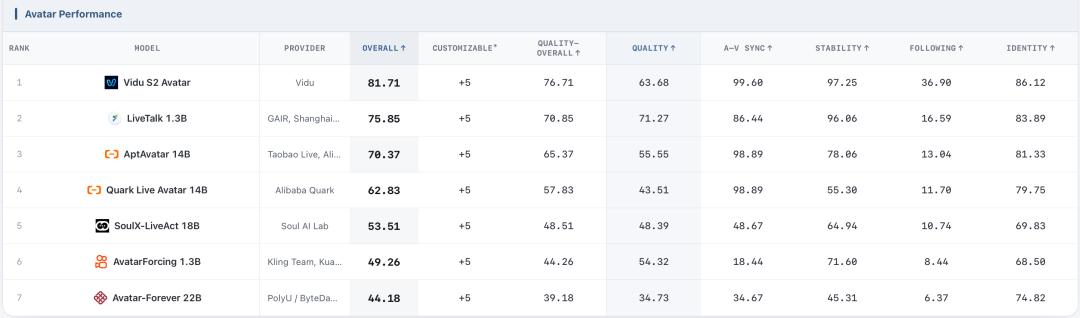
Das bedeutet: Die Charaktere können stabil bleiben, die Lippenbewegungen stimmen mit dem Ton überein, aber spezifische Aktionen werden möglicherweise nicht wie gewünscht ausgeführt. Kontinuierliche Interaktion stellt komplexere Anforderungen an das Modell: Es muss nicht nur die Anweisung verstehen, sondern auch das richtige Objekt zur richtigen Zeit verändern.
Auch bei der Weltgenerierung zeigt sich eine deutliche Aufteilung der Fähigkeiten.
MemFlow erzielte den höchsten Gesamtscore von 33,36, Krea Realtime erreichte den höchsten Wert für Anweisungsbefolgung von 25,93, Matrix-Game 3.5 erzielte den höchsten Wert für Kontinuität (Continuity) von 34,50. Bildqualität und Stabilität von HappyOyster 1.0 Adventure erreichten 58,34 bzw. 56,67, beide sind die Höchstwerte für diese Aufgabe, aber der Wert für Anweisungsbefolgung liegt nur bei 5,56, der Wert für Kontinuität nur bei 2,78.
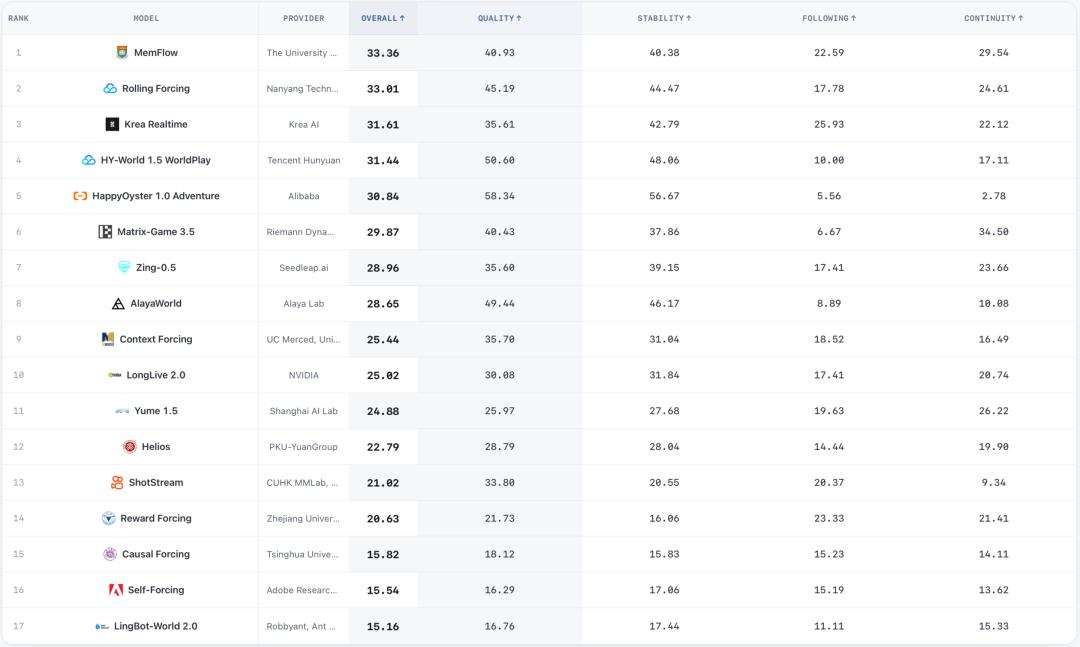
Weltgenerierung. Modellkonfigurationen unter Text- und Bildbedingungen werden gemeinsam gerankt; wenn dasselbe Modell unter beiden Eingabebedingungen bewertet wird, wird nur das Bewertungsergebnis unter Textbedingungen berichtet.
Diese Ergebnisse zeigen, dass Bildqualität, Anweisungsreaktion und Langzeitkontinuität separat beurteilt werden müssen. Dass ein Modell stabiler erscheint, bedeutet nicht, dass es besser auf Anweisungen reagiert.
Bei der Echtzeitbearbeitung erzielte Vidu S2-Editing bei der Anweisungsbearbeitung einen Gesamtscore von 45,43, die Werte für Anweisungsbefolgung und Bearbeitungserfolgsrate (Edit Success) liegen bei 72,10 bzw. 57,20; JoyAI-Video-Edit erreichte einen Gesamtscore von 42,39, aber sein Wert für Inhaltserhaltung (Preservation) liegt bei 83,33 und übertrifft damit den Wert von 60,93 von Vidu S2-Editing. Ersterer erzielt höhere Werte bei anweisungsbezogenen Indikatoren, letzterer ist besser darin, nicht zielgerichtete Inhalte im Quellvideo zu behalten.
