KI-Lehrbücher sind komplett falsch, ein gewaltiger Bug in den zugrundeliegenden Formeln wurde offengelegt, Gemini hat sich als Erster selbst repariert
Alle gängigen KI-Frameworks sind falsch!
PyTorch ist falsch, JAX ist falsch. Sogar die Standardformeln in Lehrbüchern sind falsch.
Jon Barron, leitender Forschungswissenschaftler bei Google DeepMind, hat diese Bombe platzen lassen!
Diese Woche hat Google DeepMind ein Problem aufgezeigt: In PyTorch, JAX und verschiedenen Lehrbüchern hat jede Standardversion dieses Algorithmus ständig stillschweigend eine bestimmte Zahl auf Null gerundet.
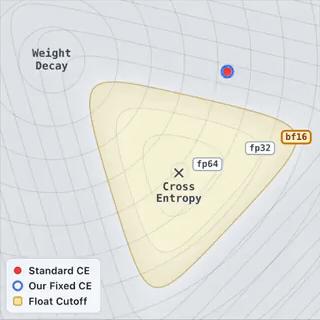
Je selbstsicherer das Modell ist, desto leichter verschwindet das korrekte Trainingssignal aus dem Nichts. Der Optimierer gerät dadurch außer Kontrolle, und die Trainingskurve schwankt heftig.
Aber das Gruseligste und zugleich Aufregendste ist: Dieser grundlegende Logikfehler, der vor den Augen der ganzen Menschheit verborgen war, wurde von der KI (Gemini) selbst entdeckt.
Dieses Mal war der Mensch nur für die nachträgliche Überprüfung und die Formatierung verantwortlich.
Verschwundene Zahlen, kollabierende Modellstandards
Dieser Bug verbirgt sich in der grundlegendsten Operation der KI: Softmax und Kreuzentropie.
Wenn Sie sich mit maschinellem Lernen befasst haben, werden Sie diese beiden Begriffe sicherlich kennen.
Softmax wandelt die rohen Ausgabewerte des Modells (Logits) in Wahrscheinlichkeiten um. Die Kreuzentropie berechnet den Fehler und teilt dem Modell mit, wie falsch es liegt.
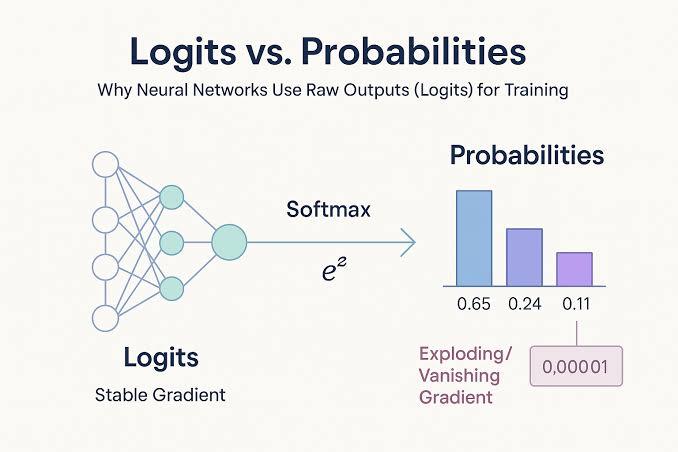
Alle Klassifikatoren, alle großen Sprachmodelle rufen diese beiden Funktionen täglich hunderte Millionen Mal auf.
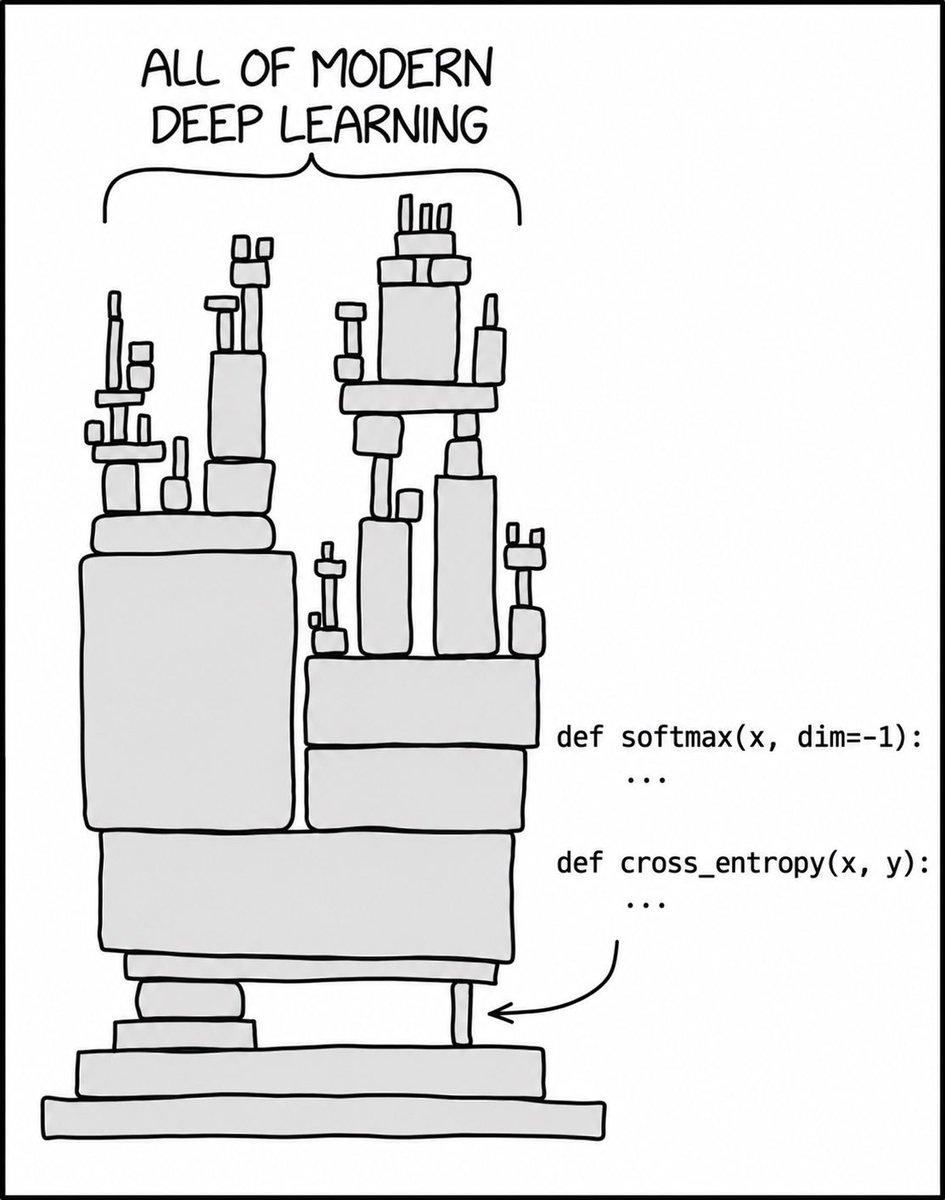
Wie konnten sie falsch werden?
Das Problem liegt in den „Grenzwerten“ und der „Rundung“.
Um einen Berechnungsüberlauf zu vermeiden, führen alle gängigen Standard-Frameworks (sowohl PyTorch als auch JAX) eine Standardmaßnahme durch:
Zuerst wird der maximale Wert von allen Werten subtrahiert.
Durch diese Subtraktion erhält der Nenner eine Struktur, die „1 + eine extrem kleine Zahl“ ähnelt.
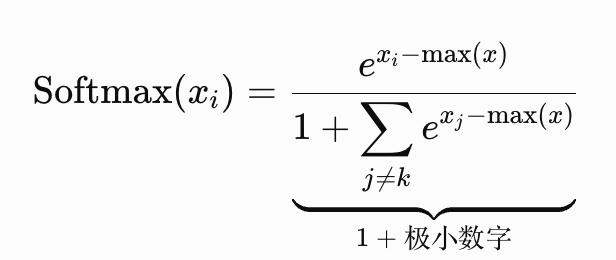
Diese „extrem kleine Zahl“ hängt vom Grad der Selbstsicherheit des Modells ab.
Je selbstsicherer das Modell ist und je höher der Wert der richtigen Antwort im Vergleich zu den anderen Antworten liegt, desto kleiner ist diese Zahl.
Aber hier verbirgt sich ein entscheidendes Detail: Mathematische Äquivalenz bedeutet nicht, dass die Ergebnisse in der Gleitkommarechnung von Computern vollständig gleichwertig sind.
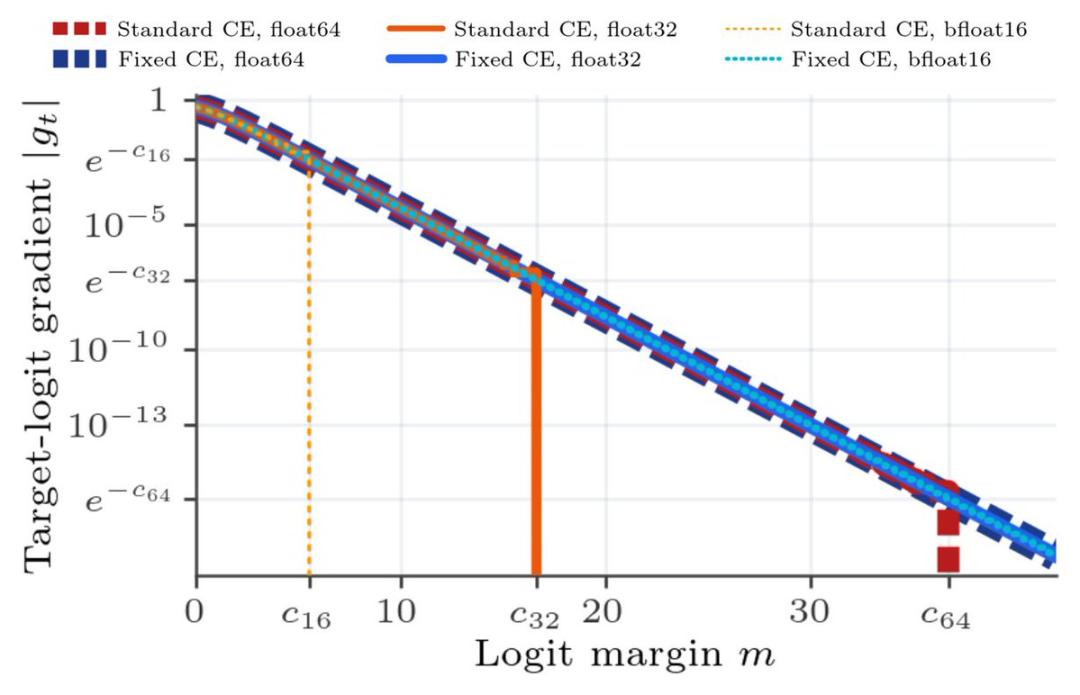
In der Welt der Gleitkommazahlen von Computern: Wenn Sie eine ausreichend kleine Zahl zu 1,0 addieren, hält der Computer sie für „zu klein, um sie zu berücksichtigen“ und rundet das Ergebnis direkt auf exakt 1,0.
Im Bfloat16-Format tritt dieser Abbruch bei einem Wert von etwa 5,5 auf. Bei FP32 liegt er bei etwa 16,6.
Was passiert, sobald man diesen Abbruch überschreitet?
Der korrekte Gradient wird augenblicklich absolut Null.
Obwohl das Modell noch lernt, wird das Feedback-Signal zur richtigen Antwort direkt durch den Rundungsmechanismus des Computers ausgelöscht.
Das DeepMind-Papier nennt dies Softmax-Kollaps (Softmax Collapse).
Und der Optimierer macht die Sache noch schlimmer.
Das Prinzip des gängigen Optimierers Adam besteht darin, jede Aktualisierung durch den Durchschnitt der jüngsten Gradienten zu teilen. Wenn der Gradient aufgrund des Bugs lange Zeit Null ist, nähert sich dieser Durchschnitt unbegrenzt der Null.
Wenn der echte Gradient endlich wieder auftaucht, teilt Adam diesen Gradienten durch eine extrem kleine Zahl.
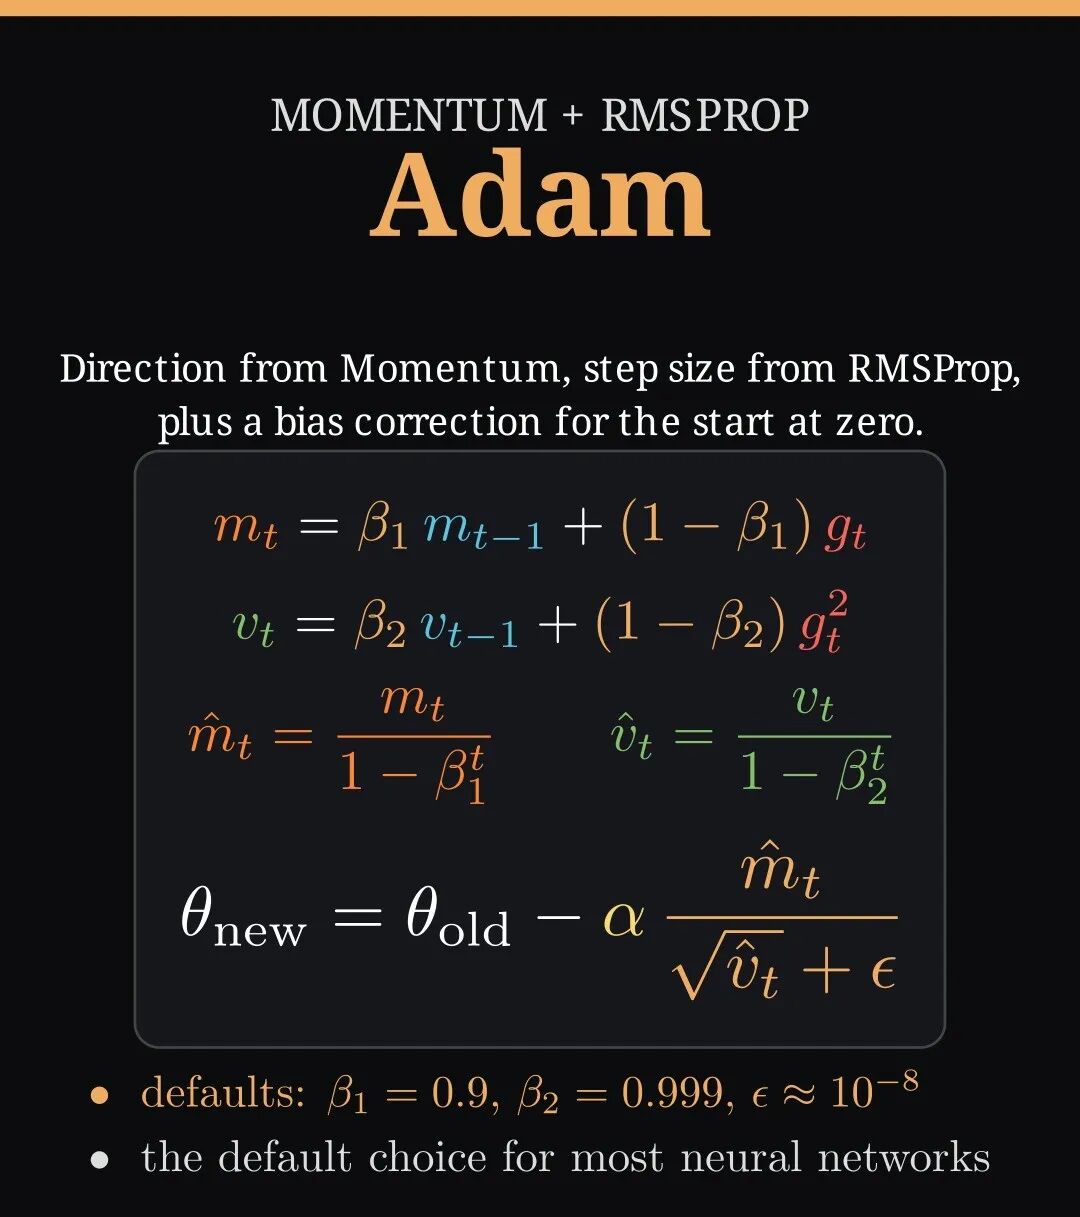
Das Ergebnis ist, dass das Modell einen großen Schritt nach vorne macht und die Verlustfunktion (Loss) augenblicklich stark ansteigt.
Die akademische Welt hat dieses Phänomen früher beobachtet und ihm einen schönen Namen gegeben: „Schleudereffekt (Slingshots)“, und dachte, es sei ein fortgeschrittenes Merkmal im Prozess des „Grokking“ des Modells.
Letztendlich stellt sich heraus: Das ist kein Merkmal, sondern ein Bug.
Neben dem Kollaps gibt es noch Softmax-Kompensation (Softmax Cancellation).
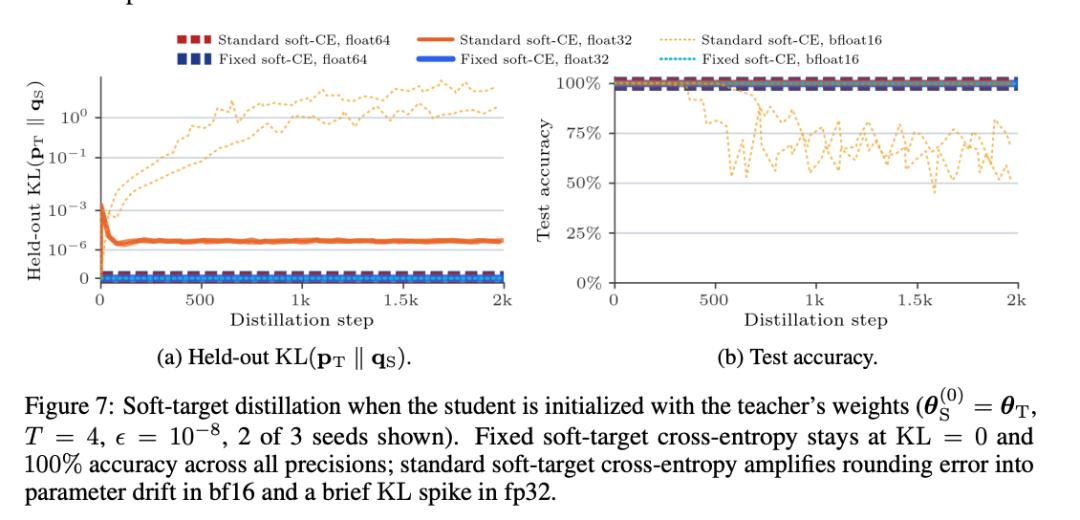
Bei der Wissensdestillation, wenn das Schüler-Modell das Lehrer-Modell vollständig kopiert, sollte der Gradient theoretisch Null sein.
Aber da der Standardcode zuerst die Wahrscheinlichkeiten berechnet und sie dann subtrahiert, hinterlässt der Rundungsfehler einen „Geistergradienten“. Das Schüler-Modell weicht auf unerklärliche Weise von der richtigen Antwort ab.
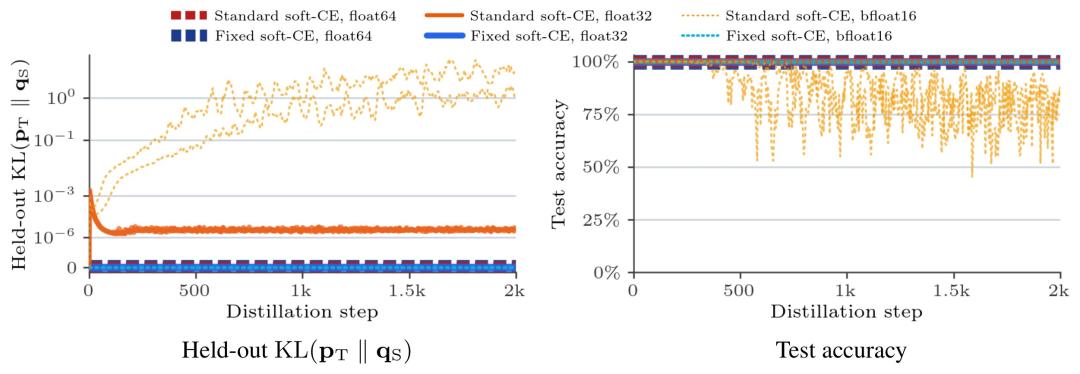
All dies geschieht nur, weil eine extrem kleine Zahl verloren gegangen ist.
Das Team von Jonathan T. Barron von DeepMind hat ein Papier auf arXiv eingereicht: „Reparatur von Softmax und Kreuzentropie“.
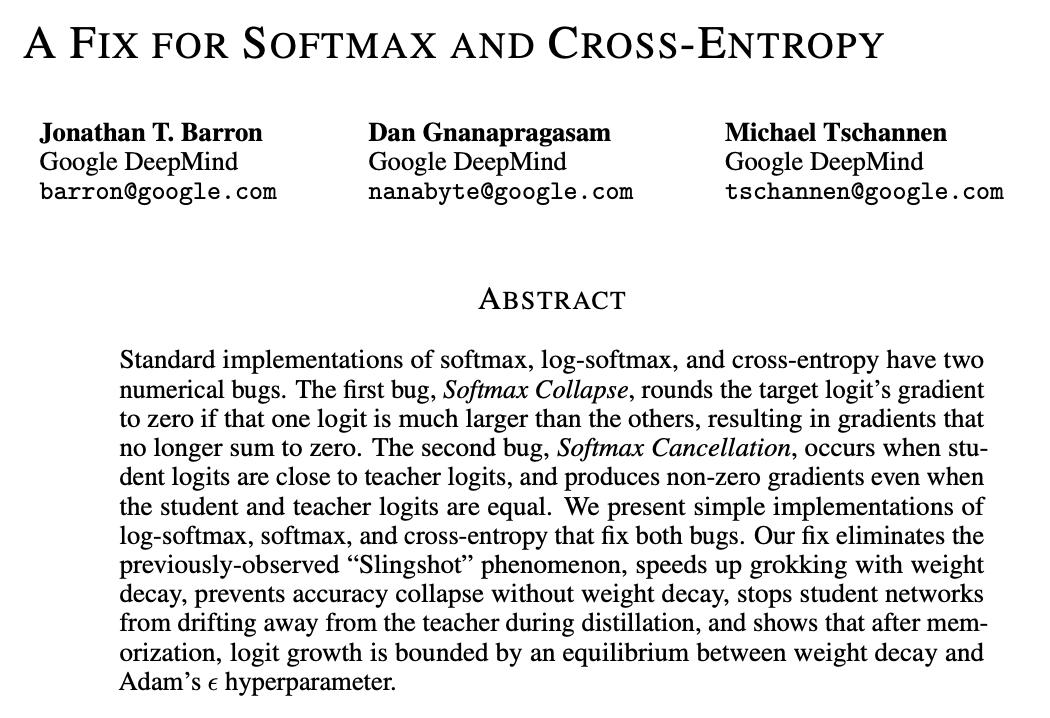
Am nächsten Tag veröffentlichte Barron auf der Plattform X eine bahnbrechende Nachricht:
Es stellt sich heraus, dass alle vorhandenen Implementierungen von Softmax und Kreuzentropie (einschließlich JAX, PyTorch, Lehrbüchern usw.) einen subtilen Bug haben – eigentlich zwei.
Eine einfache Neufassung kann sie reparieren und den „Schleudereffekt“ während des Grokkings beseitigen.
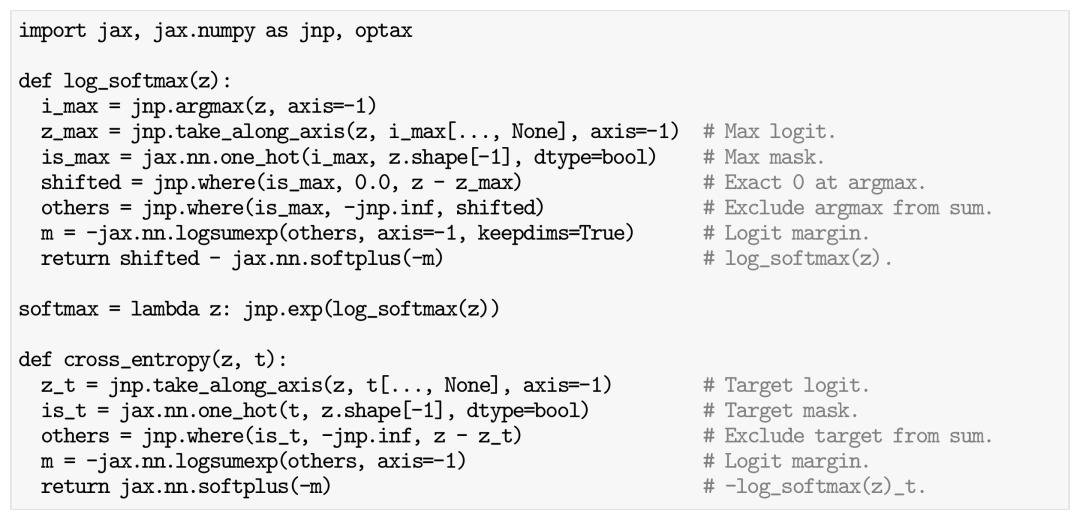
Für die Kreuzentropie (Reparatur des Kollapses): Nehmen Sie das Ziel aus der Summe heraus, berechnen Sie den Abstand direkt mit log-sum-exp und geben Sie dann das Softplus des negativen Abstands zurück. Das Kernprinzip: Fügen Sie niemals eine extrem kleine Zahl zu 1 hinzu.
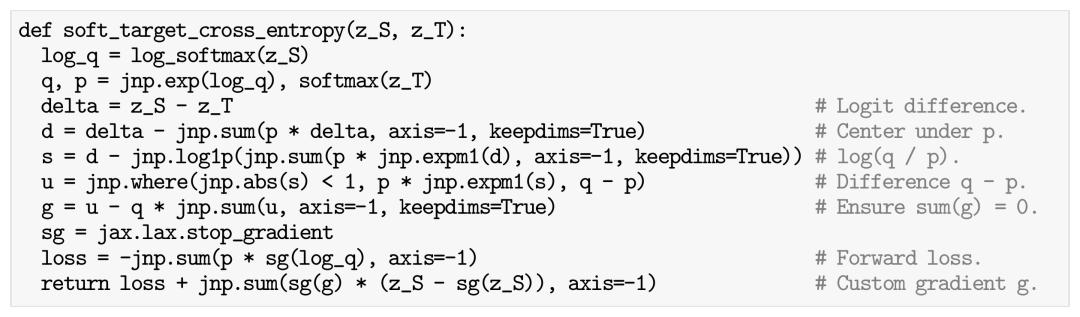
Für die Destillation (Reparatur der Kompensation): Verwenden Sie expm1 und log1p für die Berechnung im logarithmischen Raum. Auf diese Weise ist der Gradient perfekt absolut Null, wenn das Schüler-Modell perfekt zum Lehrer-Modell passt, ohne dass Geister zurückbleiben.
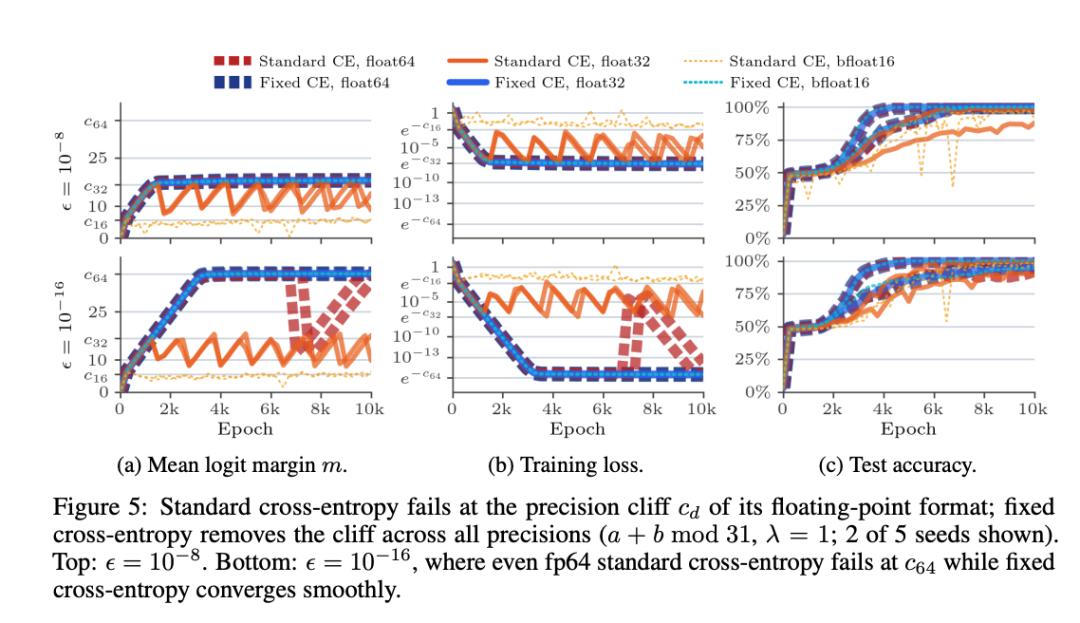
Das Papier liefert intuitive Datentests:
Bei der Aufgabe der Modulo-Addition (a + b mod 31) beträgt die Testgenauigkeit mit dem Standardcode unter Bfloat16-Präzision nur 93,3 % (und ist extrem instabil).
Nach dem Austausch durch den reparierten Code steigt die Genauigkeit direkt auf 100,0 % an und ist absolut stabil.
Und im Destillationstest hält der reparierte Code die Divergenz zwischen Schüler- und Lehrer-Modell bei Null, sodass die Genauigkeit perfekt bei 100 % bleibt.
Aber was den gesamten Technologiebereich wirklich in Aufregung versetzt hat, ist ein Satz, den Barron im Kommentarbereich ergänzt hat:
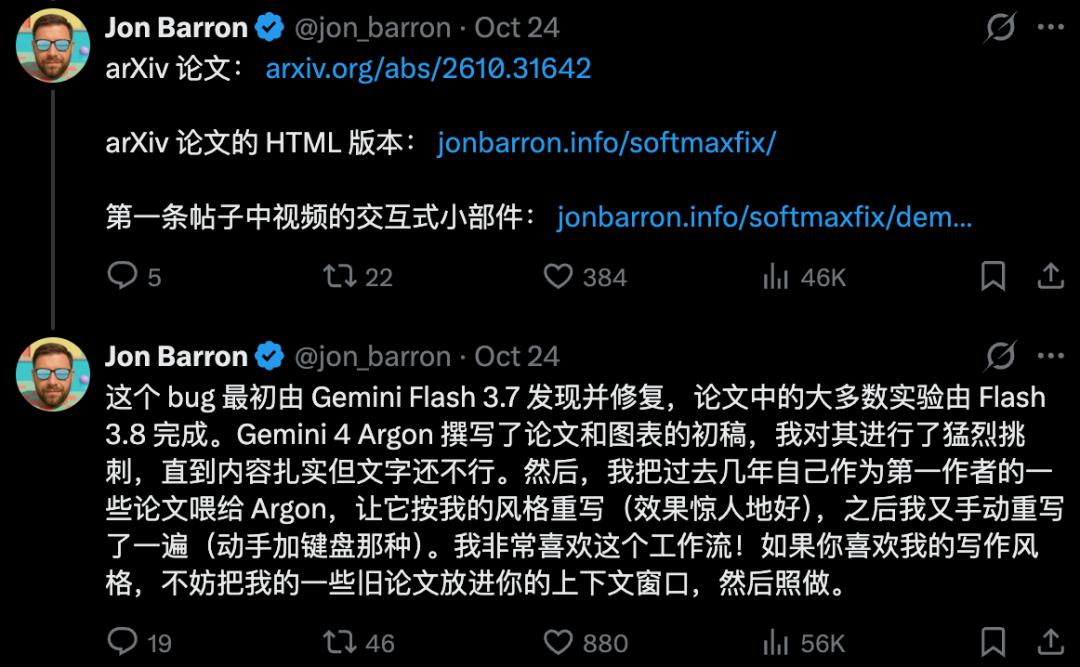
Dieser Bug wurde ursprünglich von Gemini Flash 3.7 entdeckt und behoben. Die meisten Experimente im Papier wurden von Flash 3.8 durchgeführt. Gemini 4 Argon schrieb den Entwurf des Papiers und der Diagramme.
Ich habe nur extrem streng nach Fehlern gesucht, bis der Inhalt solide war.
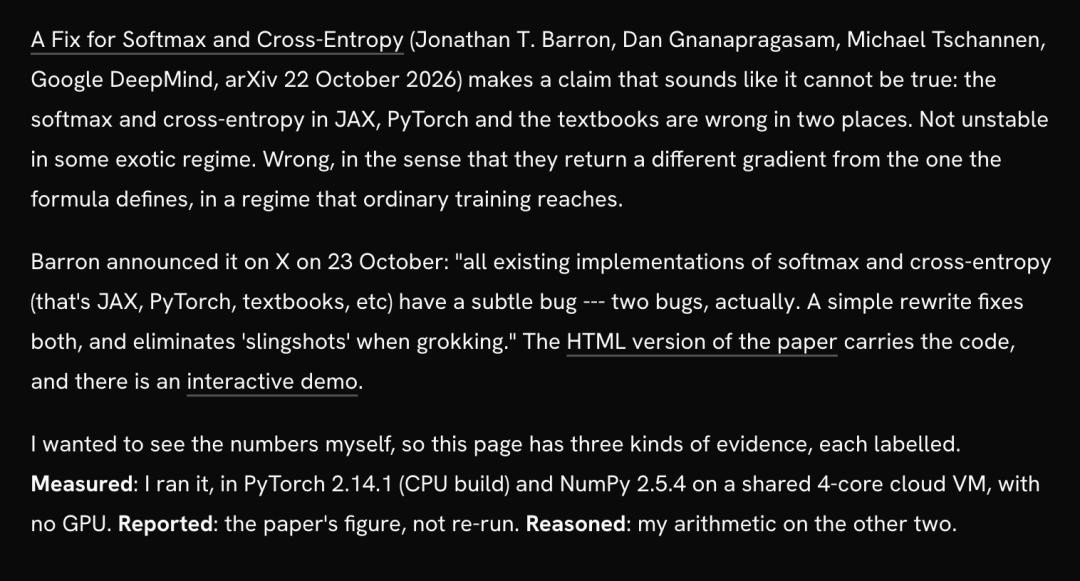
Am 24. Oktober führte der unabhängige Ingenieur Satyajit Ghana eine vollständige Reproduktion in PyTorch durch.
Er reproduzierte die beiden Bugs mit den ausgegebenen Werten auf der CPU, portierte die Reparatur und bestätigte die Ergebnisse des Papiers unter FP32-Präzision.
Seine Schlussfolgerung ist unerschütterlich: „Unabhängig von anderen Details wurde der Mechanismus uneingeschränkt bestätigt.“
Historische Tragödien: Maschinen verlieren ständig Zahlen
Dass Zahlen stillschweigend verloren gehen, ist nicht das erste Mal. Jedes Mal sind die Kosten extrem hoch.
