DeepSeek Open Source überzeugt auf ganzer Linie, vLLM/SGLang haben über Nacht die Leistung der Konkurrenz überholt, und die Inferenzgeschwindigkeit erreicht ein neues Spitzenniveau.
Es muss einfach der großartige Lehrer D von „Yuanshen“ sein – das ist so großzügig!
Kaum eine Woche ist vergangen, seitdem die hauseigene Inferenz-Engine DeepInfer veröffentlicht wurde, da hat die Open-Source-Community bereits fleißig ihre Ergebnisse vorgelegt.
Es ist wahrhaftig der Fall, dass ein „Wal, der sinkt, alles zum Leben erweckt“: Die ersten Effekte der Open-Source-Veröffentlichung sind nun frisch eingetroffen:
Das Ziel ist, DeepSeek zu lernen, zu werden und zu übertreffen. (nicht wirklich)
Reife Inferenz-Frameworks wie vLLM und SGLang haben als Erste das T0-Upgrade-Paket erhalten –
Unter den jeweils offengelegten Testkonfigurationen liegt ihre Leistung bereits nahe an DeepInfer, teilweise übertrifft sie es sogar.
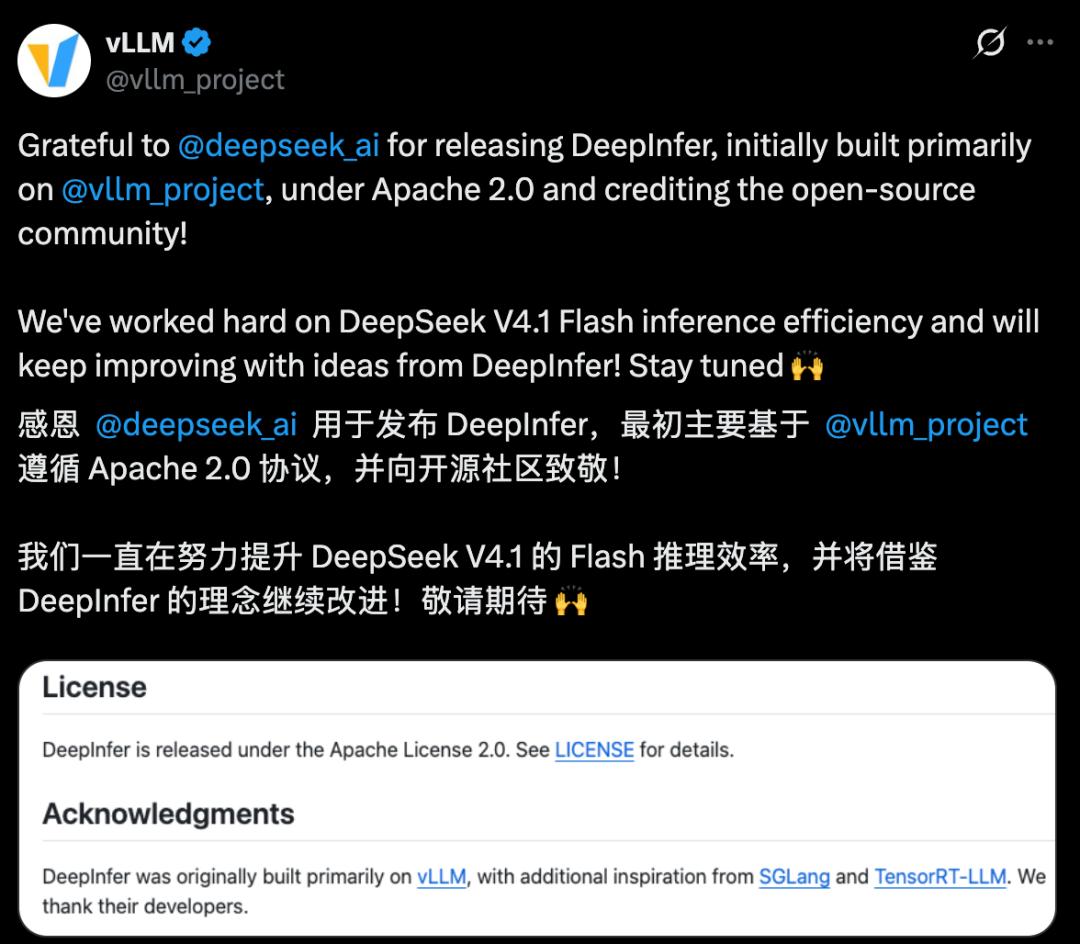
Ausgezeichnet! DeepInfer wurde ursprünglich auf Basis von vLLM aufgebaut, und bei der Gestaltung wurden auch Ideen von SGLang übernommen.
Jetzt hat DeepSeek die verfeinerte Implementierung öffentlich gemacht, und die beiden Projekte übernehmen die Erkenntnisse und optimieren weiter.
Diese Jungs haben das Open-Source-Prinzip wirklich zu voller Blüte gebracht.
Außerdem sind nach und nach einzelne Entwicklerprojekte online gegangen, die von DeepInfer inspiriert wurden – von Hardware-Anpassung über Inferenzbeschleunigung bis hin zu Bereitstellungsoptimierung sind die Ansätze sehr unterschiedlich.
Aber der Effekt ist erstaunlich einheitlich: Sie sind alle leistungsfähiger geworden!
Jetzt, wo DeepInfer Open Source ist, ist die ganze Community in Aufregung geraten.
Das Wettlaufen um die schnellste Inferenz hat die heiße Phase erreicht, es ist Showtime~
Die Open-Source-Community nutzt DeepInfer auf vielfältige Weise
Schauen wir uns zuerst vLLM an.
Die jetzt vorgelegten Ergebnisse reichen von dem Punkt, an dem DeepInfer eingeholt wurde, bis hin zur Bereitstellung auf ganzen Racks.
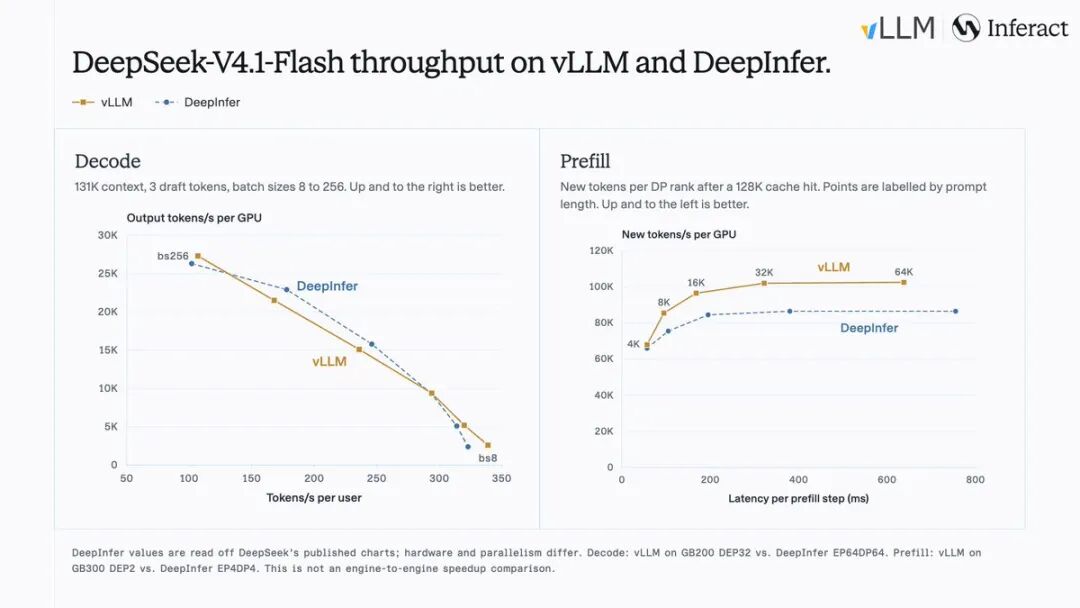
Durch die Integration des Open-Source-Kernels von DeepSeek und umfangreiche Optimierungen der Vorauffüll- und Dekodierungsphasen kann die Leistungskurve von vLLM jetzt mit der von DeepInfer mithalten.
Bei gleicher Dekodierungskonfiguration (131K Kontext, 3 Entwurfs-Token pro Runde) beträgt der Unterschied im Durchsatz, der mit GB200 gemessen wurde, im Bereich der Batch-Größe von 8 bis 256 nur 6 % im Vergleich zu DeepInfer.
Auf der Seite der Vorauffüllung wurde der Durchsatz neuer Token um 35,6 % bis 43,9 % gesteigert.
Erweitern wir die Bereitstellungsgröße auf das NVIDIA GB300 NVL72-Rack.
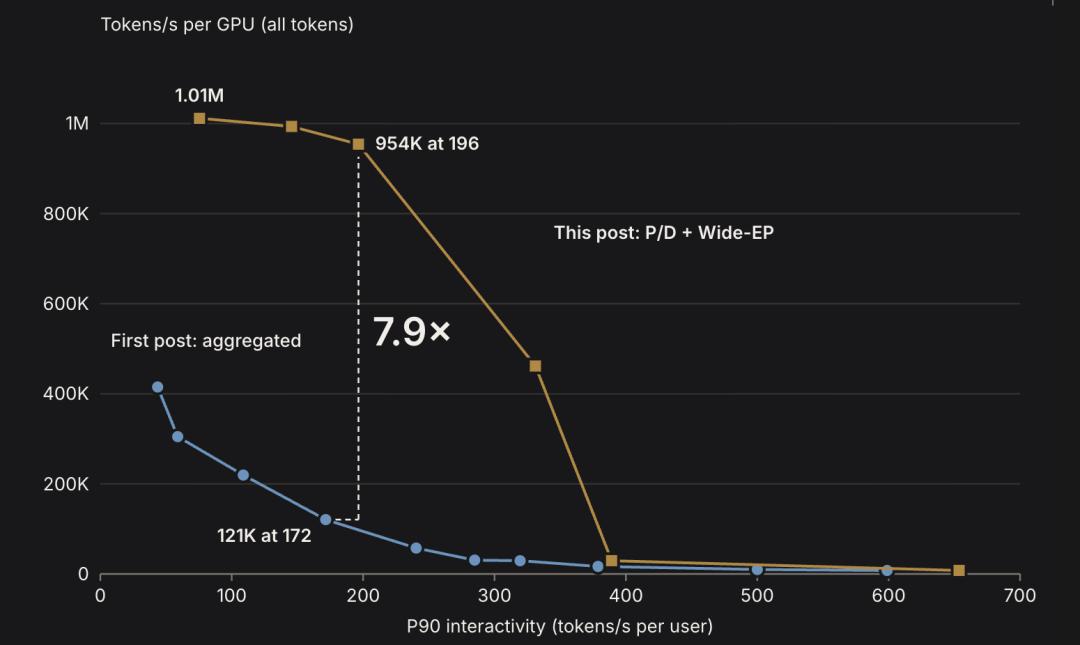
In Kombination mit der Trennung von Vorauffüllung und Dekodierung sowie der Erweiterung der Expertenparallelität erreicht vLLM im SemiAnalysis AgentX-Test einen Durchsatz von bis zu 954.000 Token/s pro Karte, was das 7,9-fache des vorherigen Ergebnisses auf einem einzelnen Knoten ist.
Dasselbe DeepSeek wurde tatsächlich noch weiter auf Geschwindigkeit getrimmt...
Woher kommen diese Verbesserungen? Das Team hat fast jedes einzelne Detail berücksichtigt.
Beispielsweise muss bei der Verarbeitung von Eingaben bei der spärlichen Aufmerksamkeit aus einer Gruppe von Kandidaten die Inhalte herausgefiltert werden, die Aufmerksamkeit verdienen – dies betrifft die Top-K-Auswahl.
Bei dem vorherigen Pfad wurden die BF16-Werte, die von DeepGEMM ausgegeben wurden, zuerst in FP32 umgewandelt, bevor die Filterung erfolgte.
Die neue Implementierung lässt DeepSelect direkt mit BF16-Daten arbeiten und spart diese zwischengeschaltete Umwandlung ein.
Das Einsparen eines Rechenschritts scheint nur eine kleine Änderung zu sein, aber im entsprechenden Operator-Test erreicht die Top-K-Verarbeitungsgeschwindigkeit etwa das 3,7-fache des ursprünglichen Werts.
Das vLLM-Team hat außerdem eine eigene CPU-Kommunikationsmethode entwickelt, die Informationen durch rekursive Verdopplung und andere Verfahren austauscht, um die für die Synchronisierung erforderlichen Runden zu reduzieren.
Für die kleine Batch-Dekodierung, die von Agenten häufig verwendet wird, hat vLLM außerdem beschlossen, DSpark-Entwurfsgenerierung separat zu unterstützen und den dedizierten Dekodierungspfad mit vollständigen CUDA-Graphen auszuführen.
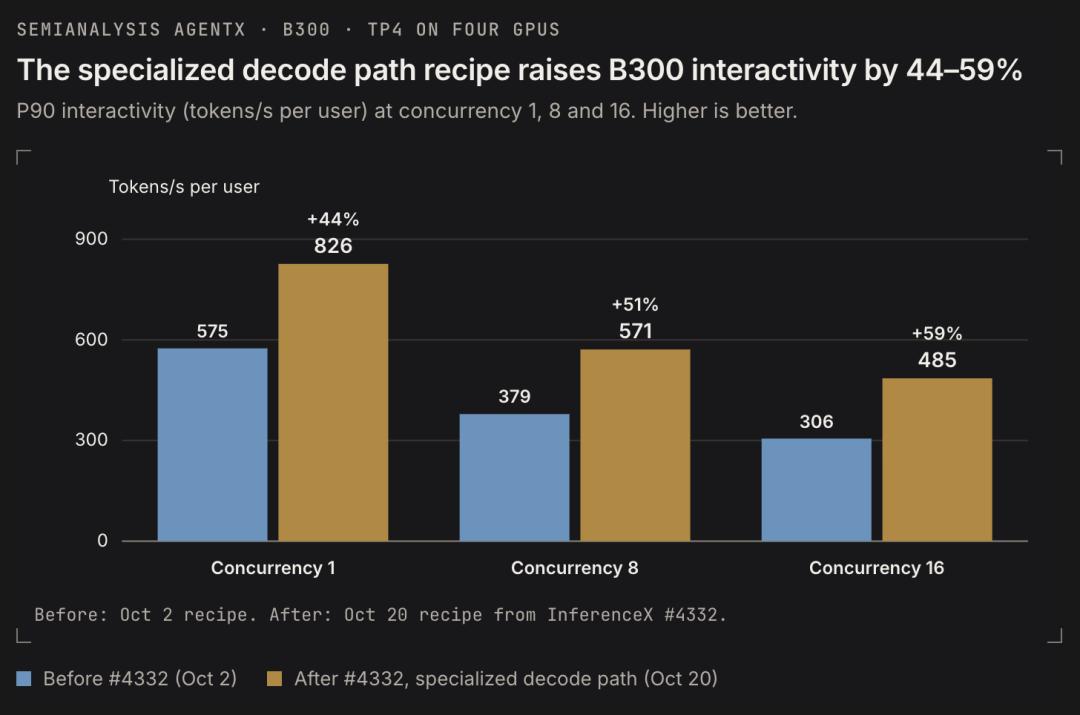
Die unmittelbar danach von SGLang vorgelegte Antwort geht noch weiter und deckt sowohl die Eingabe- als auch die Ausgabephase ab.
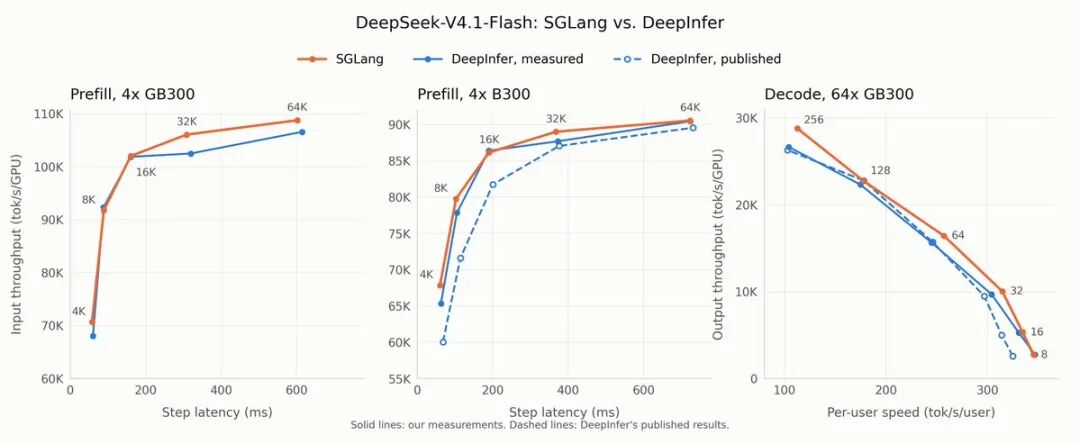
SGLang hat die Vorauffüllung auf 4 B300- bzw. 4 GB300-Grafikkarten getestet, und der maximale Durchsatz liegt um ca. 4 % höher als bei DeepInfer.
Bei dem Dekodierungstest wurden ebenfalls 64 GB300-Grafikkarten verwendet.
Bei 256 Anfragen pro Karte benötigt DeepInfer 31,19 Millisekunden pro Schritt, SGLang 28,88 Millisekunden – die Zeit pro Schritt wird um ca. 7,4 % verkürzt. Bei 8 Anfragen pro Karte liegen die beiden Werte fast gleichauf.
Im konkreten Vorgehen hat SGLang zuerst die Mega-Kernel (MegaMoE, MegaAttention, Mega-mHC, MegaGate), die begrenzte Wiedergabe mit SWA und die Engram-Optimierung integriert.
Nachdem die Leistung von DeepInfer erreicht wurde, wurde weiter iteriert und weitere Kernel-Fusionslösungen eingeführt.
Anschließend wurde durch die Unterstützung von aufteilbaren CUDA-Graphen eine effiziente Vorauffüllung realisiert.
Im Vergleich zur Open-Source-Version von DeepInfer ist SGLang vollständiger und enthält zusätzlich wichtige Dienstkomponenten, darunter das KV-Cache-System, die Architektur zur Trennung von Vorauffüllung und Dekodierung sowie das Lastausgleichsmodul.
Erwähnenswert ist, dass SGLang zum Zwecke eines strengeren Vergleichs DeepInfer auf GB300 und B300 noch einmal neu ausgeführt hat.
Das Ergebnis war überraschend: Der Durchsatz von DeepInfer in einigen Konfigurationen lag noch höher als die ursprünglich veröffentlichten Werte...
Wow! Lehrer D ist wirklich ein ehrlicher Mensch, die Testergebnisse sind absolut realistisch!
Der Kreislauf der Inferenzbeschleunigung
Der Entwickler Eric Zhang hat das Konzept noch einen Schritt weiter gebracht.
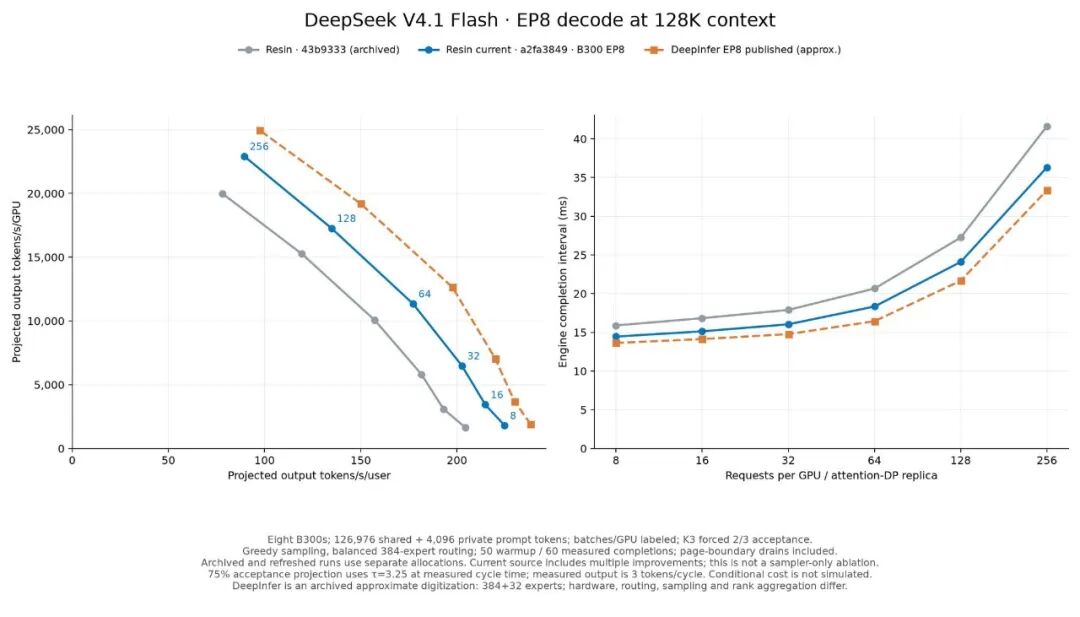
Zuvor hat er ständig eine experimentelle Bibliothek mit Bausteinen für den Aufbau von Inferenz-Engines für große Modelle entwickelt – Resin.
Darin werden Teile, die von vielen Modellen gemeinsam genutzt werden, zu einer gemeinsamen Basisplattform zusammengefasst, z. B. Scheduler, KV-Cache-Verwaltung usw. Der Benutzer muss nur noch die spezifische Berechnungsimplementierung für das jeweilige Modell und die jeweilige Hardware ergänzen, um eine unabhängige Engine zu erstellen.
Laut Eric selbst wurde er in der letzten Woche von DeepInfer inspiriert und hat erfolgreich viele Funktionen und Parallelisierungsmechanismen zum Laufen gebracht.
Laut den Testergebnissen unterscheidet sich die Leistung von Resin auf DeepSeek-V4.1-Flash um ca. 5 % bis 10 % von der von DeepInfer, und es verfügt gleichzeitig über Funktionen wie HTTP-Dienst, Präfix-Caching und Metriken.
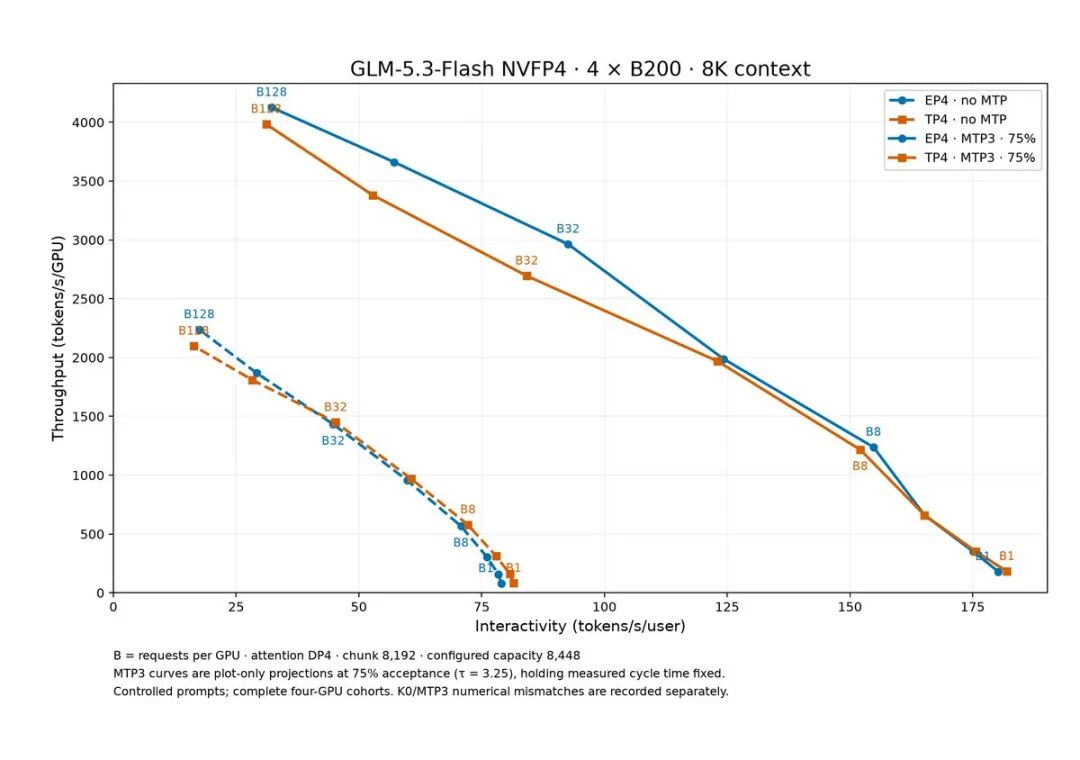
Anschließend hat er dieser Basisplattform noch eine zusätzliche Fähigkeit hinzugefügt.
Die Aufgabe bestand darin, der KI beizubringen, wie Modelle auf Basis von Resin implementiert werden, und dann Codex darauf über Nacht laufen zu lassen.
Laut seinen Angaben hat der Agent die GLM-5.3-Flash-Engine mit MTP-Unterstützung fertiggestellt. Bei der Konfiguration mit B200 und EP4 erreicht der maximale Eingabedurchsatz 60.000 Token/s und der maximale Ausgabedurchsatz 16.000 Token/s.
Und: Resin ist weiterhin Open Source.
Das ist so herzerwärmend – diese blühende Open-Source-Landschaft ist genau das, was du dir gewünscht hast, großer fetter Fisch.
DeepInfer stammt aus der Open-Source-Welt und kehrt zu ihr zurück. Reife Frameworks integrieren und optimieren es weiter, und einzelne Entwickler können die darin enthaltenen Designideen aufnehmen und die Open-Source-Entwicklung fortsetzen.
Also hat der große fette Fisch die wahre Bedeutung von nachhaltigem Open Source wirklich verstanden~
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „QbitAI“, Autor: Fokus auf zukunftsweisende Technologie, veröffentlicht mit Genehmigung von 36Kr.