Wenn KI in den GPU-Bereich vorstößt, geht die Edge-Rechenleistung zur Konvergenz über
Kürzlich hat Arm die Aktualisierung der neuen Generation der Mali-GPU-Architektur angekündigt. Die Matrixrecheneinheit in der Grafikpipeline wurde aufgerüstet, um die Zusammenarbeit bei der Inferenz großer Modelle auf Endgeräten und dem neuronalen Rendering zu stärken und ein einheitliches Softwareplanungsschema für fahrzeuggebundene, mobile und eingebettete Endgeräte einzuführen.
Dieser Ansatz, bei dem die KI-Rechenleistung in die GPU integriert wird und eine einheitliche Hardware mehrere Arten von Lasten trägt, wird zunehmend zur gemeinsamen Wahl der Branche. Ähnliche Integrationsversuche werden auch auf verschiedenen Marktebenen durchgeführt: von mobilen Endgeräten über Desktop-Geräte bis hin zum Markt für IP-Lizenzen verfolgen die Hersteller unterschiedliche Wege, die jedoch alle in die gleiche Richtung weisen.
01 Warum benötigt lokale KI eine GPU
Mit der stetigen Erweiterung der Anwendungsszenarien am Rand müssen Geräte gleichzeitig verschiedene Aufgaben wie Grafikrendering, maschinelles Sehen, Signalverarbeitung und Inferenz großer Modelle übernehmen.
Am Beispiel großer Modelle auf Endgeräten: Von der einzelnen Dialogverarbeitung bis zur multimodalen Zusammenarbeit, von kurzen zu langen Kontexten ändern sich die Lastmerkmale ständig, was höhere Anforderungen an die Flexibilität der Hardware stellt. In der vergangenen Zeit bestand der Mainstream-Gedanke im Chipdesign darin, spezielle Hardwaremodule für unterschiedliche Lasten separat zu konfigurieren. Grafikeinheit, KI-Beschleuniger und Videocodec-Einheit verfügen jeweils über unabhängige Datenpfade und Software-Stacks. Dieses Schema kann für einen einzelnen Indikator die optimale Leistung erzielen, aber seine Nachteile sind ebenfalls deutlich. Die Koexistenz mehrerer Beschleuniger erhöht den Schwierigkeitsgrad der Systemintegration erheblich, und Hardwareressourcen lassen sich nur schwer auf verschiedene Aufgaben verteilen. Sobald sich die Anforderungen der Endgeräte weiterentwickeln, treten Probleme mit unzureichender Auslastung einiger spezialisierter Hardware mit festen Funktionen auf, was die Gesamtkosten und den Stromverbrauch des Chips erhöht.
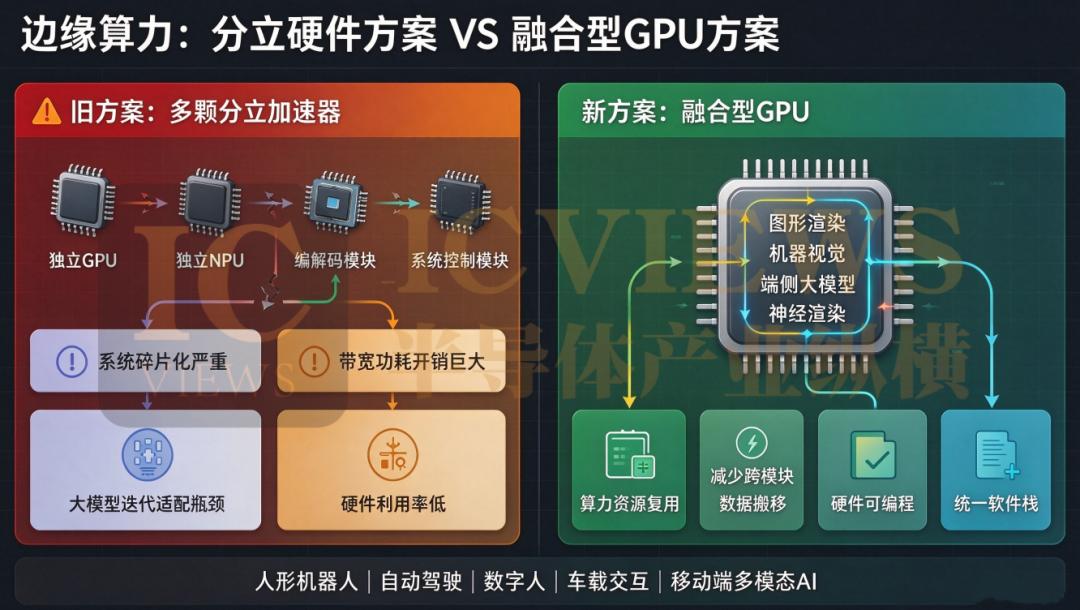
Zu Beginn des Booms der KI am Rand tauchten viele eigenständige NPU-Produkte auf dem Markt auf, deren Spezifikationen um feste Operatoren und Modellstrukturen herum entworfen wurden. Die Architektur großer Modelle, Quantisierungsschemata und Operatorsätze befinden sich jedoch noch in einem schnellen Iterationszyklus. Feste Hardwarearchitekturen stoßen nach der Aktualisierung der Modelle schnell an Anpassungsgrenzen. Die Branche erkennt allmählich, dass ein einzelner spezialisierter Beschleuniger die ständig wechselnden KI-Arbeitslasten langfristig nur schwer bewältigen kann. GPUs mit Grafikfähigkeiten, allgemeiner paralleler Rechenleistung und programmierbaren Eigenschaften werden zu dem zentralen Träger der integrierten Rechenleistung am Rand. Der Schwerpunkt des Wettbewerbs um die Rechenarchitektur verlagert sich auch von der reinen Vergleichsspitzenrechenleistung hin zur Programmierbarkeit der Hardware, der Allgemeingültigkeit des Software-Stacks und der tatsächlichen Energieeffizienz bei Mehrfachaufgaben.
Vor diesem Hintergrund haben viele Chiphersteller bereits begonnen, dieses Integrationskonzept umzusetzen. NVIDIA nutzt Tensor Cores, damit die GPU-Hardware die Rechenleistung zwischen Grafikrendering, maschinellem Sehen und KI-Inferenz wiederverwenden kann. Qualcomm hingegen koordiniert die Planung zwischen Adreno-GPU und Hexagon-NPU und verlagert gleichzeitig KI-Aufgaben wie Superauflösung und Framerate-Generierung in die Grafikpipeline. Die E-Serie-Produkte von Imagination entscheiden sich dafür, programmierbare Matrixbeschleuniger direkt in die Rendering-Pipeline zu integrieren, sodass ein einziger Kern gleichzeitig Grafik, allgemeine Berechnungen und KI-Inferenz übernimmt. Daher sind Grafikfähigkeiten ein unvermeidbares grundlegendes Fundament, wenn KI auf Endgeräten ausgeführt werden soll.
02 Zusammenarbeit von Hardware und Software bei integrierter Rechenleistung
Die Fähigkeit zur grundlegenden Matrix- und Faltungsrechnung wird zum Kern der integrierten GPU zur Unterstützung von KI- und visuellen Aufgaben. Die eingebettete Produktlinie von AMD integriert spezielle KI-Einheiten in die GPU-Kerne, um in Szenarien industrieller Roboter Echtzeitvisualisierungen gleichzeitig mit Aufgaben des maschinellen Sehens wie Zielerkennung und Segmentierung zu verarbeiten, wobei die Stabilität bei gleichzeitiger Ausführung mehrerer Aufgaben im Vordergrund steht. Die Arc-Integrierte Grafikkarte von Intel iteriert kontinuierlich die neurale Superauflösung XeSS, bindet die KI-Upsampling-Funktion tief in den Grafikrendering-Prozess ein und reduziert den Overhead der Datenübertragung, der durch eine separate NPU entsteht. Hinter diesen Entscheidungen steht die gemeinsame Überlegung zur Effizienz der gleichzeitigen Ausführung mehrerer Aufgaben auf Endgeräten und zum Bandbreitenaufwand bei der Datenübertragung. Obwohl die Implementierungswege der verschiedenen Hersteller unterschiedlich sind, erkennen sie alle, dass ein einzelner Hardwareindikator die sich ständig weiterentwickelnden KI-Lasten nicht unterstützen kann. Die Programmierbarkeit der Hardware ersetzt feste Operatoren und wird zum Schwerpunkt des Wettbewerbs auf unterster Ebene.
Neuronales Rendering ist der direkteste Ansatz, um KI in die Grafikpipeline zu integrieren. NVIDIAs DLSS rekonstruiert niedrig aufgelöste Frames mit neuronalen Netzen. DLSS 4 führt die Generierung mehrerer Frames weiter ein, sodass mehrere Bilder für jeden traditionell gerenderten Frame erzeugt werden können, was die Framerate auf das Mehrfache des traditionellen Renderings steigert. Anschließend wird es zu einem 3D-gesteuerten neuronalen Rendering weiterentwickelt, das Licht und Materialien der KI überlässt. AMDs FSR 4 nutzt trainierte neuronale Netze, um die Bildqualität aus niedrig aufgelösten Frames zu rekonstruieren. Intels XeSS 2 bündelt KI-Frame-Generierung und Niedriglatenz-Technologien, wobei die Anzahl der unterstützten Spiele stetig wächst. Superauflösung ist der gemeinsame Einstiegspunkt für alle Hersteller, da sie unter Beibehaltung der Rendering-Auflösung mit neuronalen Netzen die Bilddetails ergänzen kann, um Bildqualität und Leistung zu vereinbaren, ohne dass spezielle Hardware für KI-Funktionen separat bereitgestellt werden muss. Die E-Serie von Imagination führt in dieser Richtung das NSR-Neural-Superauflösungs-Schema ein, das tief an die eigene GPU angepasst ist. Es verwendet eine einzelne zeitliche Superauflösungsverarbeitung und kombiniert mit der Technologie zur selbstständigen Netzkompression, um redundante Gewichte zu reduzieren und den Inferenzstromverbrauch zu senken. Bei einer Konfiguration mit einem 1-GHz-Einkern beträgt die Latenz der Superauflösung von 540p auf 1080p etwa 2,3 Millisekunden. Es ist geplant, die Unterstützung über das PowerVR SDK sowie Engines wie Unreal Engine und Godot bereitzustellen. Der gemeinsame Vorteil, Aufgaben wie Superauflösung in die GPU statt in eine separate NPU zu legen, besteht darin, den Bandbreitenverlust zu reduzieren, der durch das Hin- und Herbewegen von Framedaten zwischen verschiedenen Hardwaremodulen entsteht.
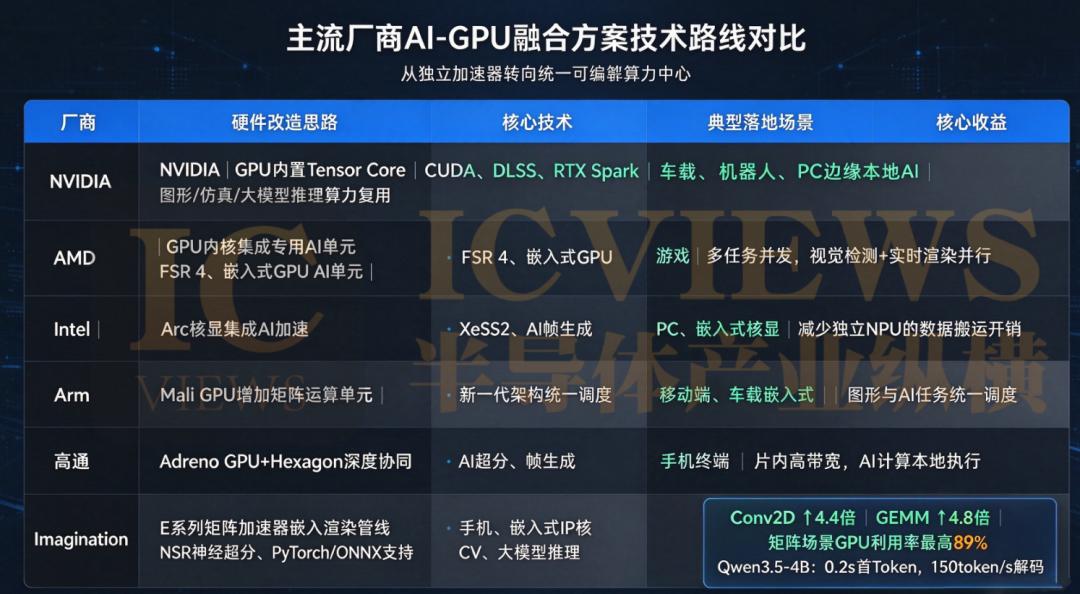
Bei der grundlegenden Rechenleistung zeigen Vergleichsdaten von Imagination, dass im Vergleich zur vorherigen D-Serie die Faltungsleistung Conv2D der E-Serie um das 4,4-fache gestiegen ist, die Matrixmultiplikation GEMM um das 4,8-fache und die GPU-Auslastung in Matrixrechenszenarien bis zu 89 % erreichen kann. Bei typischen Rand-Sprachmodellen ist die Füllleistung um das 4,7-fache gestiegen. Am Beispiel des Modells Qwen 3.5 4B kann bei einer Konfiguration mit 1,5-GHz-Vierkernen eine erste Token-Generierung in 0,2 Sekunden erreicht werden, und der Decodierungsdurchsatz beträgt etwa 150 Token pro Sekunde. Um die Kosten für die Modellmigration zu senken, übermittelt das Team den optimierten Llama.cpp-Backend an die oberste Open-Source-Community. Später ist die native Unterstützung von PyTorch und ONNX Runtime geplant. Grafik bleibt die Grundbasis dieses IP. Die E-Serie fügt Unterstützung für DirectX 12 FL11_0 hinzu, erreicht bei Spiel-Lasten eine Leistungssteigerung von bis zu 54 % im Vergleich zur Vorgängergeneration und eine Steigerung der Leistung pro Watt von bis zu 39 %. Sie bietet mehrere konfigurierbare Spezifikationen, die von Smartphones bis zu eingebetteten Systemen reichen. Die ersten Chips sollen noch in diesem Jahr in die Fertigung gehen.
03 Die gesamte Branche konvergiert zur GPU
NVIDIA verfeinert auf Basis der Blackwell-Architektur weiterhin das einheitliche Rechenleistungssystem, nutzt das CUDA-Software-Stack, um Rendering, allgemeine Berechnungen und die Inferenz lokaler Agenten zu verbinden. Die neue Version des 3D-gesteuerten neuronalen Renderings injiziert die KI-Generierungsfähigkeit direkt in den Echtzeit-Rendering-Prozess. Verbraucherhardware wie RTX Spark bündelt Grafik-, CPU- und KI-Rechenleistung auf einem einzigen Chip und unterstützt die Ausführung lokaler Agenten mit großen Parametern offline – dies ist das Produkt der Umsetzung dieses Konzepts für Endgeräte.
Auf der GTC-Konferenz in Berlin am 21. Oktober bestätigte die Grundsatzrede von Jensen Huang diese Richtung indirekt. Er stellte fest, dass „Physische KI“ die nächste Hauptentwicklungslinie sein wird. Interaktive Szenarien in der realen Welt wie humanoide Roboter und autonomes Fahren sind stark darauf angewiesen, dass das Gerät lokal gleichzeitig Simulationsrendering und KI-Inferenz durchführt. In der Live-Demonstration übernahm RTX Spark auf denselben GPU-Ressourcen parallel das 3D-Simulations-Rendering und die Inferenz des Roboter-Agenten.
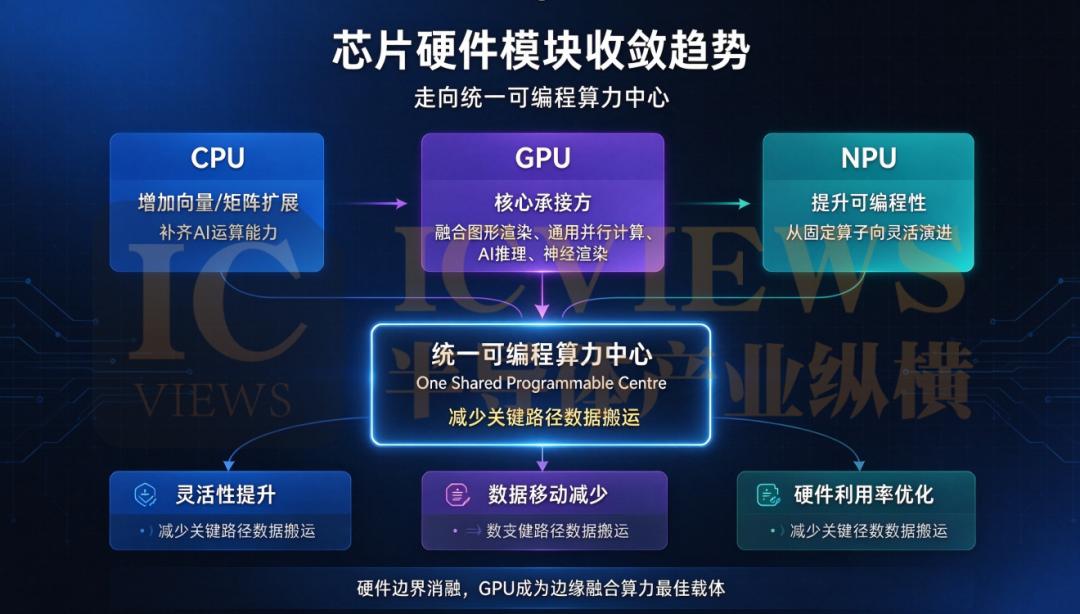
Auf der anderen Seite wählt die neue Generation der Mali-Architektur von Arm, mehr Matrixrechenressourcen in der Grafikpipeline zu integrieren, um die einheitliche Planung von Grafik- und KI-Aufgaben zu realisieren und das Hin- und Herbewegen von Daten zwischen mehreren Beschleunigern zu reduzieren. Auch Qualcomm fügt der GPU KI-Matrixkerne hinzu, um neuronale Verarbeitung, Superauflösung und Framerate-Generierung in die Grafikpipeline zu bündeln und mit Hilfe des On-Chip-Hochgeschwindigkeits-Arbeitsspeichers die KI-Berechnungen lokal zu halten.
Von IP-Herstellern bis zu Endgeräte-Chips verschwimmen die Grenzen zwischen den Hardwarekomponenten zunehmend: CPUs ergänzen ihre KI-Leistung durch Vektorerweiterungen, NPUs werden zunehmend allgemeiner einsetzbar. GPUs zeichnen sich aufgrund ihrer parallelen Rechenleistung, ausgereiften Software-Ökosysteme und nativen Grafikfähigkeiten in Szenarien mit gemischten Lasten durch herausragende Vorteile aus. Mit der Verbreitung multimodaler großer Modelle auf mobilen Endgeräten dienen Endgeräte nicht mehr nur der Ausführung von Dialogen, sondern müssen auch die kooperative Verarbeitung von Bild und Sprache übernehmen, sodass die Nachfrage nach einheitlicher Hardwareplanung immer stärker wird. Die Kriterien der Branche zur Bewertung von Hardware ändern sich ebenfalls. Die auf dem Papier angegebene TOPS-Spitzenrechenleistung ist nicht mehr der einzige Maßstab. Der End-to-End-Token-Durchsatz, die Rendering-Latenz, der Bandbreitenaufwand, die tatsächliche Energieeffizienz und die Erweiterbarkeit der Software werden wichtiger.
04 Von dem Verkauf von Hardware zum Verkauf von Plattformen
Im Zeitalter der integrierten Rechenleistung verlagert sich der Wettbewerbsschwerpunkt von Chiphersteller und IP-Anbietern schrittweise von dem Vergleich der Leistung von Hardwareeinheiten zum Aufbau vollständiger Plattformfähigkeiten. Die Programmierbarkeit der Hardware, die Anpassung an Open-Source-Ökosysteme und die Integration von übergeordneten Engines bestimmen gemeinsam den Wert eines Produkts während des gesamten Lebenszyklus des Geräts. Ein einzelner Vorteil bei Hardwareparametern lässt sich langfristig nur schwer aufrechterhalten. Ein einheitlicher, iterierbarer Software-Stack wird zum zentralen Wettbewerbsvorteil für integrierte GPU-Lösungen. Dies bedeutet auch, dass die um die GPU aufgebauten Entwicklungswerkzeugketten, Open-Source-Beiträge und Engine-Anpassungen die reine Rechenleistung ablösen und zu einem wichtigen Maßstab für die Wettbewerbsfähigkeit eines Chipherstellers werden. Für nachgeschaltete Entwickler bestimmen das vertraute Programmiermodell und die wiederverwendbare Werkzeugkette direkt, ob eine Hardware schnell in das Mainstream-Ökosystem aufgenommen werden kann.
Jon Peddie, Präsident und Gründer von Jon Peddie Research, sagte: „Die Grenzen zwischen traditionellen Prozessorklassen verschwimmen allmählich. CPUs nutzen Vektorerweiterungen, um ihre KI-Leistung zu steigern, während NPUs zunehmend allgemeiner einsetzbar werden. Mit der fortschreitenden Integration von Funktionen ist die GPU am wahrscheinlichsten, sich in diesem Trend durchzusetzen. Schließlich verfügt die GPU nicht nur über parallele Rechenleistung und ein ausgereiftes Software-Ökosystem, sondern kann im Gegensatz zu anderen Prozessoren auch Grafikaufgaben verarbeiten, während sie KI- und Berechnungsaufgaben ausführt.“
Mit Blick auf die Zukunft werden mit der kontinuierlichen Umsetzung von Randanwendungen wie generativer KI, digitalen Menschen, Robotern und fahrzeuggebundener Interaktion gemischte Lasten aus Grafikrendering und KI-Inferenz immer häufiger auftreten. Chiphersteller werden weiterhin zwischen spezialisierter Hardware und allgemeinen programmierbaren Architekturen abwägen. Integrierte GPUs bieten der Branche einen praktikablen Weg, um die Fragmentierung des Systems zu verringern und Rechenressourcen wiederzuverwenden. Der nachfolgende industrielle Wettbewerb wird sich stärker auf die Vollständigkeit des Software-Ökosystems, die Effizienz der lastübergreifenden Planung, die Kosten der Modellmigration und die Fähigkeit zur kontinuierlichen Iteration in verschiedenen Endgeräteszenarien konzentrieren.