Großmodelle mit fast einer Billion Parameter halten Einzug auf Desktop-Geräten, Apple und NVIDIA sorgen gemeinsam für einen völligen Umbruch im Segment der KI-PCs.
Wenn wir über persönliche KI sprechen, kommen wir an Edge-Modellen nicht vorbei. Derzeit können Edge-Modelle jedoch die Anforderungen an den KI-Betrieb für komplexere Aufgaben kaum erfüllen, und der Grund ist einfach: Umfang und Fähigkeiten der Modelle sind nach wie vor durch die Hardware begrenzt.
Heute nähert sich die Parametergröße modernster Großmodelle der Billionen-Grenze. Beispielsweise hat das öffentlich zugängliche Modell Kimi K3 eine Parameterzahl von bis zu 2,8 Billionen. Selbst bei Anwendung der 4-Bit-Quantisierung (bei der ein Teil der Genauigkeit geopfert wird, um die Leistungsanforderungen zu senken) benötigen allein die Modellgewichte etwa 1,4 TB Speicherplatz, und im laufenden Betrieb fallen zusätzliche Speicherkosten an.
Die meisten handelsüblichen Consumer-Grafikkarten verfügen nur über 8/12 GB Grafikspeicher, und nur wenige High-End-Modelle erreichen 16/24/32 GB. Bei professionellen Grafikkarten mit noch größerem Speicher kosten die gesamten Systeme oft ab einer sechsstelligen Summe – ein Preis, der jeden abschreckt.
Daher vertrat Leike Technology lange Zeit die Ansicht, dass es keine Großmodelle auf der Edge-Seite gibt. Diese Ansicht ist jedoch inzwischen überholt. Denn vor uns steht Nvidias RTX Spark, danach Apples Mac Studio: Beide Unternehmen stellen sich gleichzeitig der Herausforderung des Ziels „Großmodell auf der Edge-Seite“.
Echter KI-PC ist da
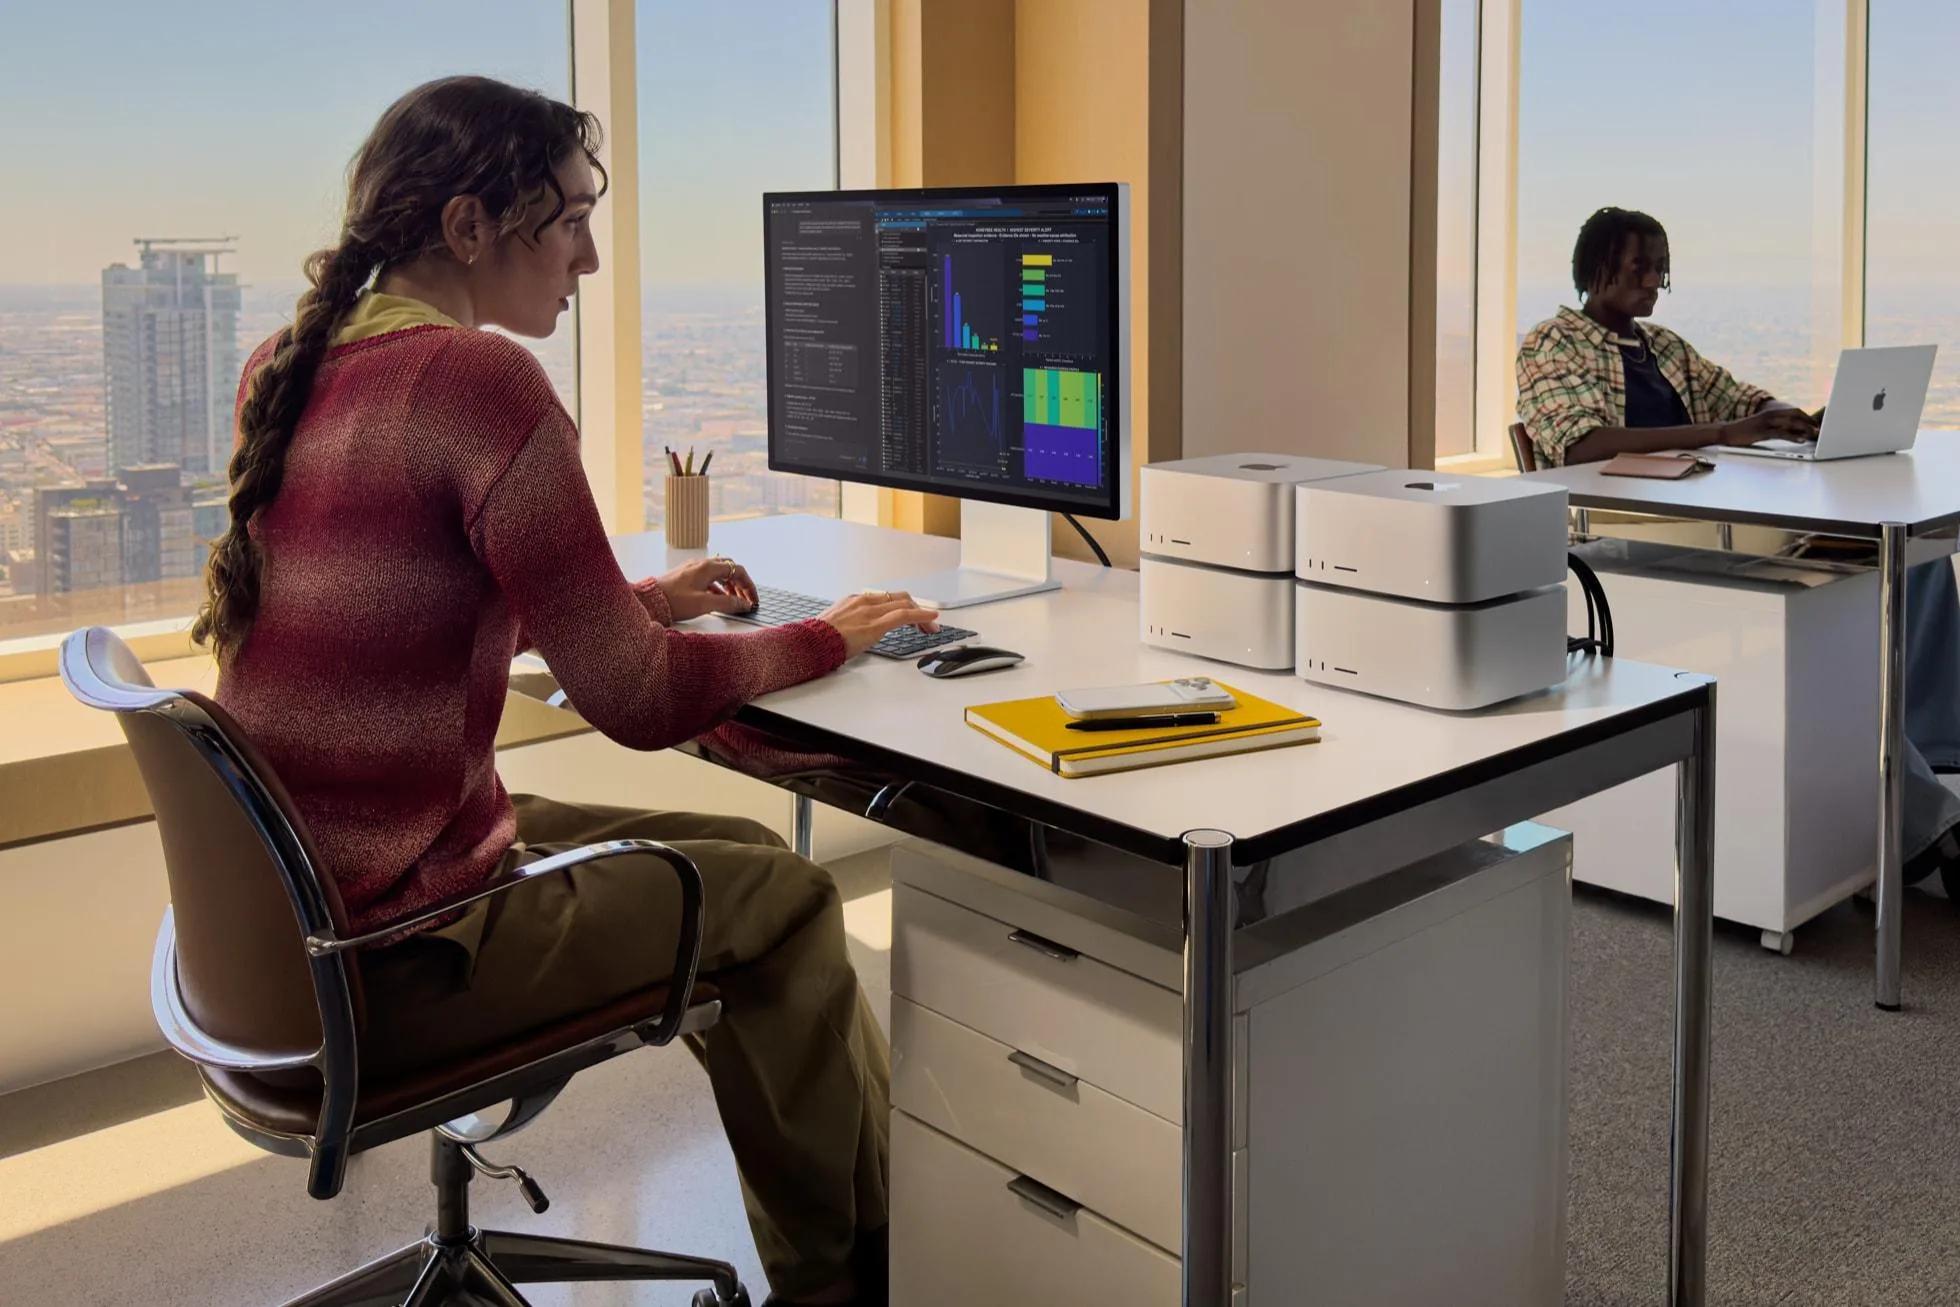
Vor kurzem hat Meta offiziell das Open-Weight-Modell Muse Spark Open mit 816 Milliarden Parametern veröffentlicht. Apple hat über das MLX-Framework die vollständige Inferenz dieses Modells auf einem Cluster aus Mac Studio-Geräten der M5 Ultra-Version erfolgreich ausgeführt. Allein bezüglich der Parameterzahl gehört Muse Spark Open zur ersten Riege der derzeit öffentlich zugänglichen Großmodelle.
Quelle: Apple
Die Top-Ausstattung des Mac Studio ist zwar nicht billig, aber das Gerät kann zumindest auf Ihrem Schreibtisch stehen und ein Modell mit fast einer Billion Parametern bereitstellen – allein das ist schon fast magisch. Im Vergleich dazu ist Nvidia nicht so extrem: Ihre RTX Spark-Laptops packen nur ein Modell mit 120 Milliarden Parametern in das Gerät.
Früher dachte man darüber nach, wie man Modelle „verkleinern“ kann, um sie in den Grafikspeicher zu packen. Heute reißen die Giganten den Tisch direkt um und bringen „KI-Supercomputer“ auf den Schreibtisch. Aus Sicht von Leike bedeutet dies im Grunde, dass persönliche KI-PCs offiziell in die „Ära der Modelle mit hunderten Milliarden Parametern“ eintreten.
An dieser Stelle fragen sich manche Leser vielleicht: „Musste ein Modell mit 816 Milliarden Parametern früher nicht auf einem H100-Server-Cluster ausgeführt werden? Wie passt es in einen Desktop-Mac Studio?“
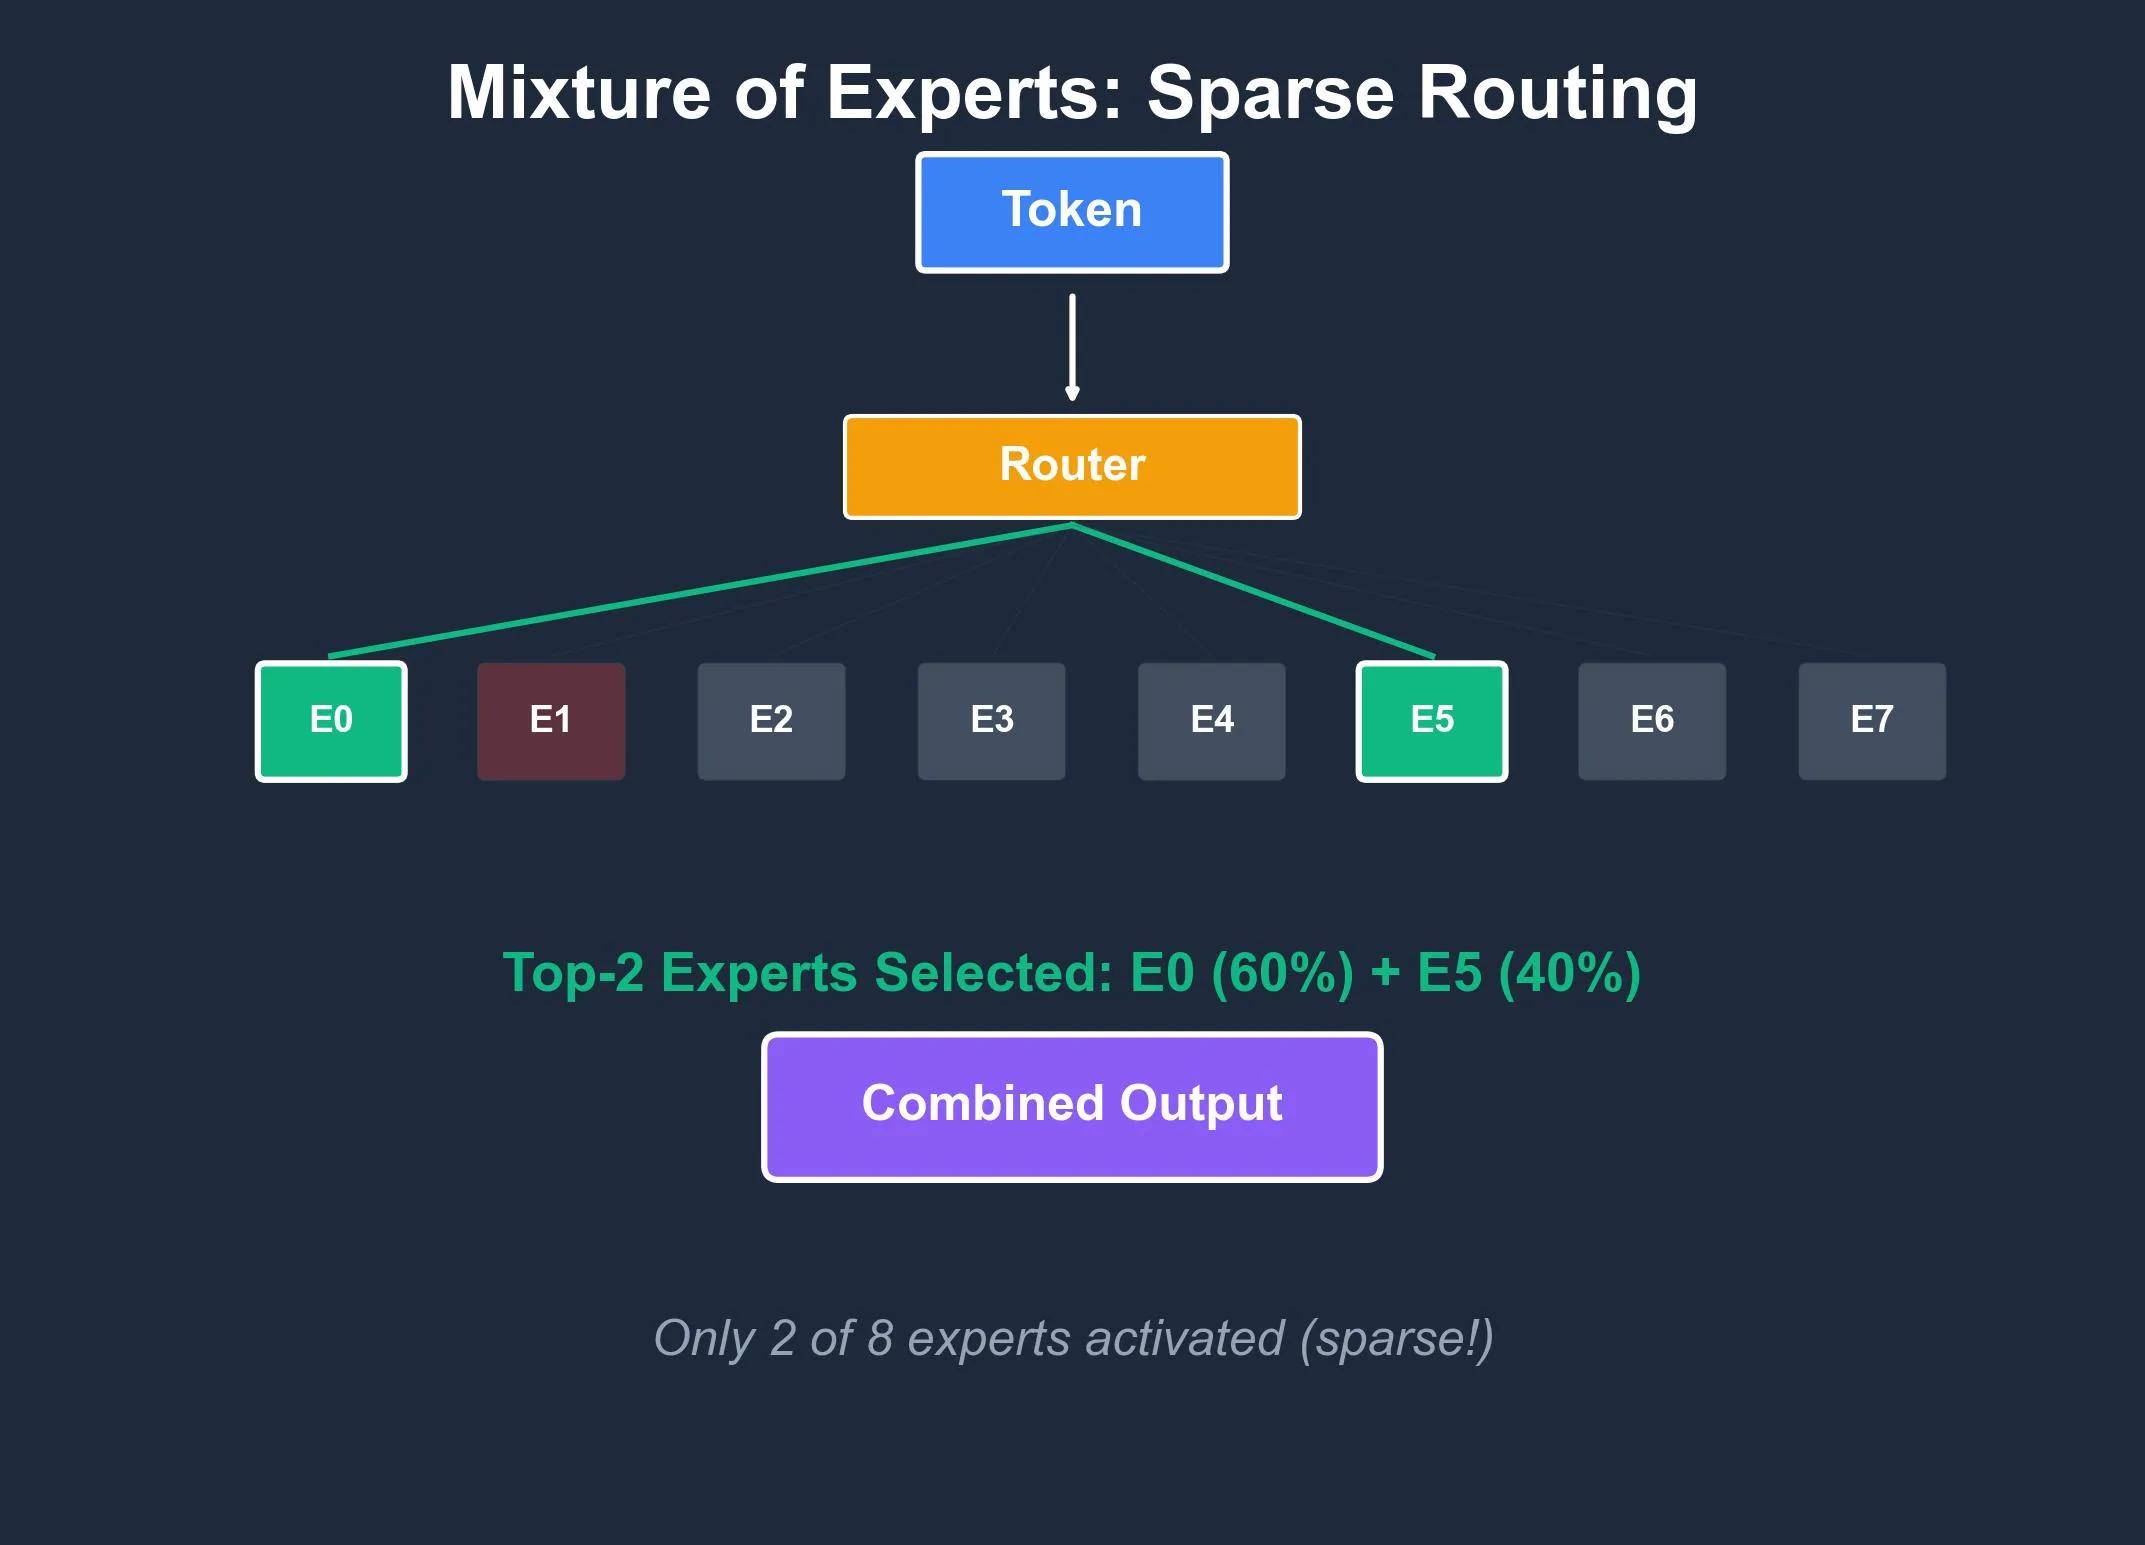
Der Kern liegt in der Kombination aus MoE-Architektur und hochbreitbandigem einheitlichem Speicher. Was bedeutet das? Einfach ausgedrückt: Obwohl Muse Spark Open über 816 Milliarden Parameter und 256 Expertennetzwerke verfügt, werden bei jeder Generierung von Token nur etwa 42 Milliarden (42B) Parameter dynamisch aktiviert.
Quelle: Nvidia
Das ist wie ein Superkrankenhaus mit 256 Fachärzten, bei dem für jede Behandlung nur 8 passende Experten zur Konsultation zusammenkommen. Das Modell mit einem Rechenaufwand von fast 42B kann dennoch die riesige Parametergröße des 816B-Modells nutzen.
Aber MoE hat eine tödliche Hürde: Alle Gewichte des Modells müssen nach wie vor im Speicher abgelegt werden. Man kann zwar den Rechenaufwand reduzieren, nicht aber den Speicherbedarf. Daher haben Apple und Nvidia die gleiche Lösung ins Auge gefasst: CPU und GPU auf einem einzigen Chip zu integrieren und dann mit einem riesigen einheitlichen Speicher die Modellgewichte zu bewältigen.
Apple nutzt zwei Mac Studio-Geräte der M5 Ultra-Version mit 512 GB einheitlichem Speicher, die über Thunderbolt 5 zu einem verteilten Inferenzcluster verbunden sind. Mit dem insgesamt 1 TB großen einheitlichen Speicher der beiden Geräte wird das 816B-Modell untergebracht. Darüber hinaus kann die parallele Inferenz mit vier Mac Studio-Geräten durchgeführt werden. In den von Apple veröffentlichten Tests erreicht die Generierungsgeschwindigkeit mit vier Geräten über 36 Token pro Sekunde, was für viele alltägliche Entwicklungsszenarien ausreicht.
Obwohl die Geschwindigkeit nicht mit der einiger Cloud-Modelle mithalten kann, ermöglicht die lokale Bereitstellung, dass sensible Daten möglichst auf dem eigenen Gerät verbleiben, und sie funktioniert auch ohne Internetverbindung – das ist für Fachkräfte in Bereichen wie dem Finanzsektor sehr attraktiv. Für normale Entwickler ist Cloud-Rechenleistung ehrlich gesagt günstiger, da die Bereitstellung eines Mac Studio der M5 Ultra-Version mit 512 GB Speicher voraussichtlich mehr als 100.000 Yuan kostet. Der genaue Preis wird erst Ende des Monats von Apple bekannt gegeben.
An dieser Stelle machen sich viele Freunde wahrscheinlich Sorgen um ihren Geldbeutel. Was ist, wenn man keinen Mac Studio kauft, sondern einen RTX Spark-Laptop? Der ist zwar deutlich günstiger, aber die Version mit 128 GB kostet immer noch 40.000 bis 50.000 Yuan. Zwar liegt das auch am derzeit sehr hohen Speicherpreis, aber dieser Aufschlag ist dennoch enorm.
Wofür gibt man hunderttausende Yuan für die Bereitstellung eines KI-Großmodells aus?
Nun stellt sich die Frage: Wenn die Kosten für die Bereitstellung von Großmodellen auf der Edge-Seite so hoch sind, warum sollte man sie dann vorantreiben? Wofür ist das für private Nutzer nützlich?
Ehrlich gesagt: Wenn Sie im Alltag nur Übersetzungen durchführen oder Texte verfassen, sind Cloud-APIs tatsächlich die optimale Lösung. Aber wenn Ihre Anforderungen an KI tiefer gehen, kann Cloud-KI nicht alle Ihre Wünsche erfüllen. Nehmen wir die Programmierung als Beispiel: Mit zunehmendem Code-Umfang steigt der Token-Verbrauch von KI-Agenten während der Aufgaben stark an, ein großer Teil davon stammt aus Kontextrückblicken und Tests.
Diese zusätzlichen Inferenzkosten sind nicht gering, insbesondere wenn Sie fortlaufende Tests und Überwachungen durchführen. Wenn jedoch ein Modell mit 120B oder sogar 816B auf der Edge-Seite bereitgestellt wird, sieht die Situation ganz anders aus. Entwickler können diese trivialen Inferenzaufgaben an das Edge-Modell verteilen und nur komplexe Aufgaben an die Cloud übergeben. Dadurch sinken die marginalen Inferenzkosten stark, und Sie müssen keine API-Gebühren für jeden Aufruf mehr zahlen.
Quelle: Apple
Darüber hinaus gibt es Aufgaben, die die Sicherheit lokaler Computer und Daten betreffen, wie die Verwaltung intelligenter Haushaltsgeräte, lokale Datenanalysen und die Datenverarbeitung mit hohen Geheimhaltungsanforderungen – all dies kann durch die Bereitstellung von Edge-Modellen das Risiko eines Datenlecks verringern.
Für Anwälte, Finanzanalysten und einige Programmierer können sich diese Investitionen voll und ganz lohnen, denn bei einem Datenleck ist der Schaden oft weit höher als die Kosten für die Geräte.
Darüber hinaus spart man im Bereich der KI-Videoproduktion noch mehr Kosten für die Cloud-Generierung. Ersteller können Videomodelle vollständig lokal bereitstellen und dann Videos wiederholt zu niedrigen Grenzkosten generieren. Sobald zufriedenstellende Videoclips entstanden sind, laden sie diese zur Cloud-KI hoch, um vollständige Videos mit mehr Details und besserer Wirkung zu generieren – das senkt die Kosten für die frühe „Ausprobierphase“ erheblich.
Für normale Nutzer ist es tatsächlich nicht notwendig, sich mit Edge-Modellen mit sehr großen Parameterzahlen zu befassen. Für Nutzer, die KI als Produktivitätswerkzeug einsetzen, ist dies jedoch lediglich eine Investition.
Nvidia verfolgt Portabilität, Apple setzt auf maximale Rechenleistung
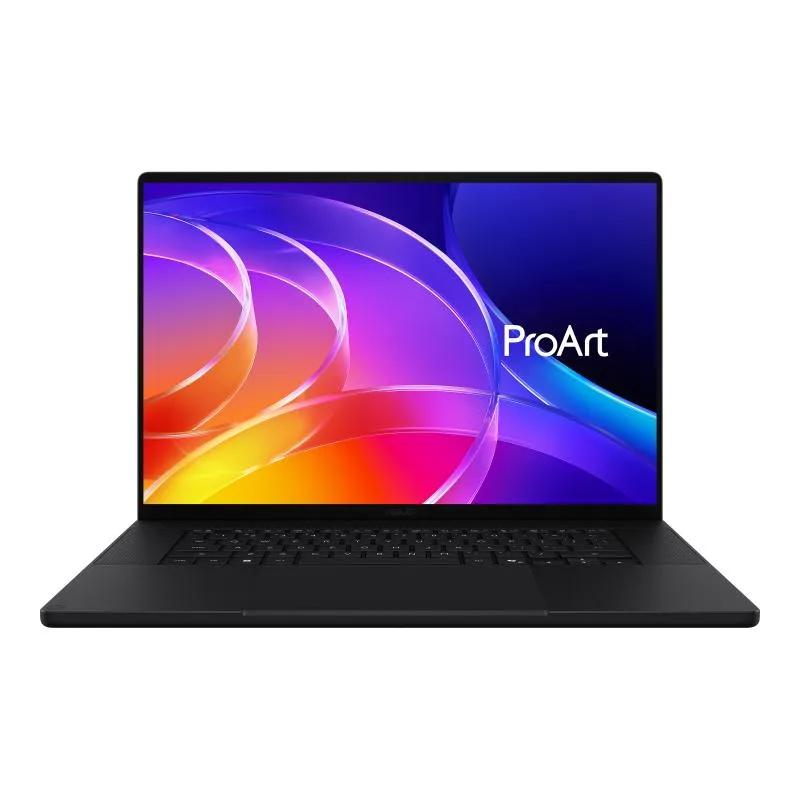
Aus Sicht von Leike verfolgt Nvidia eigentlich die Route „mobile Allround-Lösung + Ausweitung des CUDA-Ökosystems“. Nvidia hat bei RTX Spark einen angepassten Arm-CPU und eine Blackwell-GPU zu einem einzigen Chip-SOC kombiniert und in schlanke Gehäuse wie das Asus ProArt 16 und das Lenovo YOGA Pro 15 integriert.
Gleichzeitig hat Nvidia zusammen mit Microsoft am Markttag eine native PyTorch-CUDA-Version für Windows on Arm bereitgestellt (die 97 % der beliebten Python-Pakete unterstützt). Außerdem wurden Anpassungen für mehrere Szenarien vorgenommen, darunter lokale KI-Agenten wie das beliebte OpenClaw „AI Lobster“, ComfyUI RTX Video mit Superauflösung und Frame-Interpolation sowie Spiele mit DLSS 5.
In Kombination mit der NVIDIA PAIR-Technologie kann der Laptop zu Hause auch zu einem lokalen „KI-Inferenzserver“ werden, der von anderen Computern aufgerufen werden kann. Diese Fähigkeiten treffen direkt die Bedürfnisse mobiler Entwickler. Einfach ausgedrückt: RTX Spark ist für Entwickler gedacht, die meist nicht an einem festen Ort entwickeln und gleichzeitig hohe Anforderungen an die Datensicherheit stellen.
Quelle: Asus
In Nvidias Vorstellung kann der RTX Spark PC als tragbarer Assistent für Entwickler fungieren, der Edge-Großmodelle ausführt. Gleichzeitig übertrifft er viele herkömmliche Hochleistungs-Laptops in Bezug auf Energieeffizienz, bietet eine gute Akkulaufzeit bei mobilem Einsatz und deckt zudem Anforderungen in Bereichen wie Erstellung und Spiele ab – also eine hohe Allgemeinverwendbarkeit.
Bei Apple ist das anders: Sie verfolgen tatsächlich die kapitalintensive Route „maximales Energieeffizienzverhältnis + Erweiterung des Desktop-Clusters“. Apple erwartet nicht, dass Sie diese Geräte, in die das 816B-Modell passt, mit sich herumtragen. Vielmehr sollen sie in einigen lokalen KI-Inferenzszenarien eine Alternative zu herkömmlichen unternehmensweiten Servern darstellen.
Tatsächlich ist diese Geräteausstattung für kleine Unternehmen und persönliche Studios sehr attraktiv. Im Vergleich zu teuren GPU-Servern und den dazugehörigen Wartungskosten erscheint ein Mac Studio-Cluster für 200.000 bis 300.000 Yuan nicht mehr unerreichbar.
Sowohl RTX Spark als auch Mac Studio beweisen eines: „Großer einheitlicher Speicher“ wird zu einem wichtigen Entwicklungstrend für KI-PCs. Obwohl derzeit die Preise für solche Produkte aufgrund steigender Speicherpreise und Chipherstellungskosten hoch bleiben, zeigen bisherige Erfahrungen, dass mit der Weiterentwicklung der gesamten Branche im Bereich der einheitlichen Speichertechnik die Kosten entsprechender Produkte schrittweise sinken werden.
Aber derzeit gehören diese „echten KI-PCs“ noch zu den „Spielzeugen“ von professionellen Entwicklern, intensiven Erstellern und wohlhabenden Technikbegeisterten. Apples Lösung mit mehreren parallel geschalteten Geräten ist eindeutig exklusiv für „Spieler mit großem Budget“, und die 512-GB-Version kommt erst Ende des Monats auf den Markt. Nvidias RTX Spark beginnt zwar bei einem Preis von 2599 US-Dollar, aber die voll ausgestattete 128-GB-Version, die das 120B-Modell flüssig ausführen kann, kostet in China im Allgemeinen etwa 40.000 Yuan.
Derzeit sind erste Modelle wie das Asus ProArt 16 RTX Spark und das Lenovo YOGA Pro 15 RTX Spark auf dem Markt erschienen, und Apple wird den Preis der M5 Ultra-Version mit 512 GB Ende des Monats bekannt geben. Wenn es später möglich ist, wird Leike vielleicht ein Asus ProArt 16 RTX Spark besorgen, um es für Sie zu testen – bleiben Sie dran.
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „Leike Technology“, Autor: Leike Technology, veröffentlicht mit Genehmigung von 36kr.