Vergleichbar mit dem wegweisenden Grundlagenpapier von Transformer? Diese Forschungsarbeit hat heftige Debatten in der gesamten KI-Gemeinschaft ausgelöst.
Dieser Artikel hat das Verständnis im Bereich der künstlichen Intelligenz vollständig auf den Kopf gestellt, weitreichende Spekulationen ausgelöst, und Sam Altman hat seine Anerkennung öffentlich zum Ausdruck gebracht.
Der Forscher Adam Majmudar schrieb auf X: Dies ist das wichtigste Ergebnis dieses Jahres, seine Bedeutung ist vergleichbar mit „Attention Is All You Need“. Es bringt uns von der Phase „Kann das Ausrichtungsproblem überhaupt gelöst werden?“ in die Phase „Vielleicht können wir das Ausrichtungsproblem bereits im nächsten Jahr lösen“.
Andere Personen äußerten: „Mein Verständnis von neuronalen Netzen scheint um fünf Jahre vorangetrieben worden zu sein.“
Der Autor des Artikels, Cammarata, erklärte, dass er den Artikel zu einem Zeitpunkt veröffentlicht habe, an dem die Menschen nach Hoffnung suchten.
Was die Forscher und politischen Entscheidungsträger im Bereich der KI-Sicherheit am meisten fürchten, ist, dass leistungsstarke Modelle enorme Risiken mit sich bringen könnten. Derzeit brauchen sie dringend eine „Rettungsleine“, um sich zu stützen. Dies ist einer der Gründe, warum der Artikel eine so große Resonanz hervorgerufen hat.
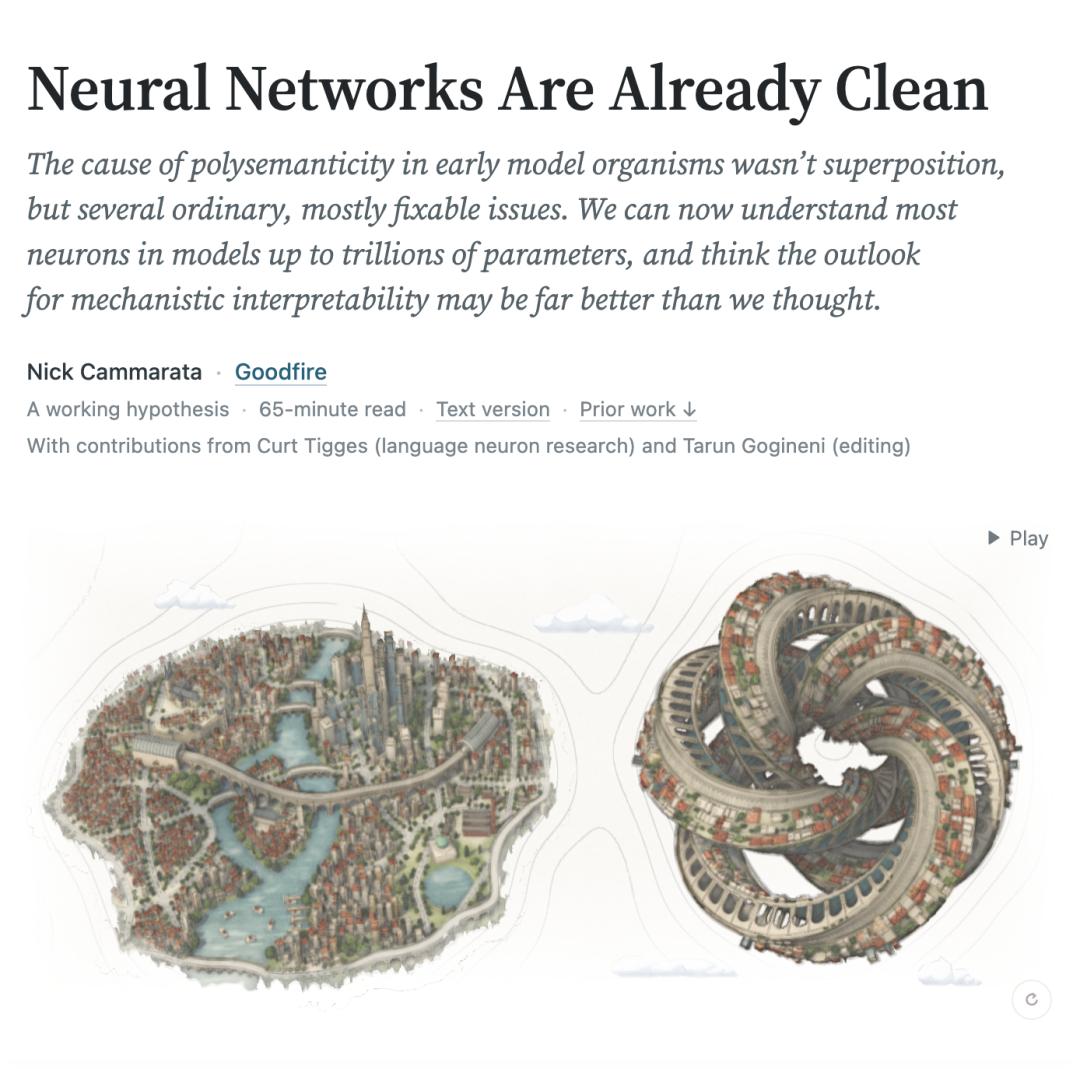
Die im Artikel vorgelegte Beurteilung ist ziemlich gewagt: Große neuronale Netze sind möglicherweise leichter zu verstehen, als man früher angenommen hat, und viele interne Strukturen, die als schwer zu zerlegen galten, folgen vielleicht schon immer einer erkennbaren Regel.
Dennoch ist Jacob Hilton vom gemeinnützigen Forschungslabor Alignment Research Center in Berkeley nicht der Ansicht, dass Cammaratas Blog so wichtig ist, wie alle behaupten.
Aus Hiltons Tweet auf X geht hervor: Die Forscher verstehen weniger als 0,01 % der internen Funktionsweise führender LLMs.
„Ich habe Cammaratas Optimismus immer geschätzt, aber leider vermittelt er der Öffentlichkeit ein unrealistisches Bild vom aktuellen Stand des Fachgebiets.“
Link zum ursprünglichen Blog👉: https://already-clean.goodfire.com/
Die Black Box – vielleicht haben wir sie falsch verstanden
Fast alle großen Modelle verwenden in gewissem Maße neuronale Netze.
Ein neuronales Netz ist ein maschinelles Lernmodell, das nach dem Vorbild der Funktionsweise des menschlichen Gehirns entworfen wurde. Es besteht aus vielen kleinen Einheiten, die Neuronen genannt werden und die schichtweise miteinander verbunden sind.
Cammarata forscht seit langem an der Interpretierbarkeit neuronaler Netze und war in früheren Jahren am Aufbau eines einflussreichen theoretischen Rahmens beteiligt.
In frühen visuellen Modellen reagierte dasselbe Neuron auf zwei Arten von Bildern: Gesichter von Katzen und Vorderseiten von Autos. Was genau erkannte es? Eine Katze? Ein Auto? Oder wurden zwei völlig unbedeutende Konzepte miteinander vermischt?
Cammarata glaubte damals ebenfalls, dass es im Inneren des Modells viele solcher verflochtenen Konzepte gibt.
Die Forscher haben dafür die Hypothese der „Überlagerung“ entwickelt. Die Erklärung lautet wie folgt: Das Modell muss so viele Konzepte ausdrücken, dass die Anzahl der verfügbaren Neuronen begrenzt ist. Daher muss das Netzwerk verschiedene Konzepte in denselben Darstellungsraum pressen. Ein Neuron trägt auf diese Weise mehrere scheinbar völlig unzusammenhängende Bedeutungen.
Um diese verflochtenen Konzepte zu entwirren, haben die Forscher speziell Werkzeuge wie Sparse Autoencoder entwickelt, um die neuronale Aktivität in klarere Einheiten zu zerlegen.
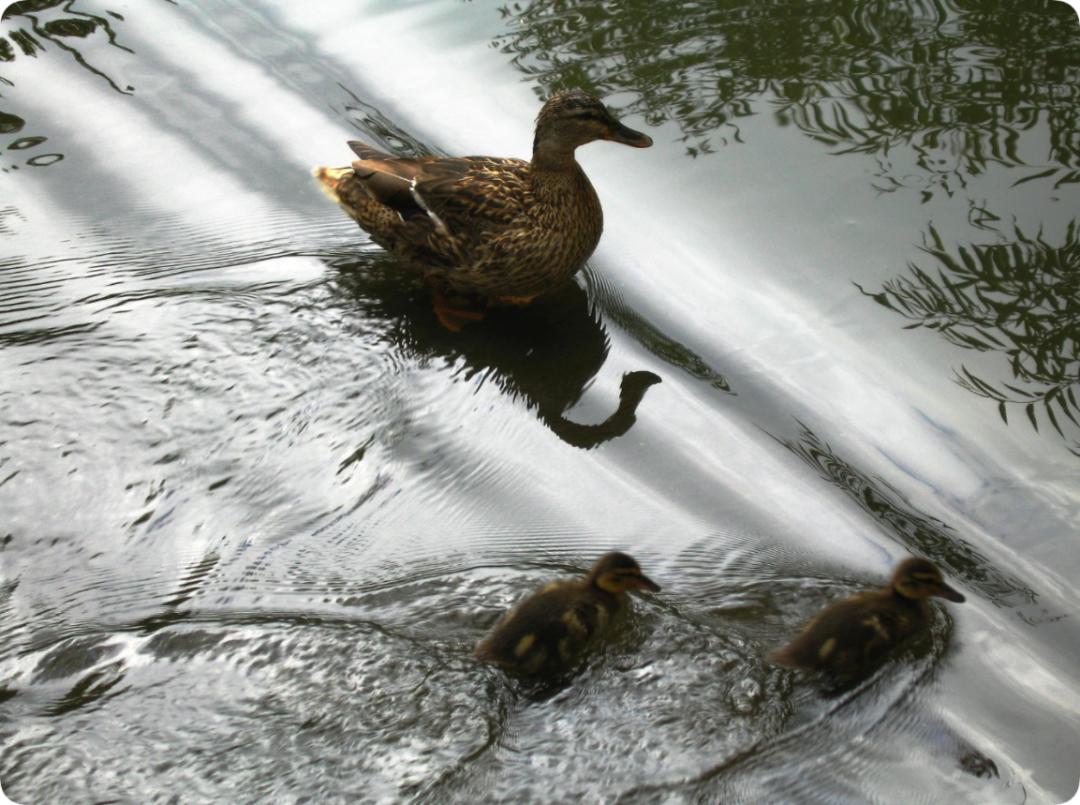
Die Überlagerung der fast ebenen Wellen (Diagonale), die aus der Ferne kommen, und der Wellen, die durch die Spur einer Ente erzeugt werden, erfüllen im Wasser nur annähernd eine lineare Beziehung
Cammarata ist jetzt der Ansicht, dass man damals möglicherweise zu viel nachgedacht hat.
Dieses Neuron erkennt möglicherweise eine V-förmige Struktur. Hinter dem Umriss eines Katzengesichts, der spitzen Winkel, den ein Auto von vorne bildet, der Zungenform einer Flamme und der Verzweigung eines Wasserstroms verbirgt sich dieselbe visuelle Regel. Objekte, die völlig unzusammenhängend erscheinen, teilen tatsächlich dasselbe geometrische Merkmal.
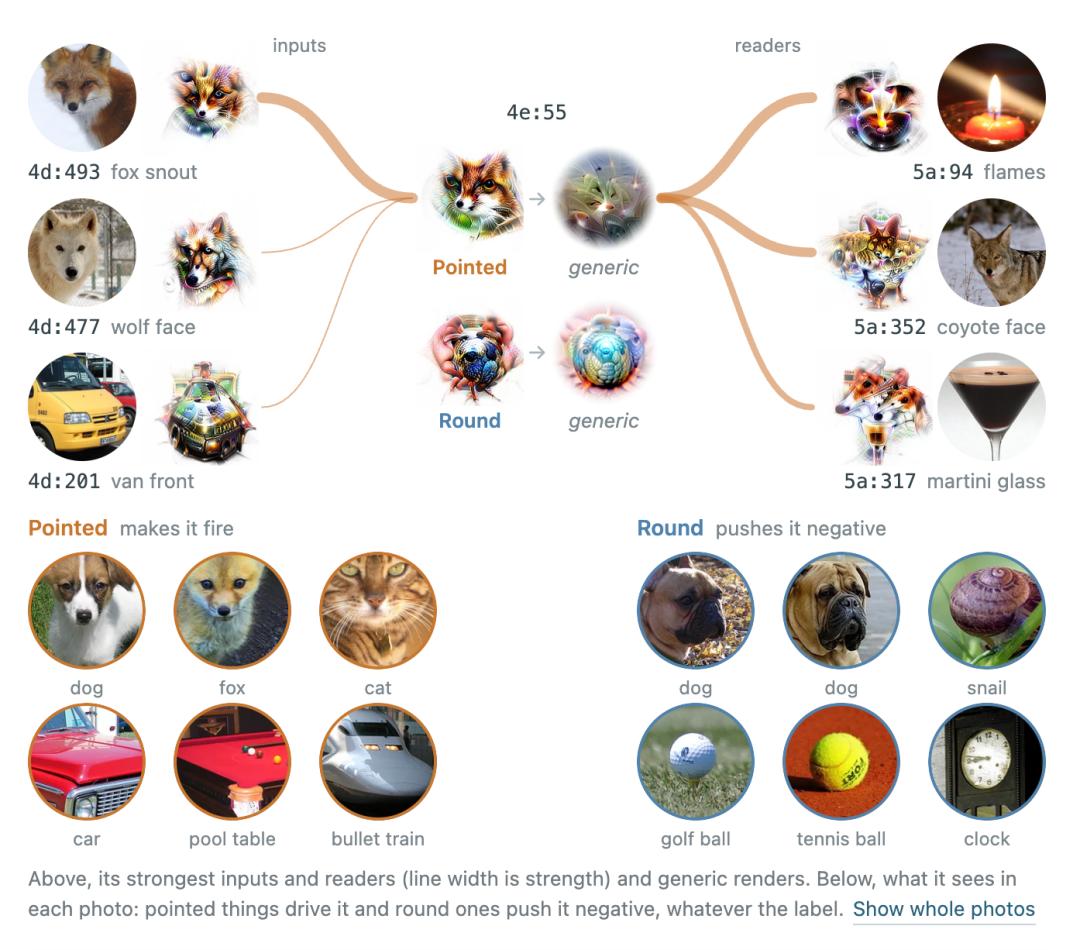
Ein weiterer Fall, der einst als Beweis für „Überlagerung“ galt, könnte auch eine einfachere Erklärung haben.
Die Forscher haben einmal festgestellt, dass das Merkmal zur Erkennung von Autos offenbar in einer Gruppe von Neuronen verborgen ist, die mit Hunden zusammenhängen. Nach einer erneuten Überprüfung gab Cammarata eine andere Erklärung an: Hunde und Autos teilen möglicherweise eine Regel in Bezug auf den Aufnahmewinkel – sie stehen auf Bildern oft in ähnlicher Haltung direkt vor der Kamera.
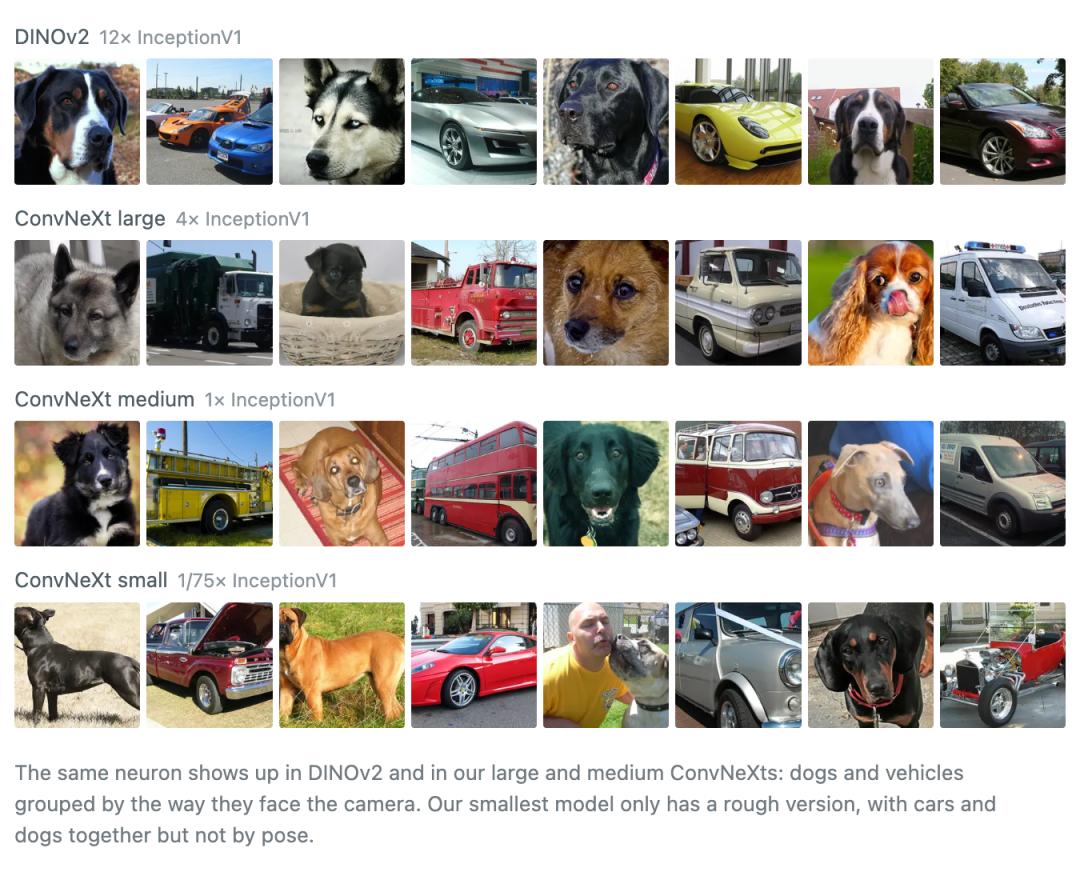
Wenn all diese klassischen Fälle eine andere Erklärung haben, ist das Innere neuronaler Netze wirklich so schwer zu verstehen?
Cammarata berichtet, dass nach der Verbesserung der Architektur und der Analysemethoden selbst ohne Erhöhung der Modellgröße oder der Trainingsdaten etwa 99 % bis 100 % der Neuronen in der letzten Schicht des frühen visuellen Modells InceptionV1 relativ klar erklärt werden können.
Er hat auch Modelle untersucht, deren Größenspanne etwa das 300-fache beträgt, und ist der Ansicht, dass diese Modelle in verschiedenen Maßstäben ein beträchtliches Maß an Lesbarkeit behalten.
Cammarata beschreibt eine weitere von ihm beobachtete Regel mit dem Begriff „rekursive Generalisierung“.
Ein Neuron kann während des Lernprozesses von einem engen Muster ausgehen und allmählich verwandte Zweige entwickeln, so wie ein Ast Seitenäste bildet.
Nehmen wir als Beispiel ein Sprachmodell: Ein Neuron, das ursprünglich die Buchstabenkombination „iy“ erkennt, reagiert später möglicherweise auf „diy“ und das semantisch verwandte „do it yourself“. Betrachtet man nur die Auslöseliste nach Abschluss des Modelltrainings, scheinen diese Reaktionen weit voneinander entfernt zu sein. Verfolgt man jedoch, wie sie sich während des Lernprozesses bilden, kann man einen kontinuierlichen Zusammenhangspfad finden.
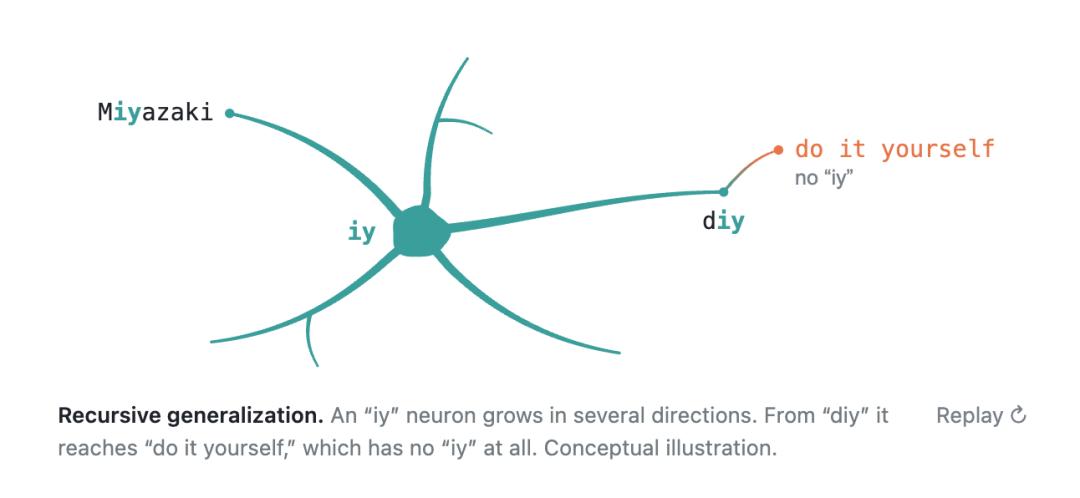
Nach Cammaratas Ansicht entstehen viele komplexe Phänomene durch die ständige Erweiterung, Kombination und Differenzierung gewöhnlicher Muster, nicht dadurch, dass Konzepte willkürlich in dasselbe Neuron gepresst werden.
Dieser Ansatz wurde bereits vorläufig validiert. In Qwen3-32B weisen etwa 90 % der Neuronen eine Hauptfunktion in ihrer positiven und negativen Antwortrichtung auf, etwa 7 % beziehen sich auf zwei verwandte Funktionen, und der noch nicht erklärte Teil beträgt etwa 2 % bis 4 %.
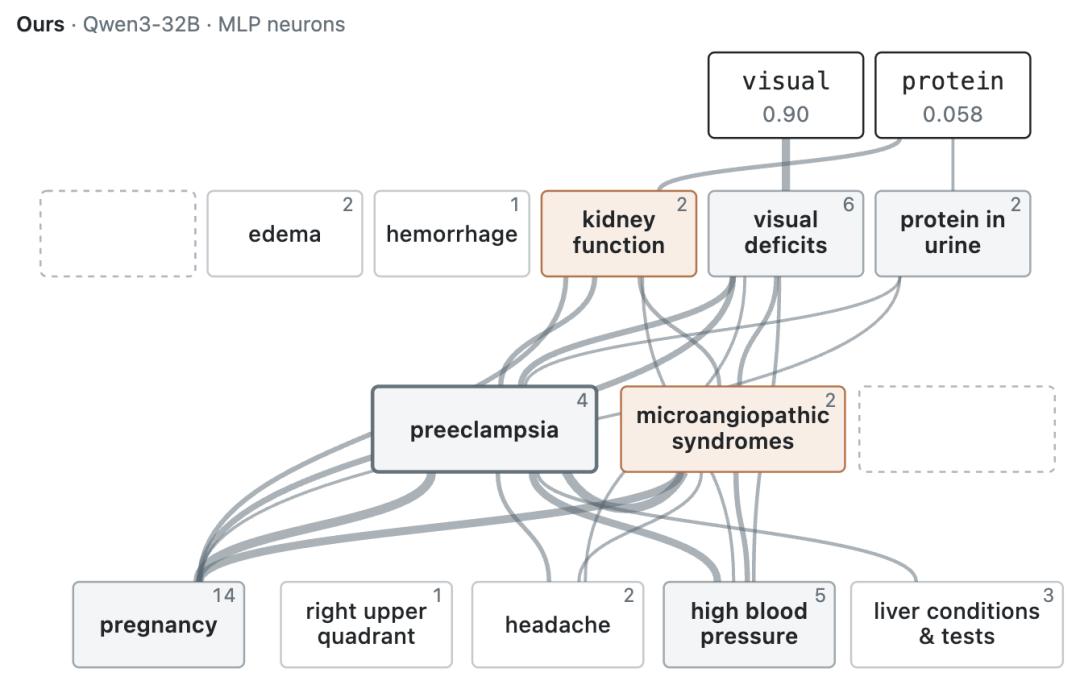
Je mehr Verständnis, desto mehr Sicherheit
Wenn der Informationsfluss im Inneren des Modells zuverlässig verfolgt werden kann, hat die Sicherheitsforschung die Chance, von der Beobachtung von Ergebnissen weiter zur Analyse von Mechanismen vorzudringen.
Die Forscher können versuchen, bestimmte Neuronen, Rechenschaltkreise und Informationsübertragungspfade im Modell zu identifizieren und dann durch Interventionsversuche beobachten, ob eine Änderung eines internen Mechanismus das Verhalten des Modells verändert.
Wenn eine Gruppe von Neuronen an einer Art von Schlussfolgerung beteiligt ist und ein Rechenschaltkreis mit einer bestimmten Beurteilung zusammenhängt, haben die Forscher die Chance, sie gezielter zu prüfen.
Im Vergleich zur Beurteilung, ob ein Modell sicher ist, nur anhand der endgültigen Antwort versucht diese Methode, die Sicherheitsbewertung auf den internen Prozess voranzutreiben, der das Verhalten erzeugt.
Aus diesem Grund ist Cammaratas Forschung so bemerkenswert.
Wenn die interne Struktur neuronaler Netze tatsächlich geordneter ist als früher angenommen, könnten die Kosten für ihr Verständnis sinken. Die Forscher können direkt die Mechanismen untersuchen, die das Modell bereits gebildet hat, verfolgen, wie diese Mechanismen zusammenwirken, und nach und nach eine vollständigere interne Karte erstellen.
Dennoch entsprechen die internen Mechanismen des Modells nicht den psychologischen Konzepten, die wir gewohnt sind. Ein Neuron, das mit Täuschung zusammenhängt, ist nicht unbedingt eine unabhängig existierende „Täuschungsabsicht“ im Inneren des Modells. Ein Merkmal, das eine Ablehnung der Antwort vorhersagen kann, reicht auch nicht unbedingt aus, um zu belegen, dass das Modell den Grund für die Ablehnung versteht.
Die Forscher müssen die Erklärung durch verschiedene Beweise validieren, sowohl die neuronale Aktivität beobachten als auch Interventionen, kontrafaktische Tests und erneute Überprüfungen über verschiedene Kontexte hinweg durchführen. Andernfalls könnte das sogenannte Verständnis immer noch nur eine statistische Korrelation mit einem plausibel klingenden Etikett versehen sein.
Bei der Sicherheitsarbeit haben die Modellbewertung, Red-Team-Tests, Zugriffskontrollen, Laufzeitüberwachung sowie Einschränkungen bei der Bereitstellung hochriskanter Fähigkeiten jeweils ihre eigene, nicht leicht ersetzbare Rolle. Das Verständnis der Forscher für das Modell hat immer Grenzen, und die Risiken in der Realität entstehen oft durch die Überlagerung mehrerer Glieder.
Das Endspiel der KI ist auch eine Regelung über die Machtverteilung
Wenn es um die langfristige Sicherheit von KI geht, haben die drei von Sam Altman kürzlich vorgeschlagenen möglichen Ausgänge das Problem auf eine größere institutionelle Ebene gelenkt.
Eine Möglichkeit besteht darin, eine internationale Organisation ähnlich der Internationalen Atomenergiebehörde zu gründen, die für die Festlegung und Durchsetzung von Sicherheitsstandards zuständig ist. Eine andere Möglichkeit besteht darin, alle KI-Labore in derselben Institution zusammenzuführen, um neue Technologien gemeinsam zu entwickeln und deren sichere Anwendung zu gewährleisten. Die dritte Möglichkeit besteht darin, dass ein KI-Entwickler genügend starke wirtschaftliche Stärke ansammelt, um die Rechenressourcen anderer Entwickler abzuschneiden und potenziell gefährliche Entwickler daran zu hindern, ihre Projekte weiter voranzutreiben.
Die Entwicklung der Nukleartechnik hat längst gezeigt, dass die Risiken bestimmter Technologien die Kontrollreich