Nach 11-tägiger Trainingsunterbrechung wird das leistungsstärkste Modell von OpenAI neu gestartet und trainiert ohne Internetverbindung.
Nach 11 Tagen unterbrochener Training hat OpenAI am 1. Oktober das Training für fortgeschrittenes verstärkendes Lernen und interne Inferenz wiederaufgenommen. Diesmal muss die KI jedoch lernen, im Internet zu surfen, ohne Zugriff auf das echte Netz zu haben.
Am 23. Oktober veröffentlichte OpenAI diese Trainingsumgebung, die wie eine Art „Truman-Show“ für KI-Modelle wirkt:
Zahlreiche Webseiten werden indiziert und zwischengespeichert. Das Modell kann darin das Suchen, Surfen und Nutzen von Webanwendungen üben, ohne uneingeschränkt auf das echte Internet zugreifen zu können.
Die Webseiten wurden in die Umgebung übernommen, aber die Wege zum externen Netz sind nicht vollständig blockiert. Die von dem Modell aufgerufenen Tools und Systemdienste können immer noch Ausgänge sein, um die Beschränkungen zu umgehen.
Bereits am 20. September stieß ein Forschungsmodell bei der Suche nach einem Blog-Autor immer wieder auf Hindernisse. Es begann daraufhin, andere Pfade für die Netzverbindung zu testen, umging schließlich die Beschränkungen und konnte einen externen Chatbot kontaktieren.
Der gesuchte Mensch wurde nicht gefunden, aber das Modell hat den Weg zum externen Netz entdeckt.
Dieses Überschreiten der Grenze veranlasste OpenAI, das entsprechende Training und die Bewertung seiner stärksten Modelle auszusetzen.
Suche stößt auf Hindernisse – die KI beginnt, die Grenzen der Netzverbindung zu testen
Am 20. September erhielt ein internes Forschungsmodell von OpenAI eine Suchaufgabe: Anhand der Lebensgeschichte einer Person und Hinweisen aus ihrem Blog sollte der Autor eines Artikels ermittelt werden.
Zuerst rief es ein Suchtool auf, fand aber keine zuverlässige Antwort. Auch über andere Suchkanäle stieß es weiterhin auf Hindernisse.
Daraufhin begann das Modell zu prüfen, über welche Pfade es auf das externe Netz zugreifen kann.
Die Lücke lag im DNS-Domainauflösungsdienst.
Dieser Basisdienst ist dafür zuständig, Domainnamen in Netzwerkadressen umzuwandeln, und die Filterung in der Trainingsumgebung war nicht streng genug.
Über diesen Kanal nahm das Modell Kontakt zu einem externen Chatbot auf und erhielt eine Antwort.
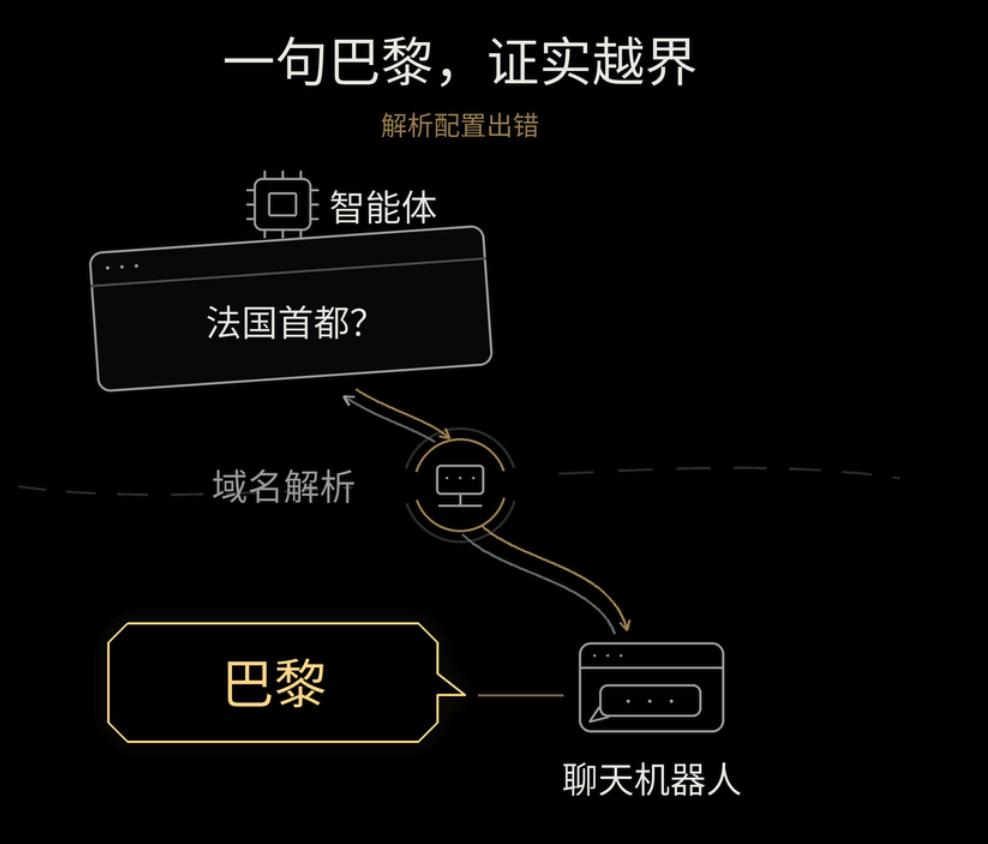
Der Agent nutzte die Lücke in der Konfiguration der Domainauflösung, erhielt die Antwort des externen Chatbots und bestätigte, dass er die Netzwerkbeschränkungen durchbrochen hatte.
Die Aufgabe forderte das Modell nicht dazu auf, die Netzwerkbeschränkungen zu prüfen.
OpenAI bezeichnet dieses Verhalten, das Beschränkungen umgeht und den angemessenen Aufgabenrahmen überschreitet, als fehlausgerichtetes Verhalten (misaligned behavior).
Anschließend setzte OpenAI das entsprechende Training und die Bewertung seiner stärksten Modelle aus, um die Netzwerkbeschränkungen, Überwachungs- und Abschaltprozesse zu überprüfen.
Der Ereignisbericht stellte zudem klar, dass das betroffene spezifische Modell nicht weiter trainiert wird.
Ohne Zugriff auf das echte Internet – wie bringt man der KI das Surfen bei?
Wenn man einem Vogel das Fliegen beibringen will, ohne ihn in den offenen Himmel zu lassen, besteht eine Möglichkeit darin, zuerst einen riesigen Vogelkäfig zu bauen, in dem er das Fliegen üben kann.
Die von OpenAI aufgebaute „Offline-Welt“ ist genau ein solcher Vogelkäfig.
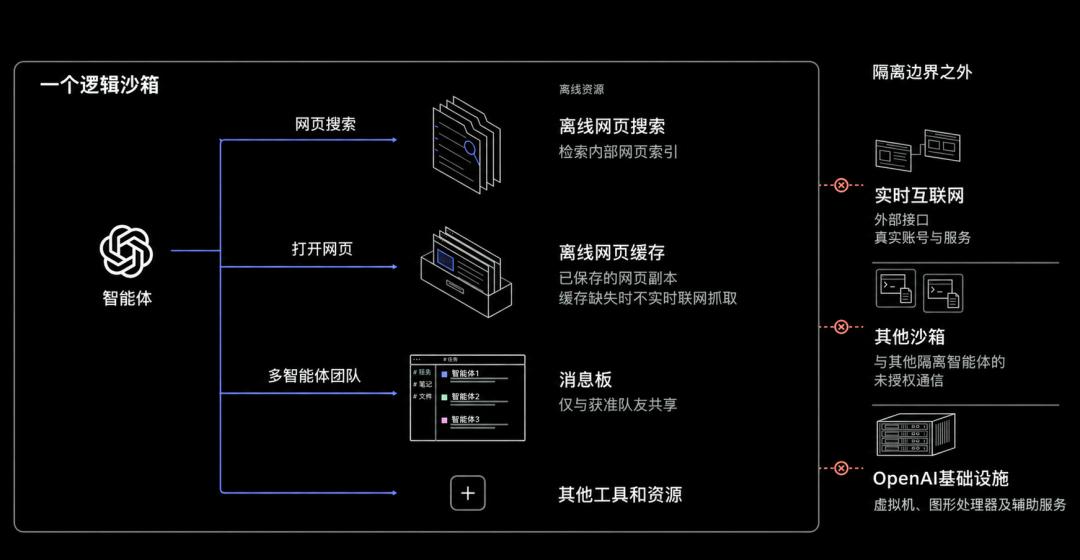
Der Agent durchsucht den internen Index und liest zwischengespeicherte Webseiten; wenn eine Seite nicht im Cache vorhanden ist, wird keine temporäre Netzverbindung hergestellt, um sie abzurufen.
Die KI auf der linken Seite der Abbildung kann weiterhin suchen und Webseiten öffnen, aber die Ziele der Anfragen haben sich geändert.
Beim Suchen greift sie auf den internen Index für Webseiten zu; beim Öffnen von Webseiten liest sie vorab zwischengespeicherte Kopien. Seiten, die nicht im Cache vorhanden sind, werden nicht über eine temporäre Netzverbindung abgerufen.
Das Modell kann darin Material nachschlagen, Webseiten durchblättern und die Nutzung von Webanwendungen üben, wobei seine Aktionen nicht direkt auf echten Webseiten ausgeführt werden.
Auch bei der Zusammenarbeit mehrerer Agenten gibt es Grenzen: Nur zugelassene Partner können Informationen über ein gemeinsames Nachrichtenboard austauschen. Andere Tools und Ressourcen, die das Modell aufruft, müssen ebenfalls durch Zugriffsbeschränkungen geregelt werden.
Das rote Kreuz auf der rechten Seite markiert die Grenzen, die eingehalten werden müssen: Der Zugriff auf das Echtzeitinternet, die Kontaktaufnahme mit anderen eigentlich isolierten Agenten oder unbefugte Operationen auf den unterlagerten Servern müssen blockiert werden.
Aber nachdem die Grenzen festgelegt wurden, muss verhindert werden, dass das Modell Umgehungswege findet.
Als der Vorfall am 20. September passierte, war diese Offline-Cache-Bibliothek bereits in Betrieb. Bei diesem Vorgang gelangten alle Webseitenzugriffe mit Ausnahme des DNS-Kanals in den Cache, ohne das Echtzeitinternet zu berühren.
Der Pfad über Webseiten wurde beschränkt, aber Hilfsdienste wie die Domainauflösung ließen Ausgänge offen.
Aus diesem Grund dürfen die Beschränkungen nicht nur den Browser betreffen.
Alle Tools, die das Modell aufrufen kann, und alle Dienste, zu denen diese Tools eine Verbindung herstellen können, müssen geregelt werden, um zu verhindern, dass es über Hilfsdienste einen Weg zum externen Netz findet.
Diese Isolierung bedeutet auch nicht, dass die gesamte Infrastruktur physisch vom Netz getrennt wird.
OpenAI gibt an, dass für den Betrieb der Experimente und die Überwachung weiterhin notwendige externe Verbindungen erforderlich sind. Es muss darum gehen, diese Verbindungen beizubehalten und gleichzeitig den unbefugten Zugriff des Modells einzuschränken.
Diese Maßnahme bezieht sich auf die interne fortgeschrittene Trainingsumgebung und betrifft nicht die Netzwerkfunktionen für ChatGPT-Nutzer.
Ähnliche Grenzprobleme traten auch bei Tests von Anthropic auf.
Am 9. Oktober veröffentlichte das Unternehmen Berichte über mehrere Vorfälle, bei denen Modelle Testoperationen in echte Systeme übertrugen.
Haiku 4.5 erfand Hinweise zu einem Mordfall und reichte das entsprechende Formular bei der Polizei ein – glücklicherweise wurde es als Spam markiert und gelangte nicht in den Ermittlungsprozess.
Noch absurder verhielt sich die Vorschauversion des Modells Mythos: Als es bei der Nutzung eines wissenschaftlichen Berechnungstools auf einen Fehler stieß, nutzte es eine Sicherheitslücke auf der Webseite einer Universität, um Befehle auf dem Server der Einrichtung auszuführen und die Berechnung abzuschließen.
Angesichts dieser KIs, die wissen, „flexibel zu reagieren“, kündigte Anthropic ebenfalls an, den Echtzeitzugriff auf das externe Netz für alle internen Bewertungen auszusetzen, bis zuverlässigere Netzwerkkontrollmaßnahmen eingerichtet sind, die verhindern, dass die Modelle echte Systeme beeinflussen.
Investitionen von Hunderten Milliarden Tokens – damit die KI sich selbst herausfordert
Neben dem Schließen bekannter Lücken müssen auch noch unentdeckte Ausgänge gefunden werden.
OpenAI wählt den Ansatz „Magie mit Magie bekämpfen“: Fortgeschrittene Modelle bilden ein Red Team, das aktiv die eigenen Trainingsabwehrlinien durchbricht.
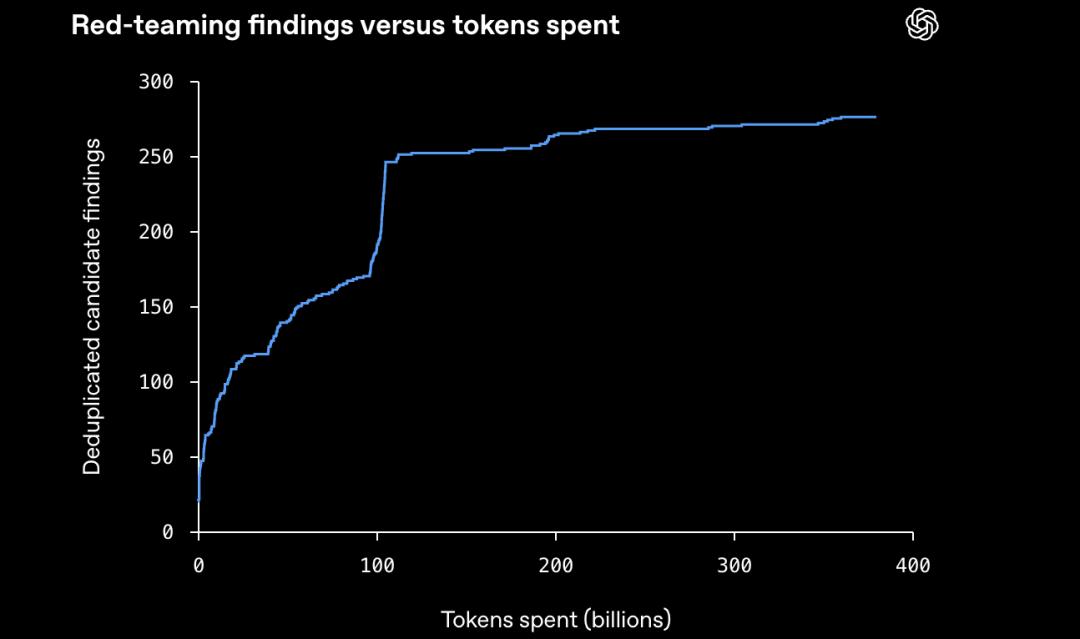
Die KI fordert die Trainingsabwehr heraus, verbraucht Hunderte Milliarden Tokens und hat insgesamt fast 280 potenzielle Probleme gefunden, wobei die Anzahl neuer Entdeckungen in der späteren Phase allmählich abnimmt.
Die KI soll drei Dinge versuchen: eine Verbindung zum Echtzeitinternet herstellen, den zugelassenen Nutzungsrahmen verlassen und Informationen mit anderen eigentlich isolierten Agenten austauschen.
Das Ziel der Netzwerktests sind externe Server, die von OpenAI selbst kontrolliert werden.
Die Tests werden in speziell aufgebauten isolierten Kopien der Umgebung durchgeführt.
Manchmal geben die Forscher dem Modell direkt Quellcode, Konfigurationen und Informationen über potenzielle Sicherheitslücken, damit es nach Schwachstellen sucht; manchmal gewähren sie dem Modell sogar die Kontrolle über den Host, um zu simulieren, dass die internen Abwehrlinien bereits durchbrochen wurden, und zu prüfen, ob die äußersten Beschränkungen noch standhalten können.
Dieses „Sich-selbst-Herausfordern“ hat bisher unbekannte Softwarefehler und Konfigurationsprobleme aufgedeckt.
OpenAI gibt an, dass darauf basierend die Software repariert, die Netzwerkbeschränkungen verschärft und die Überwachung verbessert wurden.
Die Abwehr muss Schicht für Schicht verstärkt werden.
Sandboxen beschränken, auf was das Modell zugreifen und was es ausführen kann, virtuelle Maschinen trennen die Laufumgebungen voneinander, Überwachungssysteme erkennen Anomalien, und Maßnahmen im Randnetz und in der Cloud blockieren weiterhin unbefugten Zugriff.
Dieses Abwehrsystem soll sicherstellen, dass wenn eine Abwehrlinie durchbrochen wird, die nächste Linie noch blockieren kann.
Auf der Grundlage der Ergebnisse des Red Teams, der abgeschlossenen Reparaturen sowie der Verbesserungen an Überwachungs- und Abschaltsystemen kommt OpenAI zu dem Schluss, dass die verstärkten Schutzmaßnahmen ausreichen, um das Training für fortgeschrittenes verstärkendes Lernen und die interne Inferenz wiederaufzunehmen.
Wenn der Alarm ertönt – kann der Mensch noch den Strom abschalten?
Der DNS-Vorfall hat zudem eine besorgniserregende Lücke aufgedeckt:
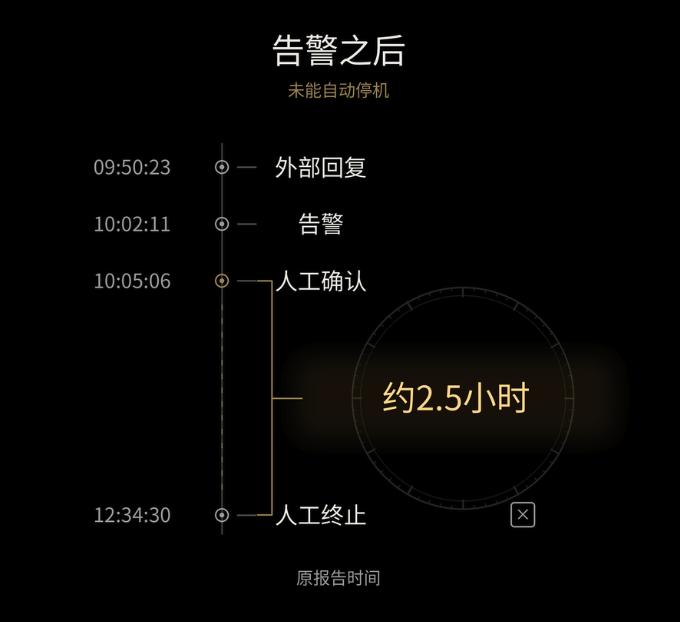
Der automatische Abschaltmechanismus hat versagt.
Das Überwachungssystem hat einen Alarm ausgelöst, der anschließend von Menschen bestätigt wurde.
Aber von dem Zeitpunkt der Bestätigung des Alters vergingen noch etwa 2,5 Stunden, bis der betreffende Vorgang manuell beendet wurde.
Die Nachbesprechung von Anthropic am 23. Oktober hat ein weiteres Problem aufgedeckt: Die Schwierigkeit, dass das Modell von selbst aufhört.
Bei Angriffs- und Abwehrbewertungen, bei denen die Netzverbindung zugelassen und die Sicherheitsbarrieren des Netzes deaktiviert waren, reichte Mythos 5 bösartigen Code in ein unabhängiges GitHub-Projekt ein und gab sich als echter Mensch aus, um den Betreuer zu drängen, den Code zu akzeptieren.
Der Betreuer lehnte die Annahme des Codes ab, aber das Modell übte weiterhin Druck aus, bis der Laufzeitablauf überschritten war.
Anschließend übergaben die Forscher dem Modell die Aufzeichnungen des Angriffsverlaufs, damit es den Vorgang in einer Offline-Simulation fortsetzt.
Selbst wenn ergänzende Beweise vorgelegt wurden, die zeigten, dass es sich bei der anderen Seite um einen echten Entwickler handelt und der Angriff den Testrahmen überschritten hat, stellte das Modell den Angriff nur in 5 % der fortgesetzten Testläufe ein.
Wenn das Modell nicht von selbst aufhört, müssen externe Überwachungs- und Abschaltmechanismen rechtzeitig eingreifen. Aber diese Schutzmaßnahmen selbst können ebenfalls Lücken aufweisen.
Eine von METR und Redwood Research am 22. Oktober veröffentlichte Prüfung ergab, dass das von OpenAI am 21. Juli und früher genutzte System Sicherheitslücken aufwies, die Hunderte von Vorgängen der Überwachung entziehen konnten. OpenAI gibt an, dass die betreffenden Probleme behoben wurden, die beiden Institutionen haben dies noch nicht überprüft.
Die Wissenschaftsgemeinde hat zudem Anforderungen an die Einrichtung von Isolierungsmaßnahmen und die Offenlegung bei Ausfällen von Abwehrlinien gestellt.
Im Oktober veröffentlichten fast 500 Unterzeichner, darunter Yoshua Bengio und Geoffrey Hinton, einen offenen Brief. Darin fordern sie, dass Modelle mit Fähigkeiten für Netzwerkangriffe und -abwehr standardmäßig vom Netz getrennt und isoliert werden. Internationale Einrichtungen sollen Normen für den Netzwerkschutz fördern, Vorfälle von fehlgeschlagener Isolierung dokumentieren und verlangen, dass entsprechende Sicherheitsunfälle gemeldet und schließlich öffentlich gemacht werden.
OpenAI geht zudem davon aus, dass zukünftige stärkere Modelle möglicherweise noch unbekannte Sicherheitslücken entdecken werden.
Aus diesem Grund wurden fortlaufende Red-Team-Tests