Tang Jies unter seinem Namen veröffentlichtes wissenschaftliches Papier enthüllt ein internes multimodales Modell – ist die nächste Generation von GLM zum Greifen nah?
Nach dem beeindruckenden Debüt von GLM-5.3 und GLM-5.3-Flash (obwohl beide Modelle zur gleichen Serie gehören, verwenden sie unterschiedliche Basismodelle für das Training) hat Zhipu AI kontinuierlich Fähigkeiten des Modells wie Codierung und langfristige Agenten verbessert. Wie die nächste Generation von GLM genau aktualisiert wird, ist jedoch nach wie vor ein wichtiger Schwerpunkt der Aufmerksamkeit aller.
Neben stärkerer Schlussfolgerungsfähigkeit und niedrigeren Kosten gibt es einen weiteren bemerkenswerten Trend: natives Multimodalität.
Kürzlich haben Forscher der Tsinghua-Universität und von Zhipu AI gemeinsam auf arXiv das Papier „Can Visual Generation Expand What Unified Multimodal Models Know?“ veröffentlicht. Der korrespondierende Autor ist Tang Jie, Chefwissenschaftler von Zhipu AI und Professor an der Tsinghua-Universität.
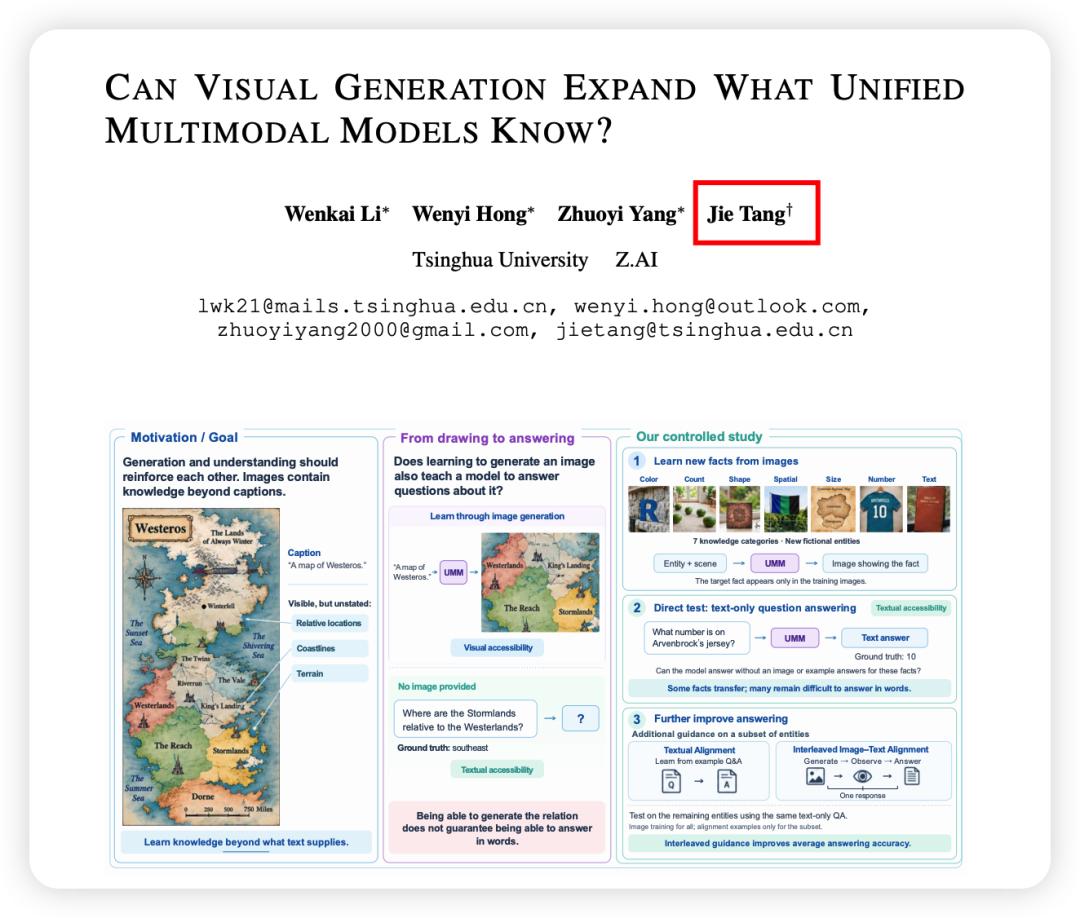
Das Papier stellt ein bisher nicht veröffentlichtes internes Modell von Zhipu AI namens GLM-Omni vor und versucht, eine etwas kontraintuitive Frage zu beantworten: Können die Kenntnisse, die das Modell durch die Bildgenerierung erlernt, in sprachliche Schlussfolgerungsfähigkeiten umgewandelt werden?
In Experimenten erreichte GLM-Omni bei numerischen Aufgaben einen Anteil von 72 %, der die angegebene Trikotnummer korrekt zeichnen konnte, aber wenn kein Bild bereitgestellt und nur die gleiche Nummer mit Text abgefragt wurde, lag die Korrektrate nur bei 2 %.
Anschließend passten die Forscher die Trainingsmethode an, sodass das Modell die Generierung von Bildern, die Beobachtung von Bildern und die Textantwort in dieselbe Trainingssequenz einbezieht. Die durchschnittliche Genauigkeit des Modells bei Text-Frage-Antwort-Aufgaben stieg von 12,57 % auf 26,86 %. Auf dieser Grundlage konnte die Genauigkeit weiter auf 41,14 % verbessert werden, indem dem Modell erlaubt wurde, vor der Beantwortung von Fragen zuerst ein Bild zu generieren und dann das Bild zur Beantwortung zu beobachten.
Diese Studie ist kein direkter Beweis dafür, dass die nächste Generation von GLM eine bestimmte Architektur übernehmen wird, aber sie liefert einen verfolgenswerten Forschungs- und Entwicklungs Hinweis: Nachdem Zhipu AI bereits natives multimodales Verständnis auf GLM-5.3-Flash realisiert hat, erforschen die Forscher noch, wie eine engere Verbindung zwischen visueller Generierung und sprachlicher Schlussfolgerung hergestellt werden kann.
Zhipu AI braucht nur noch dich
Um die Bedeutung dieses Papiers zu verstehen, muss zuerst ein Konzept geklärt werden: Natives Multimodalität bedeutet nicht, dass das Modell selbst Bilder generieren kann.
Im August dieses Jahres hat Zhipu AI GLM-5.3-Flash auf den Markt gebracht und es als das erste native multimodale Modell der GLM-5-Serie bezeichnet. Es verwendet einen neuartigen vortrainierten Basiskörper, unterstützt multimodale Eingaben wie Bilder und Videos, kann im Arbeitsablauf des Codierungsagenten Schnittstellen verstehen und Renderergebnisse beobachten und den Code gemäß dem Interaktionsfeedback weiter modifizieren.
Aus der Sicht der öffentlichen Modellschnittstelle ist die Hauptausgabe von GLM-5.3-Flash jedoch immer noch Text. Dass es visuelle Informationen verstehen kann, bedeutet nicht, dass es bereits in der Lage ist, Bilder nativ im selben Modell zu generieren.
Dies ist auch eine wichtige technische Trennlinie bei aktuellen multimodalen Modellen.
Eine Art von Modellen löst hauptsächlich das einheitliche Verständnis verschiedener Informationen und ermöglicht es dem Modell, Eingaben wie Text, Bilder und Videos gleichzeitig zu verarbeiten;
Eine andere Art von Modellen versucht weitergehend, Verständnis und Generierung zu vereinheitlichen, sodass dasselbe Modell sowohl visuelle Inhalte verstehen als auch Bilder direkt generieren kann, und den Wissensaustausch zwischen den beiden Fähigkeiten erforscht.
Das Problem, vor dem die letztere Art von Modellen steht, besteht nicht nur darin, Bilder gut zu zeichnen, sondern auch darin, ob die Kenntnisse, die das Modell aus Generierungsaufgaben erlernt, von anderen Aufgaben aufgerufen werden können.
Als Tang Jie zuvor über natives Multimodalität sprach, konzentrierte er sich nicht nur darauf, eine Eingabe- oder Ausgabefähigkeit hinzuzufügen. Seiner Meinung nach ist die einheitliche Wahrnehmung von Informationen wie Sehen, Ton und sogar Tastsinn eine wichtige Grundlage dafür, dass das Modell die Umgebung weiter verstehen und langfristige Aufgaben ausführen kann.
Für Agenten, die die Umgebung kontinuierlich beobachten und ihre Handlungen gemäß Feedback anpassen müssen, ist Multimodalität nicht nur eine Funktionserweiterung, sondern hängt auch davon ab, ob das Modell wirklich in komplexe reale Aufgaben eintreten kann.
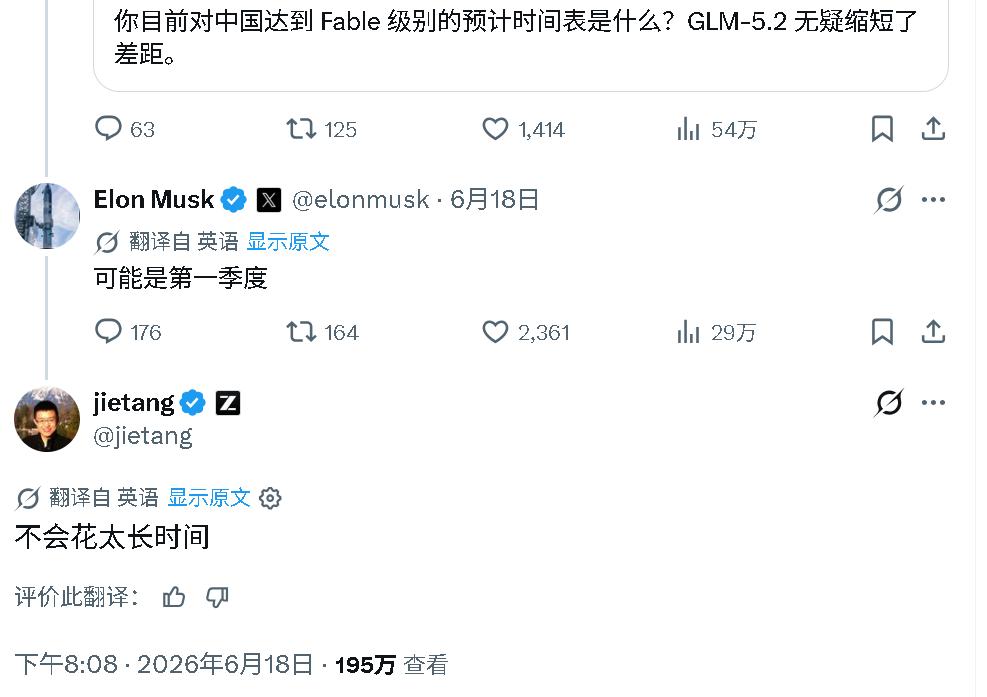
Im Juni dieses Jahres fragte ein Netznutzer auf X Elon Musk: Wann erreichen chinesische Modelle das Niveau von Fable? Elon Musk antwortete, es könnte im ersten Quartal sein. Tang Jie antwortete: Es wird nicht lange dauern.
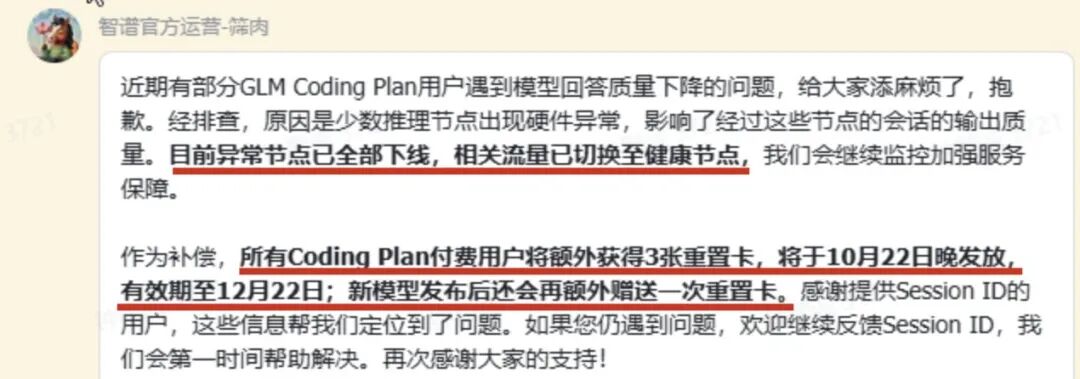
Am Abend des 21. Oktober sandte der offizielle Betrieb den Nutzern des Programmierpakets eine Benachrichtigung über die Entschädigung. Am Ende der Benachrichtigung stand noch ein Satz: „Nach der Veröffentlichung des neuen Modells wird eine zusätzliche Rücksetzungskarte verschenkt“, was gleichbedeutend mit einer Vorankündigung ist, dass die Aktualisierung kurz bevorsteht.
Versteckte Fähigkeiten der multimodalen Ausgabe
Der korrespondierende Autor des Papiers, Tang Jie, ist Chefwissenschaftler von Zhipu AI. Drei gemeinsame Erstautoren, Li Wenkai, Hong Wenyi und Yang Zhuoyi, haben diese Forschung während ihres Praktikums bei Zhipu AI abgeschlossen.
Das Modell GLM-Omni basiert auf dem quelloffenen GLM-4.1V-Thinking von Zhipu AI mit einem Parameterumfang von 9B und gehört zu den kleineren Testmodellen. Das Forschungsteam schlug eine Testmethode namens Knowledge Transfer Probing (KTP) vor, deren Kern darin besteht, zwei Dinge zu unterscheiden:
Hat das Modell beim Generieren von Bildern ein bestimmtes Wissen erlernt;
Kann es dieses Wissen durch Sprache ausdrücken.
Dies ist auch ein potenzieller Wert, der bei einheitlichen multimodalen Modellen erforscht werden kann. Es kann nicht nur das Modell ermöglichen, gleichzeitig Bilder anzusehen und zu zeichnen, sondern auch dazu führen, dass Kenntnisse, die durch verschiedene Modalitäten erlernt werden, sich gegenseitig ergänzen, anstatt unabhängig voneinander zu arbeiten.
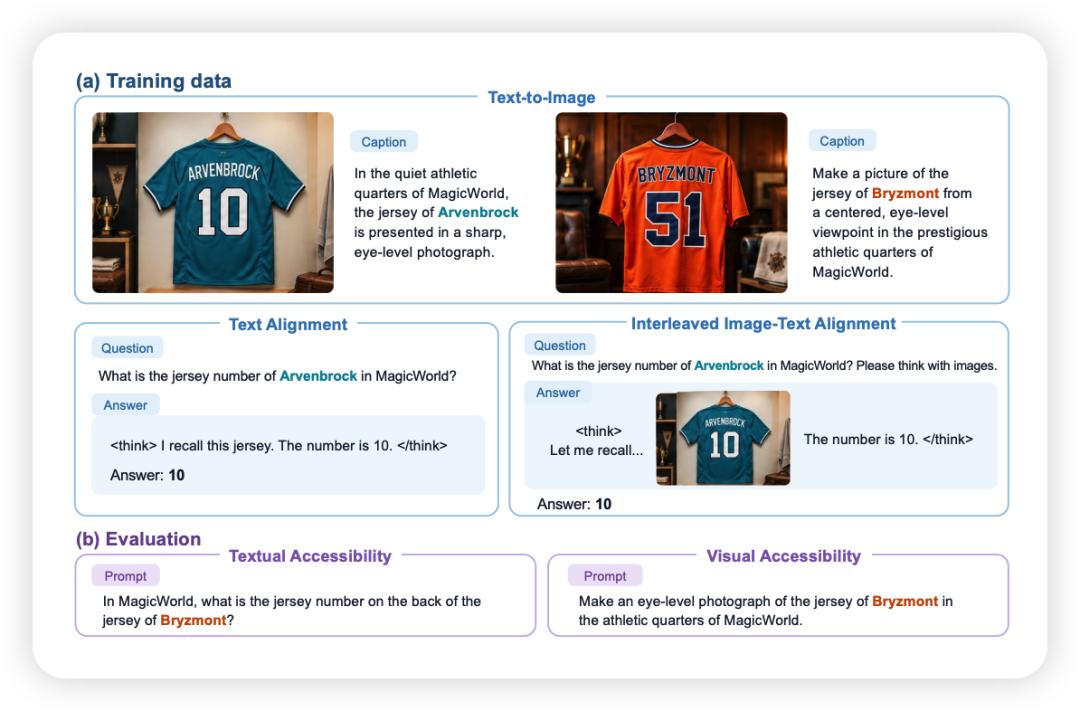
Um dies zu überprüfen, haben die Forscher eine fiktive Welt namens MagicWorld aufgebaut, in der Entitäten wie Mannschaften, Personen und Abzeichen nicht existieren. Zum Beispiel hat eine fiktive Mannschaft die Trikotnummer 10. Beim Training wurde das Modell nur dazu gebracht, Bilder von Trikots mit der Nummer 10 zu generieren, und die Zahl wurde in den Textaufforderungen nicht bereitgestellt.
Der Datensatz umfasst 7 Arten von Kenntnissen wie Farbe, Menge, Zahl, Form und räumliche Position mit insgesamt 350 Einträgen und wurde auf 8552 Gruppen von Bildtrainingsmustern erweitert. Auf diese Weise kann die Möglichkeit weitgehend ausgeschlossen werden, dass das Modell Fragen anhand vorhandener Textgedächtnisse beantwortet.
An dem Test nahmen nicht nur das interne GLM-Omni von Zhipu AI, sondern auch BAGEL von ByteDance und SenseNova-U1 von SenseTime teil. Die drei Modelle verwenden unterschiedliche visuelle Generierungsarchitekturen. Die Forscher überprüften jeweils, ob sie die Zielattribute korrekt zeichnen können und ob sie mit Text ohne Bildunterstützung antworten können.
Im ersten Experiment wurde ein deutliches Phänomen „können zeichnen, aber nicht sprechen“ festgestellt.
Die durchschnittliche Korrektheitsrate der Bildgenerierung von GLM-Omni erreichte 54 %, aber die Genauigkeit bei der direkten Beantwortung desselben Wissens mit Text betrug nur 14,57 %. Darunter lag die Bildkorrektheitsrate bei numerischen Aufgaben bei 72 %, aber die Korrektheitsrate bei Text-Frage-Antwort-Aufgaben nur bei 2 %. Bei den numerischen Aufgaben von SenseNova-U1 war der Unterschied noch größer, nämlich 88 % bzw. 0 %.
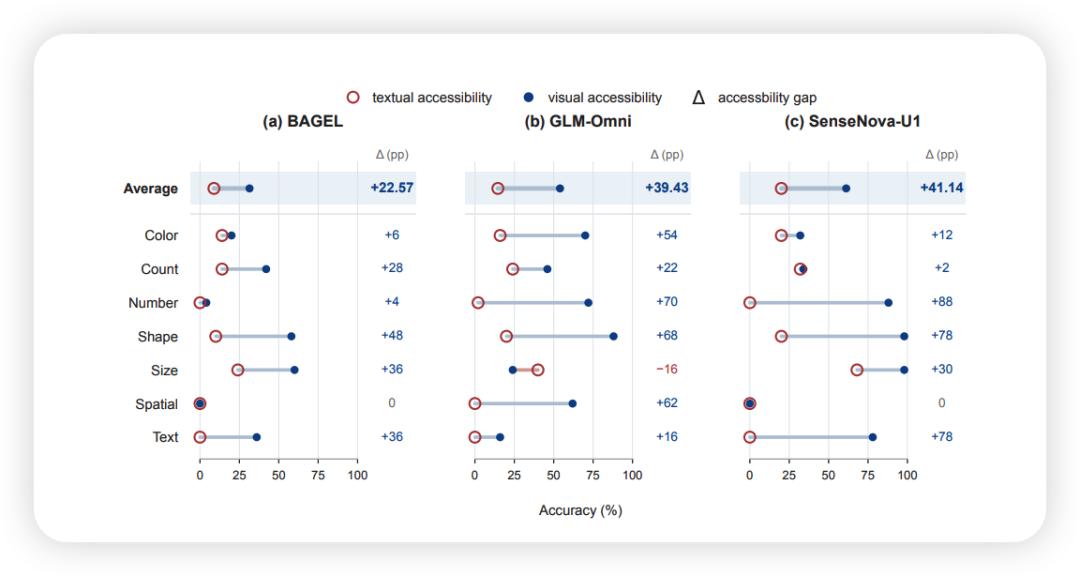
Dies bedeutet, dass das Modell bestimmte Kenntnisse während des Bildgenerierungsprozesses reproduzieren kann, aber es schwierig ist, sie direkt durch Sprache aufzurufen. Mit anderen Worten: Die Einbeziehung von visueller Generierung und Sprachverständnis in dasselbe Modell bedeutet nicht, dass die Kenntnisse, die die beiden Fähigkeiten beherrschen, automatisch austauschbar sind.
Wo liegt also genau das Problem? Die Forscher probierten als Nächstes zwei verschiedene Trainingsmethoden aus.
Die erste Methode ist die Textausrichtung: Einige fiktive Entitäten werden um Text-Frage-Antworten ergänzt, sodass das Modell lernt, relevante Fragen zu beantworten, und dann getestet wird, ob es die Fähigkeit auf Entitäten übertragen kann, die es noch nie mit Textantworten gesehen hat.
Aber der Effekt war nicht stabil. Die durchschnittliche Textkorrektheitsrate von GLM-Omni sank sogar von 14,57 % auf 12,57 %. Dies zeigt, dass die einfache Erhöhung von Text-Frage-Antworten nicht ausreicht, um visuelles Wissen stabil in sprachliche Fähigkeiten umzuwandeln.
Die zweite Methode ist interessanter und heißt Interleaved Image–Text Alignment.
Die Forscher behandelten die Generierung von Bildern und die Beantwortung von Fragen nicht mehr als zwei unabhängige Aufgaben, sondern fügten sie in dieselbe Trainingssequenz ein. Wenn das Modell beispielsweise mit der Frage nach der Trikotnummer konfrontiert wird, generiert es zuerst das zugehörige Bild, beobachtet dann das Bild und gibt schließlich die Textantwort aus.
Infolgedessen stieg die durchschnittliche Korrektheitsrate von GLM-Omni im Text-Test, bei dem das temporäre Zeichnen von Bildern nicht erlaubt war, von 12,57 % auf 26,86 %.
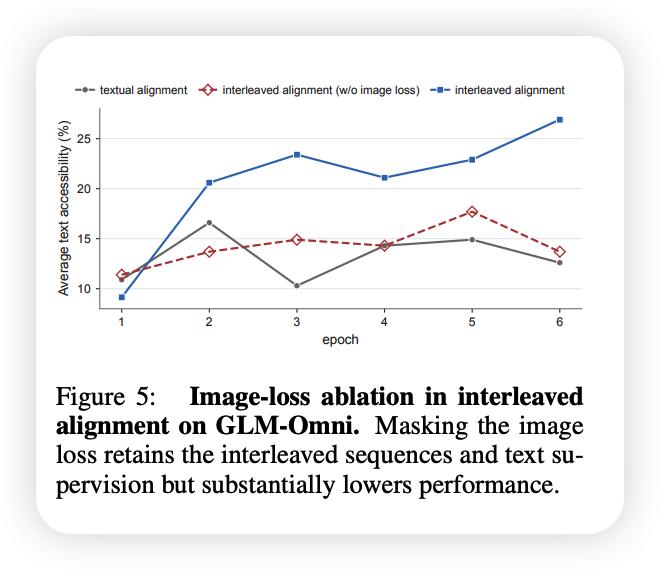
Um sicherzustellen, dass die Verbesserung von der Bildgenerierung stammt, führten die Forscher auch eine Gruppe von Kontrollexperimenten durch: Sie behielten die gleichen Trainingsmuster und Textüberwachung bei und entfernten nur das Verlustsignal des Bildgenerierungsteils im interleavierten Training. Infolgedessen sank die Genauigkeit wieder auf 13,71 %.
Dies führt zu der ersten wichtigen Schlussfolgerung des Papiers:
1) Der Wissensaustausch im einheitlichen Modell hängt nicht nur davon ab, ob die Architektur einheitlich ist, sondern auch davon, ob die Trainingssignale verschiedener Aufgaben effektiv verbunden werden können.
2) Die Bildgenerierung liefert nicht nur eine Ausgabefunktion, sondern kann selbst dem Modell helfen, Wissensverbindungen aufzubauen, die von anderen Aufgaben genutzt werden können.
Aber selbst nach dem gemeinsamen Training gibt es noch eine große Menge an visuellem Wissen, das das Modell nicht direkt in Text ausdrücken kann. Die Forscher wechselten daher den Gedanken: Da das Modell die Antwort zeichnen kann, warum lassen wir es nicht beim Beantworten von Fragen zuerst den zugehörigen Inhalt zeichnen?
Dies ist die Visual Chain-of-Thought,