Überraschenderweise liegt die GPU-Auslastung von 79 % der Unternehmen sogar unter der Hälfte.
Das Wettrüsten um KI hat mittlerweile einen fast schon surrealen Zustand erreicht...
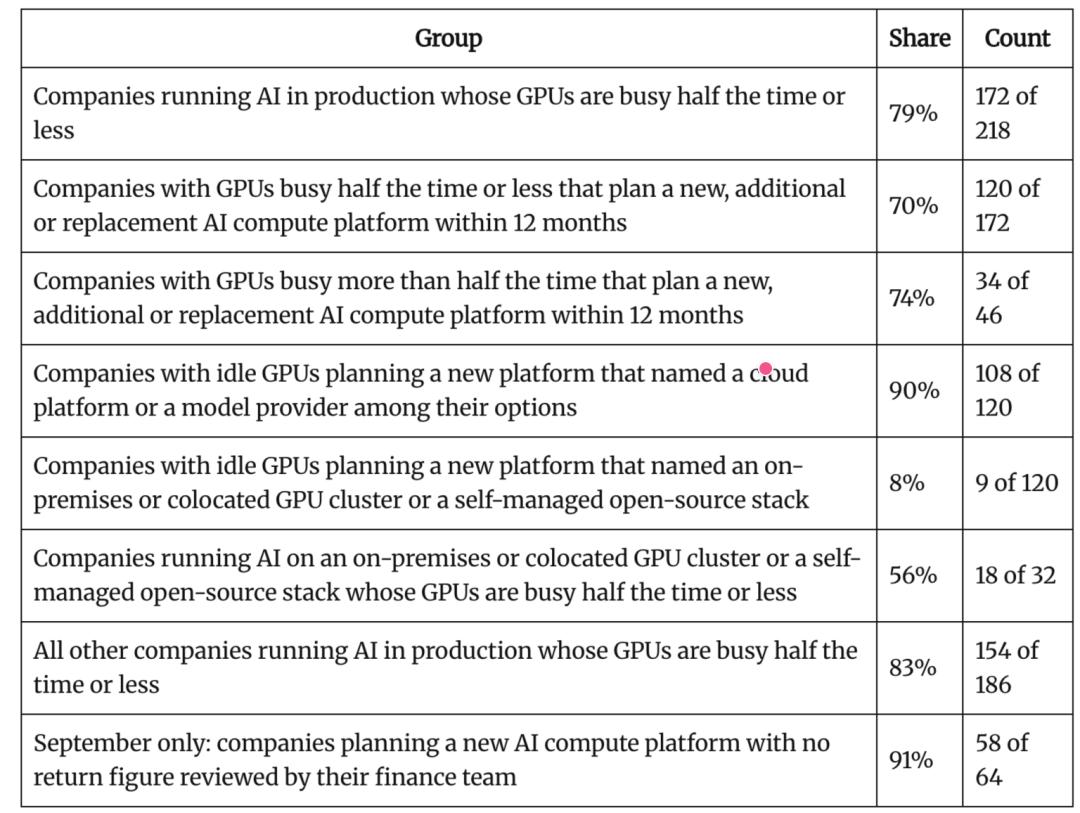
Neuen kontinuierlichen Umfragedaten des Forschungsinstituts VentureBeat Intelligence, das zum Technologiemedium VentureBeat gehört, aus dem dritten Quartal 2026 zufolge gaben 79 % der befragten Unternehmen an, dass ihre GPU-Rechenleistung mindestens die Hälfte der Zeit völlig ungenutzt bleibt.
Dieser Wert lag in den vergangenen drei Monaten stabil auf einem hohen Niveau zwischen 77 % und 81 %. Mit anderen Worten: Die unzureichende Nutzung von GPUs ist bei diesen befragten Unternehmen zu einem dauerhaften Phänomen geworden.
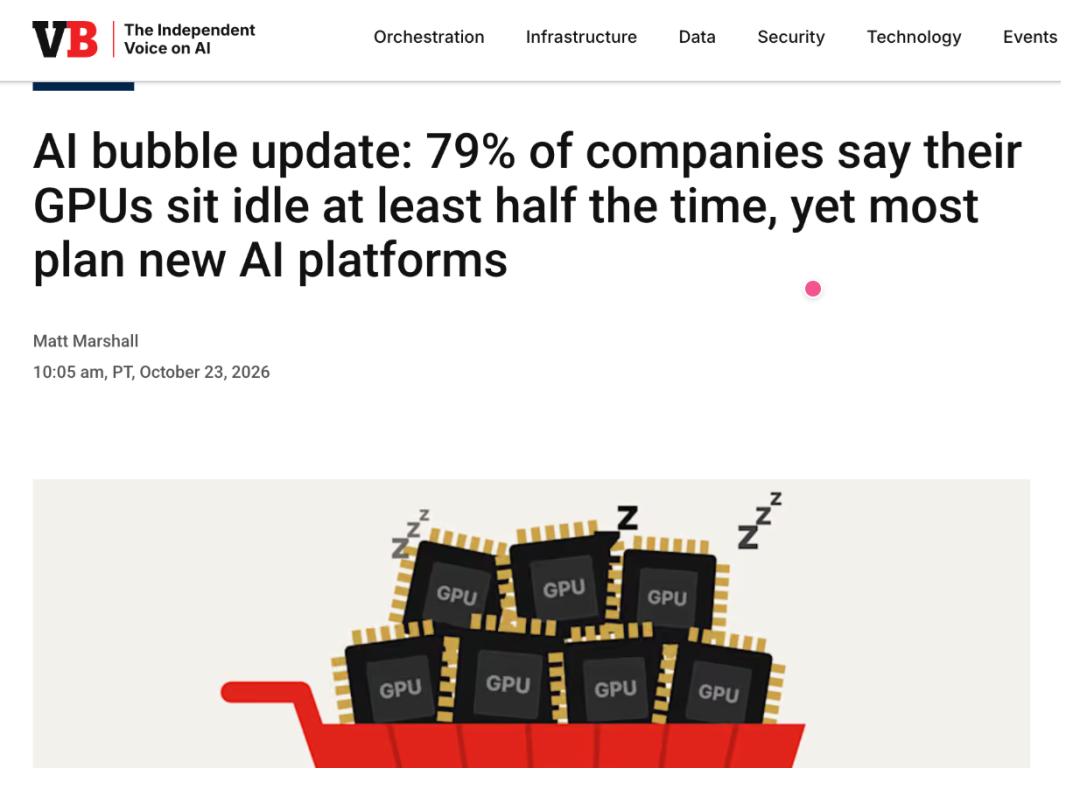
Noch absurder ist aber, dass 70 % dieser Unternehmen mit einer durchschnittlichen GPU-Auslastung von höchstens 50 % trotzdem planen, in den kommenden 12 Monaten neue KI-Rechenplattformen einzuführen, zu erweitern oder auszutauschen.
VentureBeat Intelligence, das zu VentureBeat gehört, hat die Ergebnisse seiner drei VB-Pulse-Umfragen im Bereich KI-Infrastruktur und Rechenleistung aus Juli, August und September 2026 zusammengefasst. An den drei Umfragen nahmen insgesamt 385 teilnahmeberechtigte Befragte aus Einrichtungen mit mindestens 100 Mitarbeitern teil, darunter auch Berater, die für ihre Hauptkunden antworteten.
Auf der einen Seite verstauben die Hardware in den Rechenzentren, auf der anderen Seite schießen die Ausgaben für KI weiter rasant in die Höhe. Dabei stellt sich eine offensichtliche Frage: Warum suchen Unternehmen weiterhin nach neuen KI-Plattformen, obwohl die vorhandenen Ressourcen noch nicht vollständig genutzt werden?
Schauen wir uns auch die Kapitalrendite an: Eine Umfrage von VentureBeat im September dieses Jahres ergab, dass von 64 Befragten, die die Einführung neuer KI-Plattformen planen, 58 keine von der Finanzabteilung geprüften Daten zur Kapitalrendite (ROI) vorweisen können – das entspricht einem Anteil von 91 %.
Das bedeutet, dass ein erheblicher Teil der befragten Unternehmen bei der Vorbereitung der nächsten KI-Investitionsrunde noch keine finanzgeprüfte Ertragsberechnung erstellt hat.
Natürlich bedeutet eine ungeprüfte ROI nicht, dass das Projekt keinen Nutzen bringt. In derselben Umfrage fehlten solche Daten auch bei Befragten, die keine Pläne zur Einführung neuer Plattformen haben. Dies zeigt aber zumindest, dass die finanzielle Bewertung von KI-Investitionen bei Unternehmen möglicherweise noch nicht mit dem Tempo der Infrastrukturinvestitionen Schritt hält. Das heißt, KI-Funktionen halten zwar schnell Einzug in die Produktivumgebungen, aber wie viel Geld tatsächlich ausgegeben und wie viel Wert geschaffen wird, ist für viele Unternehmen noch nicht vollständig geklärt.
Diese Zahlen sind wichtig, weil an der Wall Street heftig darüber diskutiert wird, ob sich bereits eine KI-Blase gebildet hat. VentureBeat stellt auf Basis der Umfrage eine umstrittene These auf: Das Risiko einer KI-Blase könnte bereits im Inneren der Unternehmen auftreten...
Zwei unpassende Rechnungen: Unbenutzte „Rechenleistung“ und kostspielige „APIs“
Oberflächlich betrachtet widerspricht dieses Phänomen „einerseits ungenutzt, andererseits weiter aufstocken“ völlig der wirtschaftlichen Vernunft, besonders jetzt, wo die meisten technischen Verantwortlichen unter Druck stehen, die KI-Ausgaben zu senken: Einige technische Verantwortliche berichteten VentureBeat, dass sie im Budgetzeitraum dieses Herbstes unter enormem Druck stehen, die KI-Rechnungen zu kürzen.
Ein Blick in die interne Struktur der Unternehmen zeigt aber: Der tatsächliche KI-Bedarf der Unternehmen ist nicht verschwunden, sondern liegt genau dort, wo die vorhandene Hardware überhaupt nicht mithalten kann.
Fachkräfte und Verbraucher nutzen immer mehr KI, wobei ein großer Teil der Arbeiten auf modernste Modelle von Anthropic und OpenAI angewiesen ist. Dieser Bedarf wird die Investitionen dieser Unternehmen in Rechenleistung in der kommenden Zeit weiter stützen.
Die echte Fehlpassung entsteht in den tieferen Ebenen der Unternehmen: Unternehmen zahlen derzeit für zwei völlig unterschiedliche Arten von KI-Ausgaben, zwischen denen es eine unüberwindbare Lücke gibt:
Panikgetriebene Rechenleistungsreserven: Unter der Angst vor dem weltweiten Mangel an Rechenleistung in den vergangenen zwei Jahren haben viele Unternehmen GPU-Cluster im Voraus reserviert und gekauft, um nicht den Anschluss zu verpassen. Nachdem die Hardware eingetroffen ist, fehlen den Unternehmen jedoch ausgereifte interne Anwendungsfälle und technische Fähigkeiten, um diese vollständig auszulasten.
Pfadabhängigkeit von geschlossenen modernsten Modellen: Fachabteilungen und Ingenieure neigen dazu, direkt auf die besten geschlossenen Spitzenmodelle von OpenAI, Anthropic und Google zuzugreifen. Unternehmen zahlen für diese Modelle über APIs dieser Anbieter pro Token, oder erwerben die Modellfähigkeiten über monatliche Abonnements oder große Cloud-Dienste – sie können diese Modelle aber nicht direkt auf ihren zuvor kontrollierten lokalen oder gehosteten GPUs bereitstellen.
Das führt zu einer sehr ironischen Situation: Die selbst aufgebaute Rechenleistung wird zu einem versunkenen Vermögenswert, während die Kosten für den Zugriff auf geschlossene APIs das Budget in erschreckendem Tempo aufzehren.
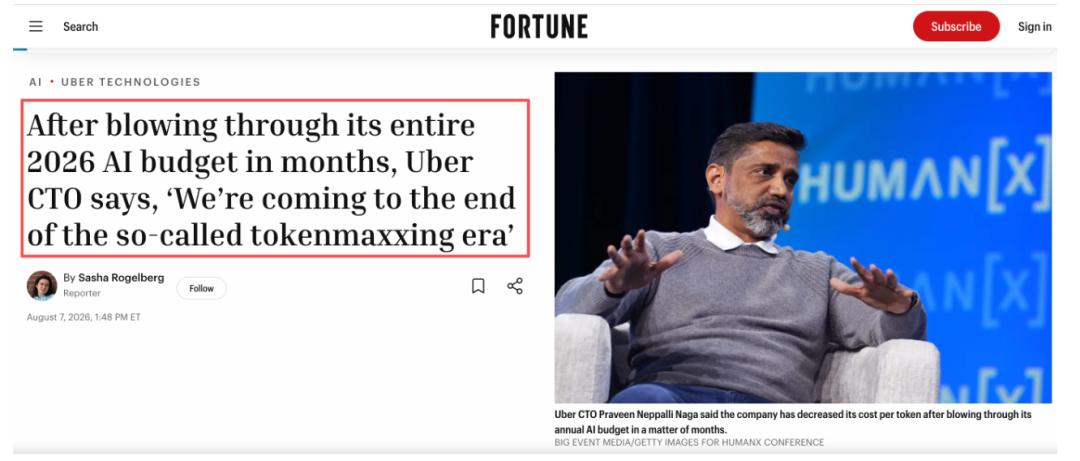
Im August dieses Jahres berichtete das Fortune-Magazin bereits, dass der Technische Leiter von Uber mitteilte, dass das Unternehmen seine Mitarbeiter ermutigt, KI-Tools so umfassend wie möglich zu nutzen – es wurde sogar eine „Bestenliste“ eingerichtet, die die Nutzungshäufigkeit dieser Tools durch Software-Ingenieure auswertet.
Das Ergebnis war, dass das gesamte KI-Budget für das Jahr 2026 innerhalb weniger Monate aufgebraucht war, und das Unternehmen das Ende der Ära des „Tokenmaxxings“ erklären musste.
Die Umfragedaten belegen diese strukturelle Trennung weiter: 90 % der Unternehmen, die neue Rechenplattformen kaufen wollen und ungenutzte GPUs haben, richten ihren Blick auf öffentliche Clouds und Modell-API-Dienstanbieter, nur 8 % erwägen die Erweiterung lokaler privater Cluster. Gleichzeitig können 91 % der Unternehmen, die die Einführung neuer Plattformen planen, keine einzige von der Finanzabteilung geprüfte tatsächliche ROI-Bewertung vorweisen.
Natürlich könnte ein Teil der ungenutzten Rechenleistung von Unternehmen absichtlich so vorgesehen sein, um beispielsweise GPU-Ressourcen für Spitzenbedarf vorzuhalten, und die geplanten neuen Plattformen könnten auch zum Austausch alter Plattformen dienen.
Vom „KI-Rechenleistungs-Wettrüsten“ zur „Inferenzökonomie“
Wenn die ungenutzten GPUs das Problem der ineffizienten Nutzung der Infrastruktur aufzeigen, dann könnte die Verbreitung von KI-Agenten die Unternehmen vor noch komplexere Kostenherausforderungen stellen.
VentureBeat prognostiziert, dass der Anteil der Ausgaben für Modellaufrufe an den gesamten KI-Ausgaben der Unternehmen in Zukunft immer weiter steigen wird. Besonders wenn sich die Anwendungen von einfachen generativen Dialogen hin zu mehrstufigen autonomen KI-Agenten entwickeln, verschärft sich der Widerspruch bei der Rechenleistung der Unternehmen weiter.
Laut Prognose von Gartner werden die Inferenzkosten für einen einzelnen Agent-Workflow bis 2028 um mehr als das Fünffache steigen.
Das bedeutet nicht, dass der Preis pro Token immer teurer wird. Tatsächlich könnte der Preis pro Einheit von Token weiter sinken, da sich die Effizienz der Inferenzinfrastruktur und der Modelle stetig verbessert. Das eigentliche Problem ist aber, dass die Anzahl an Token, die ein Agent zur Erledigung einer Aufgabe verbraucht, möglicherweise schneller wächst als der Preis pro Token sinkt.
Eine leicht zu übersehende Kostenquelle ist der Kontext. Nehmen wir das KI-Programmieren als Beispiel: Das Modell muss nicht nur das aktuelle Problem verstehen, sondern auch kontinuierlich Projektcode, Systemanweisungen und historische Ausführungsprotokolle lesen. Mit Fortschreiten der Aufgabe können diese Kontexte bei mehreren Anfragen wiederholt auftreten. Wenn sie jedes Mal neu verarbeitet werden, summieren sich die Kosten schnell – das ist der Grund, warum die Kontext-Cache-Nutzung immer wichtiger wird.
Ingenieure von NVIDIA erwähnen in einem technischen Leitfaden, dass in den von ihnen untersuchten Claude-Code-Sitzungen nach dem ersten Aufruf etwa 85 % bis 97 % des Kontexts nachfolgender Anfragen über den Cache wiederverwendet werden können. Der Preis für das Lesen aus dem Cache bei Anthropic kann je nach Modell und Preisbedingungen bis zu 1/10 bis 1/40 des Preises für normale Eingabe-Token betragen.
Für Agenten, die Aufgaben kontinuierlich ausführen müssen, kann diese Optimierung zu erheblichen Einsparungen führen.
Eine weitere Variable ist die Anzahl der Agenten. Ein Test von Vals AI, einer Branchenbewertungsstelle, bei dem Programmieraufgaben durchgeführt wurden, ergab, dass die Kosten bei einem System, bei dem ein Hauptagent mehrere Unteragenten steuert, das 1,8- bis 5,1-fache der Kosten eines einzelnen Agenten betragen.
Von vier getesteten Konfigurationen erzielte aber nur eine eine statistisch signifikante Leistungssteigerung. Mit anderen Worten: Mehr Agenten können zwar stärkere Fähigkeiten bringen, aber sie können auch einfach nur mehr Modelle dazu bringen, gleichzeitig Token zu verbrauchen.
Abschied von der extensiven Expansion: Praktische Wege zur Selbsthilfe für Unternehmen
Angesichts der extrem hohen Leerstandsrate und der außer Kontrolle geratenen Rechnungen für Modellaufrufe ist für Unternehmen das extensive „blinde Einkaufen“ von KI-Ressourcen möglicherweise vorbei. In der Branche ist man sich einig: Bevor Unternehmen den nächsten Vertrag über Rechenleistung unterzeichnen, sollten sie vor allem die Effizienz aus den bereits vorhandenen Vermögenswerten herausholen: Die bereits bezahlte Rechenleistung und Token so nutzen, dass mehr praktische Arbeiten erledigt werden können.
Konkret müssen folgende Punkte umgesetzt werden:
Die Kosten jeder abgeschlossenen Aufgabe messen, wobei sowohl die GPU-Rechenressourcen als auch die Ausgaben für API-Aufrufe berücksichtigt werden;
Verschiedene Modelle und Inferenzintensitäten testen, um die Standardkonfiguration des Unternehmens festzulegen: Der Bewertungsmaßstab sollten die Kosten pro abgeschlossener Aufgabe sein, nicht der Preis pro einzelnem Token. Denn ein billiges Modell kann mehr Token verbrauchen und am Ende die Kosten pro Aufgabe sogar höher machen;
Dem Agenten nur den Kontext geben, den er tatsächlich braucht, und wiederverwendbare Inhalte cachen – das gilt sowohl bei der Nutzung von APIs von Modellanbietern als auch bei der Ausführung auf der eigenen Infrastruktur des Unternehmens;
Einen zweiten Agenten nur dann hinzufügen, wenn sich die Aufgabe in parallel ausführbare Teile unterteilen lässt;
Regelmäßige, häufig ausgeführte Aufgaben wie Klassifizierung, Informationsextraktion und Textzusammenfassung von den APIs modernster Modelle zu Open-Source-Modellen verschieben, die auf der ungenutzten Rechenleistung ausgeführt werden;
Die verbleibende ungenutzte GPU-Zeit nutzen, um Aufgaben zu bearbeiten, die später ausgeführt werden können, wie Batch-Inferenz, Modellbewertung und Feineinstellung.
Das endgültige Ziel ist es, dass Unternehmen für jede tatsächlich abgeschlossene Arbeit einen angemesseneren Preis zahlen.
Das gibt den überraschenden Daten zu Beginn eine neue Bedeutung: Die niedrige GPU-Auslastung von 79 % und die Bereitschaft von 70 %, neue Plattformen einzuführen, beweisen nicht direkt, dass sich eine KI-Blase gebildet hat, und schon gar nicht, dass die gesamte KI-Branche zu Überkapazitäten neigt. Aber es erinnert Unternehmen daran: Zwischen den eingesetzten Ressourcen und dem tatsächlichen Bedarf besteht tatsächlich eine Lücke, die neu bewertet werden muss.
In den vergangenen Jahren hat die KI-Branche Fortschritte gerne an Parameterumfang, Trainingsrechenleistung und Kapitalausgaben gemessen. Mit der schrittweisen Integration der Technik in echte Geschäftsprozesse braucht es neben diesen Indikatoren ein praktischeres Bewertungssystem: Wie viele Arbeiten erledigen Unternehmen tatsächlich mit KI? Wie hoch ist die Erfolgsrate? Wie viel Zeit wird eingespart? Und wie viel Kosten sind dafür angefallen?
Für Modellanbieter bedeutet das, dass der Wettbewerb nicht mehr nur um die Fähigkeiten der Modelle geht, sondern sich auch auf die Inferenzeffizienz, die Flexibilität der Bereitstellung und die Gesamtkosten der Aufgaben erstreckt. Für Unternehmen ist es wichtiger, als weiterhin Rechenleistung zu horten, erst einmal die bereits vorhandenen GPUs und Token sinnvoll zu nutzen.
Schließlich kauft man GPUs, damit sie arbeiten – das wirklich Wichtige ist, wie viel Wert sie am Ende tatsächlich schaffen...
Referenzlinks:
https://venturebeat.com/infrastructure/ai-bubble-update-79-of-companies-say-their-gpus-sit-idle-at-least-half-the-time-yet-most-plan-new-ai-platforms
https://fortune.com/2026/08/07/uber-ai-spending-tokenmaxxing-is-over-cto/
Dieser Artikel stammt vom WeChat-Offiziellen Konto „Jiqi Zhixin“ (ID: almosthuman2014), Autor: AI-Fachpersonal. Die Veröffentlichung erfolgt mit Genehmigung von 36Kr.