Terence Tao ist in Verlegenheit geraten, eine Studie der Harvard-Universität zeigt, dass KI bei der Peer-Review von wissenschaftlichen Arbeiten bessere Leistungen erbringt als Experten.
Künstliche Intelligenz ist heute sogar bei der Begutachtung wissenschaftlicher Arbeiten leistungsfähiger als menschliche Experten.
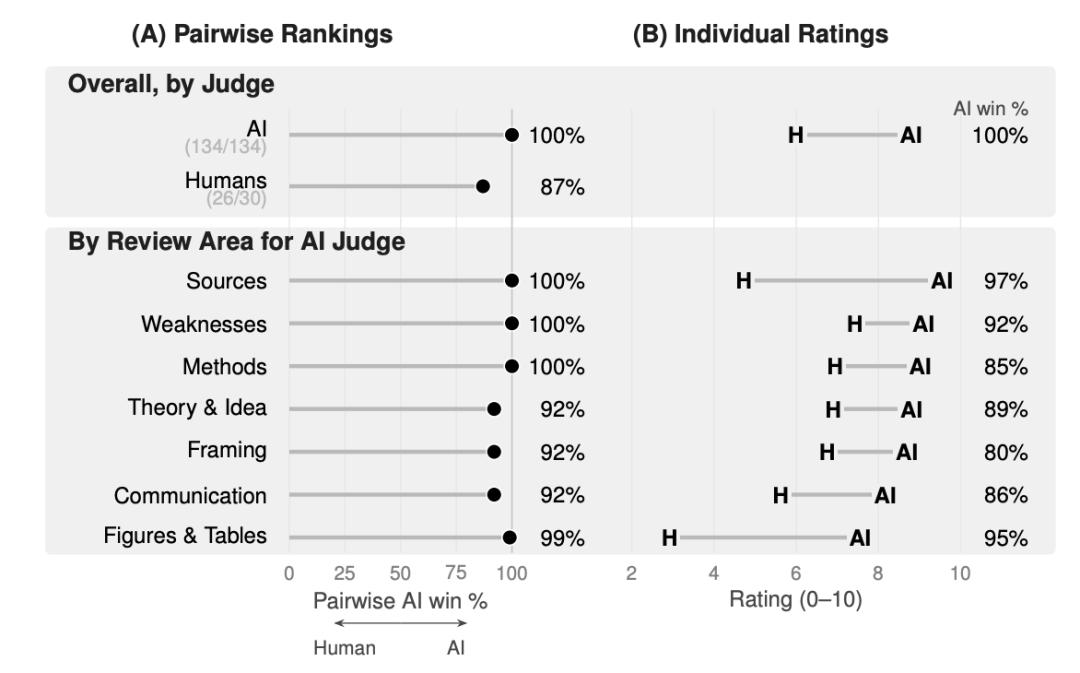
Am 22. Oktober veröffentlichten zwei Forscher der Harvard University eine Arbeit mit dem Titel „KI-Gutachten übertreffen hochwertige menschliche Peer-Reviews umfassend“, in der sie 134 Gruppen von von KI und Menschen verfassten Gutachten verglichen. Das Ergebnis: Die KI lag in sieben Bewertungsdimensionen durchgehend vorne.
Die Forscher luden zudem drei Experten ein, die früher als Chefredakteure wichtiger wissenschaftlicher Zeitschriften tätig waren, um eine Blindbewertung durchzuführen. Bei 30 Vergleichen hielten sie 26 Mal das Gutachten der KI für besser.
Bei den überprüften konkreten Aussagen lag der Anteil sachlicher Fehler in den KI-Gutachten nur bei 5,5 %, während er bei Menschen sogar 15,9 % erreichte.
Für die Mathematiker, die sich in letzter Zeit eifrig mit KI-Unternehmen auseinandersetzen, ist dies möglicherweise keine erfreuliche Nachricht.
Erst im letzten Monat kritisierten 25 Preisträger der Fields-Medaille, darunter Terence Tao, gemeinsam, dass KI-Unternehmen zu voreilig mathematische Durchbrüche verkünden, und betonten, dass die mathematische Forschung strenge Überprüfungen und Prüfungen erfordert.
Die Mathematiker fordern noch, dass die KI strengen wissenschaftlichen Prüfungen unterzogen wird, während die Menschen unterdessen möglicherweise sogar den Job des Begutachtens von Arbeiten von der KI übernehmen lassen müssen.
Das Bild wurde von KI generiert
Die Menschen sind total unterlegen
Die unterlegenen Gutachter waren keine zufällig rekrutierten Freiwilligen.
Die Studie nutzte 124 wissenschaftliche Arbeiten sowie 134 menschliche Gutachten, die vom Dienst rapidPeer des Instituts für Quantitative Sozialwissenschaften der Harvard University bereitgestellt wurden – dies ist ein kostenpflichtiger professioneller Begutachtungsdienst, bei dem die Gutachter von Fachexperten ausgewählt werden, aus verschiedenen Forschungseinrichtungen stammen und eine hohe Vergütung erhalten.
Ihre Leistung war ursprünglich auch sehr gut: Von den 74 befragten Autoren der Arbeiten hielten 88 % die erhaltenen Gutachten für sehr hochwertig, wobei 60 % die höchste Bewertung abgaben.
Die Forscher verwendeten Claude Opus 4.8 von Anthropic, um Gutachten zu erstellen, und beauftragten anschließend GPT-5.5 von OpenAI als KI-Bewerter, um die Qualität der Gutachten von Menschen und KI zu vergleichen, ohne zu wissen, wer die jeweiligen Gutachten verfasst hat.
Das Ergebnis: Die Menschen haben total und klar verloren.
Selbst wenn der KI keine Internetverbindung erlaubt wurde und ihr nur dieselben Begutachtungsrichtlinien wie den Menschen zur Verfügung gestellt wurden, wählte GPT-5.5 in allen 134 Vergleichsgruppen die KI als Sieger.
Nach der Verwendung speziell optimierter Prompts und der Freigabe der Internetverbindung entschied sich in 132 von 134 Vergleichsgruppen eindeutig die KI als Sieger, die verbleibenden zwei Ergebnisse waren ungewiss, und die Menschen erzielten weiterhin keinen einzigen Sieg.
Konkret lag die Gewinnquote der KI bei 100 % in den drei Dimensionen Ergänzung von Literaturverweisen, Erkennen von Schwachstellen der Arbeit und Forschungsmethodik; bei Aspekten wie theoretischer Innovation, Darstellungsrahmen und Ausdrucksqualität lag die Gewinnquote ebenfalls über 90 %.
Die Forscher prüften sogar 651 von der KI zitierte Literaturverweise mit DOI- oder arXiv-Nummern und stellten fest, dass alle tatsächlich existieren und keine einzige erfunden wurde.
Möglicherweise werden einige sagen, dass es unfair ist, wenn KI die Gutachten von KI bewertet – wer weiß, ob sie nicht ihre Artgenossen bevorzugt? Vielleicht versteckt sie in den Gutachten sogar Hinweise, die unbemerkt Vorteile verschaffen.
Daher luden sie die drei eingangs genannten ehemaligen Chefredakteure wissenschaftlicher Zeitschriften ein, jeweils 10 Blindbewertungen durchzuführen. Das Ergebnis war, dass die menschlichen Bewerter in 26 von 30 Vergleichen die KI wählten.
Damit standen sogar die menschlichen Bewerter auf der Seite der KI.
An diesem Punkt der Studie begannen die Autoren sogar ernsthaft zu diskutieren: Wissenschaftliche Zeitschriften könnten auf die üblichen menschlichen Peer-Reviews verzichten und die meisten Prüfaufgaben der KI überlassen, während menschliche Redakteure nur für die endgültigen Entscheidungen verantwortlich bleiben und bei Bedarf Experten hinzugezogen werden.
Nach der Veröffentlichung der Arbeit am 23. Oktober erklärte Xu Yiyi, außerordentlicher Professor für Politikwissenschaft an der Stanford University, öffentlich, dass die akademische Welt die Rolle menschlicher Experten bei der Begutachtung von Arbeiten überdenken sollte. Seiner Meinung nach müssen menschliche Experten weiterhin beteiligt sein, aber es ist nicht mehr notwendig, selbst lange Gutachten mit bis zu 1500 Wörtern zu verfassen.
Sogar die Zeitschriften, die die Verwendung von KI zur Begutachtung von Arbeiten verbieten, sind an dem Punkt angelangt, ihre eigenen Vorschriften neu zu prüfen.
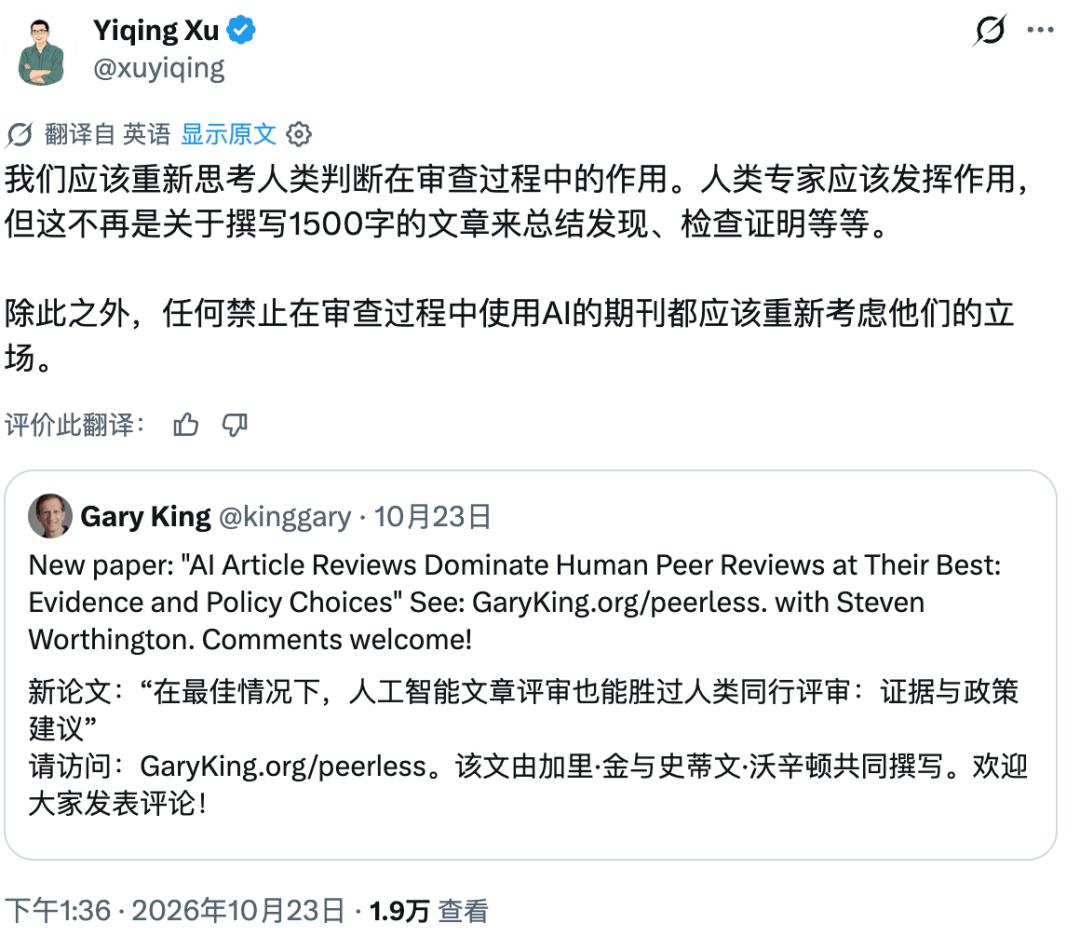
Anscheinend gibt es bereits Personen, die den Job menschlicher Gutachter der KI überlassen wollen.
Die KI begutachtet Arbeiten so gewissenhaft, dass es fast lästig ist
Daher stellt sich die Frage: Wie hat die KI die menschlichen Gutachter eigentlich übertroffen?
Die Antwort könnte sehr einfach sein – sie wird überhaupt nicht müde.
Die Begutachtung von Arbeiten ist eine sehr anstrengende Tätigkeit. Die Gutachter müssen die gesamte Arbeit durchlesen, die Forschungsmethodik, Daten, Diagramme und Argumente prüfen und zudem nach relevanten Literaturquellen suchen, die die Autoren möglicherweise übersehen haben.
Die Autoren der Arbeit beschweren sich bei der Vorstellung des Experiments sogar nebenbei über einige traditionelle Zeitschriften-Gutachter: Einige beginnen bereits bei der dritten Seite der Arbeit, nach fatalen Mängeln zu suchen, die die Arbeit widerlegen, damit sie nicht weiterlesen müssen.
Im Vergleich dazu hat die KI offensichtlich kein Bedürfnis, eilig Feierabend zu machen.
Das Bild wurde von KI generiert
In diesem Experiment stellten die Forscher die Denkleistung von Claude Opus 4.8 auf das Maximum ein und entwarfen speziell eine Reihe von Begutachtungs-Prompts, die es ihr erlaubten, im Internet nach Informationen zu suchen.
Das Ergebnis zeigte, dass die KI durchschnittlich 12,4 Internetsuchen durchführt, um eine einzelne Arbeit zu begutachten.
Der Effekt dieser Gewissenhaftigkeit ist jedoch sehr deutlich. Ohne Internetverbindung und unter Verwendung gewöhnlicher Begutachtungsrichtlinien lag die Gewinnquote der KI bei der Ergänzung von Literaturverweisen bei 62 %; nach der Verwendung speziell optimierter Prompts und der Freigabe der Internetverbindung stieg die Gewinnquote direkt auf 100 % an.
Die Zeiten haben sich geändert.
Im April dieses Jahres veröffentlichte das Redaktionsteam der wissenschaftlichen Zeitschrift „Organization Science“ noch eine Studie, in der mehr als zehntausend in den letzten Jahren erhaltene Gutachten analysiert wurden. Es stellte sich heraus, dass die mit umfangreicher KI-Nutzung erstellten Gutachten schwerer zu lesen waren und die diskutierten Themen enger gefasst waren.
Damals glaubten die Forscher sogar, dass die von KI erstellten Gutachten noch nicht das Niveau menschlicher Begutachtungen erreicht hätten. Weniger als ein halbes Jahr später legte Harvard jedoch bereits ein anderes Ergebnis vor.
Aber die übermäßige Gewissenhaftigkeit der KI kann gelegentlich auch frustrierend sein.
Die Autoren der Arbeit geben ein Beispiel: Die KI ist manchmal so pingelig, dass es schon absurd wirkt: Obwohl sie weiß, dass 2+2=4 korrekt ist, weist sie trotzdem darauf hin, dass der Autor nicht definiert hat, was das Pluszeichen bedeutet.
Menschliche Gutachter könnten sich über zu viele Mängel in der Arbeit ärgern, während die KI möglicherweise „süchtig nach Fehlersuche“ wird und auch dann Fehler findet, wenn es eigentlich keine gibt.
Zudem entwickelt sich die Fähigkeit der KI ständig weiter.
Früher mussten die Autoren der Arbeiten den menschlichen Gutachtern beweisen, dass ihre Forschung veröffentlichungswert ist; später müssen möglicherweise die menschlichen Gutachter den wissenschaftlichen Zeitschriften beweisen, warum es sich noch lohnt, sie zu bezahlen.
Die Mathematiker stehen möglicherweise etwas peinlich da
In letzter Zeit hat sich das Schlachtfeld zwischen Mathematikern und KI-Unternehmen von der Überprüfung mathematischer Beweise bis hin zum Peer-Review ausgeweitet.
Am 11. September gaben die ersten 25 Preisträger der Fields-Medaille, darunter Terence Tao, eine gemeinsame Erklärung ab, in der sie kritisierten, dass KI-Unternehmen das Lösen mathematischer Probleme zu einem Wettbewerb um die Fähigkeiten ihrer Modelle machen, voreilig große Durchbrüche verkünden und der mathematischen Gemeinschaft keine ausreichende Zeit zur Überprüfung, zum Verstehen und zur Diskussion lassen.
Am 29. September veröffentlichte die Beratungsgruppe für Mathematik und KI (AGMAI) zudem spezielle Richtlinien, die betonen, dass die von menschlichen Mathematikern vollständig verstandenen KI-Forschungsergebnisse nach traditionellen wissenschaftlichen Normen als Arbeit veröffentlicht und dem Peer-Review der Zeitschriften unterzogen werden sollten.
Die mathematische Forschung folgt einem seit vielen Jahren bestehenden Regelwerk. Nachdem ein Beweis verfasst wurde, muss er von Experten geprüft und von Kollegen diskutiert werden, bevor er allmählich zu dem von der akademischen Gemeinschaft anerkannten Wissen wird.
KI-Unternehmen können voller Freude verkünden, dass sie erneut ein weltweites schwieriges Problem gelöst haben, aber ob die mathematische Gemeinschaft dies anerkennt, ist eine ganz andere Angelegenheit.
Ein Teil der Mathematiker will nicht einmal zulassen, dass die KI den Stuhl des Gutachters berührt.
Am 7. September kritisierte eine Organisation namens „Gesellschaft der menschlichen Mathematik“ (AHM) öffentlich, dass OpenAI mehr als 700 mathematische Forschungsdokumente auf einmal veröffentlicht hat, und behauptete, dass dies eher eine Machtdemonstration als ernsthafte wissenschaftliche Arbeit sei.
Die Organisation forderte ihre Mitglieder sogar ausdrücklich auf, keine von KI erstellten mathematischen Arbeiten oder Kommentare zu veröffentlichen, und das gilt auch nicht für Gutachten.
Gerade als die Mathematiker sich bemühen, Regeln für die KI aufzustellen, haben die zwei Forscher aus Harvard sowohl menschliche als auch KI-Gutachter zur Prüfung antreten lassen.
Wie wir sehen, hat die KI nicht nur begonnen, die Fähigkeit der Menschen zum Verfassen von Arbeiten herauszufordern, sondern ist inzwischen sogar bei der Suche nach Mängeln in Arbeiten besser als viele professionelle Gutachter.
Natürlich bezieht sich diese Harvard-Studie hauptsächlich auf Arbeiten der Sozialwissenschaften und kann noch nicht beweisen, dass die KI in der Lage ist, komplexe mathematische Beweise unabhängig zu prüfen. Die Forderung der Mathematiker nach strengen Überprüfungen ist an sich nicht falsch.
Aber die Entwicklung der Dinge wirkt in gewissem Maße schon absurd.
Die Mathematiker betonen noch immer, dass die KI die Schwelle des menschlichen Peer-Reviews nicht umgehen darf.
Aber die KI hat bereits damit begonnen, zu untersuchen, ob sie auch diejenigen ersetzen kann, die diese Schwelle bewachen.
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „Letter AI“, Autor: Yuan Xinyue, veröffentlicht mit Genehmigung von 36Kr.