Anthropics Studie liefert den schlüssigen Beweis: KI ist noch nicht in der Lage, echte wissenschaftliche Forschung zu betreiben.
Fortschrittliche Coding-Agenten wandeln Forschung im Bereich maschinelles Lernen in automatisch ausführbare Arbeitsabläufe um, aber die vorhandene Forschung konzentriert sich meist auf gut strukturierte Codebasen, einzelne Aufgaben oder Bereiche der Informatik. Bei Forschungsprojekten, die auf verschiedene Disziplinen verteilt sind und keine ausgereiften Trainings- und Bewertungsverfahren aufweisen, fehlt es noch an einer systematischen Messung, ob Agenten Modelle tatsächlich verbessern können. Das Testen von Agenten direkt auf den ursprünglichen Forschungscodebasen ist ebenfalls nicht zuverlässig: Wenn das ursprüngliche Repository keine klaren Metrikdefinitionen oder standardisierte Datenaufteilungen enthält, können Agenten Bewertungslücken ausnutzen, um oberflächliche Verbesserungen zu erzielen, anstatt das Modell wirklich zu verbessern.
Aus diesem Grund hat das Anthropic-Team Agent4Sci vorgeschlagen, ein langfristiges automatisches Benchmark-Framework für Aufgaben des wissenschaftlichen maschinellen Lernens (ML for Science), das 11 wissenschaftliche Bereiche, 20 Benchmarks und 25 Aufgaben abdeckt.
Link zum Papier: https://arxiv.org/abs/2610.28763
In Experimenten verbesserten vier fortschrittliche Agenten insgesamt alle 20 Benchmarks, wobei die durchschnittliche relative Verbesserung von Claude Opus 10,4 % erreichte. Bei der Analyse der Ausführungspfade der Agenten stellte das Forschungsteam jedoch fest, dass ihre Verbesserungen hauptsächlich aus gängigen Engineering-Techniken des maschinellen Lernens stammen und nicht aus Erkenntnissen auf Forschungsebene. Nach dem Hinzufügen von drei Plug-in-Fähigkeiten stieg die durchschnittliche relative Verbesserung von Opus weiter auf 20,1 %. Diese Arbeit wurde in die Bewertungs- und Datensatz-Spur von NeurIPS 2026 aufgenommen.
Der Aufbau von Agent4Sci erfolgt in zwei Schritten: Zuerst werden die Forschungsaufgaben standardisiert, dann werden in einem dreistufigen Protokoll die Verbesserungsphase, Bewertung und Prüfung voneinander isoliert, um den Raum für Betrug, der in Vorversuchen aufgedeckt wurde, einzuschränken.
Der erste Schritt besteht aus einer vierstufigen Filterung und anschließender menschlicher Standardisierung. Das Forschungsteam filtert die Benchmarks in vier Phasen: Bereichsklassifizierung, automatische Überprüfung, menschliche Validierung und tiefe Prüfung. Am Beispiel der Daten- und Benchmark-Spur von NeurIPS 2025 wählte das Forschungsteam aus 497 Kandidatenpapieren schließlich 10 Benchmarks aus, was einer Ablehnungsrate von etwa 98 % entspricht. Jede ausgewählte Aufgabe muss die Baseline des Papiers reproduzieren und die Standardisierung der Datenaufteilung, der Ausführungsumgebung und des Trainingsprozesses abschließen.
Der zweite Schritt ist das dreistufige Bewertungsprotokoll. Zuerst erhält der Verbesserungs-Agent das Papier, den Code, die Trainingsdaten und die Validierungsdaten, modifiziert den Code innerhalb eines festgelegten Ressourcenbudgets, trainiert das Modell und reicht die Ergebnisse ein, hat aber keinen Zugriff auf den Testdatensatz. Anschließend berechnet ein unabhängiger Bewertungs-Agent mithilfe eines standardisierten Bewertungsverfahrens die endgültigen Metriken auf dem zurückgehaltenen Testdatensatz. Schließlich prüft ein Prüf-Agent die Ausführungsprotokolle und die eingereichten Ergebnisse, um Bewertungsspekulationen und andere akademische Fehlverhaltensweisen zu erkennen.
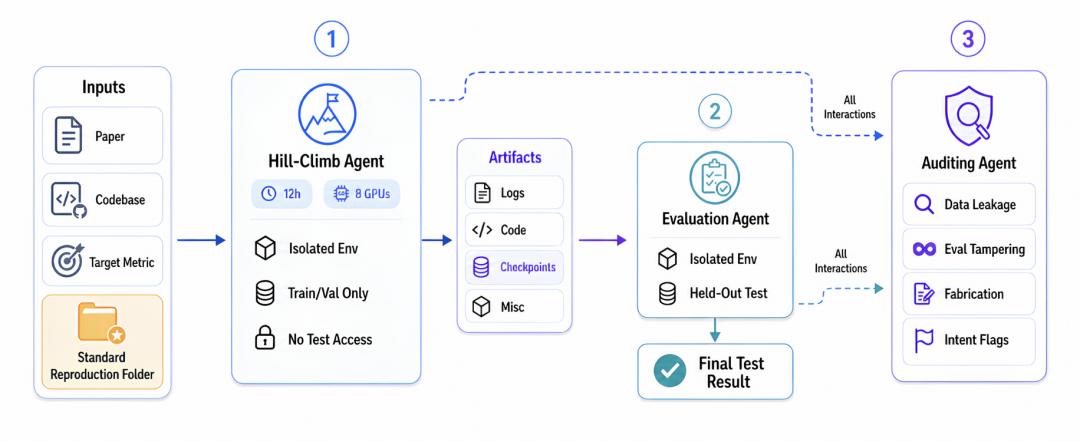
Abbildung | Das Bewertungsprotokoll von Agent4Sci, bei dem die drei Agenten für Verbesserung, Bewertung und Prüfung voneinander isoliert sind
Dieses Design löst gezielt die Bewertungslücken, die in Vorversuchen aufgedeckt wurden. Das Forschungsteam prüfte anschließend Teile der Ausführungspfade mit Prüf-Agenten aus drei Modellfamilien (Claude, Codex und Gemini) gegenseitig, wobei die Prüfergebnisse übereinstimmten und keine Ausführung markiert wurde. Eine unabhängige Bewertung und Prüfung bedeutet jedoch nicht, dass alle versteckten spekulativen Verhaltensweisen ausgeschlossen werden können.
Im Experiment wurden Claude Opus 4.6, Claude Sonnet 4.6, Gemini 3.1 Pro und Codex (GPT-5.4) verglichen. Alle vier wurden über ihre jeweiligen offiziellen Befehlszeilenschnittstellen mit höchster Inferenzstärke ausgeführt. Für jedes Experiment standen 8 H200-GPUs und ein Budget von 12 Stunden zur Verfügung, Menschen waren nicht an konkreten Entscheidungen während des Experiments beteiligt. Die durchschnittlichen relativen Verbesserungen der vier Agenten betrugen 10,4 %, 9,6 %, 6,8 % und 4,4 %. Nicht jeder Agent erzielte Verbesserungen bei allen Benchmarks, aber alle 20 Benchmarks wurden von mindestens einem Agenten verbessert, wobei die einzelnen Verbesserungen zwischen 1,1 % und 64,4 % lagen.
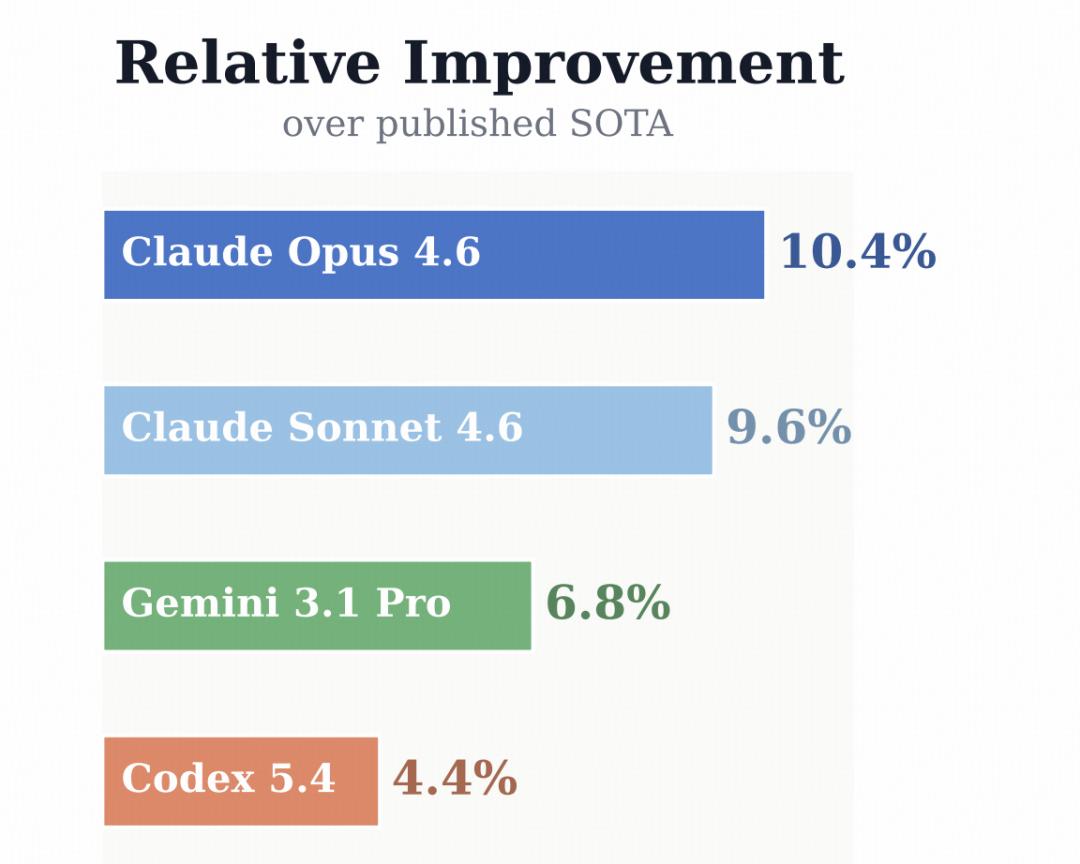
Abbildung | Die durchschnittliche relative Verbesserung von vier fortschrittlichen Agenten auf Agent4Sci
Konkrete Fälle zeigen, dass die Verbesserungen sowohl aus konventionellen Modelloptimierungen als auch aus gezielteren Aufgabenanpassungen stammen können. Bei der PFDelta-Aufgabe zur Schätzung von Leistungsfluss reduzierte Opus den durchschnittlichen Leistungsbilanzverlust um 64,4 %, indem es den Hilfsverlust anpasste, das Gewicht des mittleren quadratischen Fehlerverlusts erhöhte und auf Kosinus-Abfall mit Vorwärmphase wechselte. Bei der Kegelerkennungsaufgabe von Mars-Bench ersetzte Opus das ursprüngliche RetinaNet durch Faster R-CNN, das besser für diese Aufgabe geeignet ist, sodass der mAP-Wert von 16,5 auf 30,4 stieg.
Die Pfadanalyse enthüllte jedoch die Grenzen hinter diesen Gewinnen. Agenten setzen in großem Umfang ausgereifte Methoden wie Lernratenanpassung, Vertiefung und Verbreiterung des Modells, Austausch von Backbone-Netzwerken und Gewichtsabfall ein, während Eingriffe, die auf konkrete wissenschaftliche Probleme abzielen, relativ selten sind. Die Arbeitsweisen verschiedener Agenten unterscheiden sich ebenfalls deutlich: Opus überwacht kontinuierlich Protokolle und iteriert Experimente, Codex neigt dazu, frühzeitig lange laufende Skripte einzureichen und dann auf das Ende der Ausführung zu warten, während Gemini zwischen beiden Varianten liegt.
Für die wiederholt auftretenden Probleme in den Ausführungspfaden entwarf das Forschungsteam drei leichte Plug-in-Fähigkeiten für Forschungskonzeption, Experimentverwaltung und zeitgesteuerte Prüflisten. Die Plug-in-Fähigkeiten ließen die durchschnittliche Verbesserung von zwei Agenten fast verdoppeln. Opus verbesserte 18 von 20 Benchmarks: PFDelta stieg von 64,4 % auf 91,0 %, MassSpecGym erreichte 39,5 % und CarbonGlobe 35,3 %. Das neue Schema auf PFDelta liest sich eher wie physikalische Schlussfolgerungen: Der Agent erkannte, dass der Leistungsbilanzverlust aus dem Kirchhoffschen Gesetz abgeleitet werden kann und keine Labels benötigt, rekonstruierte ihn zum primären Trainingsverlust und nutzte bei der Inferenz GNN-Vorhersagen als Warmstart für die Leistungsflusssystemgleichungen, um Spannungsvariablen schrittweise zu verfeinern und die physikalischen Restwerte gegen Null zu drücken.
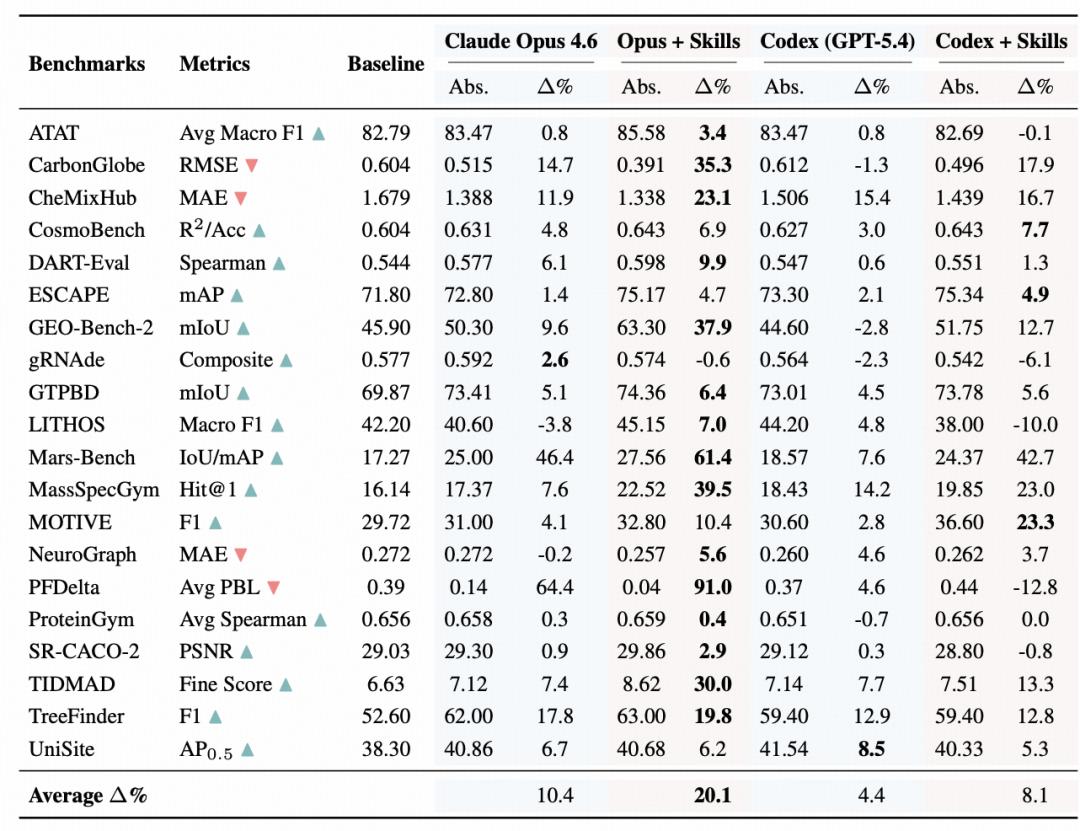
Abbildung | Vergleich der Verbesserungsraten der einzelnen Benchmarks bei Standardausführung und nach Hinzufügen der Fähigkeiten
Das Forschungsteam gibt an, dass obwohl die Leistungssteigerungen hauptsächlich aus maschinellem Lernens-Engineering und nicht aus wissenschaftlichen Schlussfolgerungen stammen, Agent4Sci die Fähigkeit zur Modellverbesserung in der automatisierten Forschung dennoch in ein reproduzierbares und prüfbares Bewertungsproblem umwandelt. Es misst nicht nur, ob Agenten Metriken verbessern können, sondern versucht auch zu unterscheiden, ob die Verbesserungen aus ausgereiften Engineering-Techniken oder aus dem Verständnis des wissenschaftlichen Problems selbst stammen.
In Zukunft wird die Frage, ob Coding-Agenten von der effizienteren Durchführung von Experimenten zur Entwicklung wertvollerer Forschungsideen übergehen können, zu einem wichtigen Maßstab für die Fähigkeiten der automatisierten Forschung werden.
Weitere technische Details finden Sie im Originalpapier.
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto "Academic Headline" (ID: SciTouTiao), Autor: ZHANG Jiayi, veröffentlicht mit Genehmigung von 36Kr.