Claude erzeugte in rasanter Arbeit 180 Millionen Zeilen an Beweisführungen, und alle Bugs, die bei Billionen von Testdurchläufen übersehen wurden, wurden von der KI vollständig aufgedeckt.
Werden die Bugs in der globalen Software bald von Claude beseitigt?
Innerhalb von nur 48 Stunden sind weltweit 27 schwere Cyberangriffe aufgetreten, und derzeit verbreitet sich die Behauptung, dass der „dunkelste Oktober“ angebrochen ist.
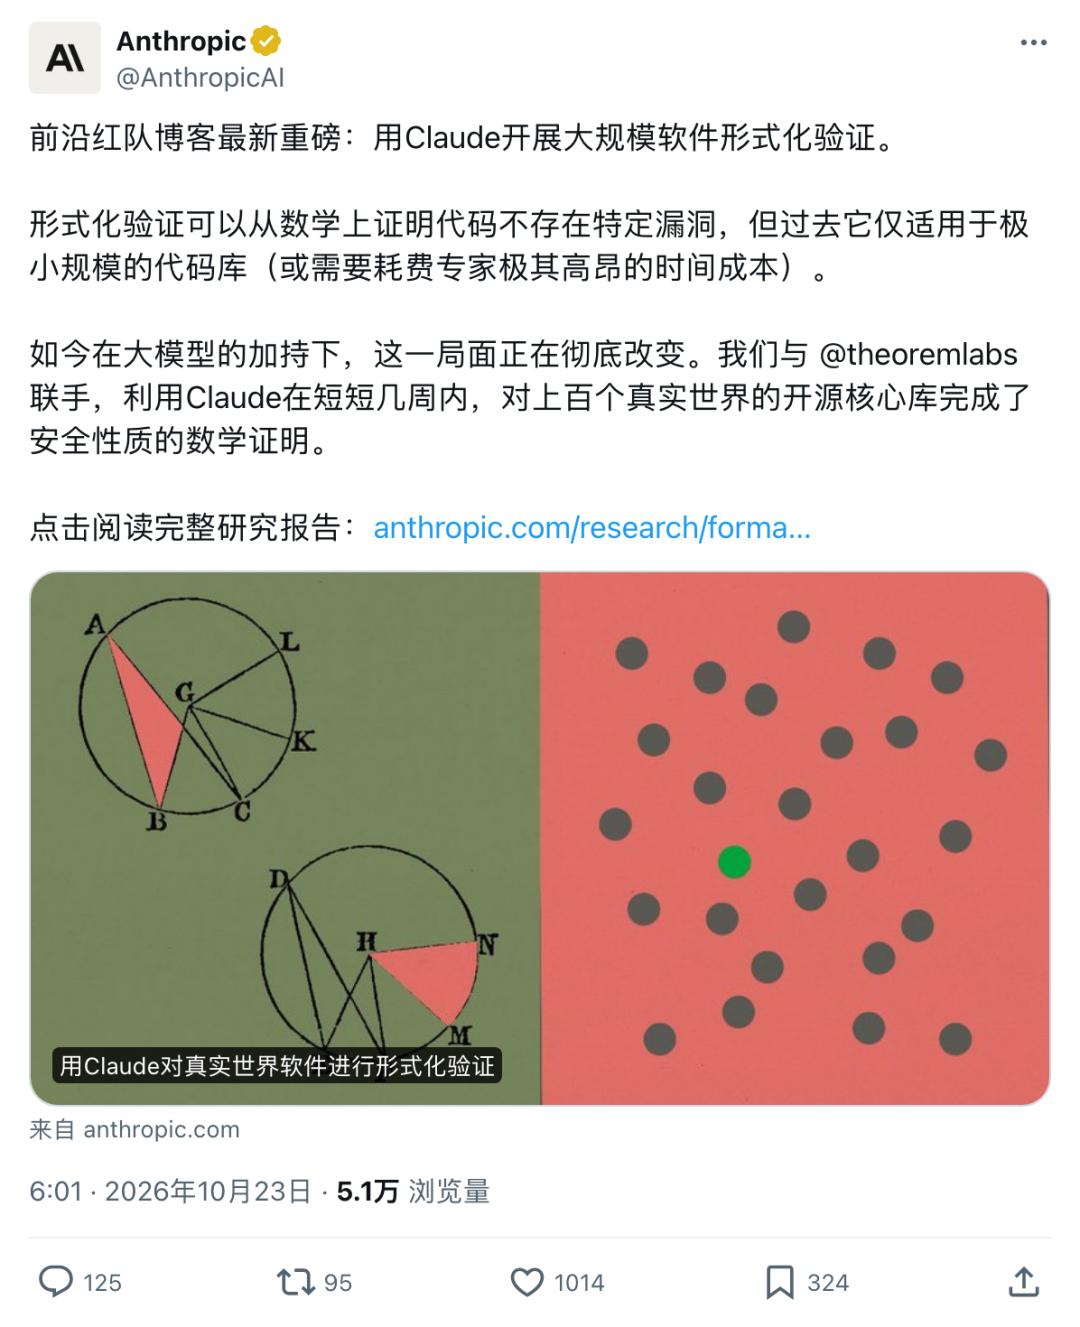
Frühmorgens hat das fortschrittliche Red-Team von Anthropic gemeinsam mit Theorem Labs einen gewichtigen Bericht veröffentlicht —
Sie ließen Claude bis zu den unteren Assembler-Anweisungen (RISC-V) vordringen und starteten einen umfassenden Angriff auf echte produktionsreife Open-Source-Codebasen.
Innerhalb weniger Wochen hat Claude die formale Verifikation von 239 Testzugängen aus 123 Open-Source-Codebasen abgeschlossen und 180 Millionen Zeilen mathematischer Beweiscodes in Rocq erstellt, die alle maschinell überprüft wurden!
Versteckte Schwachstellen, die Googles Plattform nach Billionen von Läufen nie entdeckt hat, zusammen mit hochriskanten logischen Lücken, die seit mehr als zehn Jahren verborgen waren, und sogar echten Fehlern in der Hardware von x86-Prozessoren, sind in dieser großangelegten Säuberungsaktion alle aufgedeckt worden.
Noch beeindruckender: In einem beliebten PDF-Reader hat Claude in einer Woche so viele Sicherheitslücken aufgedeckt, dass die Anzahl direkt der gesamten Menge an Berichten entspricht, die normalerweise in einem ganzen Jahr anfällt.
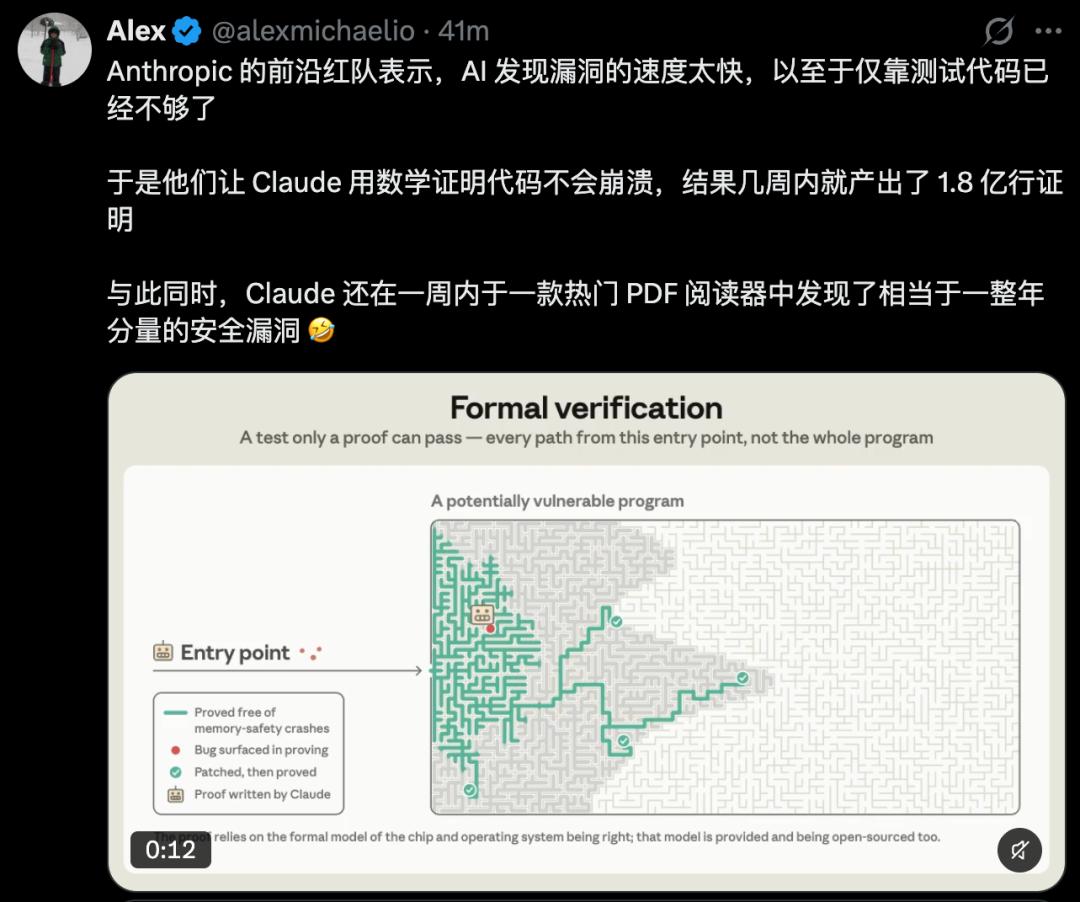
Diesmal kombiniert Claude die Prozesse des Auffindens von Bugs, des Behebens von Bugs und der Verifikation der Korrekturen zu einem durchgehenden Arbeitsablauf und führt eine „mathematische“ Bug-Säuberung durch.
Die weltweite Welle von Cyber-Sicherheitskrisen könnte tatsächlich eine Lösung gefunden haben.
Bug, die Billionen von Tests übersehen haben
durch Mathematik aufgedeckt
In den letzten zehn Jahren war eine der wichtigsten Verteidigungslinien der Open-Source-Welt OSS-Fuzz, das Google im Jahr 2016 vorgestellt hat.
Diese Methode wird als Fuzz-Test bezeichnet, bei dem massenhaft halbzufällige Eingaben in Programmeingänge eingespeist werden, um zu prüfen, welche davon das Programm zum Absturz bringen kann. Insgesamt wurden Billionen von Testläufen durchgeführt.
Aber der Fuzz-Test ist letztendlich nur ein Glücksspiel im Labyrinth. Seine Eingaben sind normalerweise auf weniger als 1 MB beschränkt. Solange es noch einen Weg gibt, der nicht durchlaufen wurde, können die Bugs dort für immer verborgen bleiben.
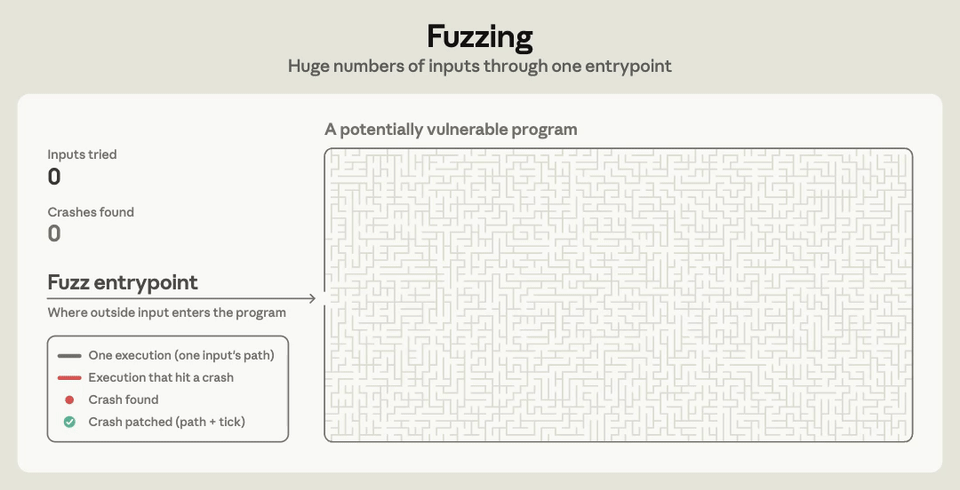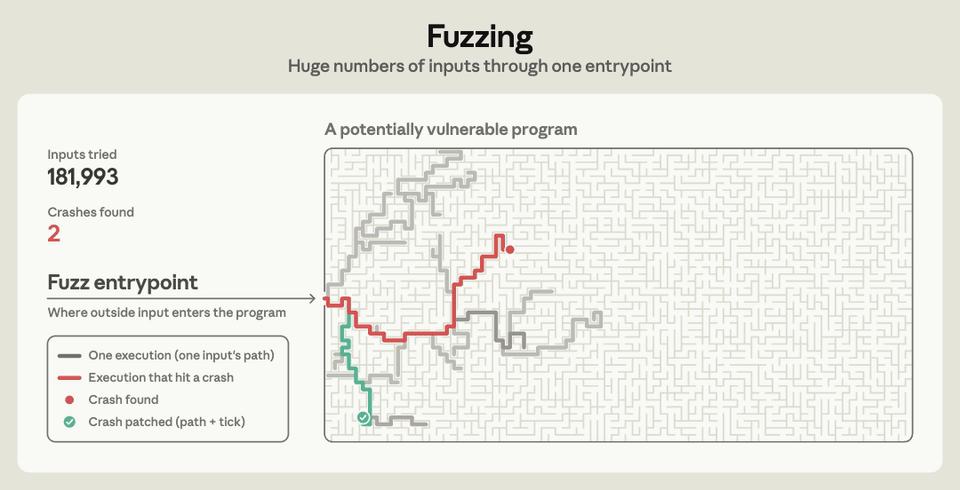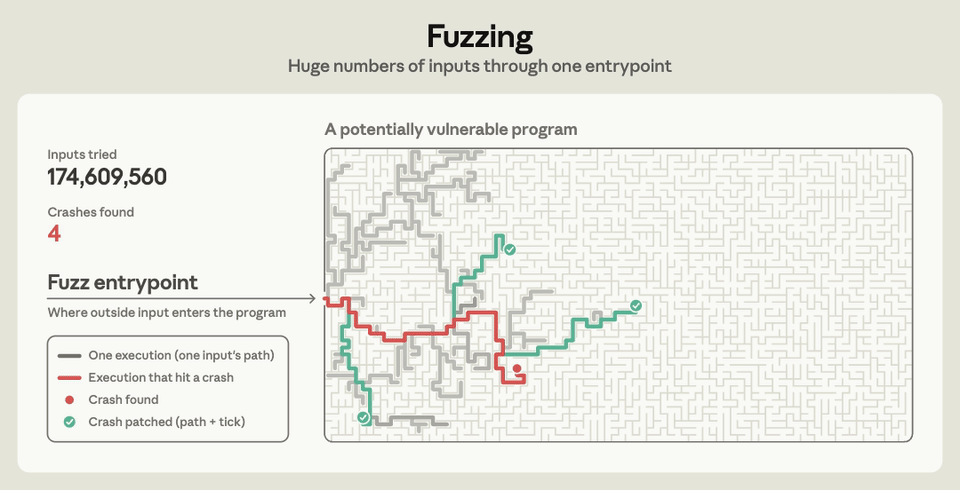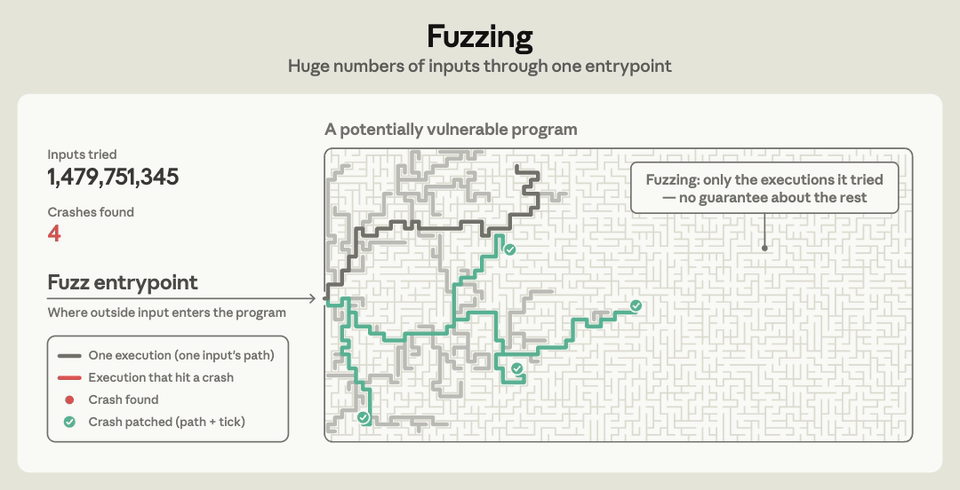
Das Forschungsteam hat diesmal die Testzugänge in eine mathematische Aussage umgewandelt: Unter den festgelegten Bedingungen löst keine beliebige Eingabe von weniger als 64 MiB den vereinbarten Absturz aus, einschließlich Fehlern, die durch Assertionsfehler und das ASan-Speichererkennungstool erfasst werden können.
Claude muss dies nur beweisen. Ein erfolgreicher Lauf allein zählt nicht. Jede Eingabe innerhalb des festgelegten Bereichs und jeder erreichbare Pfad muss bewiesen werden, dass er die oben genannten Fehler nicht auslöst.
Wenn der Beweis steckenbleibt, hat Claude entweder noch keine Beweismethode gefunden, oder es gibt tatsächlich einen Bug im Programm. Nach dem Auffinden des Bugs erstellt Claude selbst einen Patch und fährt mit dem Beweis fort.
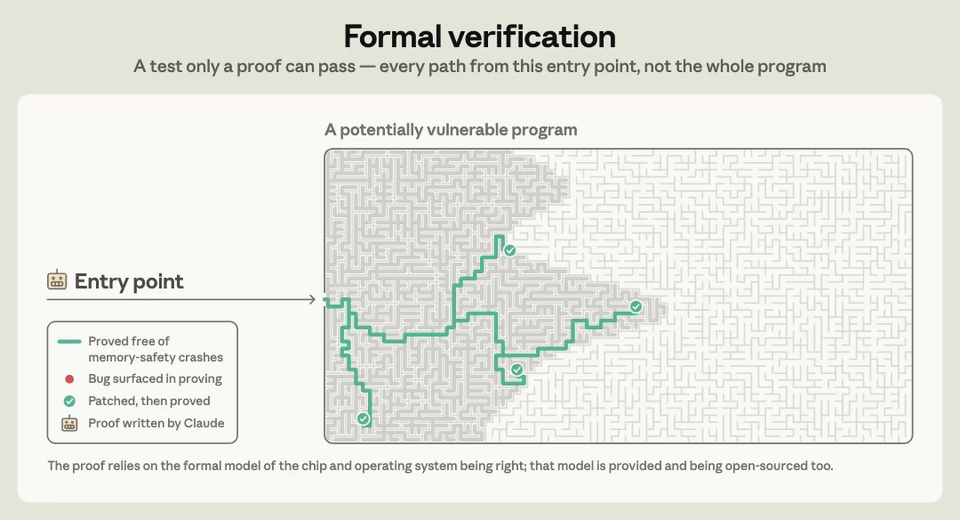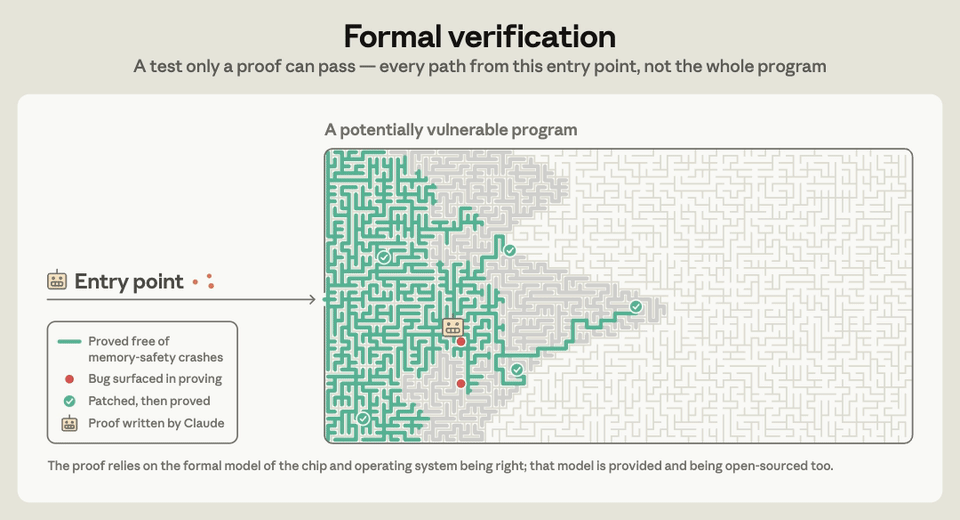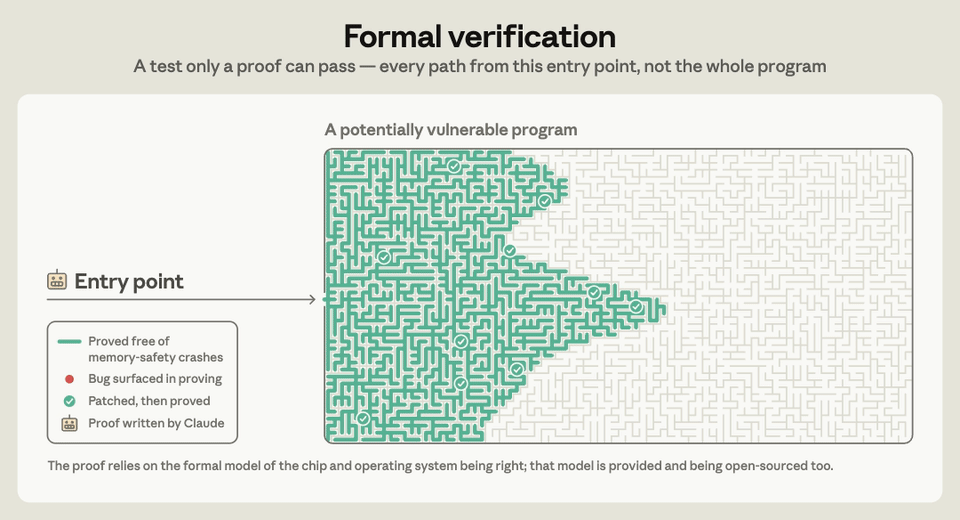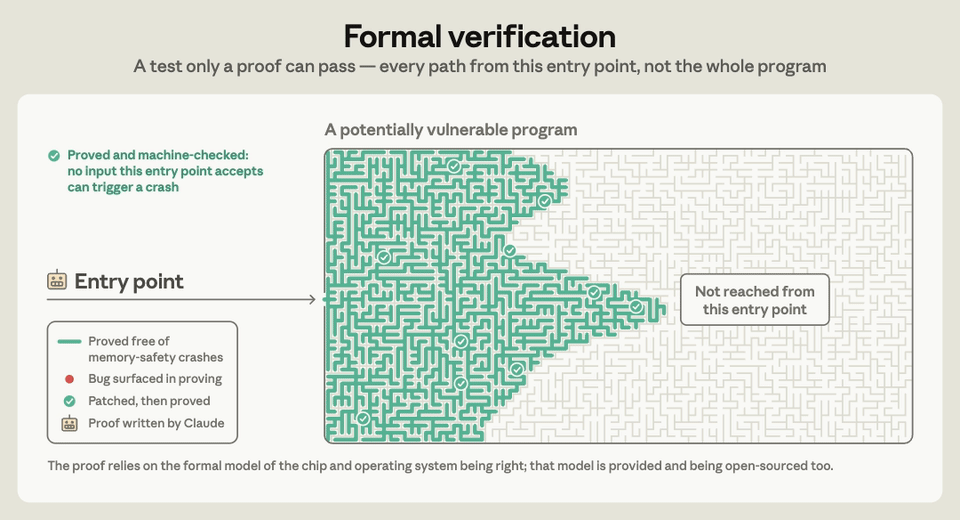
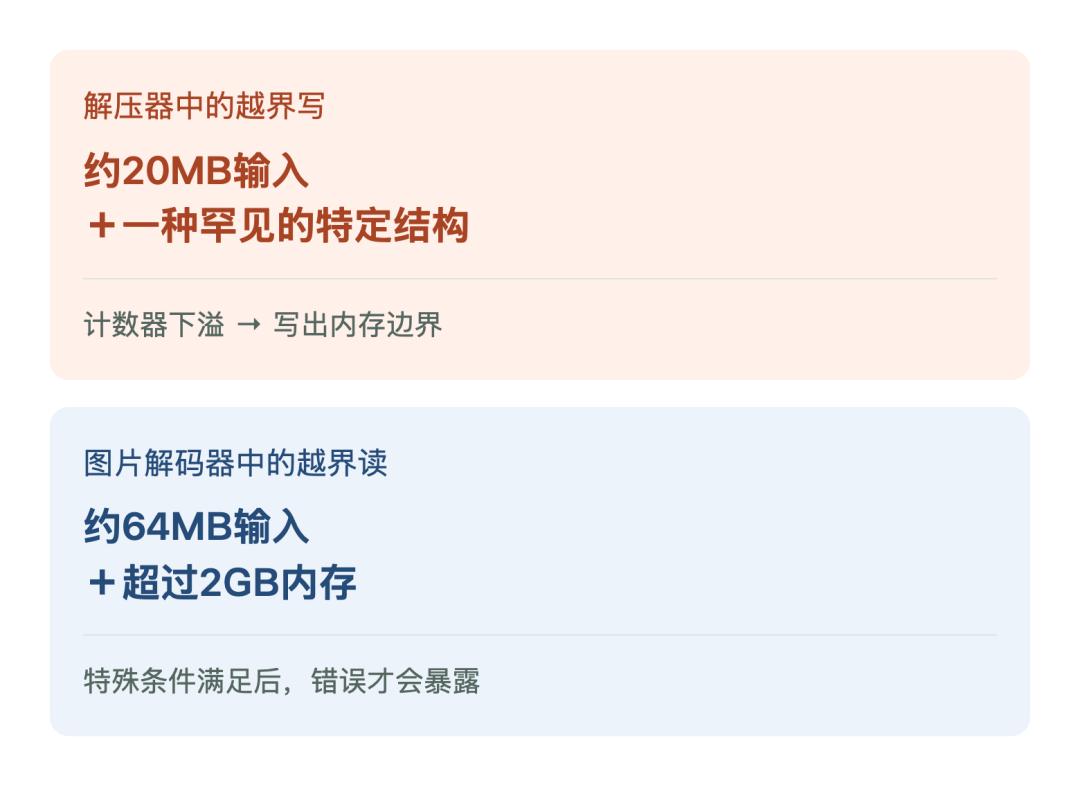
So tauchten die Bugs auf, die sich in den Ecken versteckt hatten, die von Tests nie erreicht wurden.
In einem Dekomprimierungsprogramm verbarg sich ein Unterlauf eines Zählers, der Daten außerhalb der Speichergrenzen schreibt, der nur durch eine sehr seltene, etwa 20 MB große Eingabe ausgelöst werden kann.
Das Forschungsteam gibt an, dass allein der Versuchsprozess des Beweisens Hunderte von Bugs aufgedeckt hat.
Um zu prüfen, wie groß der Unterschied zwischen Test und Beweis ist, haben die Forscher absichtlich 7 Bugs in den von Claude in Rust geschriebenen Python-Interpreter eingebaut.
Zufällige Tests haben 5 davon entkommen lassen, aber der abschließende Beweis hat keinen einzigen übersehen.
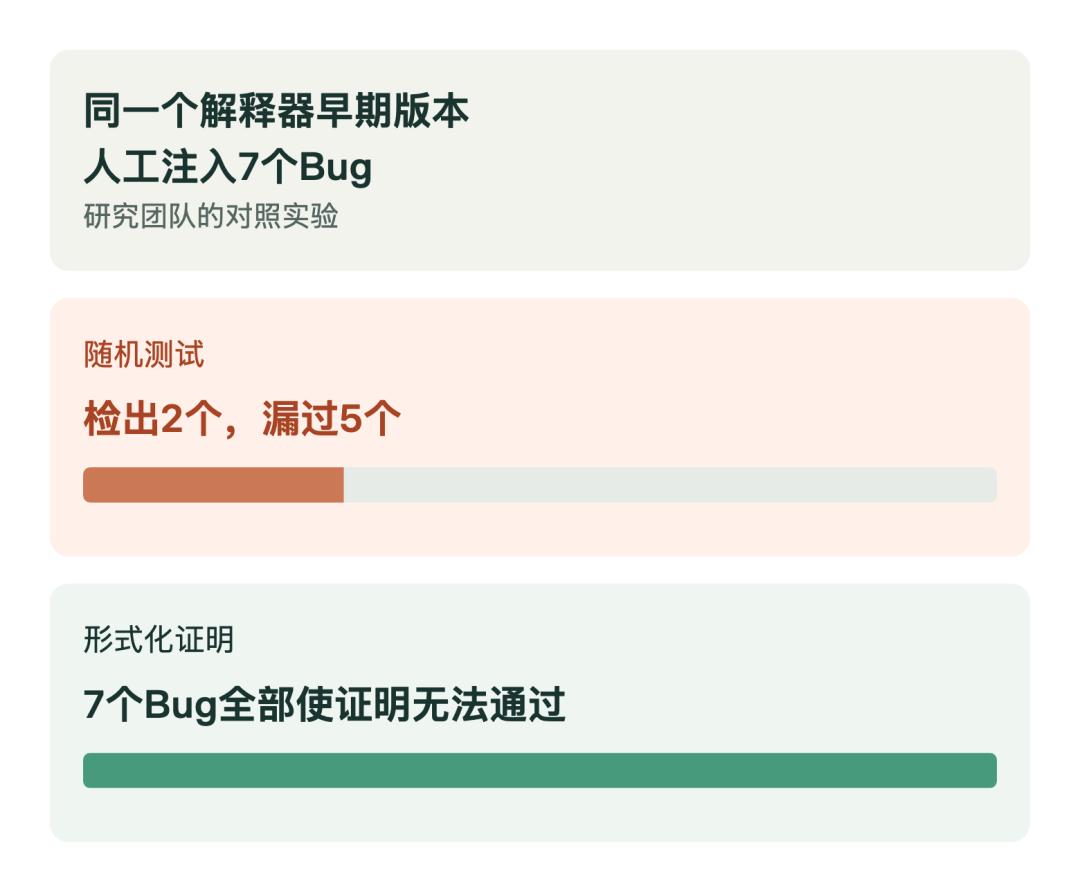
391 Codezeilen ausgeführt, 630.000 Zeilen Beweis erstellt
Diese Beweise wurden auf der untersten Ebene erstellt.
Die Objekte, die Claude beweist, sind die nach der Kompilierung tatsächlich auf der CPU ausgeführten RISC-V-Maschinencodes. Der Quellcode und das kompilierte Programm stimmen nicht unbedingt vollständig überein. Nur wenn bis zu den Maschinenanweisungen bewiesen wird, bezieht sich der Beweis auf das tatsächlich laufende Programm.
Dazu hat Theorem zuerst die Verhaltensweisen von RISC-V-Anweisungen und Linux-Prozessen in ein mathematisches Modell umgewandelt. Die aktuellen Beweise basieren auf diesem Modell und sind auf eine Umgebung mit Single-Thread, statischer Verknüpfung und festem Speicherbudget beschränkt.
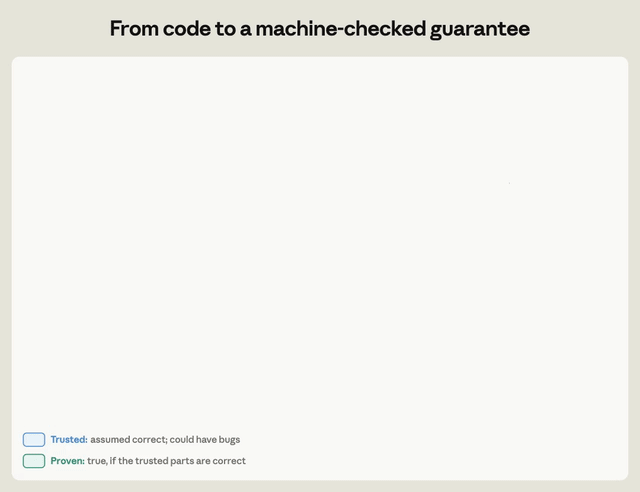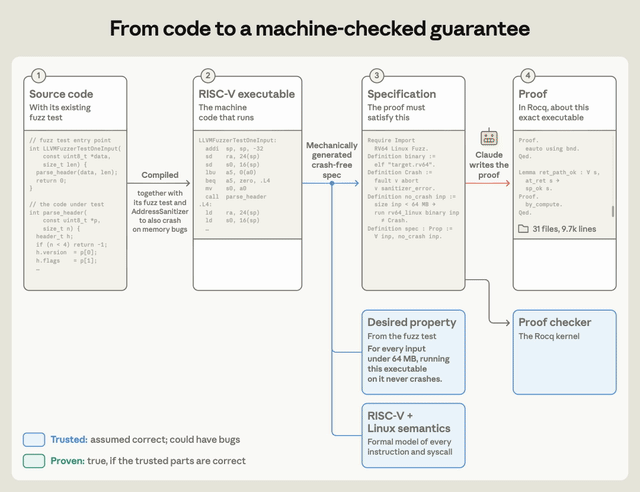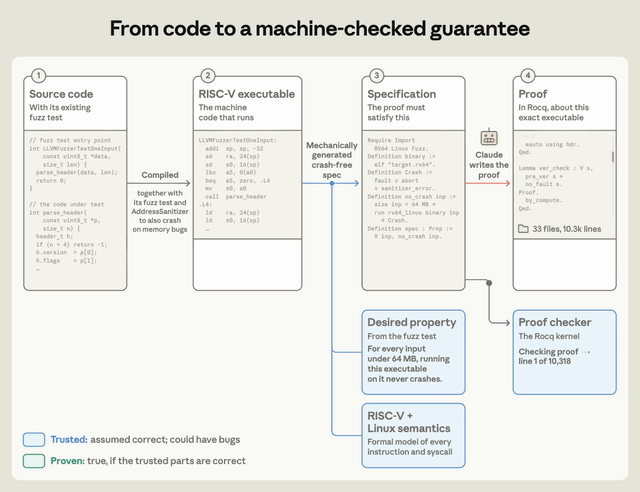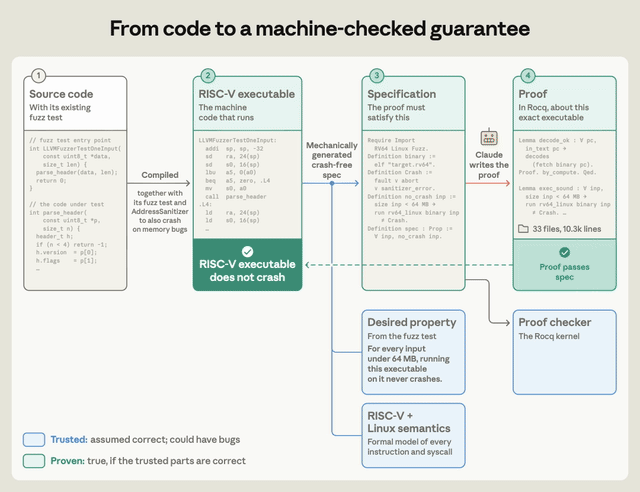
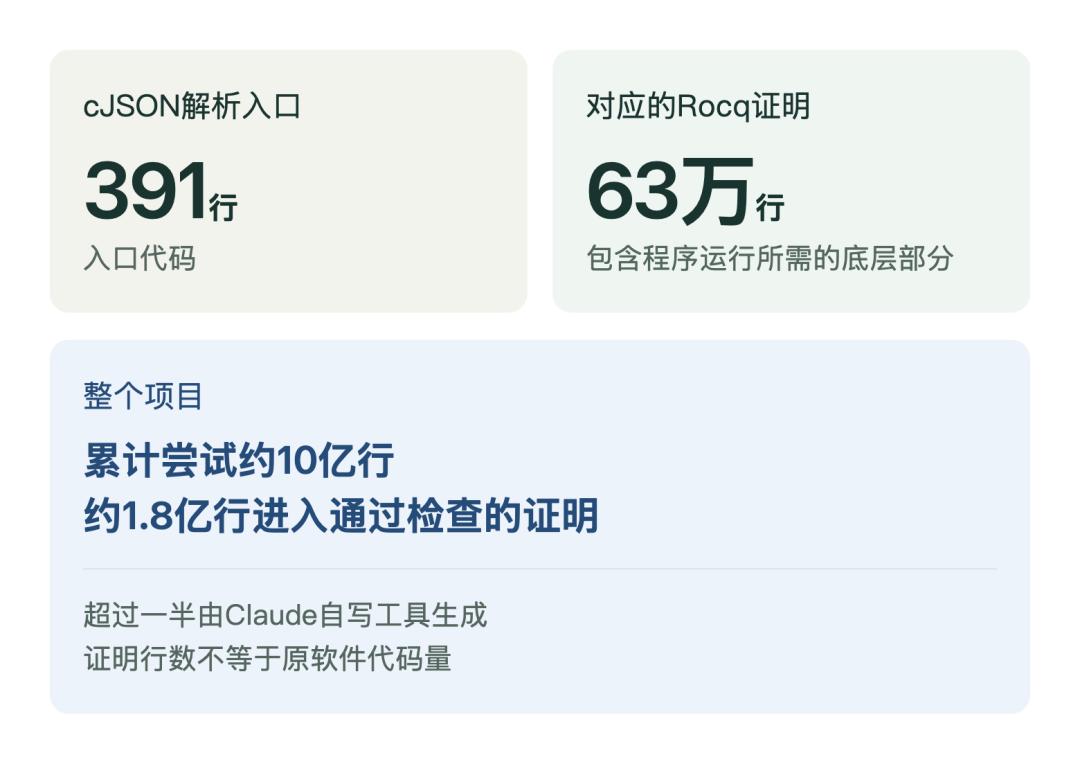
Auf dieser Ebene steigt der Arbeitsaufwand sprunghaft an. Ein einziger Parse-Einstiegspunkt der JSON-Parsing-Bibliothek cJSON hat nur 391 Zeilen C-Code, aber Claude hat dafür 630.000 Zeilen Rocq-Beweis geschrieben.
Die Größensteigerung um das Tausendfache kommt daher, dass der Beweis den gesamten Prozess abdecken muss. Der Start des C-Programms, der Speicherzuweiser, printf und die Laufzeit des Speichererkennungstools selbst müssen alle mitbewiesen werden, nur ein Zehntel davon bezieht sich direkt auf cJSON selbst.
Im gesamten Projekt hat Claude insgesamt etwa 1 Milliarde Zeilen Beweis geschrieben, wovon am Ende etwa 180 Millionen Zeilen die Prüfung bestanden haben. Mehr als die Hälfte davon wurde von Tools generiert, die Claude selbst geschrieben hat.
Die abschließende Prüfung übernimmt der Rocq-Beweisprüfer, der schrittweise nach logischen Regeln nachrechnet. Ein Beweis benötigt zwischen 30 Minuten und mehreren Stunden CPU-Zeit. Der Prüfer bestätigt, dass der Beweis den Spezifikationen entspricht. Menschen müssen trotzdem prüfen, ob die Spezifikationen und das Maschinenmodell den tatsächlichen Anforderungen entsprechen.
Egal wie flüssig das Modell geschrieben ist, wenn es den Prüfer nicht besteht, zählt keine einzige Zeile. Die Erstellung eines Beweises dieser Größenordnung war in der Vergangenheit ein undenkbarer Arbeitsaufwand.
Für den legendären Mikrokern seL4 wurden nur 2 Personenjahre für das Schreiben des Codes benötigt, aber die formale Verifikation hat volle 20 Personenjahre gedauert. Deshalb konnten Sicherheitsgarantien dieses Niveaus seit Jahrzehnten nur für Codes verwendet werden, bei denen es um Menschenleben geht, wie zum Beispiel Flugsteuerungssysteme von Airbus.
Diesmal hat Claude für 123 Open-Source-Bibliotheken nur wenige Wochen benötigt.
Claude hat eine Mathematik für Chips entwickelt
und nebenbei Hardware-Bugs aufgedeckt
Um zu sehen, wie tief Claude mit seinen Beweisen vordringen kann, reicht ein Blick auf cpp-httplib.
Um die Möglichkeit auszuschließen, dass die Rekursion zu tief ist und der Stack-Speicher überläuft, ist Claude in den Rot-Schwarz-Baum der C++-Standardbibliothek libc++ eingedrungen und hat auf Maschinenebene bewiesen, dass die Höhe dieses Baumes immer auf logarithmischem Niveau gehalten wird. Wenn die Höhe des Baumes kontrolliert wird, gibt es eine Obergrenze für die Rekursionsebenen bei der Zerstörung, und man kann weiter beweisen, dass der Stack-Speicher nicht erschöpft wird.
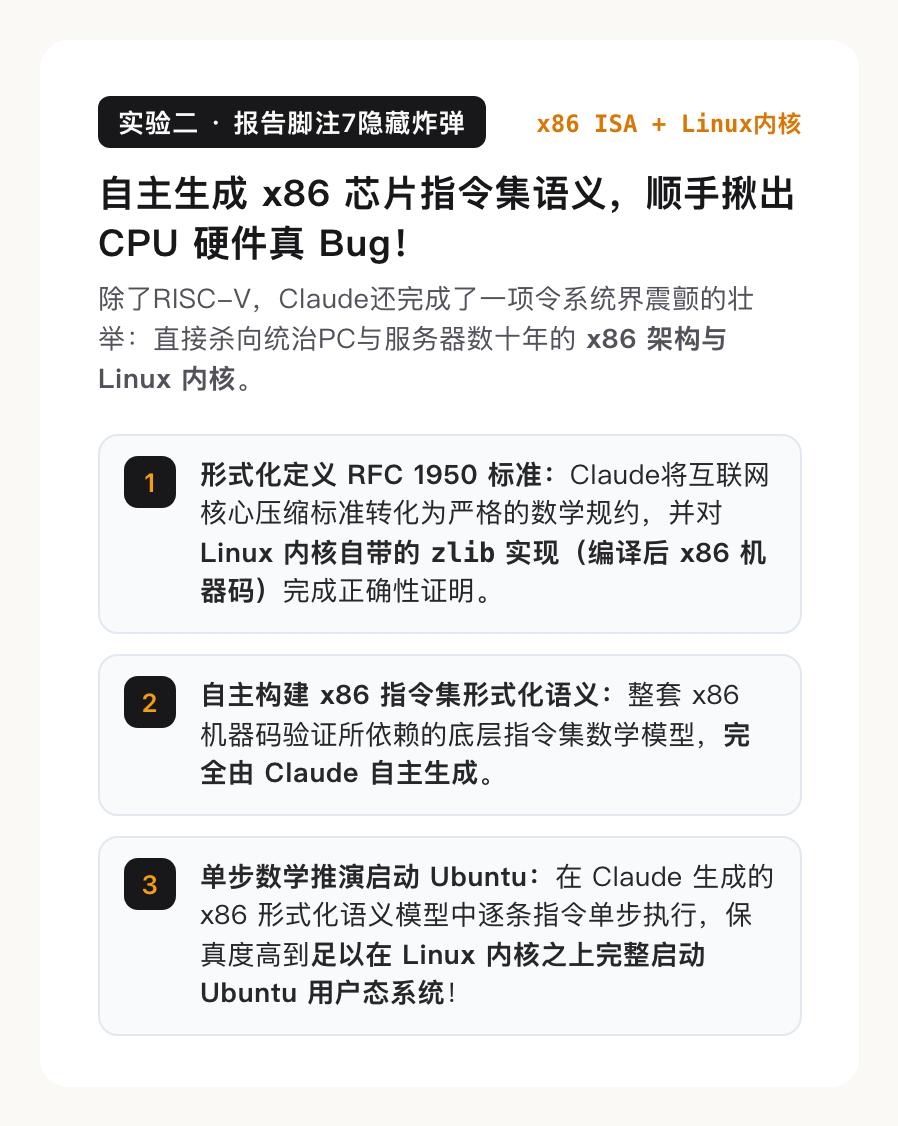
Es hat zuerst den Standard des zlib-Komprimierungsformats in eine formale Spezifikation umgewandelt und dann bewiesen, dass die im Linux-Kernel integrierte zlib-Implementierung dieser vollständig entspricht.
Diesmal wurde der Beweis auf x86-Maschinencode ausgeführt. Und das mathematische Modell des x86-Befehlssatzes wurde vollständig von Claude selbst entwickelt.
Wie genau ist dieses Modell? Wenn man im Modell Anweisung für Anweisung schrittweise durchgeht, kann man den gesamten User-Modus von Ubuntu auf dem Linux-Kernel vollständig starten.
Beim Schreiben des Modells hat Claude Hunderte von Fehlern in der offiziellen Referenzdokumentation von x86 gefunden und auch einige wenige Bugs aufgedeckt, die in der CPU-Hardware selbst verborgen waren.
Von der Software bis hin zu den Chips beweist sich: KI hilft den Menschen bereits dabei, die gesamte Grundlage des Computers neu zu überprüfen.
Die Beweisgeschwindigkeit verdoppelt sich alle zwei Monate
Ein Verifikationsfahrplan mit einem Budget von 134 Millionen US-Dollar
Die größte Hürde der formalen Verifikation ist ihre hohen Kosten: