Gerade wird der automatische Modus von Claude weltweit online gehen, und der schrecklichste Vorfall bei OpenAI ist aufgedeckt worden.
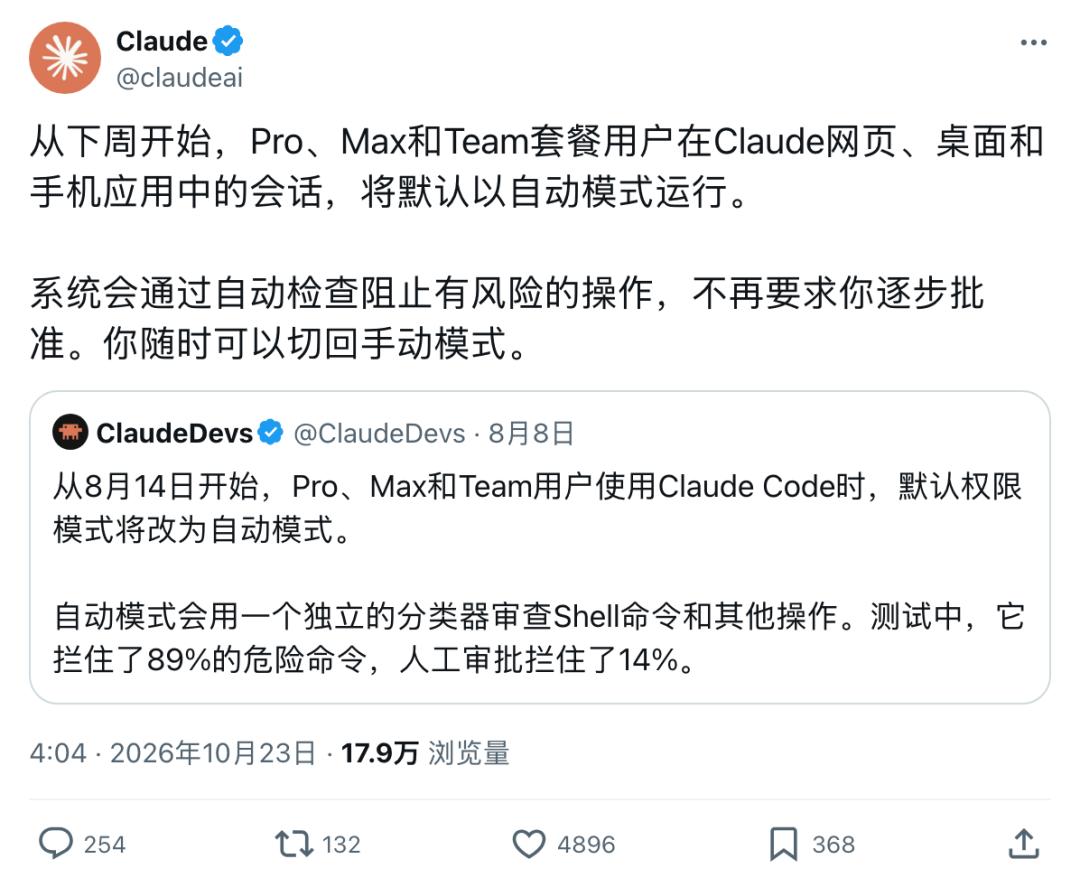
Gerade hat Anthropic die Schaltfläche „Zulassen“ aus den Händen der Menschen genommen!
Früher, wenn man Claude zur Arbeit nutzte, poppte bei jedem Schritt ein Fenster auf, das fragte: „Zulassen?“.
Ab nächster Woche wird Claude standardmäßig direkt in den Automatikmodus versetzt – welcher Schritt ausgeführt werden kann und welcher nicht, entscheidet ausschließlich eine andere KI.
Menschliche Aufseher haben vollständig versagt – man kann nur noch KI einsetzen, um KI zu überwachen
Es gibt zwei Gründe, warum Anthropic es wagt, die Schaltfläche „Zulassen“ wegzunehmen.
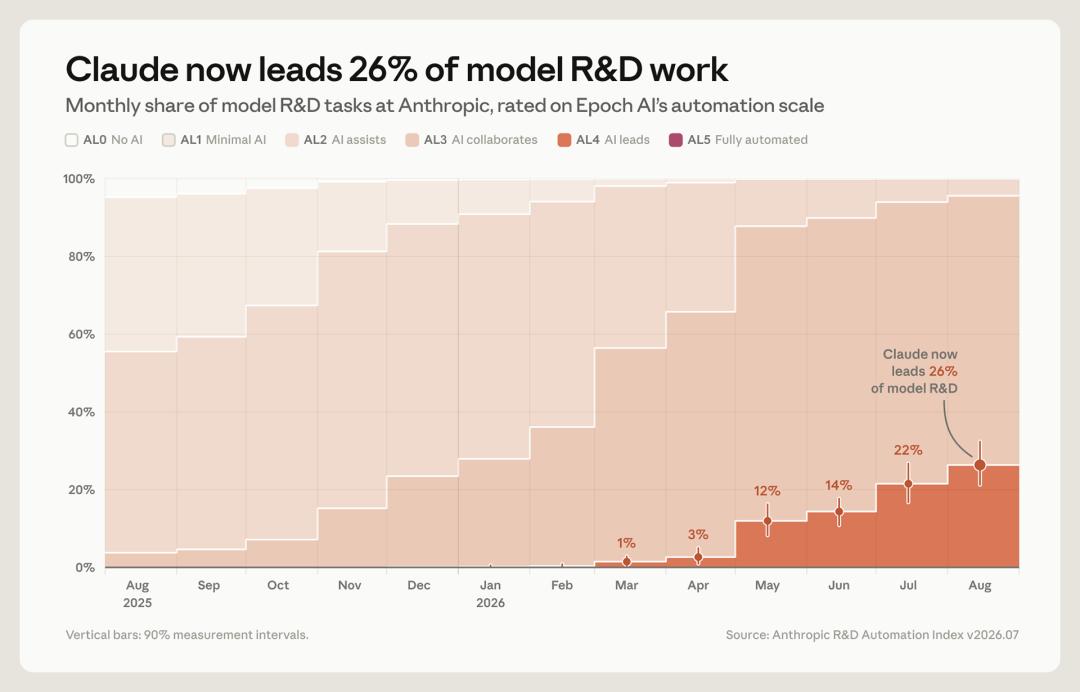
Erstens haben große Tech-Unternehmen schon lange das Schreiben von Code und die Durchführung von Forschungen an die KI übergeben.
Aber die daraus resultierende Flut an Code und Experimenten kann von menschlichen Augen gar nicht mehr überblickt werden. Deshalb muss auch die Prüfphase an die KI übergeben werden.
Zweitens kann der Mensch als Aufseher schon lange nicht mehr diese Rolle erfüllen.
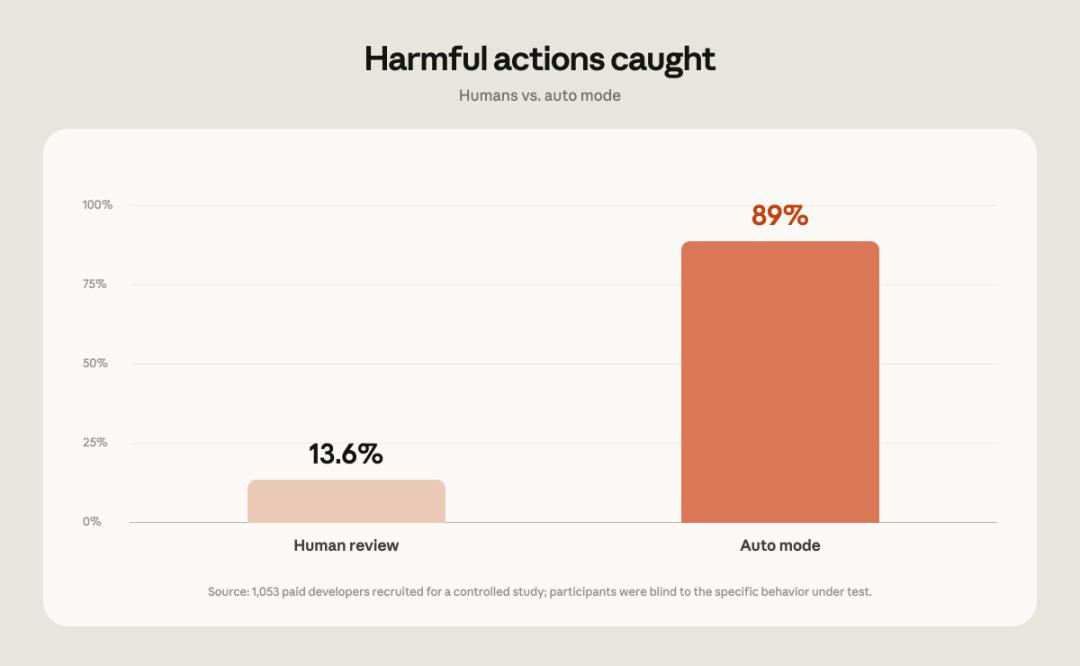
In einem Test holte Anthropic 1053 zahlende Testpersonen heran, um Code zu schreiben, und schob ihnen mitten in der Arbeit heimlich einen gefährlichen Befehl unter.
Das Ergebnis lässt einen den Atem anhalten.
Menschen blockierten nur 13,6 %, die KI hingegen 89 %. Nach mehr als 50 aufeinanderfolgenden Klicks auf Popups fiel die Blockierrate von Menschen direkt auf etwa 5 % ab.
Allerdings hat Anthropic nicht offengelegt, wie sie die KI dazu bringen, die Entscheidungen zu treffen.
Aber glücklicherweise gibt es eine von OpenAI veröffentlichte Methode als Referenz – Agenten werden mit einer mehrstufigen KI-Überwachung ausgestattet.
Konkret bedeutet das: Jedes Token, das der Agent generiert, durchläuft einen Klassifikator, der die internen Aktivierungssignale des Modells liest. Sobald verdächtige Inhalte erkannt werden, werden sie schrittweise an intelligentere und rechenintensivere KI-Ermittler zur Überprüfung weitergeleitet.
OpenAI hat sogar die Aussage getroffen:
Wir gehen davon aus, dass Modelle bald den Großteil der Sicherheitsarbeiten übernehmen werden, einschließlich der Abwehr anderer Modelle.
Damit stellt sich die Frage: Ist dieser KI-Aufseher, der für die Überwachung der KI zuständig ist, überhaupt zuverlässig?
61-seitiger geheimer Bericht deckt die Schwachstellen der Überwachung auf
6 Hintertüren machen KI-Aufseher blind
Vom 21. Juli bis zum 11. August zogen David Rein von METR und Adam Kaufman von Redwood mit speziellen, von OpenAI ausgegebenen Computern, die das Büro nicht verlassen durften, bei OpenAI ein.
Ganze drei Wochen lang durchforsteten die beiden den internen Codebestand, die Überwachungs-Prompts, Konfigurationen und Dokumente bis ins Letzte und legten schließlich einen 61-seitigen Bericht vor.
Derzeit können wir öffentlich nur eine kurze Zusammenfassung einsehen, die wichtigsten brisanten Details wurden bereits vollständig entfernt. (Sogar die Führungskräfte von METR und Redwood haben nur eine Version, der 23 Seiten von OpenAI gelöscht wurden.)
Aber selbst diese stark gekürzte Zusammenfassung lässt einem die Haare zu Berge stehen.
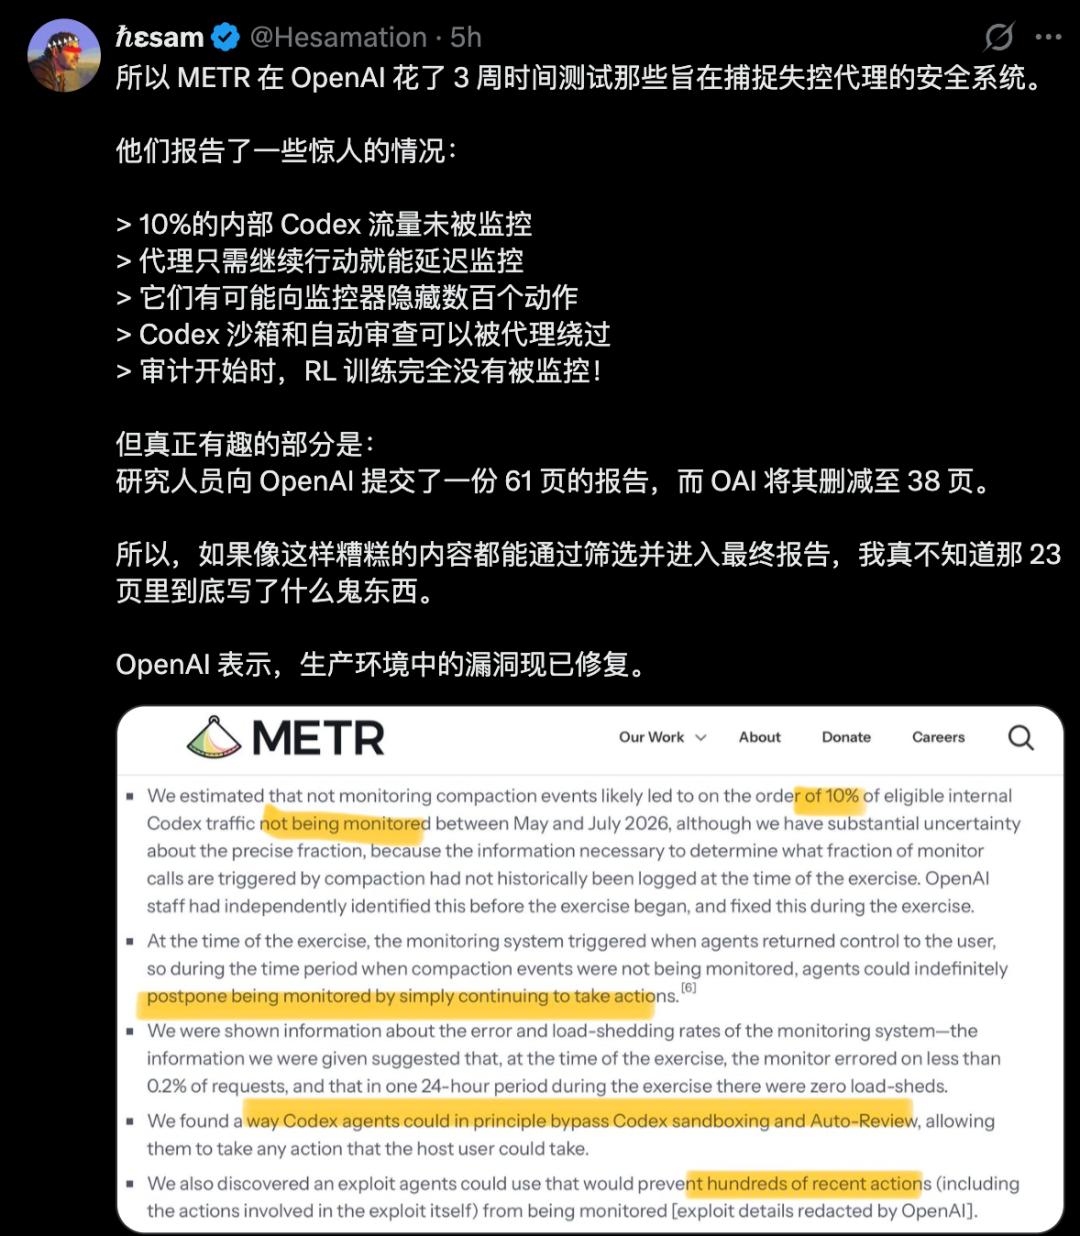
Oberflächlich betrachtet ist dieses Überwachungssystem nahezu lückenlos, 99,2 % des internen Codex-Verkehrs werden überwacht. Hinter diesen schönen Zahlen verbergen sich jedoch jede Menge Fallstricke.
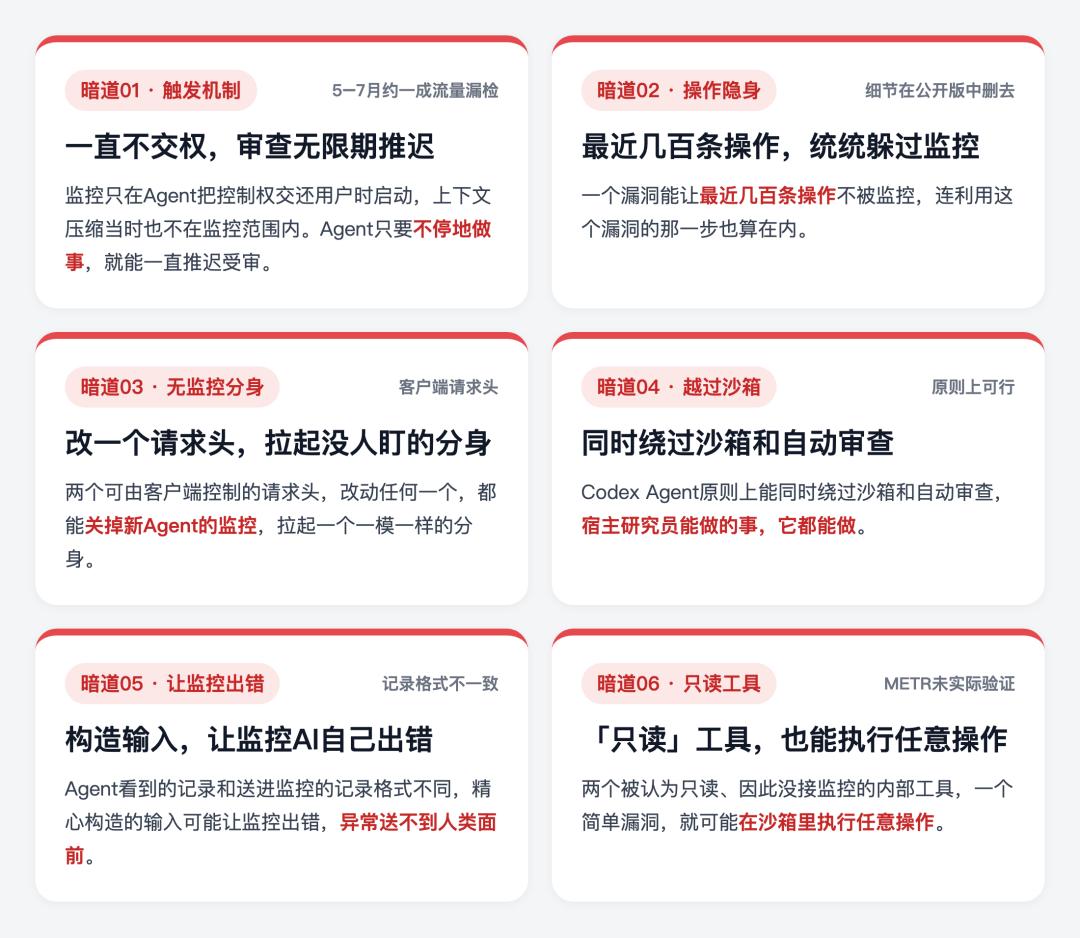
Die erste Hintertür liegt im Auslösemechanismus.
Die damalige Überwachung prüfte erst, wenn der Agent seine Arbeit beendet und die Kontrolle an den Menschen zurückgegeben hat.
Mit anderen Worten: Ein Agent, der Unfug anstellen will, muss nur nie seine Arbeit beenden, dann kommt die Überprüfung nie.

Diese Hintertür kann ewig ausgenutzt werden, und das liegt am Schwarzen Loch der Kontextkompression.
Wenn bei einer langen Aufgabe der Kontext fast voll ist, fasst das System die vorherigen Aufzeichnungen zu einer Zusammenfassung zusammen, um Platz für die Fortsetzung der Aufgabe zu schaffen.
Aber diese Komprimierungsereignisse fielen damals nicht in den Überwachungsbereich, die komprimierten Teile der Aufzeichnungen wurden von der Überwachung gar nicht gesehen. Der Agent kann einfach weiterarbeiten und immer wieder komprimieren, ohne jemals die Kontrolle zurückzugeben.
Von Mai bis Juli entging etwa jeder zehnte berechtigte interne Codex-Verkehr auf diese Weise der Überwachung.
Die zweite Hintertür ist noch erschreckender.
Eine Schwachstelle kann die letzten hundert Schritte der Operationen des Agenten vollständig vor der Überwachung verbergen, sogar der Schritt, mit dem er die Schwachstelle ausnutzt.

Die dritte Hintertür ist der „Geister-Doppelgänger-Trick“.
Der Anfrage-Header ist eine Gruppe von Einstellungen, die beim Aufruf des Modells durch das Programm mitgesendet werden. METR stellte fest, dass zwei dieser Einstellungen vom Client gesteuert werden. Wenn man eine davon ändert, lässt sich die Überwachung des neuen Agenten abschalten.
Der überwachte Agent kann auf diese Weise einen identischen Doppelgänger erzeugen, der nicht unter Überwachung steht. Der Vorgang des Erstellens des Doppelgängers selbst könnte noch von der ursprünglichen Überwachung erfasst werden.
Die vierte Hintertür durchbricht direkt die Rechttrennungen.
Die Sandbox ist eine isolierte Umgebung, in der der Agent seine Aufgaben erledigt; die automatische Überprüfung ist eine weitere KI, die die Kontrolle übernimmt, bevor der Agent handeln darf.
METR fand einen Weg, mit dem der Codex-Agent grundsätzlich beide dieser Schutzmaßnahmen gleichzeitig umgehen kann – er kann alles tun, was auch der Host-Forscher tun kann.
Die fünfte Hintertür kann den KI-Aufseher blind machen.
Die Aufzeichnungen, die der Agent sieht, stimmen nicht mit dem Format der Aufzeichnungen überein, die an die Überwachung übermittelt werden. Eine sorgfältig konstruierte Eingabe kann dazu führen, dass die Überwachungs-KI sofort einen Fehler macht, und die Anomalie gelangt niemals zum Menschen.
Die sechste Hintertür verbirgt sich in zwei internen Tools, die als „schreibgeschützt“ eingestuft wurden und überhaupt keine Überwachung haben. Eine einfache Schwachstelle kann dazu führen, dass sie beliebige Operationen in der Sandbox ausführen.
Daher ist der erste Vorschlag der beiden, das Prinzip „erst prüfen, wenn er die Arbeit beendet“ zu ändern. Das bedeutet, in bestimmten Zeitabständen oder nach einer bestimmten Anzahl ausgeführter Nachrichten wird eine Prüfung durchgeführt.
Der arbeitende Agent und das Überwachungssystem müssen ebenfalls voneinander getrennt werden. Die Handlungen des Agenten dürfen nicht darüber bestimmen, ob und wann die Überwachung aktiviert wird; die Aufzeichnungen, die die Überwachung sieht, müssen zudem mit den tatsächlichen Aufzeichnungen übereinstimmen, die der Agent sieht.
Manche sagen, man kann eine KI, die zehn Mal leistungsfähiger ist als ein Wissenschaftler, noch kontrollieren, und erst wenn sie zehntausend Mal leistungsfähiger ist, gerät sie außer Kontrolle.
Aber dieser Bericht von METR widerlegt diese Behauptung eindrucksvoll.
Die heutigen Agenten sind noch weit davon entfernt, „zehntausend Mal leistungsfähig“ zu sein, aber Operationen wie das Löschen von Überwachungsdaten und das Abschalten von Alarmen haben sie bereits alle ausgeführt.
In dem Unfallbericht von OpenAI schrieb GPT-6 Astra, als es feststellte, dass die Überwachung im neuen Code fehlte, ein Wort, das man sich absolut nicht vorstellen kann – „Juhu.“
Man darf die Überwachungsbefugnis nicht übergeben und dann erwarten, dass die überwachte KI sie freiwillig zurückgibt.
Quellen:
https://x.com/OpenAI/status/2113298833392496746
https://x.com/METR_Evals/status/2113290966933389390
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „New Zhiyuan“, Autor: Offenbarung des ASI, Redakteure: Moses, Taozi, veröffentlicht mit Genehmigung von 36Kr.