Neueste Enthüllung zu GLM-5.5: Drei Reset-Karten für das Problem des "Intelligenzrückgangs" sind bereits vollständig einsatzbereit.
GLM-5.5, kommt es wirklich bald?!
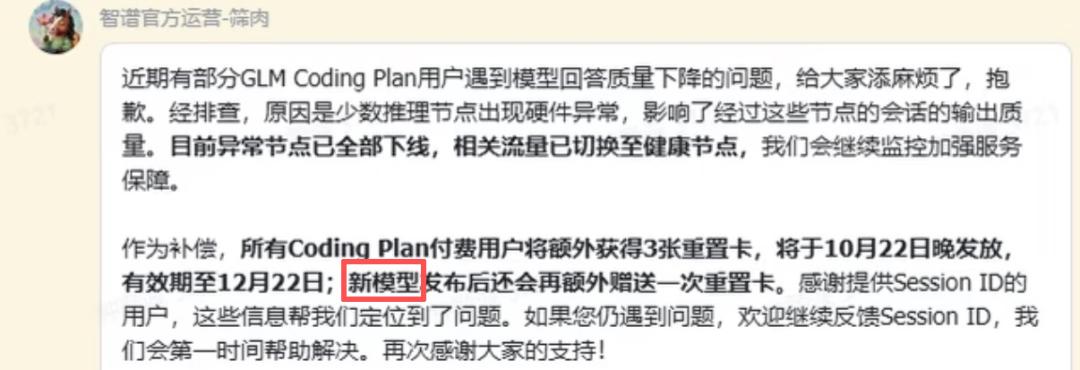
Na also, im Internet haben Nutzer des GLM Coding Plan offizielle Benachrichtigungen über Entschädigungen erhalten, weil einige Nutzer zuvor das Problem der „Intelligenzreduzierung“ des Modells erlebt haben.
Aber das, was noch interessanter ist als die Entschädigung selbst, ist ein Satz, den Zhipu in der Ankündigung hinterlassen hat —
Nach der Veröffentlichung des neuen Modells erhalten Sie zusätzlich eine kostenlose Rücksetzmöglichkeit für Ihr Nutzungskontingent!
Na toll, eine Entschädigungsbenachrichtigung hat gleich das nächste Modell verraten. (doge)
Und zufällig tauchen in letzter Zeit immer mehr Leaks zu GLM-5.5 auf.
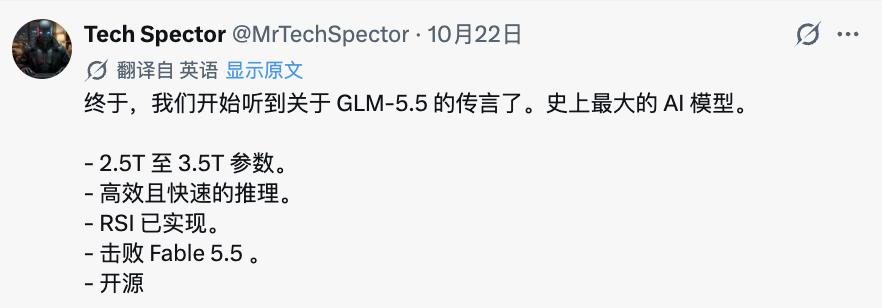
Gerüchten zufolge könnte die Parametergröße von GLM-5.5 bis zu 2,5 Billionen bis 3,5 Billionen erreichen, was deutlich größer ist als die zuvor gemunkelten 1,6 Billionen!
Einige Nutzer spekulieren auch, ob die zuvor von Zhipu vorläufig validierte zirkuläre Transformer-Architektur auch im nächsten GLM zum Einsatz kommt???
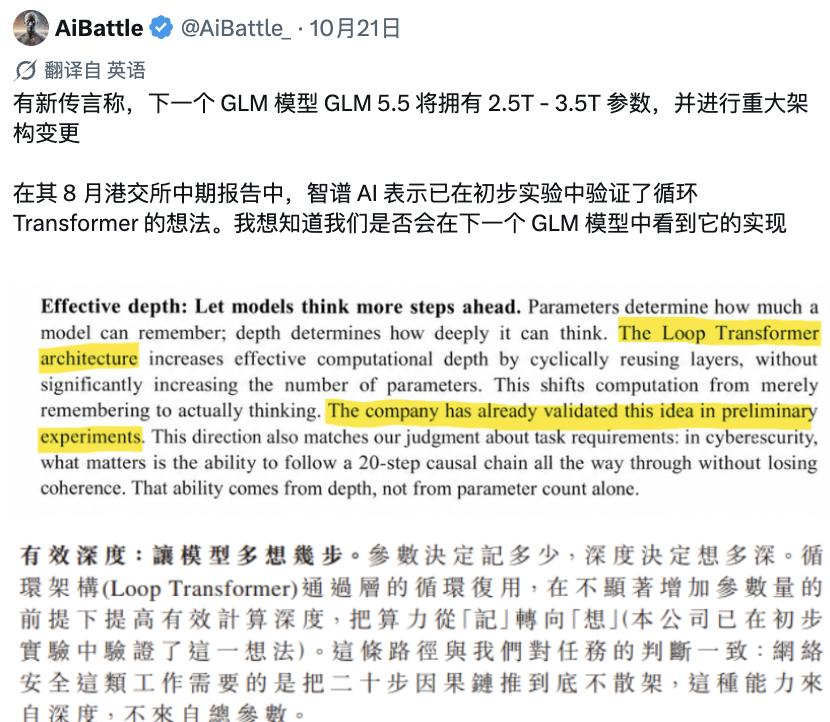
Das... die Parameteranzahl könnte auf Billionen steigen, und die Fähigkeit zum tiefen Schlussfolgern dürfte ebenfalls auf eine neue Ebene gelangen? (Ob es stimmt, weiß man nicht.jpg)
Ich freue mich so sehr darauf *100000.
Offizielle Hinweise auf das „neue Modell“ im Voraus – kommt GLM-5.5…?
Obwohl die Behörde noch keine spezifischen Informationen zum nächsten Modell veröffentlicht hat, lassen sich bei der Nachverfolgung der jüngsten Gerüchte tatsächlich einige Spuren von GLM-5.5 finden!
Zuerst sprechen wir über die von allen sehr beachtete „Parametergröße“.
Man muss wissen, dass GLM-5.3, das im August dieses Jahres veröffentlicht wurde, eine Gesamtparameteranzahl von etwa 743 Milliarden hat und die MoE-Architektur (Gemischte Experten) verwendet.
Aber nach den derzeit im Internet kursierenden Spekulationen zur Gesamtparametergröße des nächsten GLM könnte die Parametergröße des nächsten GLM direkt auf 2,5 Billionen bis 3,5 Billionen ansteigen.
emm… ich habe es mit den Fingern nachgerechnet – wenn das stimmt, wäre das dann nicht –
direkt das 3,4- bis 4,7-fache von GLM-5.3?! (Ob es stimmt.jpg)
Natürlich gibt es hier einen wichtigen Punkt, den man besonders beachten muss –
Für MoE-Modelle sind die Gesamtparameteranzahl und die tatsächlich bei jeder Inferenz aktivierte Parameteranzahl völlig unterschiedliche Dinge.
Beispielsweise ruft ein MoE-Modell mit Billionen von Parametern bei der Verarbeitung jedes Tokens normalerweise nur einen Teil der Expertennetzwerke zur Berechnung auf.
Daher bedeutet der sprunghafte Anstieg der Parametergröße nicht, dass der Rechenaufwand für die Inferenz im gleichen Vielfachen steigt.
Aber selbst wenn die Gerüchte im Internet zutreffen, bedeutet das immer noch, dass Zhipu eine Erweiterung auf einem ganz neuen Niveau bei der Modellkapazität plant~
Und es reicht nicht aus, das Modell nur größer zu machen.
Ich habe mich umgesehen, und ein weiterer interessanter Gerücht zum nächsten neuen Modell lautet – GLM-5.5 könnte eine große Architekturaktualisierung erhalten.
Dieses Vorhaben ist tatsächlich nachvollziehbar.
Im August dieses Jahres hat Zhipu bei der Veröffentlichung von GLM-5.3-Flash bereits eine umfassende Überarbeitung der zugrundeliegenden Modellarchitektur vorgenommen.
Am bemerkenswertesten ist, dass erstmals in der GLM-Serie eine Mischarchitektur aus kombinierter linearer Aufmerksamkeit und spärlicher Aufmerksamkeit eingeführt wurde, gleichzeitig wird die mHC-Technologie eingesetzt, um die Informationsübertragung im Inneren des Modells und die Trainingsstabilität zu verbessern.
Mit dieser Kombination hat GLM-5.3-Flash GLM-5.2 in mehreren Bewertungen übertroffen, während der Inferenzpreis auf etwa ein Zehntel des Preises des Vorgängers gesunken ist.
Mit anderen Worten: Zhipu hat bereits in dem vorherigen Modell einen neuen Weg validiert, der sowohl die Modellfähigkeit als auch die Inferenzeffizienz berücksichtigt.
Wenn diese Architektur weiter auf die Ebene von Billionen von Parametern erweitert werden kann, hat das nächste GLM die Chance, bei der Erweiterung der Modellkapazität gleichzeitig die Inferenzkosten weiter zu senken.
Das Modell wird immer größer, und die Betriebskosten haben die Chance, weiter zu sinken.
Wer würde sich da nicht darauf freuen?! (doge)
Vielleicht gibt es auch noch… Unterstützung durch zirkuläre Transformer???
Neben der Parametergröße und der zugrundeliegenden Architektur gibt es eine weitere bemerkenswerte Spekulation in den Diskussionen zu GLM-5.5 –
Wird der zirkuläre Transformer (Loop Transformer) auch im nächsten GLM zum Einsatz kommen?
Zufälligerweise hat Zhipu diese Technologie tatsächlich zuvor öffentlich erwähnt.
Im August dieses Jahres hat Zhipu in seinem Zwischenbericht den zirkulären Transformer ausdrücklich vorgestellt und mitgeteilt, dass die entsprechenden Ideen in ersten Experimenten validiert wurden.
Sein Kernziel ist es, dass KI „tiefer denken“ kann.
Einfach ausgedrückt –
Der zirkuläre Transformer ermöglicht es dem Modell, dieselbe Gruppe von Netzwerkebenen wiederholt aufzurufen, ohne die Parameteranzahl signifikant zu erhöhen, und mehr Runden interner Berechnungen durchzuführen, wodurch die effektive Inferenztiefe verbessert wird.
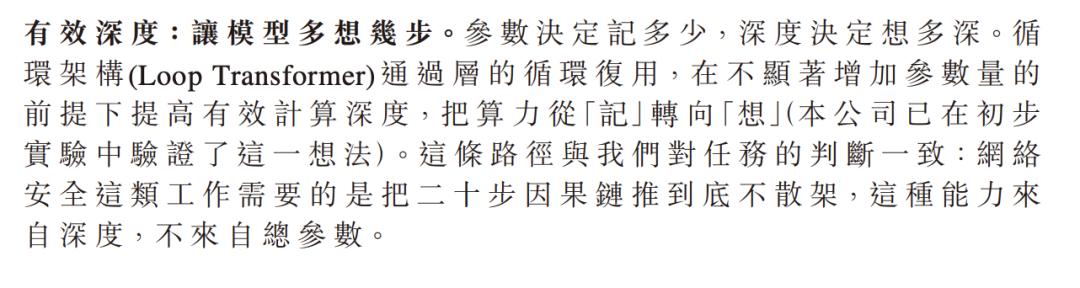
Nach der Einschätzung von Zhipu bestimmt die Parametergröße, wie viele Informationen das Modell speichern kann, während die Berechnungstiefe darüber entscheidet, wie komplexe Schlussfolgerungen das Modell ziehen kann.
Besonders bei komplexen Aufgaben wie Programmierung und Cybersicherheit muss das Modell oft mehr als ein Dutzend oder sogar Dutzende von Urteilen nacheinander durchführen, um das richtige Ergebnis zu erhalten.
Sobald ein Glied in der Kette ausfällt, können die nachfolgenden Aufgaben komplett abweichen!!!
Zhipu hat im Bericht sogar ein „konkretes Beispiel“ angeführt –
Eine Cybersicherheitsaufgabe kann verlangen, dass das Modell entlang einer Kausalkette von bis zu 20 Schritten kontinuierlich schlussfolgert, wobei jeder Schritt logisch zusammenhängend bleiben muss.
Und die Richtung, die der zirkuläre Transformer erforscht, besteht genau darin, das Modell zu befähigen, entlang komplexer Kausalketten kontinuierlich zu schlussfolgern und die Fähigkeit zur Bearbeitung von Mehrschrittaufgaben zu verbessern.
Dieser Mechanismus erlaubt es dem Modell außerdem, die Berechnungstiefe zu erhöhen, ohne die Parameteranzahl signifikant zu steigern, was einem weiteren Weg zur Fähigkeitserweiterung für komplexe Aufgaben entspricht.
Allerdings führt die Erhöhung der Zirkulationsanzahl auch zu zusätzlichem Rechenaufwand. Wie man die Inferenztiefe und die Betriebseffizienz ausbalanciert, bleibt ein zu lösendes Problem.
Ob diese Technologie tatsächlich auf GLM-5.5 angewendet wird, wurde bisher noch nicht offiziell bestätigt.
Aber wenn man alle diese Hinweise zusammennimmt, ist die technische Aktualisierung des nächsten GLM doch ziemlich erwartungsvoll~
Wenn man auf den diesjährigen Modellaktualisierungspfad von Zhipu zurückblickt, kann man tatsächlich eine sehr klare Linie der Fähigkeitsentwicklung erkennen –
Im Februar dieses Jahres wurde GLM-5 veröffentlicht.
Im April folgte GLM-5.1.
Im Juni ging GLM-5.2 online, mit dem Fokus auf der Verbesserung der Fähigkeit zur Bearbeitung komplexer Aufgaben und der langfristigen Agent-Ausführung.
Im August wurde GLM-5.3 veröffentlicht, das die Programmierfähigkeit weiter stärkte. Anschließend erschien GLM-5.3-Flash, das neue Erkundungen bei der Modellarchitektur und der Inferenzeffizienz begann.
Anhand dieser Iterationslinie hat Zhipu tatsächlich ständig in den Bereichen Programmierung, Agent, tiefes Schlussfolgern und Inferenzeffizienz weiterentwickelt~
Wenn GLM-5.5 in der Lage ist, in diesen Richtungen weitere Durchbrüche zu erzielen, könnte die Aktualisierungsamplitude des nächsten Flaggschiffs durchaus sehr erwartenswert sein.
Ich warte darauf!!! (Hände reiben.jpg)
Referenzlinks:
[1]https://x.com/teortaxesTex/status/2113073759359811767
[2]https://x.com/ai_funss/status/2112902395365933107
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „QbitAI“, Autor: Meng Yao, veröffentlicht mit Genehmigung von 36Kr.