96 Roboter evolvieren gemeinsam, ihre Erfolgsrate übertrifft die der Menschen. Die Tsinghua-Universität, AgiBot und Wuwen Xinqiong haben gemeinsam das Konzept des „kollektiven Erfahrungslernens“ vorgeschlagen.
Jede Ausführung eines Roboters in der realen Welt erzeugt Erfahrung. Wie diese Erfahrungen nutzbar gemacht werden können, stellt seit langem ein schwieriges Problem dar. Die traditionelle Vorgehensweise stützt sich auf manuelle Korrekturen: Fernbediener überwachen die Ausführung der Roboter, übernehmen die Steuerung bei Fehlern der Strategie und geben die korrekten Aktionen vor. Dieses Modell kann bei wenigen Robotern noch aufrechterhalten werden, aber mit zunehmender Größe des Clusters kann die menschliche Überwachung der steigenden Nachfrage früher oder später nicht mehr folgen.
Um dieses Problem zu lösen, hat das gemeinsame Team der Tsinghua-Universität, von AgiBot und Wuyuan Core Dome das Kollektive Erfahrungslernen (CEL) vorgeschlagen, ein Lernparadigma, das es bereits eingesetzten Robotern ermöglicht, Ausführungserfahrungen zu teilen und dieselbe Strategie gemeinsam zu verbessern.
Link zum Papier: https://arxiv.org/abs/2610.25736
Die algorithmische Umsetzung von CEL ist das fehlergeführte erfahrungsbasierte Retrieval-Finetuning (FERT): Mithilfe des Kontexts, in dem der Roboter bei der Ausführung scheitert, werden relevante Trajektorienausschnitte aus den erfolgreichen Erfahrungen abgerufen, die vom gesamten Cluster gemeinsam geteilt werden, und die darin aufgezeichneten Aktionen werden als Überwachungssignal zur Aktualisierung der Strategie verwendet. Der gesamte Prozess erfordert keine zusätzliche Erfassung von Expertenvorführungen oder Korrekturaktionen. Menschen müssen nur jede Ausführung als erfolgreich oder fehlgeschlagen markieren und die Umgebung zurücksetzen, während die Aktionen selbst vollständig von den Robotern bereitgestellt werden.
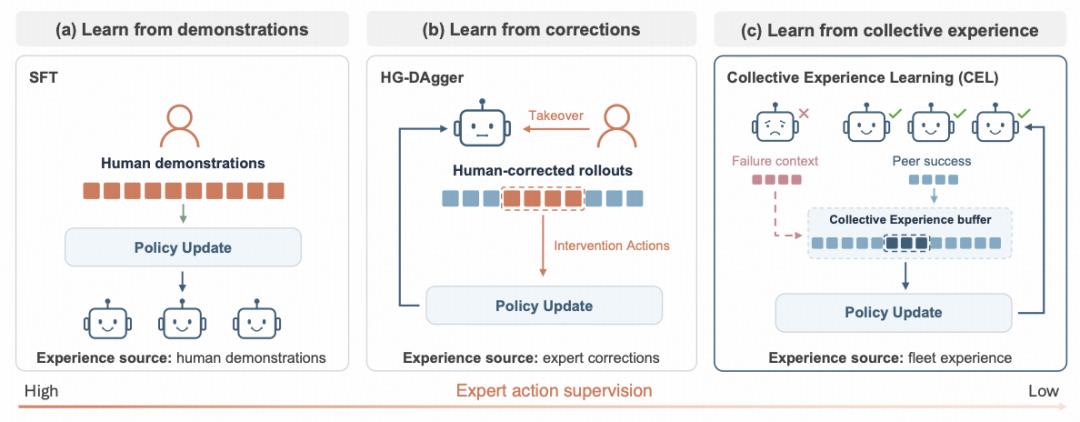
Abbildung | Drei Erfahrungsquellen für das Lernen von Roboterstrategien: menschliche Vorführung, Expertenkorrektur und kollektive Erfahrung des Clusters
Um das kontinuierliche Lernen in großen Clustern zu unterstützen, hat das Team zudem ein fehlertolerantes asynchrones Trainingssystem (FATS) aufgebaut. Auf diese Weise können die Erfahrungserfassung, die Strategieoptimierung und die Strategieverteilung fortgesetzt werden, selbst wenn einzelne Roboter im Cluster aufgrund von Störungen, Zurücksetzungen oder Wartungsarbeiten unterbrochen werden.
Bei fünf realen Bedienaufgaben wie Verpacken von Mobiltelefonen, Blumenarrangieren und Falten von Kleidung führte das Forschungsteam 120 Versuche für jede Aufgabe durch. Die an der Bewertung beteiligten Roboter waren nicht an der Erfassung der Trainingsdaten beteiligt, und die Erfolgsrate der endgültigen Strategie erreichte 93,3 % bis 99,2 %. Wenn die Erfassungsdauer pro Roboter festgelegt und nur die Anzahl der Roboter erhöht wird, ist der Cluster größer und die Anzahl der Erfahrungen steigt, sodass die Leistung von FERT im Allgemeinen besser wird. Bei der mehrstufigen Aufgabe des Mobiltelefonverpackens stieg die Aufgabenerfolgsrate nach dem Lernen mit 96 Robotern von 79,2 % auf 98,3 %.
Diese Ergebnisse zeigen, dass kollektive Erfahrung eine praktikable und erweiterbare Grundlage für das Roboterlernen sein kann: Mit zunehmendem Umfang der Bereitstellung wächst das Angebot an Erfahrungen synchron, ohne dass die Expertenüberwachung im gleichen Verhältnis ausgeweitet werden muss. Dies bietet einen Weg für Roboter, die Zuverlässigkeit ihrer Strategien während des Einsatzes kontinuierlich zu verbessern.
1. Forschungsmethoden
Die algorithmische und systemische Umsetzung von CEL sind FERT und FATS.
Der Kerngedanke von FERT lässt sich in einem Satz zusammenfassen: Erfolge liefern Nachahmungsvorlagen, Fehler bestimmen, was gelernt wird. Der konkrete Ablauf gliedert sich in die folgenden vier Schritte:
- Erster Schritt: Asynchrone Erfahrungserfassung. Die Roboter im Cluster führen Aufgaben kontinuierlich und autonom aus, und jede abgeschlossene Trajektorie wird mit dem binären Ergebnis „erfolgreich“ oder „fehlgeschlagen“ markiert. Erfolgreiche Trajektorien gelangen als Lernmaterial in den Puffer für kollektive Erfahrungen; fehlgeschlagene Trajektorien liefern keine Aktionen und dienen nur als Hinweis für das Retrieval. Dies gewährleistet, dass das System aus Fehlern lernen kann, ohne die fehlgeschlagenen Aktionen nachzuahmen.
- Zweiter Schritt: Erfahrungskodierung. Die Ausgabe des eingefrorenen visuellen Encoders des VLA (nach räumlicher Pooling) und die propriozeptiven Gelenkzustände werden jeweils normalisiert und anschließend zusammengefügt, um eine einheitliche Retrieval-Darstellung zu bilden, sodass die Erfahrungen verschiedener Roboter miteinander verglichen werden können.
- Dritter Schritt: Fehlergeführtes Retrieval, der Schlüssel dieser Methode. Ein binäres Label kann nur angeben, dass eine Trajektorie fehlgeschlagen ist, aber nicht feststellen, an welcher Stelle der Fehler aufgetreten ist. FERT verwendet die Beobachtungssequenz etwa 3 Sekunden vor dem fehlgeschlagenen Endpunkt als Abfrage und findet mithilfe der dynamischen Zeitnormalisierung von Teilsequenzen mit Steigungsbeschränkung (S-DTW) zeitlich ausgerichtete und zustandsähnliche erfolgreiche Ausschnitte in der Bibliothek der erfolgreichen Erfahrungen. Intuitiv ausgedrückt beantwortet dies die Frage: „Wie muss man in einer ähnlichen Situation vorgehen, um erfolgreich zu sein?“
- Vierter Schritt: Prioritäts-Finetuning. Die abgerufenen Ausschnitte erhalten eine höhere Abfragepriorität, sodass häufig auftretende fehlerhafte Situationen dazu führen, dass die zugehörigen erfolgreichen Verhaltensweisen häufiger gelernt werden. Gleichzeitig nimmt die Priorität exponentiell mit der Zeit ab, sodass das Lernen stets auf die aktuell fehleranfälligsten Teile der Strategie fokussiert bleibt. Die Aktualisierung der Strategie erfolgt durch Anpassung des Log-Likelihoods von Aktionsblöcken, ohne dass Wertfunktionen, Kritiker oder Vorteilsschätzungen erforderlich sind. Theoretisch hat das Team nachgewiesen, dass unter den Bedingungen des erfolgreichen Replay und der Retrieval-Ausrichtung die Aktualisierungsrichtung von FERT mit dem Ziel der Erhöhung der Aufgabenerfolgsrate übereinstimmt und die Retrieval-Gewichtung einen positiven Beitrag erster Ordnung leistet.
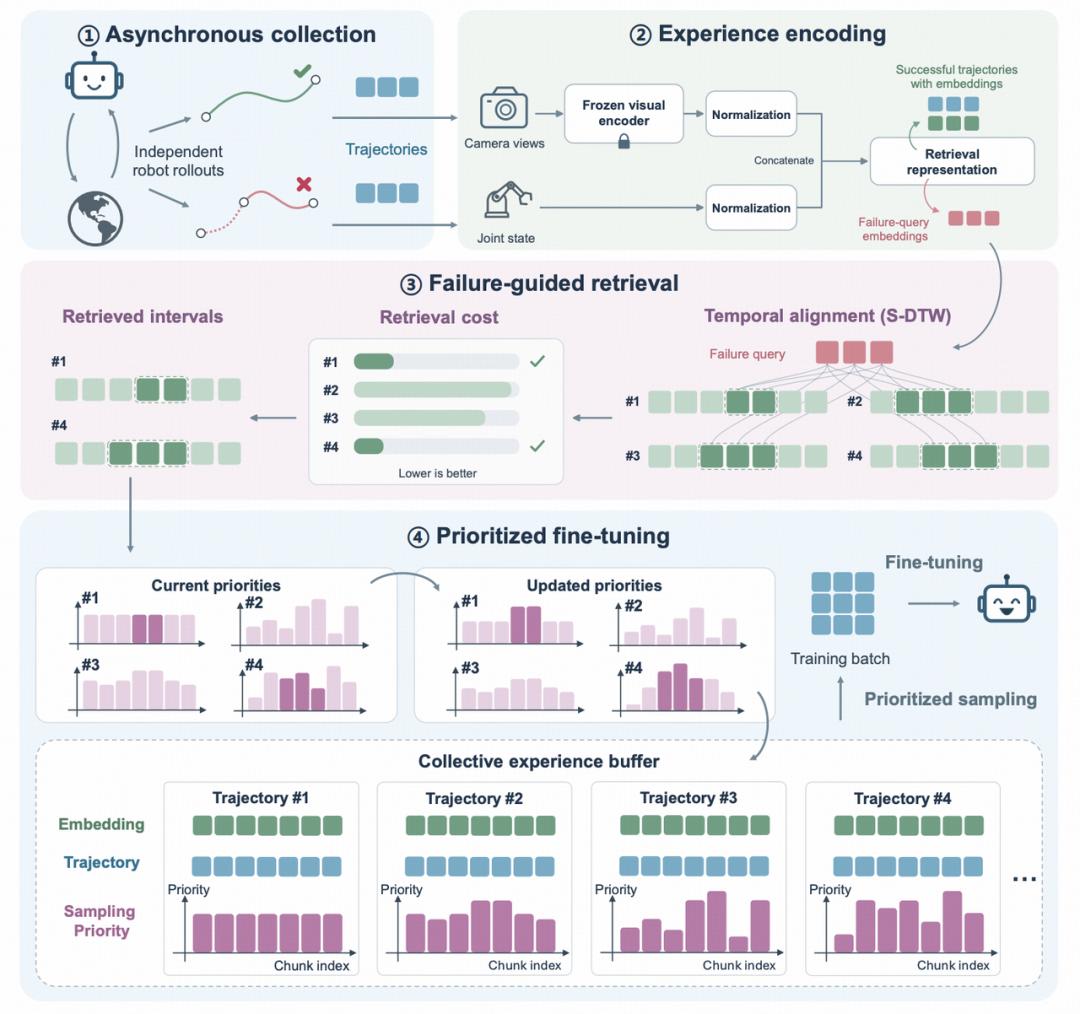
Abbildung | Gesamtablauf von FERT
Um diesen Lernzyklus von FERT auf einem realen Cluster zum Laufen zu bringen, ist der technische Schwierigkeitsgrad nicht geringer als der des Algorithmus selbst. Das Team weist auf zwei wichtige Eigenschaften hin: Erstens unterscheiden sich die zeitlichen Anforderungen von Interaktion und Erfahrung. Der Roboter muss vor der nächsten Aktion das Inferenzergebnis erhalten (Millisekundenbereich), während das Training vollständige Episodenaufzeichnungen erfordert (GB-Bereich, die nicht sofort eintreffen müssen). Zweitens können physische Roboter jederzeit unterbrochen werden. Im praktischen Betrieb mit 96 Robotern tritt durchschnittlich alle 22 Minuten ein Fehler bei einem Roboter auf.
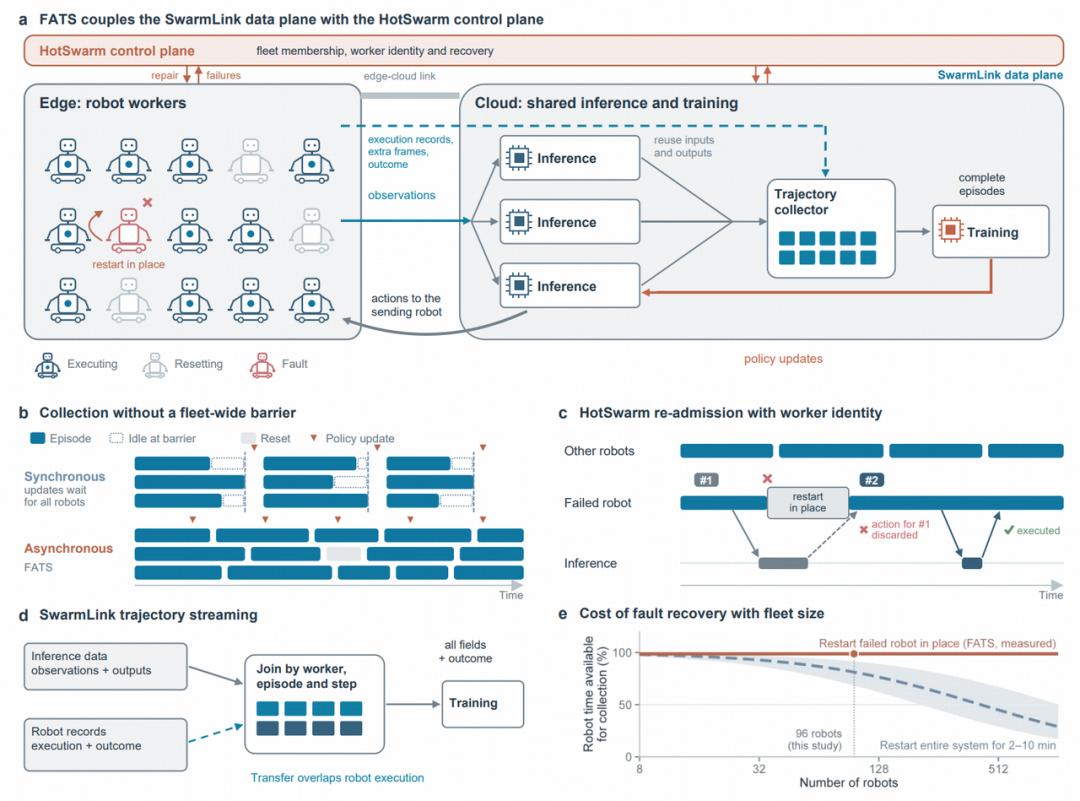
Abbildung | Architektur von FATS
Um diese beiden Probleme zu lösen, verwendet FATS eine Zweiebenenarchitektur.
Die Datenebene SwarmLink verbindet die Ausführung der Roboter mit der gemeinsamen cloudbasierten Inferenz und dem Training. Inferenzanforderungen werden in einen gemeinsamen Anforderungspool eingespeist, und angehaltene Roboter geben automatisch Rechenkapazität frei. Episodendaten werden während der Ausführung gestreamt hochgeladen, und die bereits für die Inferenz verwendeten Beobachtungen werden in der Cloud direkt wiederverwendet, um doppelte Übertragungen zu vermeiden. Interaktionsdaten haben Vorrang vor Batch-Trainingsdaten.
Die Steuerebene HotSwarm modelliert den Cluster als dynamische Mitgliedschaftsbeziehung. Die Lebenszyklen von „Arbeitsplätzen“ (festen Positionen, die Knoten, Geräte und Roboter binden) und „Arbeitern“ (Prozessen, die den Arbeitsplatz belegen) werden getrennt. Der Arbeitsplatz bleibt während des gesamten Trainings bestehen, während der Arbeiter jederzeit ausgetauscht werden kann. Bei einem Roboterfehler startet das System den zugehörigen Arbeiter vor Ort neu, baut die Verbindung mit einer neuen Versionsnummer wieder auf und spielt die unterbrochenen Aufrufe erneut ab, sodass die übrigen Roboter nicht beeinträchtigt werden. Abgelaufene Aktionen, die für fehlgeschlagene Arbeiter berechnet wurden, werden erkannt und verworfen, um zu verhindern, dass Daten mit falsch zugeordneten Aktionen und Beobachtungen das Training verunreinigen. Die Wiederherstellungsstrategie ist abgestuft gestaltet: Umgebungsarbeiter werden jederzeit vor Ort neu gestartet, wobei der maximale Verlust eine Episode beträgt. Trainingsarbeiter werden regelmäßig archiviert und aus dem neuesten Prüfpunkt wiederhergestellt, sodass der Optimiererzustand, der über mehrere Stunden angesammelt wurde, erhalten bleibt.
2. Experimentelle Ergebnisse
Die Experimente deckten fünf reale Tischbedienaufgaben ab: Blumenarrangieren (flexible Objekte), Falten von Kleidung (verformbare Stoffe), Aufladen von Mobiltelefonen (Einstecken, Ausstecken und präzises Ausrichten), Zusammenbauen von Hockern (kleine Objekte und Werkzeugnutzung) und Verpacken von Mobiltelefonen (mehrstufiges Platzieren, Dauer 2-3 Minuten). Als Hardware diente der zwearmige Roboter AgiBot G2, als Grundmodell π0.
Bei der maximalen Clustergröße jeder Aufgabe erhöhte das Mehrroboter-HG-DAgger die durchschnittliche Erfolgsrate der fünf Aufgaben von 36,3 % bei SFT auf 81,0 %. Ohne Verwendung zusätzlicher Experten Daten steigerte FERT den Durchschnittswert weiter auf 97,3 %, wobei die durchschnittliche Fehlerrate relativ um 86,0 % sank. Darunter stieg die Erfolgsrate beim Mobiltelefonaufladen von 60,0 % auf 97,5 %, die Fehlerrate sank relativ um 93,8 %; beim Verpacken von Mobiltelefonen stieg der Wert von 79,2 % auf 98,3 %.
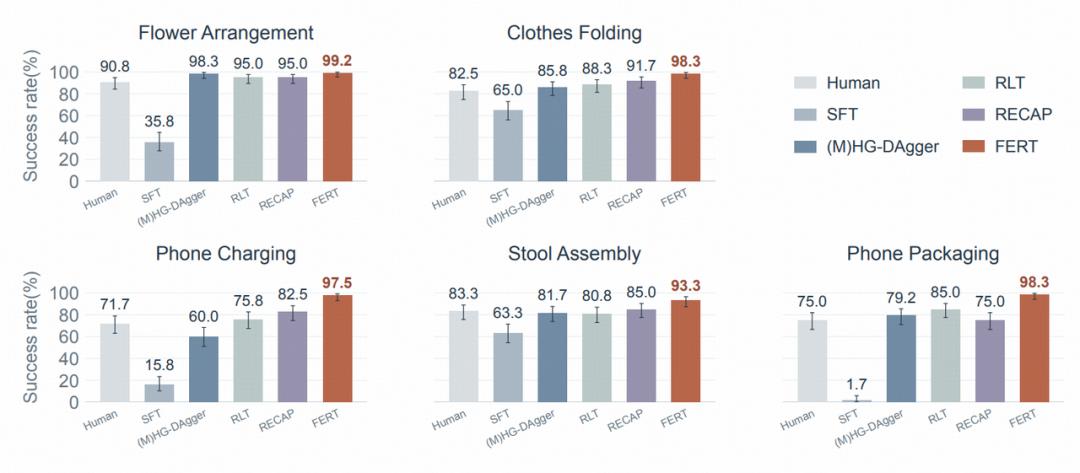
Abbildung | Hauptergebnisse der fünf Aufgaben
FERT übertraf das menschliche Fernbedienen bei allen fünf Aufgaben um durchschnittlich 16,7 Prozentpunkte, beim Mobiltelefonaufladen um 25,8 Prozentpunkte. Es übertraf zudem beide Baselines deutlich: das einrobotische Online-Reinforcement-Learning RLT (durchschnittlich um 12,3 Prozentpunkte höher) und das Offline-Reinforcement-Learning RECAP, das ebenfalls Clusterdaten verwendet aber Expertenkorrekturen beibehält (durchschnittlich um 11,5 Prozentpunkte höher).
Wenn die Erfassungszeit pro Roboter festgelegt und nur die Anzahl der Roboter erhöht wird, steigt die Erfolgsrate von FERT bei allen fünf Aufgaben insgesamt kontinuierlich an: Bei der Aufgabe des Mobiltelefonverpackens stieg die Erfolgsrate von 86,7 % auf 98,3 %, als das Trainingscluster von 16 auf 96 Roboter erweitert wurde. Im Gegensatz dazu erreichte das auf menschliche Eingriffe angewiesene HG-DAgger bei wachsendem Cluster eine Sättigung oder sogar einen Rückgang, da die begrenzte menschliche Überwachungs- und Eingriffsfähigkeit eine Obergrenze für die Leistung bildet. Das Angebot an Erfahrungen von FERT wächst hingegen natürlicherweise mit der Clustergröße, sodass die Erweiterungskurve „je mehr Roboter, desto besser das Lernen“ gültig bleibt. Es ist zu beachten, dass FERT bei kleinen Clustern unter der anfänglichen Strategie liegen kann, da die erfolgreichen Erfahrungen noch nicht ausreichen, um alle fehlerhaften Situationen abzudecken, auf die die Strategie stößt.
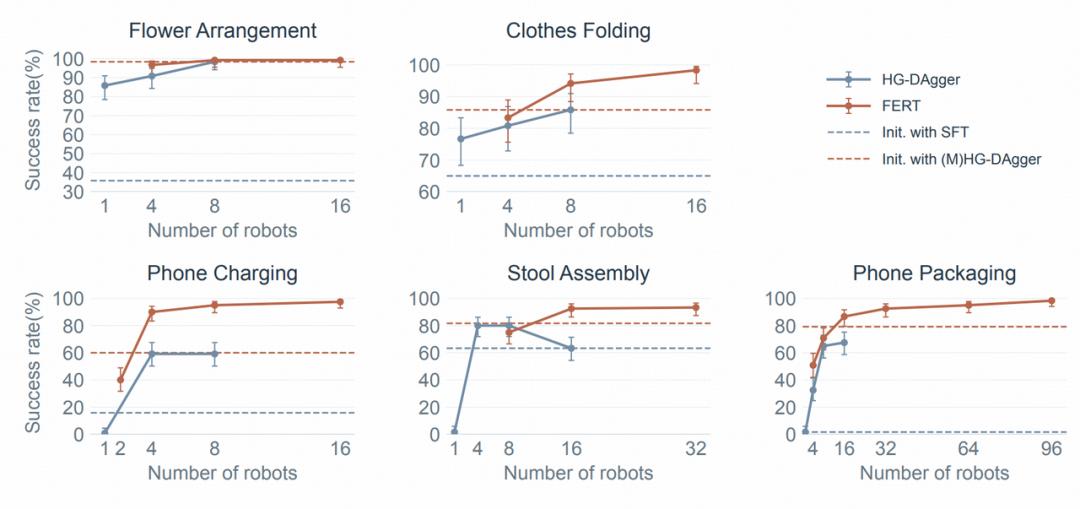
Abbildung | Skalierung mit der Clustergröße
Abschließend prüfte das Forschungsteam den Beitrag jeder Designentscheidung durch Ablationsexperimente. Die Ablationsprüfung bei der Aufgabe des Mobiltelefonverpackens (16 Trainingsroboter, Erfolgsrate der vollständigen Konfiguration 86,7 %) bestätigte die Wirkung jedes Designs. Nach Entfernung des fehlergeführten Retrievals fiel die Erfolgsrate auf 64,2 %, ein Rückgang um 22,5 Prozentpunkte – der größte Rückgang unter allen Ablationspunkten, was den Wert der „Auswahl von Erfahrungen nach fehlerhaften Situationen“ direkt bestätigt. Wenn die Erweiterung der Aktionskontexte vor und nach den abgerufenen Ausschnitten entfernt wurde, sank die Erfolgsrate auf 57,5 %, was zeigt, dass die Übereinstimmung der Aktionskontexte vor und nach den passenden Ausschnitten ebenso wichtig ist für das Lernen erfolgreichen Verhaltens