DeepSeek Open-Source-Inferenzframework: Jemand hat die Bruttomarge der KI auf 82 % berechnet.
Ich hätte nicht gedacht, dass dies auch als Open Source veröffentlicht wird.
Am Nachmittag des 20. Oktober veröffentlichte DeepSeek das intern genutzte Inferenz-Framework DeepInfer sowie die dazugehörige Token-Codec-Komponente deepseek-recipe als Open Source.
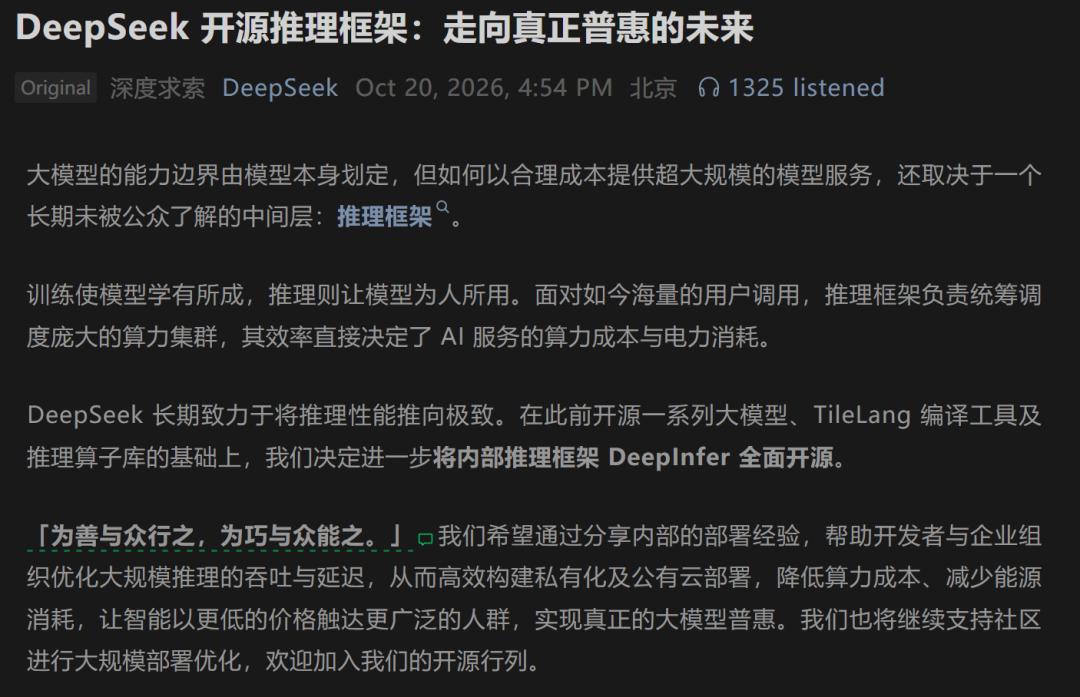
DeepInfer ist derzeit die Grundlage, die den groß angelegten Inferenzdienst von DeepSeek stützt. Es wird unter der Apache-2.0-Lizenz veröffentlicht und unterstützt aktuell DeepSeek-V4.1-Flash.
Diese Veröffentlichung hat schnell große Aufmerksamkeit erregt: Gestern diskutierten alle darüber, dass DeepSeek es nun jedem ermöglicht, sein eigenes KI-Modell schnell bereitzustellen, und heute merkt man plötzlich: Nein, warum ist die Inferenz großer Modelle so profitabel?
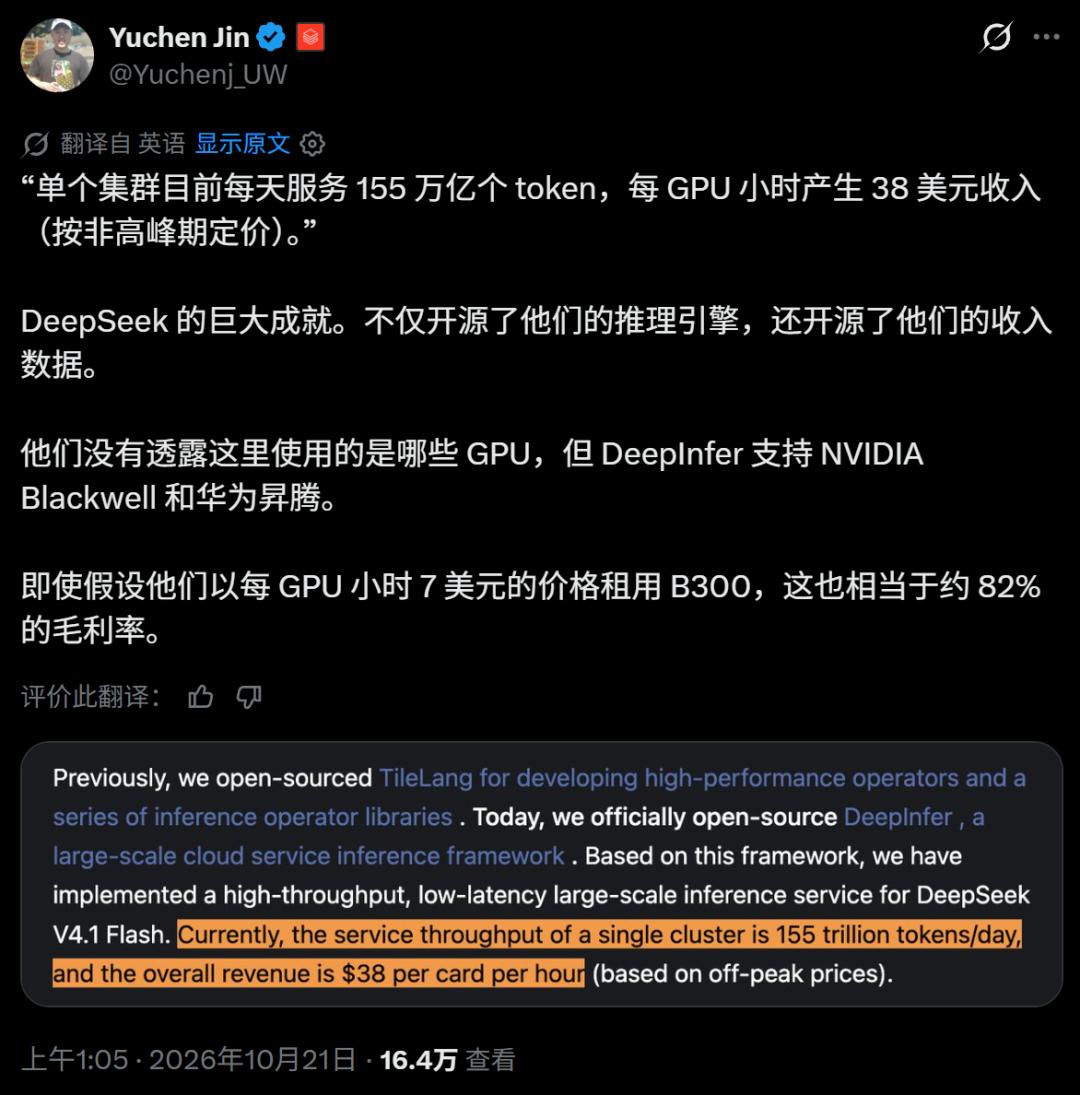
DeepSeek gab bekannt, dass auf Basis dieses Systems der Durchsatz eines einzelnen Clusters pro Tag 155 Billionen Token erreicht, gemessen am durchschnittlichen API-Marktpreis beträgt der Gesamtumsatz 38 US-Dollar pro Grafikkarte und Stunde.
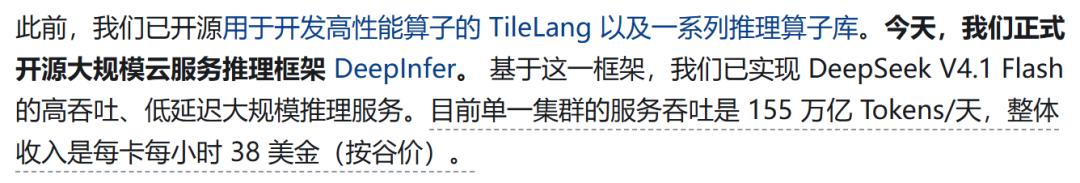
Was bedeutet das konkret? Jemand hat berechnet, dass die Bruttomarge 82 % beträgt: Angenommen, die von Ihnen angebotene API wird ausreichend häufig genutzt, und Sie mieten Grafikkarten zu einem Preis von 7 US-Dollar pro B300 pro Stunde, bleibt nach Abzug der Mietkosten noch ein beträchtlicher Überschuss übrig.
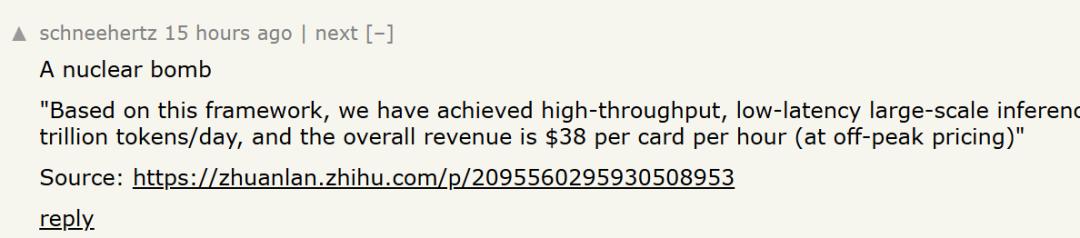
Auf Hacker News hat jemand das direkt so beschrieben: Eine Atombombe. Die nüchternen Zahlen zeigen Ihnen, dass es keine Blase im KI-Bereich gibt.
DeepInfer ergänzt die aktuelle Diskussion über die Preise von KI-Diensten um wichtige Daten und lässt uns zum ersten Mal die technische Fähigkeit verstehen, Modelle effizient zu betreiben.
Für normale Nutzer bedeutet das Aufrufen großer Modelle lediglich, eine Anfrage zu senden und auf eine Antwort zu warten. Auf der Serverseite müssen zahlreiche Anfragen so geplant werden, dass sie sich die Chips teilen, Modellparameter gelesen, auf verschiedenen Geräten verteilte Rechenressourcen mobilisiert und Warteschlangen sowie Generierungslatenz gesteuert werden.
Man wird feststellen, dass es sich bei den Modellen um die gleichen DeepSeek-Modelle handelt, aber die offizielle API und die von Dritten bereitgestellten Versionen unterscheiden sich im Nutzungserlebnis. Das liegt daran, dass für dasselbe Modell bei unterschiedlichen Inferenzimplementierungen die Anzahl der Nutzer, die pro Karte gleichzeitig bedient werden können, und die Wartezeit der Nutzer variieren können. Inferenz-Frameworks lösen genau diese Probleme: Sie zielen darauf ab, die Inferenz-Effizienz zu verbessern, sodass der effektive Durchsatz pro Recheneinheit und die von den Nutzern wahrgenommene Antwortgeschwindigkeit das optimale Niveau erreichen.
In diesem Bereich gibt es niemanden, der es besser macht als DeepSeek selbst.
DeepInfer ist hauptsächlich auf groß angelegte Bereitstellungen ausgerichtet, unterstützt NVIDIA SM100 GPUs und Huawei Ascend 950 NPUs, integriert optimierte Operatoren, verteiltes Parallelverfahren, spekulative Dekodierung, asynchrone Planung und andere Funktionen und unterstützt zudem die Einschränkung der Ausgabe nach Regeln wie JSON Schema. DeepInfer wurde ursprünglich hauptsächlich auf Basis von vLLM entwickelt und hat sich auch an SGLang und TensorRT-LLM orientiert.
Gleichzeitig ist deepseek-recipe dafür verantwortlich, API-Anforderungen in unterschiedlichen Formaten in Prompt-Texte und Token-Sequenzen umzuwandeln, die von Modellen verwendet werden, und die Ausgabe anschließend wieder in eine Antwort im entsprechenden Format umzuwandeln. Es unterstützt Schnittstellenformate wie Chat Completions, Responses und Messages und deckt die Verarbeitung von Denkinhalten, Tool-Aufrufen und Streaming-Ausgaben ab.
Dies ist von großer Bedeutung für Bereitstellungen durch Dritte: Entwickler können die offizielle Anfrageverarbeitungs- und Codec-Logik wiederverwenden, wodurch die Wahrscheinlichkeit von Verhaltensunterschieden verringert wird, wenn dieselbe Anwendung auf andere Server verschoben wird. Ob ein Modell problemlos in bestehende Agent-Workflows integriert werden kann, hängt oft von diesen Details ab.
Das derzeit quelloffene Repository bietet die Kernfunktionen für die Offline-Inferenz und die Unterstützung groß angelegter Dienste. Natürlich erfordert ein vollständiger Onlinedienst noch begleitende Komponenten wie das KV-Cache-System, visuelles Codieren und die getrennte Bereitstellung von Prefill/Decode sowie das Lastausgleich über mehrere Replikate hinweg. Dritte erhalten eine wichtige Engine, müssen bei der Implementierung jedoch noch die Systemintegration abschließen.
Das gemeinsame Ziel all dieser Bereitstellungsarbeiten ist es, dass jede Grafikkarte weniger redundante Berechnungen durchführt und mehr Anfragen bedient.
Aus den offiziellen Bereitstellungsdokumenten geht hervor, dass die Optimierungsstrategien von DeepSeek die Organisation von Ressourcen nach Inferenzphasen, die Wiederverwendung von Berechnungsergebnissen des Kontexts und die Erhöhung des effektiven Ertrags bei jeder Dekodierung umfassen.
Wenn große Modelle Anfragen verarbeiten, müssen sie zuerst den Eingabekontext verarbeiten (auch Prefill genannt) und dann schrittweise die Antwort generieren (auch Decode genannt). Die getrennte Bereitstellung der beiden Phasen ermöglicht es, Ressourcen separat zu planen und zu vermeiden, dass unterschiedliche Lasten sich gegenseitig behindern. Dies trägt dazu bei, gleichzeitig die Wartezeit für das erste Token und die nachfolgende Generierungsgeschwindigkeit zu optimieren.
Caching eignet sich besonders für lange Gespräche und Agenten. Nachdem ein Agent ein Tool aufgerufen hat, enthält die nächste Anfrage häufig erneut die vorherigen System-Prompts, Tool-Beschreibungen und Verlaufsaufzeichnungen. Wenn die zwischenzeitlichen Berechnungsergebnisse des vorhandenen Kontexts wiederverwendet werden können, lassen sich die Kosten für die wiederholte Verarbeitung desselben Inhalts reduzieren.
Ein herausragender Punkt ist die Aufbewahrungsdauer des KV-Caches: Laut offiziellen Angaben werden Agent-Verkehrsdaten 3 Tage lang und Chat-Verkehrsdaten 7 Tage lang aufbewahrt. Diese Caches werden in einem unabhängigen 3FS-Speichercluster gespeichert und können von allen Prefill-Rechnern gelesen werden. Durch die Kombination von mehrtägiger Aufbewahrung, gemeinsam genutztem Speicher und automatischer Übereinstimmungsfindung sorgt DeepSeek dafür, dass bereits berechnete lange Kontexte in mehr nachfolgenden Anfragen weiterverwendet werden können.
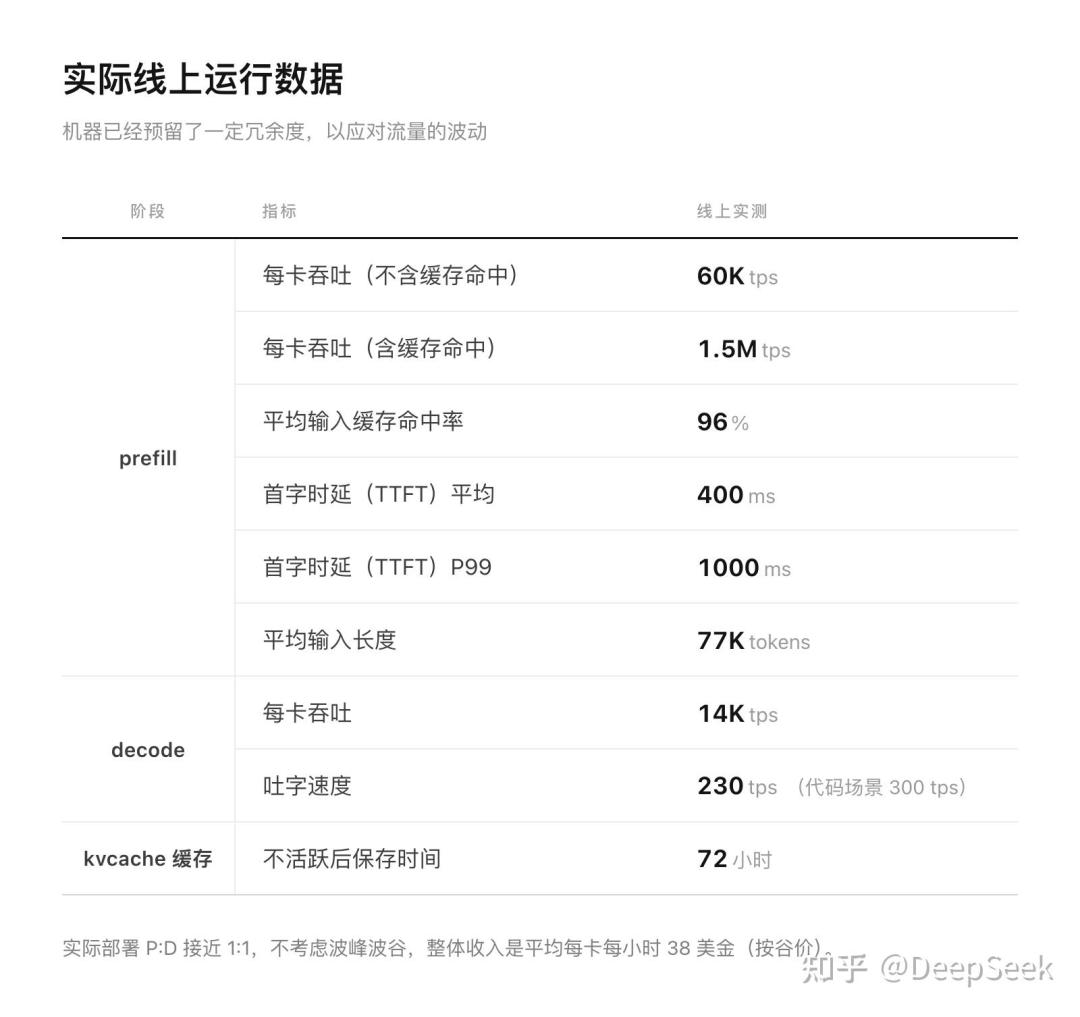
Bei anderen Anbietern wie Anthropic, OpenAI und Google liegt die Aufbewahrungsdauer des Caches meist zwischen 5 Minuten und 24 Stunden.
Ein weiteres Beispiel ist die DSpark-Spekulativ-Dekodierung: Zuerst werden Kandidaten-Token generiert und dann an das Hauptmodul zur Überprüfung übergeben. DeepSeek plant die Überprüfung weiter nach der erwarteten Akzeptanzrate der Kandidaten, um Berechnungen für Kandidaten mit geringem Nutzen zu reduzieren. Laut der offiziellen Bereitstellungsfragen-Antwort-Schätzung kann in der Nähe der aufgeführten Produktionsarbeitspunkte die dynamische Längenüberprüfung den Durchsatz um etwa 4-7 % steigern, verglichen mit der festen Überprüfung von 5 Kandidaten-Token.
Zusammengenommen verändern diese Optimierungen die Dienstmenge, die jede Grafikkarte liefern kann. Die Preise sind niedrig, aber man macht wirklich keine Verluste: Solange die Rechenkapazität nicht ungenutzt bleibt, verdient man umso mehr, je mehr Rechenkarten man kauft.
Bei der Diskussion über die Kosten pro Token sieht die aktuelle offizielle Preisliste für die APIs von DeepSeek-V4.1-Flash und V4.1 Pro wie folgt aus.
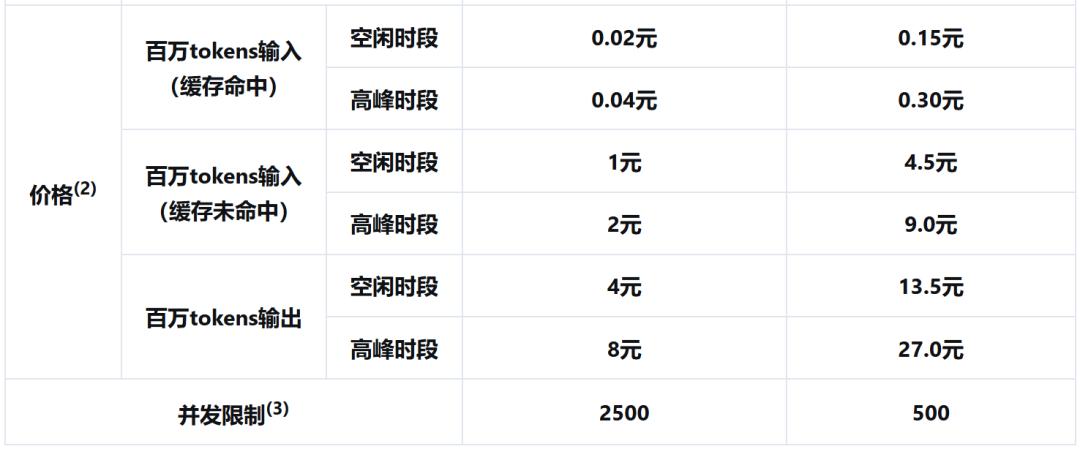
Um die Dienstumsätze und -kosten zu vergleichen, müssen gleichzeitig die Zusammensetzung von Eingaben, Ausgaben und Cache-Treffern berücksichtigt werden. Schließlich beträgt der Preis für Eingaben mit Cache-Treffer nur ein Fünftel des Preises für Eingaben ohne Treffer. Gut ist, dass DeepSeek selbst die Zahl von 38 US-Dollar genannt hat.
Abgesehen von den 7 US-Dollar für die GPU-Miete besteht auch nach Hinzurechnung anderer Dienstausgaben noch eine beträchtliche Lücke zwischen dem API-Verkaufspreis und den Kosten. Dies zeigt, dass eine effiziente Inferenz gleichzeitig niedrige Preise und einen beträchtlichen Gewinnspielraum ermöglichen kann. Kein Wunder, dass Cloud-Dienstanbieter Geld leihen, um Rechenzentren zu bauen. Auf Hacker News ist die Diskussion geteilt: Einige haben anhand niedrigerer GPU-Kosten einen höheren Gewinnspielraum berechnet, andere betonen, dass die Investitionen über den gesamten Lebenszyklus des Modells berücksichtigt werden müssen.
Allerdings hat die vorherige Aussage, dass sich alle Gerätekosten innerhalb von 10 Monaten amortisieren, nun eine Grundlage.
Auf der anderen Seite hat The Information letzten Monat aufgedeckt, dass der annualisierte Umsatz von DeepSeek etwa 1 Milliarde US-Dollar erreicht, was grob 2,74 Millionen US-Dollar pro Tag entspricht. Verglichen mit 38 US-Dollar pro Karte und Stunde entspricht das genau 3000 Grafikkarten.
DeepInfer bietet einen Code-Ausgangspunkt für optimierte Bereitstellungen. Für die meisten Nutzer wird ein intensiverer Wettbewerb im Bereich der Inferenz voraussichtlich zu niedrigeren Aufrufkosten und einem besseren Antwort-Erlebnis führen.
Man weiß nicht, ob die Zukunft so aussieht, dass man „nicht mehr Zeit verschwendet, Onkel Liang beim Training von AGI zu behindern“, oder dass nach der Veröffentlichung von V4.1 Pro die DeepSeek-Server erneut überlastet werden?
Referenzen:
https://zhuanlan.zhihu.com/p/2095560295930508953
https://news.ycombinator.com/item?id=50163277
https://www.theinformation.com/articles/deepseeks-annualized-revenue-hits-1-billion-startup-finalizes-7-5-billion-fundraising
https://x.com/Yuchenj_UW/status/2112591074409742733
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „Machine Heart“ (ID: almosthuman2014), Autor: Machine Heart, das DeepSeek verfolgt, Redakteur: Zenan, veröffentlicht mit Genehmigung von 36Kr.