Erst-Token-Latenz um 32,4 % gesenkt! Is Stone Technology hat eine bahnbrechende Maßnahme für Cluster-Scheduling vorgestellt, sodass die Effizienz der heimischen Inferenz weiter verbessert wird.
In GPU-Clustern können gleichzeitig Anfragewarteschlangen und Ressourcenleerlauf auftreten. Während der 2026 CCF National Academic Conference für Hochleistungsrechnen hat METASTONE das neue verteilte Scheduling-Framework TokenFleet vorgestellt, dessen Optimierungsschwerpunkte auf Anfrageweiterleitung, standortübergreifender Kapazitätskoordination und Verwaltung gemischter Lasten liegen, um die effektive Leistung der vorhandenen Rechenressourcen zu verbessern.
Man stellt den Inferenzdienst als eine inländische Token-Optimierungsfabrik vor: GPUs sind Produktionsanlagen, Inferenzinstanzen sind Arbeitsplätze und Geschäftsanfragen sind einzelne Bestellungen. Die Aufgabe von TokenFleet besteht darin, Bestellungen mit der Produktionskapazität abzugleichen. Bei derselben Gerätegruppe können unterschiedliche zugewiesene Aufgaben und unterschiedliche Zuweisungsmethoden zu unterschiedlichen Wartezeiten und qualifizierten Ausgaben führen. Für skalierte Dienste müssen alle diese Produktionsvereinbarungen gemeinsam berücksichtigt werden.
TokenFleet konzentriert sich auf die effektive Ausgabe des Clusters
Nach Abschluss der Modellbereitstellung muss das Cluster gleichzeitig mehrere Arten von Geschäften bewältigen. Mehrere Modelle teilen sich die Rechenleistung, und verschiedene Mieter haben ihre jeweiligen Anforderungen an den Dienstgrad. Kurze Dialoge erfordern eine sofortige Antwort, die Verarbeitung langer Dokumente erfordert mehr Rechenleistung und Videospeicher, und offline Batch-Aufgaben haben Fertigstellungsfristen. Wenn Dienste in mehreren Rechenzentren verteilt sind, muss zudem berücksichtigt werden, ob die Kapazitäten an allen Standorten koordiniert werden können.
Einfache Verkehrsverteilung kann dazu führen, dass einige Instanzen lange Warteschlangen bilden, während die Kapazitäten an anderen Standorten nicht rechtzeitig genutzt werden. Lange Anfragen und Batch-Aufgaben behindern sich gegenseitig, was die Echtzeit-Interaktion verlangsamt; Zeitüberschreitungen, Abbrüche und wiederholte Berechnungen verbrauchen Ressourcen, ohne zu einer qualifizierten Lieferung zu führen.
TokenFleet erhöht die effektive Token-Ausgabe und senkt die Kosten pro Einheit der effektiven Ausgabe, solange die Modellqualität, die Dienstanforderungen und das Rechenleistungsbudget übereinstimmen. TokenPilot wählt Instanzen innerhalb desselben Modellpools aus, FleetMind ist für die standortübergreifende Kapazitätskoordination zuständig, und SLOMax übernimmt die Zulassung von gemischten Lasten, die Warteschlangenverwaltung und die Kapazitätszuweisung. Die drei Kerntechnologien haben jeweils eigene Aufgaben.
An wen die Anfrage verteilt wird, wann die Aufgabe in die Warteschlange eintritt und wie die Kapazitäten der Rechenzentren koordiniert werden, führt letztendlich alle zu demselben Indikator: die effektive Token-Ausgabe, die erfolgreich abgeschlossen wurde und die Dienstanforderungen erfüllt.
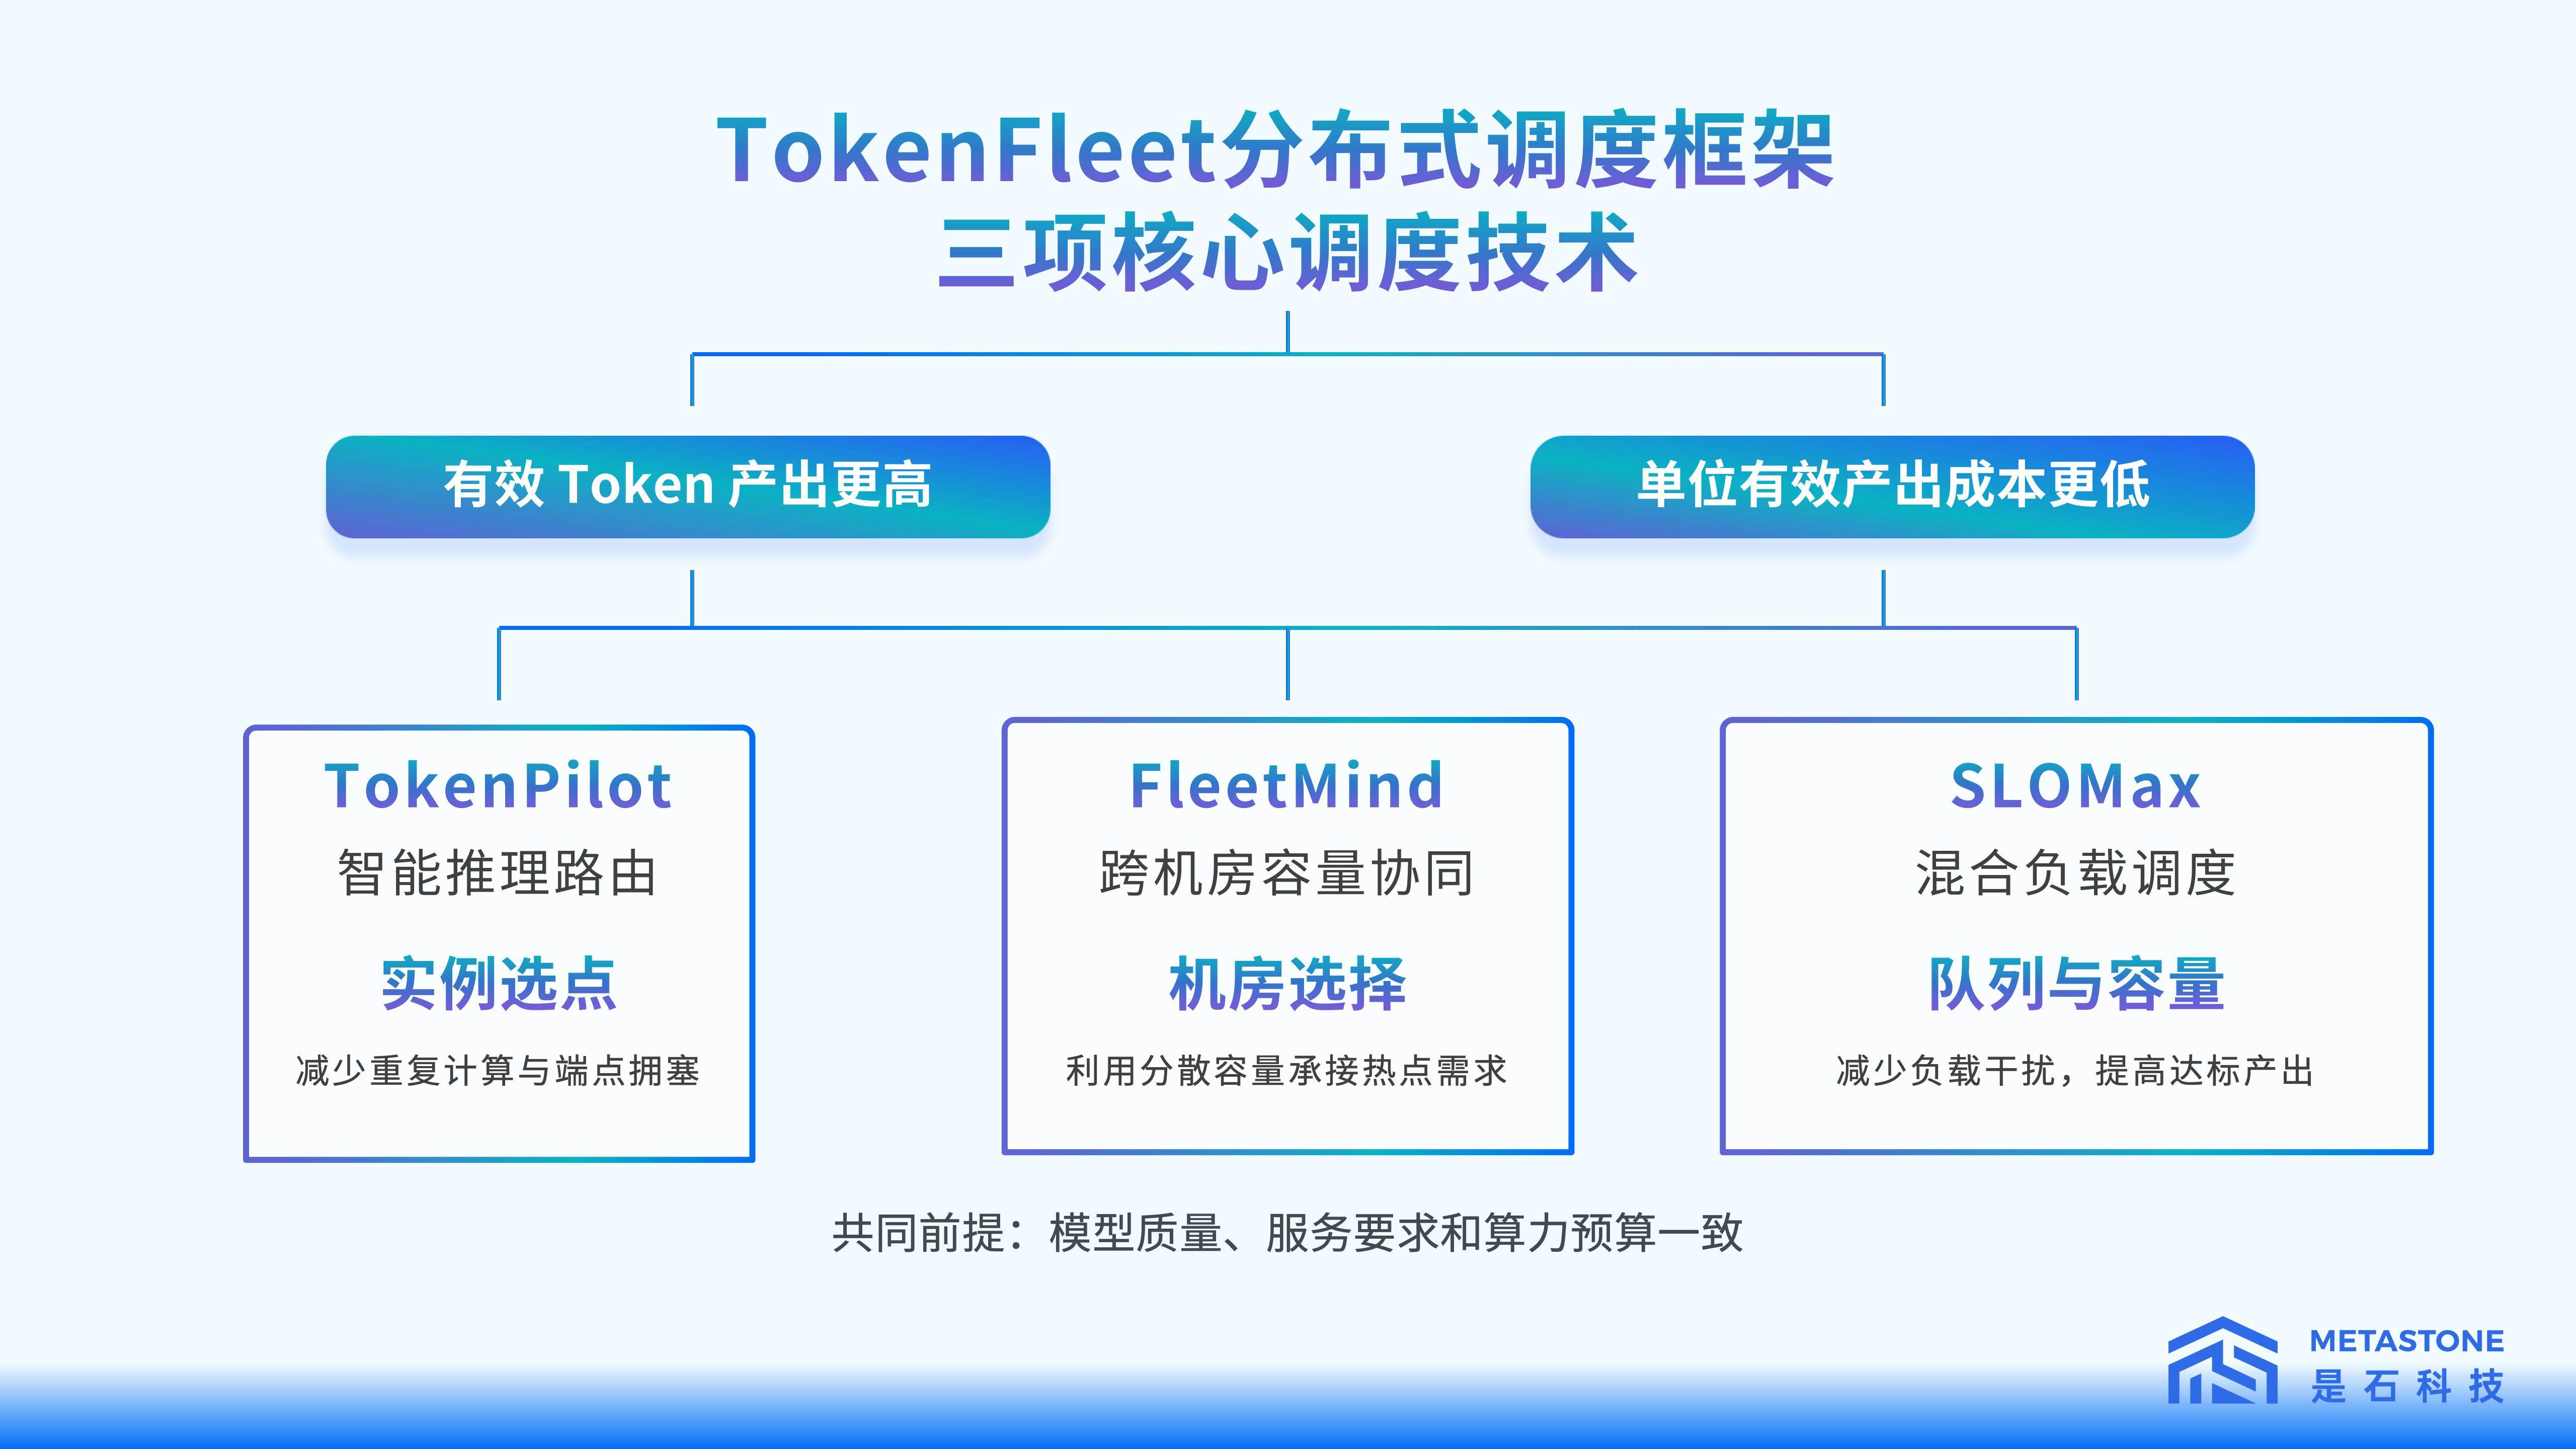
Abbildung 1 Überblick über die drei zentralen Scheduling-Technologien von TokenFleet
TokenPilot berechnet sowohl die Cache-Vorteile als auch die Kosten der Warteschlange
Sehen wir uns zuerst die Auswahl des Zielorts für die Anfrage an: An welche Instanz soll eine Anfrage gesendet werden? Eine kurze Frage-Antwort-Paar und ein langes Dokument können auch bei gleicher Zählung als eine einzelne Anfrage sehr unterschiedliche Rechen- und Videospeicherverbräuche aufweisen. Eine Verkehrsverteilung nur nach der Anzahl der Anfragen kann die tatsächliche Arbeitslast der einzelnen Instanzen kaum ausgleichen.
Der Cache bietet hier eine zusätzliche Abwägung. Wenn Anfragen mit demselben langen Präfix an eine Instanz gesendet werden, die den zugehörigen KV-Cache beibehalten hat, besteht die Möglichkeit, zuvor berechnete Ergebnisse wiederzuverwenden und das Prefill zu reduzieren – also die wiederholte Berechnung bei der Verarbeitung von Eingabeinhalten.
Aber Instanzen mit hoher Cache-Trefferquote können auch lange Warteschlangen haben. Wenn alle Anfragen an denselben Ort strömen, kann die eingesparte Rechenzeit durch Wartezeiten aufgezehrt werden.
Bei der Auswahl des Zielorts schätzt TokenPilot gleichzeitig den Nutzen der Cache-Wiederverwendung und die Kosten der Warteschlange ein. Es schätzt die Arbeitslast anhand der Eingabegröße, des Ausgabebudgets und des wiederverwendbaren Präfixes, filtert und bewertet dann die Kandidateninstanzen unter Berücksichtigung der Warteschlange, der in Bearbeitung befindlichen Token, des KV-Cache-Drucks und der vorhergesagten Latenz. Das Ausgabebudget ist eine Einschränkung und stellt nicht die tatsächliche Ausgabelänge dar.
Auf dieser Grundlage vergleicht der Scheduler die erwarteten Verarbeitungskosten verschiedener Instanzen und beurteilt, ob die durch die Wiederverwendung des Caches eingesparte Rechenzeit die zusätzliche Wartezeit ausgleichen kann.
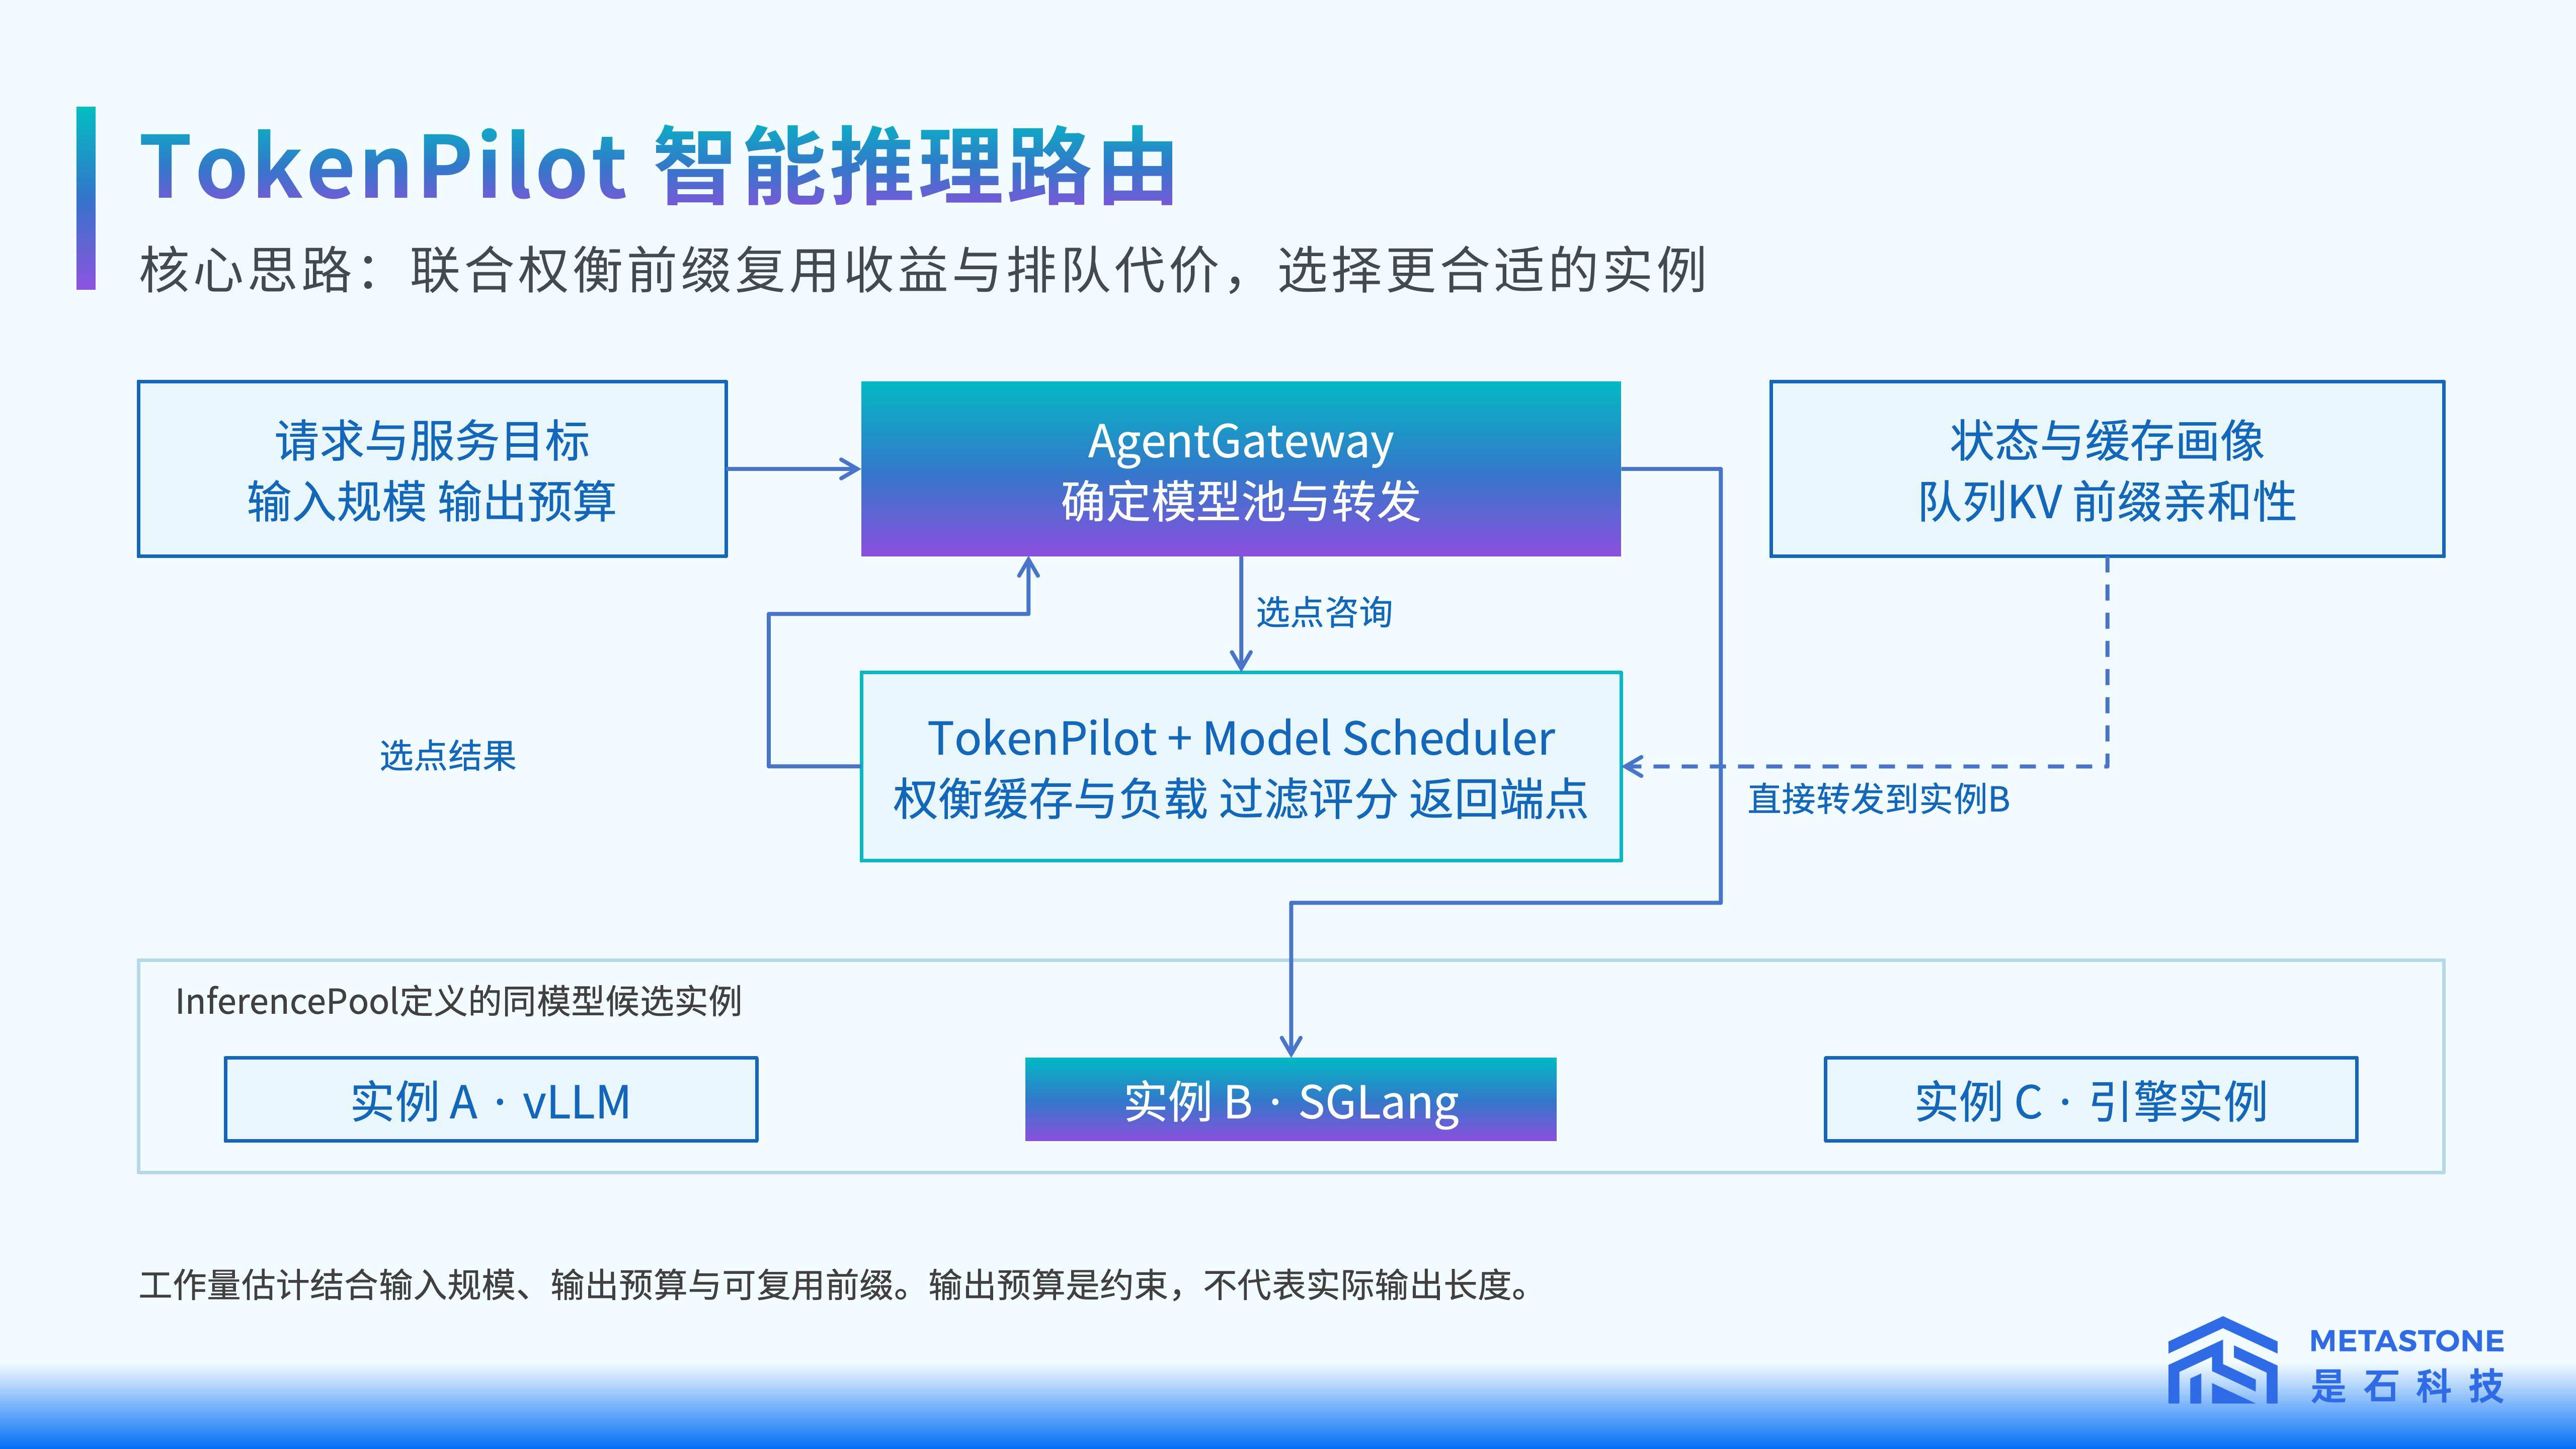
Abbildung 2 Intelligentes Inferenzrouting-Framework von TokenPilot
Die von METASTONE bereitgestellten GLM5.3-Optimierungsdaten zeigen, dass unter den getesteten Grafikkarten-Cluster- und Lastbedingungen die P95-Latenz des ersten Tokens um 32,4 % und die P50-Latenz des ersten Tokens um 71,3 % gesunken ist, nachdem das Routing mit vorhergesagter Latenz eingeführt wurde.
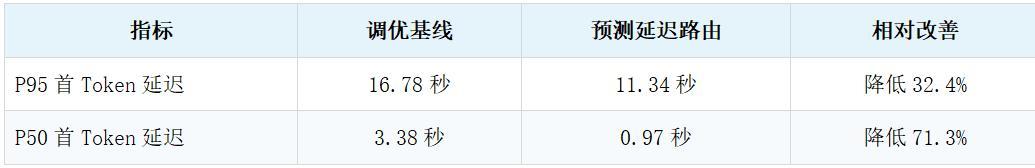
Tabelle 1 Optimierungsergebnisse der ersten Token-Latenz von TokenPilot (Datenquelle: Konferenzvortragsmaterial von METASTONE. Die Verbesserungsrate wird nach der Formel (Basiswert - Optimierter Wert) ÷ Basiswert berechnet; Die Verringerung der Latenz entspricht nicht direkt einer Kostensenkung.)
P50 spiegelt das mittlere Niveau wider, P95 spiegelt die Wartezeit der Anfragen am Ende der Verteilung wider. Diese Gruppe von Daten zeigt die Antwortverbesserung unter den getesteten Bedingungen; der Kostennutzen muss noch anhand von Durchsatz und Ressourcenauslastung bewertet werden.
FleetMind berechnet die Dienstkapazität auch standortübergreifend klar
Wenn man den Blick von einem einzelnen Modellpool auf mehrere Rechenzentren erweitert, erhält das Scheduling eine zusätzliche Ebene der Kapazitätsbeurteilung. Selbst bei freien GPUs ist es nicht unbedingt sofort möglich, Aufträge anzunehmen. Ob das Zielmodell bereitgestellt ist, ob die Version übereinstimmt, ob der Dienstendpunkt bereit ist und wie lange die Netzwerkübertragung dauert, wirken sich alle auf das Ergebnis der Verkehrsverteilung aus.
FleetMind konzentriert sich auf die tatsächlich verfügbare Kapazität des Modelldienstes. Im Design von TokenFleet sammelt es die Modellverfügbarkeit, die Echtzeitkapazität und den Netzwerkstatus der einzelnen Rechenzentren, wählt zuerst das ausführende Rechenzentrum aus und lässt dann die lokale Entscheidungsmaschine dieses Rechenzentrums die spezifische Inferenzinstanz auswählen.
Wenn das überlastete Rechenzentrum mit der Bildung von Warteschlangen beginnt, bewertet das System, ob andere Rechenzentren über bereitstehende Endpunkte des Modells derselben Version verfügen und noch Dienstreserven haben, und beurteilt dann, ob sie neue Anfragen übernehmen können, deren Ausführung über verschiedene Standorte hinweg zulässig ist.
Ob eine Verkehrsverteilung möglich ist, muss zuerst die Berechtigungs- und Datenstandortbeschränkungen erfüllen. Ob sich die Verkehrsverteilung lohnt, erfordert zudem einen umfassenden Vergleich der Backend-Latenz, der Warteschlange, der Berechnungs-, Cache- und Übertragungskosten.
Die Kapazitätskoordination erfolgt auch in unterschiedlichen Zeitskalen: Sie lenkt die Ziele neuer Anfragen in kurzen Zyklen, passt die Modellkopien und die Position der Vorwärmung in langen Zyklen an und reduziert Kapazitätsfehlanpassungen durch Kapazitätsreservierung, Erkennung der Lastobergrenze und automatischen Rückfall.
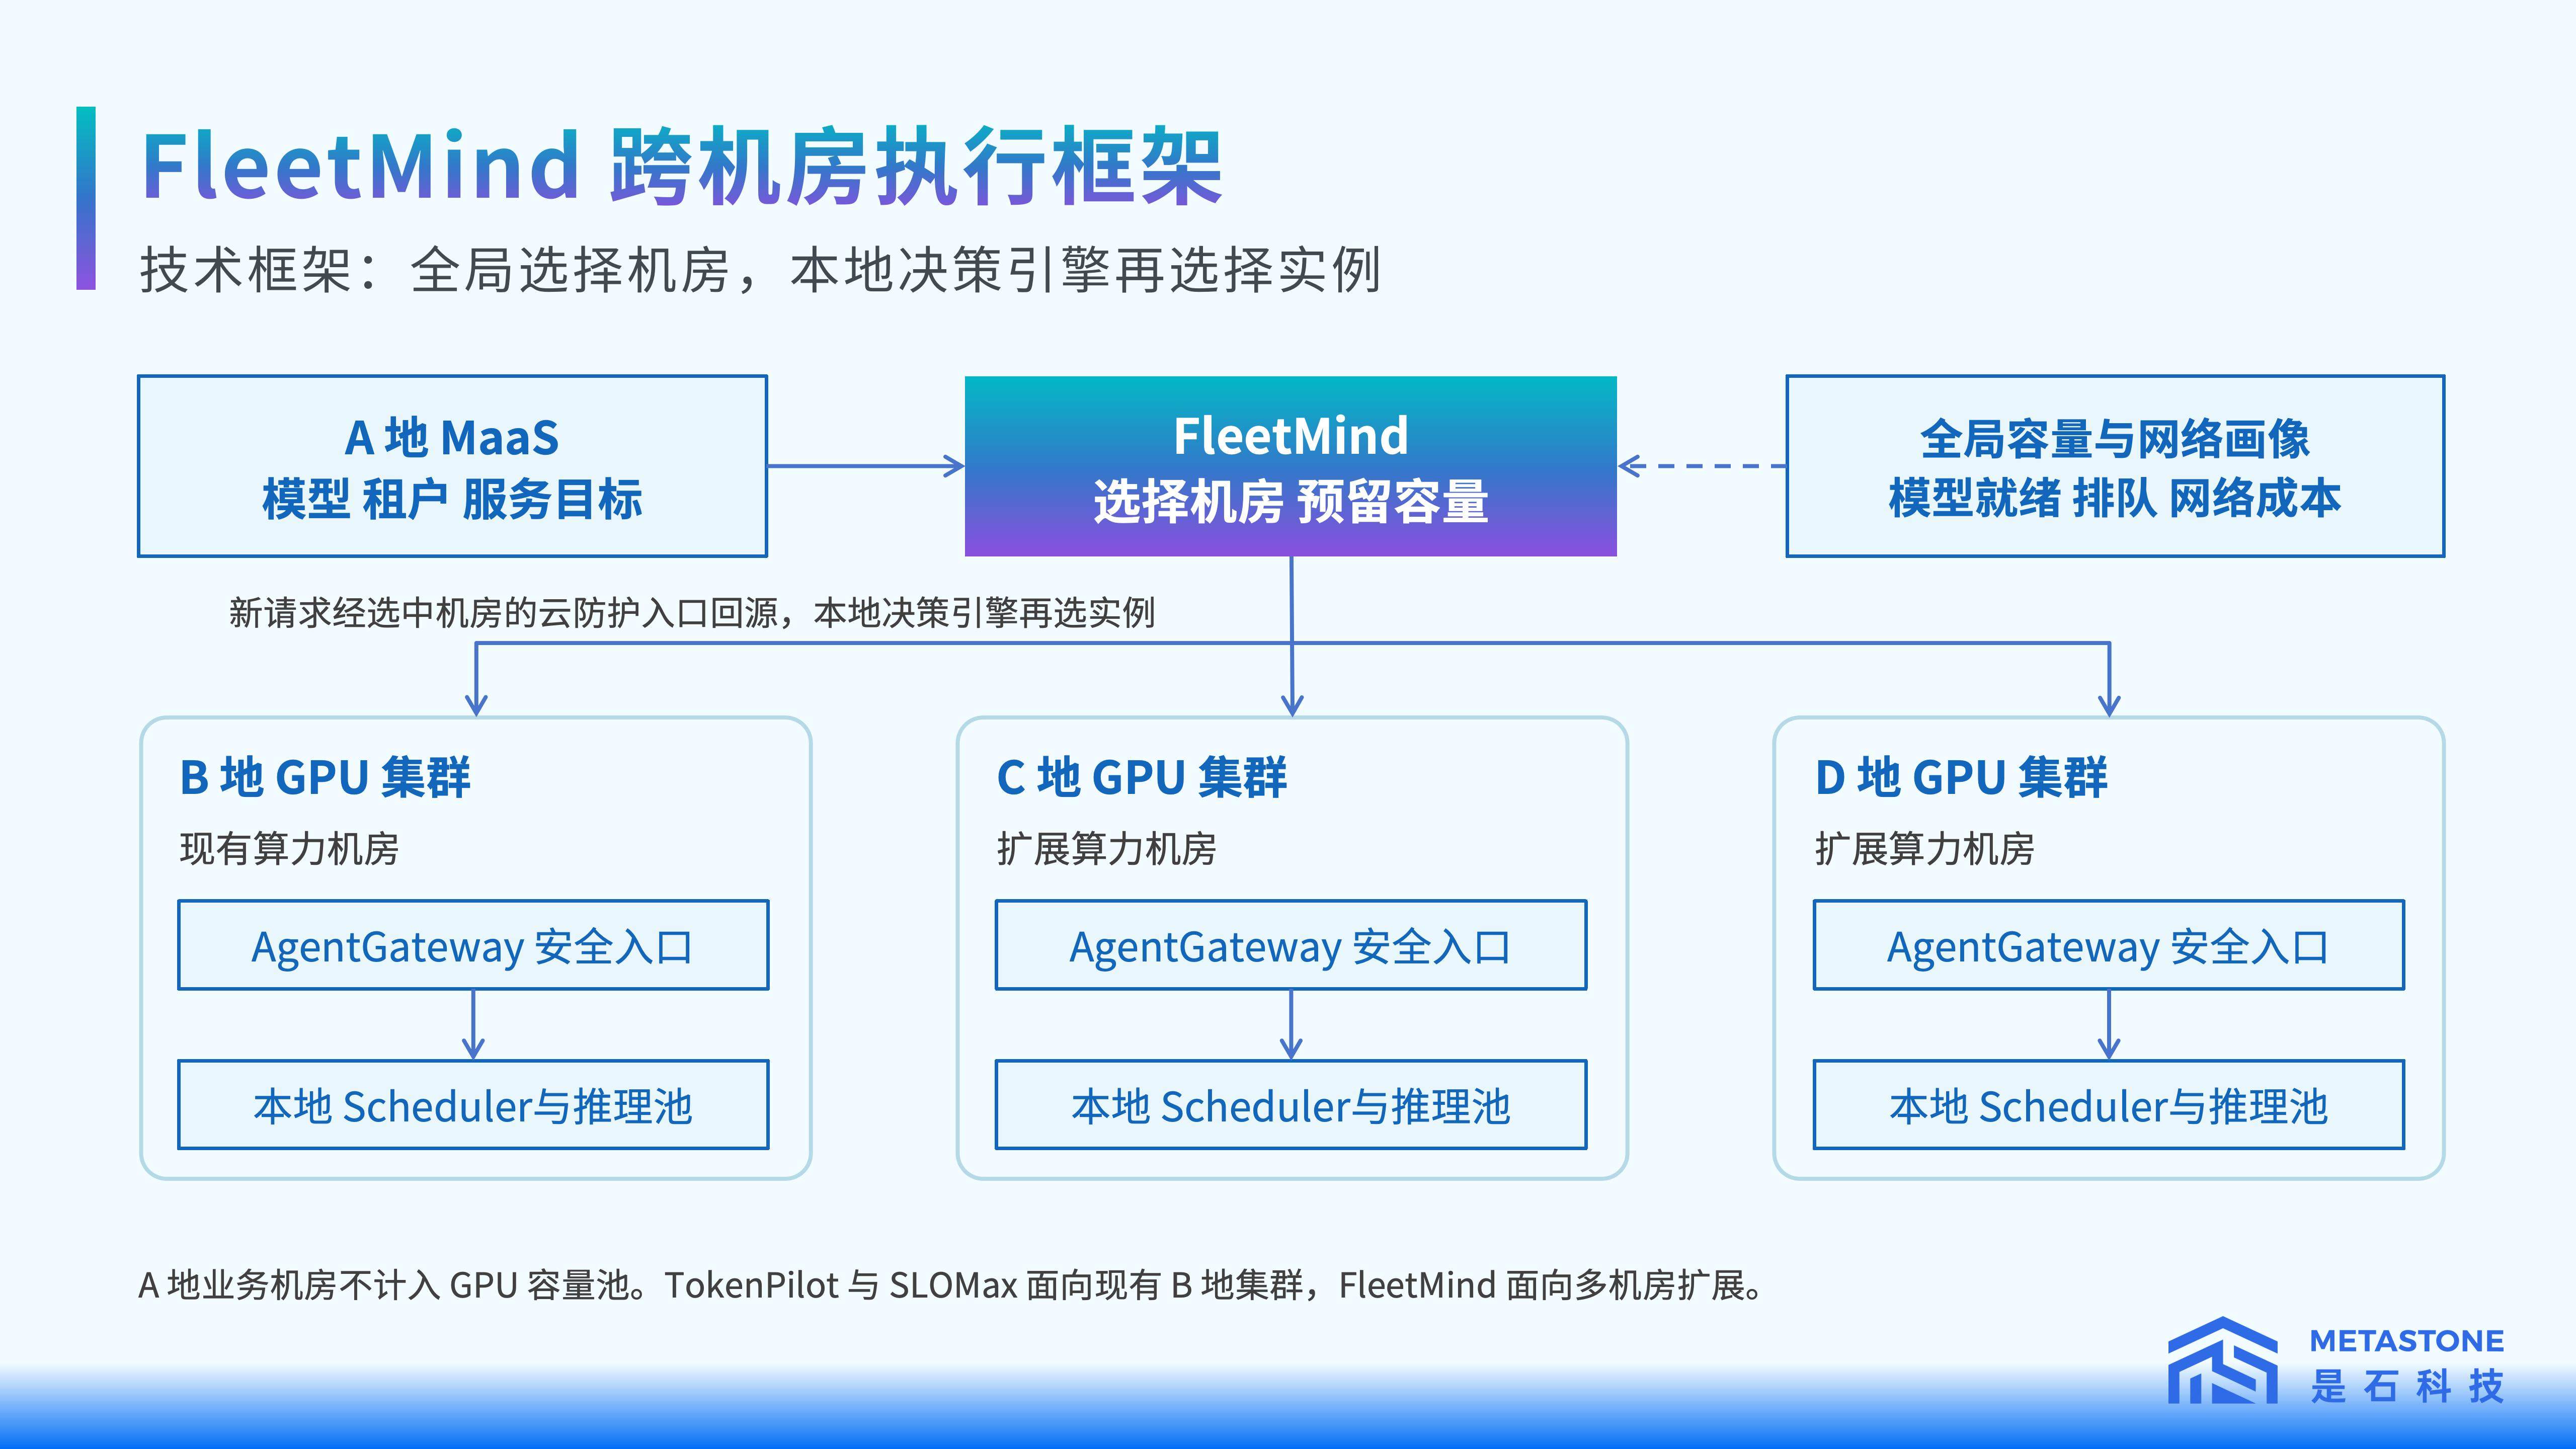
Abbildung 3 FleetMind-Framework für die standortübergreifende Ausführung (Hinweis: Ort A ist der Geschäftseingang und wird nicht in den GPU-Kapazitätspool einbezogen; Ort B ist das vorhandene Cluster, die Orte C und D sind erweiterte Rechenzentren.)
TokenPilot und SLOMax richten sich an das vorhandene Cluster, FleetMind an die Erweiterung um neue Rechenzentren für zusätzliche Rechenleistung in der Folge. Das Ziel der standortübergreifenden Koordination besteht darin, verteilte Kapazitäten, die die Geschäftsbeschränkungen erfüllen, für die Übernahme von Spitzenbedarf zu nutzen und Kapazitätsfehlanpassungen und wiederholte Reservierungen zu reduzieren.
SLOMax organisiert die Produktion nach den Dienstanforderungen
Anfragen gelangen in dasselbe Cluster, aber die Lieferanforderungen sind unterschiedlich. Echtzeit-Dialoge legen Wert auf die Antwort des ersten Tokens und die kontinuierliche Generierungsgeschwindigkeit, Aufgaben mit langem Kontext hängen stärker von der Eingabeverarbeitungsfähigkeit und der KV-Kapazität ab, während sich offline-Batch-Aufgaben auf die Fertigstellungsfrist und den Durchsatz konzentrieren. Wenn sie in dieselbe Warteschlange gestellt werden, entsteht leicht ein Wettbewerb um Ressourcen.
Langes Prefill, Druck auf die KV-Kapazität und Batch-Lasten können alle Interaktionsanfragen behindern. Zeitüberschreitungen, Abbrüche und wiederholte Ausführungen führen dazu, dass ein Teil der Berechnungen nicht in eine effektive Lieferung umgewandelt werden kann.
SLOMax erkennt die Arbeitslast anhand der Eingabelänge, des Ausgabebudgets, des Aufgabentyps und der Dienstziele des Mieters und führt dann die Zulassung nach Dienstgraden, die Warteschlangen in getrennten Pools und die Koordination der Kapazitäten durch. Es muss die Interaktionskapazität sicherstellen und die Parallelität sowie die gegenseitige Beeinträchtigung von langen und kurzen Anfragen steuern.
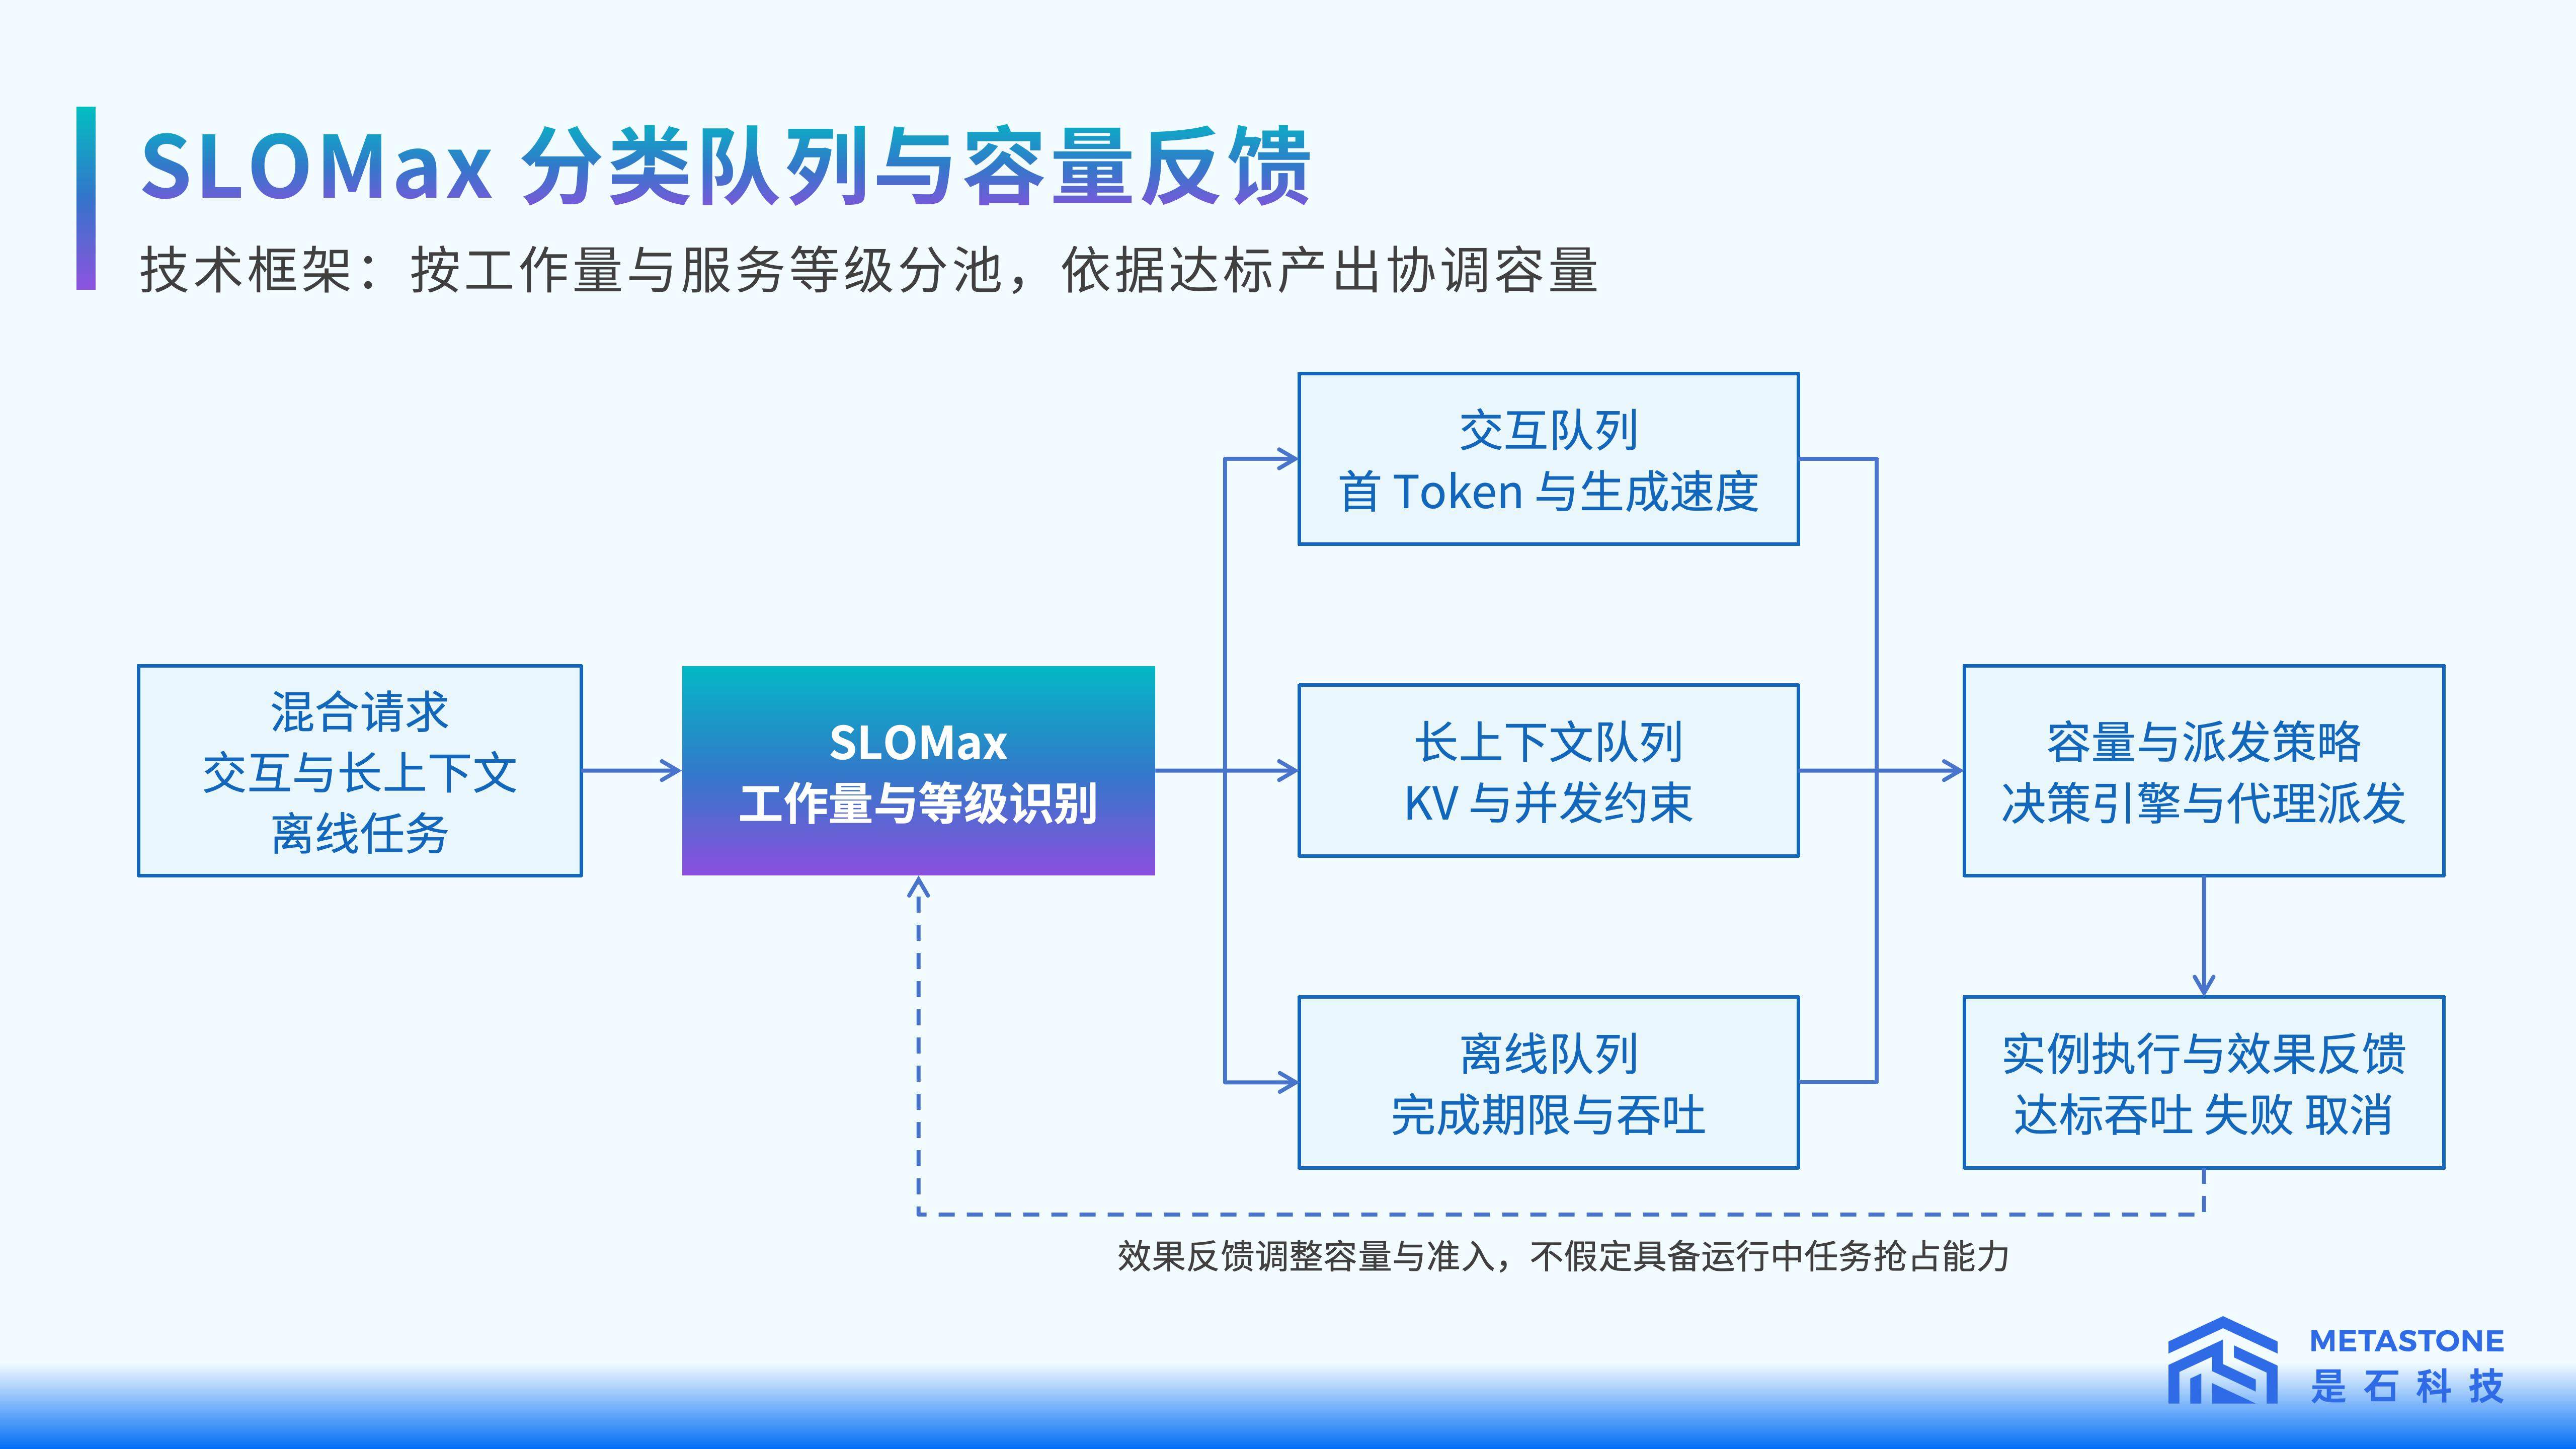
Abbildung 4 Klassifizierte Warteschlange und Kapazitätsrückkopplungsframework von SLOMax (Hinweis: Die Effektrückkopplung dient zur Anpassung von Kapazität und Zulassung, das Framework verfügt nicht über voreingestellte Fähigkeiten zur Verdrängung laufender Aufgaben.)
Um den Effekt dieses Schedulings zu messen, nimmt TokenFleet die qualifizierte Ausgabe als Optimierungsziel. Goodput, also der Durchsatz der qualifizierten Ausgabe, wird berechnet als: die Gesamtmenge der ausgegebenen Token, die von erfolgreich abgeschlossenen Anfragen erzeugt werden und die vereinbarten Dienstanforderungen erfüllen, geteilt durch die Testdauer innerhalb des vollständigen Testzeitraums. Für verschiedene Aufgabekategorien müssen jeweils eigene Schwellenwerte für die Qualifizierung definiert und die Ergebnisse gemeldet werden.
Das System gibt Informationen über den qualifizierten Durchsatz, Fehler, Abbrüche und wiederholte Ausführungen an die Scheduling-Strategie zurück und passt die Zulassungs- und Kapazitätsverhältnisse kontinuierlich an. Wie ausgelastet die GPU ist und wie hoch der Gesamtdurchsatz ist, muss immer zusammen mit der endgültigen qualifizierten Lieferung betrachtet werden.
In dem von METASTONE bereitgestellten Beispiel zur Nutzenberechnung von GLM5.3 stieg der Gesamt-Ausgabedurchsatz nach Einführung des koordinierten Schedulings mit Flusssteuerung um ca. 1,5 %, der qualifizierte Ausgabedurchsatz um ca. 29,4 % und der Qualifizierungsanteil von ca. 67 % auf ca. 86 %.
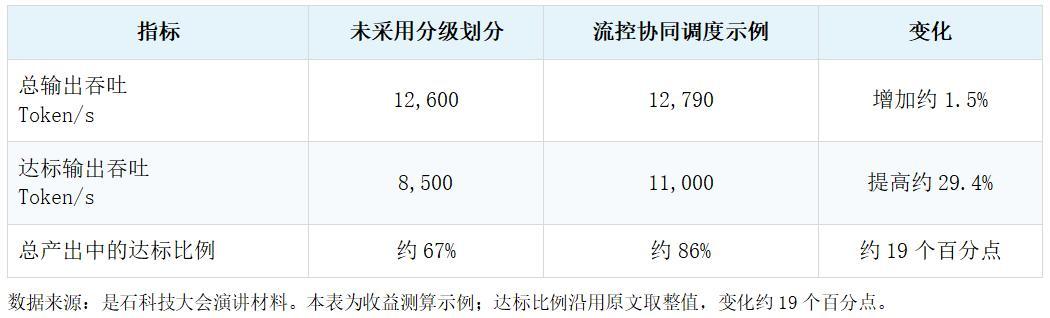
Tabelle 2 Beispiel zur Nutzenberechnung des effektiven Token-Durchsatzes von SLOMax
Diese Gruppe von Werten gehört zur Nutzenberechnung und zeigt die Ausgabestruktur, die das Scheduling verbessern soll. Der tatsächliche Nutzen muss noch anhand der spezifischen Last und der Dienstschwellenwerte überprüft werden. Bei demselben Gesamtausgabevolumen können durch die Reduzierung von Zeitüberschreitungen, Abbrüchen und wiederholten Berechnungen mehr qualifizierte Token geliefert werden. SLOMax bezieht diese Ergebnisse in die Rückkopplung ein, um die nachfolgende Ressourcenzuweisung anzupassen.
Die Effizienz der inländischen Token-Optimierungsfabrik hängt auch vom Scheduling ab
TokenFleet treibt die Optimierung des Inferenzdienstes auf Clusterebene voran. Wie die Leistung der Instanzen verschiedenen Anfragen zugewiesen wird und wie die Kapazitäten mehrerer Rechenzentren an der Dienstleistung teilnehmen, erfordert ein Scheduling, das Ressourcen mit den Geschäftsanforderungen verbindet.
METASTONE ist ein unabhängiger, von Dritten betriebener Full-Stack-Betreiber von Rechenleistung, der nicht an einen bestimmten Hersteller großer Modelle gebunden ist und Kunden einen One-Stop-Full-Stack-Lieferdienst für Rechen